

Расхождение в учете трафика всегда находятся не вовремя. Обычно это конец расчетного периода и сверка с биллингом, а в худшем случае — претензия от абонента. К этому моменту логи за нужный период уже перезаписаны, узлы пару раз перезапускались, и восстановить картинку не из чего. Само расхождение, как правило, мелкое, около процента, поэтому привязать его к конкретному событию почти нереально.
Хорошая новость в том, что мест, где теряется учет, немного. Их можно перечислить, для каждого заранее посчитать возможную потерю и превратить ее в параметр, который вы сами настраиваете. Таких мест четыре: отказ узла обработки, перебалансировка, смена узла управления и смена набора правил посреди сессии.
Меня зовут Алексей Червяков, я разработчик и тимлид в VAS Experts. Ниже пройдусь по каждому из этих мест, расскажу откуда берется потеря, как ее оценить и ограничить и на какие показатели стоит смотреть, чтобы заметить проблему вовремя.
Кто участвует в учете
Сервисный шлюз состоит из узлов обработки и узлов управления. При этом вокруг них есть пара внешних систем. Коротко, кто есть кто:
Узел обработки (DPI) — элемент сервисного шлюза, который работает на плоскости данных (user plane), через него физически идет трафик абонентов.
Узел управления (PCEF) — элемент сервисного шлюза на плоскости управления (control plane). Он раздает узлам обработки пороги по группам учета и собирает с них отчеты о потреблении.
Биллинг (OCS) — внешняя система тарификации. Она выдает квоты на трафик и принимает отчеты о расходе.
-
PCRF — внешняя система управления политиками. Решает, какая политика обслуживания у абонента и какой набор групп ему разрешены. Иногда она же выполняет роль OCS.
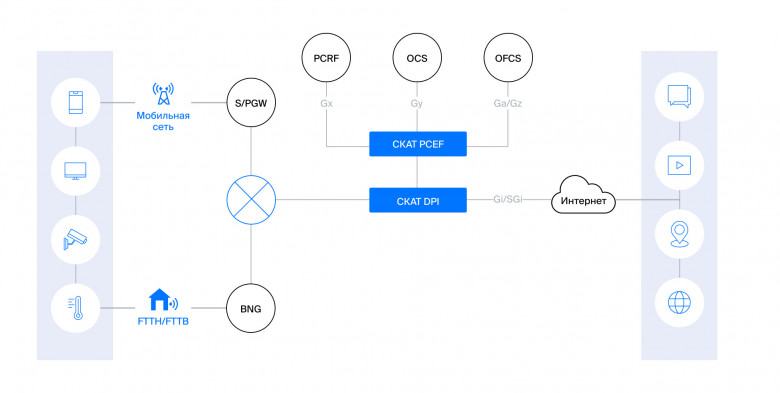
Сервисный шлюз СКАТ
Два термина, которые дальше будут постоянно мелькать:
Квота — объем, который система тарификации выдала сессии по группе учета.
Порог — объем, после которого узел обработки отправляет отчет. Порог ставит узел управления на основе квоты.
Теперь подробнее о том, что каждый из этих элементов делает в учете и как они передают друг другу данные. Начнем с того, чем вообще оперирует учет.
Базовая единица учета — группа учета. Она объединяет трафик сервисов, которые тарифицируются одинаково, и DPI отчитывается по их суммарному объему. Например, группа «видеостриминг» с идентификаторами RG 10 и SI 0 (Rating Group и Service Identifier) может включать трафик YouTube, Rutube и прочих видеосервисов.
DPI классифицирует пакеты, раскладывает их по группам учета и по каждой группе считает объем. PCEF узнает об этом объеме только из отчетов DPI, а сам хранит состояние сессий — выданные кредиты, израсходованный объем, сроки действия квот. PCRF задает ограничения скорости по группам учета. OCS выдает объемы и принимает отчеты.
Цикл учета выглядит так. PCRF сообщает PCEF, какие группы учета доступны абоненту. PCEF идет в OCS за объемами по каждой из них и отдает в DPI набор групп с ограничениями и порогами.
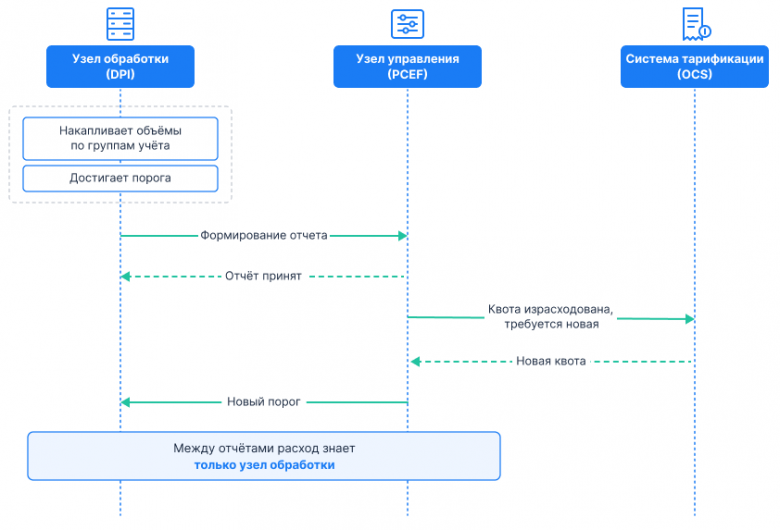
Когда расход по группе дошел до порога, DPI шлет отчет в PCEF (по запросу PCEF отчет может быть отправлен и раньше). PCEF передает данные в OCS или PCRF, получает новую квоту или новые правила и снова отправляет их в DPI. Напрямую DPI с OCS не общается, все идет через PCEF.
Слабое место у этой схемы в том, что между двумя отчетами данные о расходе есть только в одном месте. Пока отчет не ушел, ни PCEF, ни OCS не знают ничего про накопленный расход. Он существует только в счетчиках DPI. Если узел упал или сессию перекинуло при перебалансировке, то неотправленный объем пропадает. Это и есть причина потерь в учете.
Место первое: отказ узла обработки
При отказе узла потеря неизбежна, ведь упавший узел ничего уже не отправит. Но сколько именно пропадет, можно посчитать до аварии:
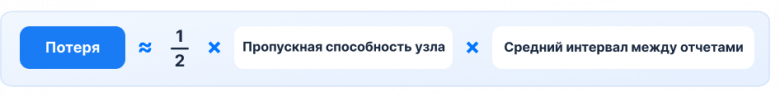
Логика простая. Полностью загруженный узел за интервал между двумя отчетами пропускает объем, равный его пропускной способности, умноженной на этот интервал. Отказ в среднем случается где-то в середине этого интервала, значит, теряется примерно половина объема.
Для узла на 200 Гбит/с это выглядит так:
Средний интервал между отчетами |
Потеря при отказе узла |
5 минут |
около 3,75 ТБ |
1 минута |
около 750 ГБ |
30 секунд |
около 375 ГБ |
Возможно цифры выглядят пугающе, но для узла такого масштаба это немного. Реальный убыток зависит от того, как часто у вас падают узлы и как тарифицируется потерянный трафик.
Главное, что видно из формулы, что потеря линейно зависит от интервала между отчетами. А интервал зависит от порога. DPI отчитывается, когда сессия набрала объем порога. Чем меньше порог, тем быстрее он набирается, тем чаще уходят отчеты и тем короче интервал, а значит, тем меньше потеря.
Отсюда второй вывод. Неотправленный объем по каждой сессии не превышает ее порога. Значит, потеря при отказе узла не превышает суммы порогов всех сессий на нем. А пороги выставляет PCEF, то есть потерями можно управлять.
По умолчанию PCEF ставит порог, равный квоте от OCS. Тогда сумма порогов на узле равна квоте, умноженной на число сессий, и ровно столько вы потеряете в худшем случае. Если не готовы мириться с таким риском, можно заранее ограничить возможные потери.
Бюджет риска
Для этого в PCEF от Vas Experts есть бюджет риска — максимальный объем, который вы готовы потерять при отказе одного узла. Задается он настройках и на узел целиком, и отдельно на каждую группу услуг. Когда бюджет задан, PCEF проверяет, что квота абонента, умноженная на число сессий с этой услугой, в него укладывается.
Если не укладывается, квота дробится. PCEF ставит на DPI меньший порог отчетности, сам суммирует промежуточные отчеты и отправляет отчет в OCS, только когда израсходована вся квота.
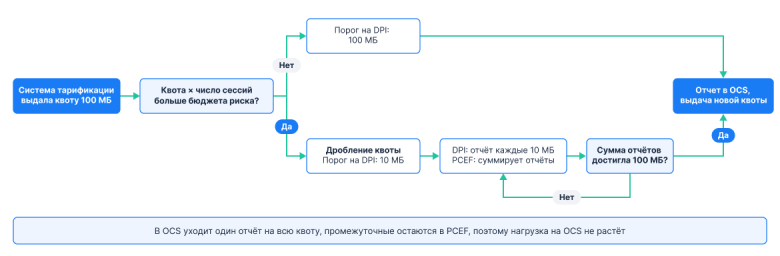
Пример. Система тарификации выдала квоту 100 МБ. Дальше возможны два сценария:
Квота с учетом числа сессий укладывается в бюджет. PCEF ставит порог 100 МБ. Как только порог набирается, PCEF отчитывается в OCS и запрашивает новую квоту.
Квота превышает бюджет риска. PCEF ставит порог 10 МБ, и DPI присылает промежуточный отчет каждые 10 МБ. Как только сумма промежуточных отчетов достигает 100 МБ, PCEF отправляет отчет в OCS и запрашивает новую квоту.
Если не хочется возиться с бюджетом, есть вариант попроще. Квоту можно делить на фиксированный коэффициент или ограничить сверху константой. Настроить можно для всех услуг сразу или для каждой отдельно. Такой вариант не учитывает число сессий, поэтому ограничивает потерю на одну сессию, а не на узел в целом. Здесь нет расчетов, поэтому с него удобно начинать внедрение.
Две периодичности вместо одной
В нашем решении дробление квоты выполняет PCEF. Настройки на DPI он передает по PFCP, в свою очередь этот протокол позволяет задать порог отчета меньше квоты. Размер порога PCEF подбирает сам под заданный бюджет риска. Допустим, вы указали, что по группе «видеостриминг» на одном узле может висеть не больше 100 ГБ неотчитанного трафика. Если услугой пользуется один абонент, PCEF выставит ему порог 50 ГБ. Если абонентов миллион, DPI будет отчитываться по каждой сессии примерно раз в 100 КБ.
Без дробления порог равен квоте, поэтому DPI отчитывается в PCEF так же часто, как PCEF в OCS. С дроблением эти две частоты разделяются и задаются независимо.
Отчеты |
Чем задается частота |
Результат |
|
От узла управления в систему тарификации (От PCEF в OCS) |
Квотой, которую выдала система тарификации |
Нагрузка на систему тарификации не меняется |
|
От узла обработки узлу управления (От DPI в PCEF) |
Бюджетом риска |
Потеря при отказе узла обработки не превышает бюджета риска |
Без дробления оператору приходится выбирать. Частые отчеты — меньше потерь, но OCS нагружается сильнее. Редкие отчеты разгружают OCS, но увеличивают потери. С дроблением чаще отправляются только отчеты от узла обработки к узлу управления. А это обмен внутри шлюза, и обходится он дешевле обмена с системой тарификации.
Три условия, без которых это не работает
Промежуточные отчеты не передаются в систему тарификации
OCS получает отчет, когда израсходована вся квота, когда истек ее срок или когда сессия завершилась. Если слать в систему промежуточные, нагрузка вырастет во столько раз, на сколько частей поделена квота, то есть ровно там, где мы ее старались не допустить.
Действие при исчерпании квоты срабатывает только после расхода всей квоты
OCS может назначить на исчерпание блокировку или переадресацию. Промежуточный порог лишь запускает отправку отчета. Если повесить действие на него, абонент с квотой 100 МБ окажется заблокирован после первых 10 МБ. Такие ошибки, как правило, выявляются по обращениям абонентов в поддержку.
Дробление ограничено снизу
Чем меньше часть квоты, тем больше отчетов, и при слишком мелком дроблении внутренний обмен тоже становится ощутимой нагрузкой. Поэтому у порога есть минимальное значение. Если даже с ним бюджет не выдерживается, PCEF выдает предупреждение. Выход за бюджет не должен проходить незаметно для оператора.
Место второе: перебалансировка
Потери в этом случае коварнее, потому что их почти не видно. Когда распределение абонентов по узлам считается как функция от списка живых узлов, любое изменение списка перекидывает часть сессий на другие узлы. Абонент при этом сразу заметит разрыв соединения. А вот то, что вместе со старой сессией пропал объем, накопленный после последнего отчета, никто не заметит.
Причем перебалансировка случается не только при авариях. Даже плановое добавление узла DPI, без которого не обходится ни одно расширение сети, приводит к перебалансировке. То есть учет теряется именно тогда, когда сеть, казалось бы, улучшают.
Подробнее о том, как расти без потерь для абонентов в статье — Масштабирование в модели CUPS: как расти, не задевая абонентов.
Чтобы объем не пропадал, сессию нужно переводить управляемо:
PCEF создает сессию на узле-приемнике, передает туда услуги и профили абонента и ставит порог на остаток квоты.
Трафик абонента переключается на приемник.
PCEF завершает сессию на узле-источнике, и тот присылает итоговый отчет.
PCEF складывает объемы с обоих узлов и устанавливает приемнику новый порог.
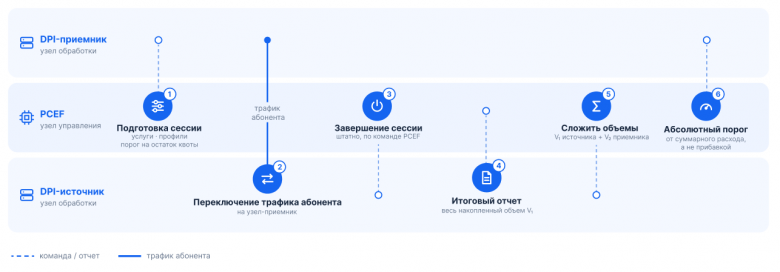
При таком переводе потерь нет. Источник завершает сессию штатно и перед этим отдает все, что накопил. Двойного учета тоже нет. Каждый байт насчитан только одним узлом, а новый порог приемнику задается абсолютным значением, рассчитанным от суммарного расхода по обоим узлам, а не как прибавка к тому, что приемник уже насчитать.
У управляемого перевода есть еще одно преимущество. Соединение абонента не прерывается, а потребление известно точно, значит, сессию тарификации не надо закрывать и открывать заново. При большом числе сессий разница ощутима. Закрытие и повторное открытие одной сессии — это четыре сообщения: запрос и ответ на закрытие, запрос и ответ на открытие. Выводите из работы узел с четырьмя миллионами сессий через закрытие-открытие — получите до шестнадцати миллионов сообщений в биллинг. При управляемом переводе обмена с OCS нет вообще.
Место третье: смена узла управления
PCEF хранит в памяти состояние сессий тарификации: выданные квоты, израсходованные объемы, сроки действия квот, номера запросов к OCS. При дроблении квоты сюда же добавляются суммы промежуточных отчетов. При отказе узла управления его сессии забирает другой PCEF. Однако без этого состояния он не может определить, сколько квоты осталось и когда она истекает. Поэтому состояние сессий хранится в общем хранилище, доступном всем узлам PCEF. К хранилищу есть два требования.
Сроки квот хранятся как абсолютное время окончания, а не как остаток
Запись «квота действует еще 400 секунд» бесполезна для нового узла управления, он не знает когда ее сделали. Запись «квота действует до 14:32:07» однозначна в любой момент. Естественно, это работает, только если часы на всех узлах PCEF синхронизированы.
Номер запроса к системе тарификации сохраняется в хранилище до отправки запроса, а не после
Каждый запрос в рамках сессии получает свой номер, и запрос с уже использованным номером OCS отбрасывает как дубликат. Допустим, PCEF отправил запрос и упал, не успев записать номер в хранилище. Новый узел берет из хранилища последний сохраненный номер и повторяет его. OCS отбросит запрос, новой квоты нет, сессия остается без квоты. Чтобы этого избежать, достаточно сначала сохранять номер и только потом отправлять запрос. В коде это одна перестановка строк. Сложно другое — вообще заметить проблему. Срабатывает она редко и выглядит как случайный глюк у одного абонента, который сложно воспроизвести.
Место четвертое: смена набора правил во время сессии
PCRF может поменять правила прямо во время сессии, например при переходе с дневного тарифа на ночной. Все, что насчитано до смены, должно учитываться по старым правилам, иначе дневной трафик уйдет в биллинг по ночному тарифу.
Механизм простой, но требует строгого порядка действий:
DPI получает от PCEF новые правила.
DPI отправляет отчет о накопленном объеме.
DPI применяет новые правила.
DPI подтверждает PCEF смену правил.
Подтверждение идет после отчета, поэтому к моменту, когда PCEF узнает о смене правил, весь объем по старым правилам уже учтется.
Между отправкой отчета и применением новых правил есть промежуток, в котором конфигурация учета не определена. На это время должно действовать правило по умолчанию, блокирующее трафик абонента. Лучше на мгновение придержать пакеты, чем пропустить их неизвестно по какому тарифу.
Не ждите сверки с биллингом
Ошибки учета сразу не всплывают, а к концу расчетного периода их причину уже не найти. Чтобы заметить проблему вовремя, следите за шестью показателями.
Показатель |
Что означает рост |
Разница между числом открытых и закрытых сессий тарификации |
Часть сессий не завершается штатно, итоговое потребление по ним не передается |
Число сессий, переведенных без итогового отчета |
Растет число случаев потери объема |
Средний интервал между отчетами по активным сессиям |
Растет множитель в формуле потери при отказе узла обработки |
Сумма порогов всех сессий на узле обработки |
Растет верхняя граница потери при отказе этого узла. Приближение к бюджету риска — повод пересмотреть дробление квот |
Отставание узлов от обновлений таблицы распределения сессий |
Узлы используют устаревшую таблицу распределения. Трафик абонента может попасть на узел DPI, который сессию уже не обслуживает |
Число отчетов от узла обработки, который больше не обслуживает сессию |
Растет число опоздавших отчетов |
Последний показатель требует пояснения. Когда сессию переводят на другой DPI, старый узел может прислать отчет с опозданием. Например, отчет ушел до переключения, а дошел до PCEF уже после. В таком отчете реальный трафик абонента, который еще нигде не учтен. Если PCEF отбросит его только потому, что узел больше не обслуживает сессию, объем пропадет. То есть шлюз потеряет учет сам, без всякой аварии. Так что опоздавшие отчеты нужно принимать и добавлять к расходу сессии, к которой они относятся.
Итог
Потери в учете возникают в четырех ситуациях, и неизбежна из них только одна — отказ узла обработки. Узел не успевает передать накопленный объем, и этот трафик выпадает из учета. Но даже здесь потеря под контролем: ее верхняя граница равна сумме порогов на узле, а через бюджет риска оператор сам решает, сколько готов потерять. В нашем решении PCEF подстраивает пороги под этот бюджет автоматически, так что граница потери при отказе любого узла известна заранее, а OCS не получает лишней нагрузки.
В остальных трех случаях потерь можно избежать, если с самого начала заложить правильный порядок действий:
при перебалансировке сессии переводятся на другой узел обработки управляемо;
сроки действия квот хранятся как абсолютное время;
номер запроса сохраняется до отправки запроса;
накопленный объем отправляется до смены правил.
Все это несложно сделать заранее. А вот выяснять причину расхождения после сверки с биллингом — занятие почти безнадежное.
Pooperrr
Человек придумал коня в вакууме и рассказывает о его достоинствах и недостатках.
Можно прикинуть нагрузку для Московского региона на узле с пропускной способностью 200 Гбит/с это примерно 60 млн. пакетов в секунду. Абонентов примерно 5 миллионов. Задача выглядит вполне решаемой.