

В Telegram нет счётчика сообщений. В личных чатах и обычных группах его нет ни в профиле, ни в настройках, ни в «Поиске». Статистика есть у каналов, но она про охваты и подписчиков, а не про переписку.
Поэтому в интернете живёт стая «лайфхаков»: «введите в поиск точку», «посмотрите номер последнего сообщения», «пролистайте до начала и прикиньте». Я решил не гадать, а сверить. Взял свои восемь чатов — шесть личных и две группы, 192 тысячи сообщений за семь лет, — и прогнал каждый способ по одним и тем же данным.
Короткий ответ. Точное число сообщений даёт только то, что считает сами записи: экспорт чата в JSON (количество записей "type": "message") или поле count в ответе API (оно считает и служебные записи). Поиск физически не может найти больше 63–95 % сообщений (остальные — без текста), номер сообщения завышает число в 3–180 раз, а «просто длина списка» в экспорте врёт на десятые доли процента — но врёт.
Ниже — как именно, с цифрами и кодом
Как проверял
Эталон — машиночитаемый экспорт Telegram Desktop («Экспорт истории чата» → JSON, без медиа). В нём каждое сообщение — отдельная запись с id, датой, автором и text; число записей "type": "message" и есть число сообщений. Служебные записи («пропущенный звонок», «закреплено сообщение») имеют "type": "service" и в счёт не идут.
Мои восемь чатов:
Тип |
Сообщений |
За какой период |
|---|---|---|
личный |
92 253 |
7 лет |
личный |
51 549 |
2,5 года |
личный |
18 640 |
5,5 лет |
группа |
12 721 |
1,7 года |
личный |
8 659 |
2,5 года |
группа |
7 617 |
1,4 года |
личный |
605 |
1,5 года |
личный |
132 |
неделя |
Дальше я называю чаты по размеру — «чат на 51 тысячу», «чат на 605 сообщений».
Оговорка: все группы у меня «обычные» (private_group), каналов и публичных супергрупп в выборке нет — это важно для способа №2, я к этому вернусь.
Способ 1. Поиск по чату: ищем «все» сообщения
Классический совет: откройте чат, нажмите лупу и введите частую букву или точку. Telegram покажет, сколько нашлось.
Проблема не в алгоритме, а в самой идее: поиск работает по тексту, а в живой переписке много сообщений без единого слова. Я посчитал, сколько сообщений в каждом чате вообще содержат текст — это потолок, выше которого поиск не поднимется, даже если найдёт всё, что умеет.
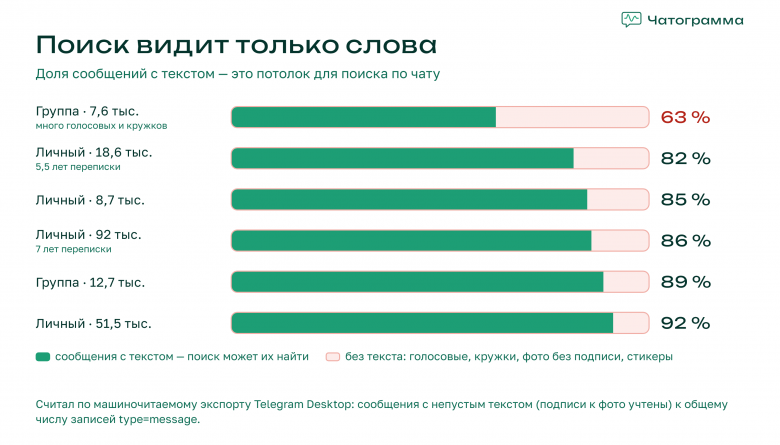
В личных чатах потолок — 82–95 % реального числа, в группе на 7,6 тысячи — всего 63 %: там почти 1400 голосовых и 600 «кружочков». Кстати, про точку: в чате на 51 тысячу она встречается в 4,7 % сообщений. Если поиск вообще принимает такой запрос, найдёт он двадцатую часть переписки.
Что не попадёт в поиск по умолчанию: голосовые, кружки, видео, фото без подписи, стикеры, гифки, контакты, геопозиции, опросы. Ничего плохого — просто это не слова.
Вывод: поиск годится, чтобы посчитать, сколько раз вы написали «люблю» или «ок». Как общий счётчик он по определению занижает: на 5–37 % в моих чатах, и это нижняя оценка ошибки — настоящий поиск ещё и ищет по словам, а не по символам.
Способ 2. Номер сообщения: «последнее сообщение — это количество»
Совет второй: возьмите номер (id) последнего сообщения — он и есть количество. Звучит логично: сообщения нумеруются по порядку, значит, номер последнего равен их числу.
Проверяем. В экспорте у каждой записи есть поле id. Сравним размах номеров (max(id) − min(id) + 1) с настоящим числом сообщений:
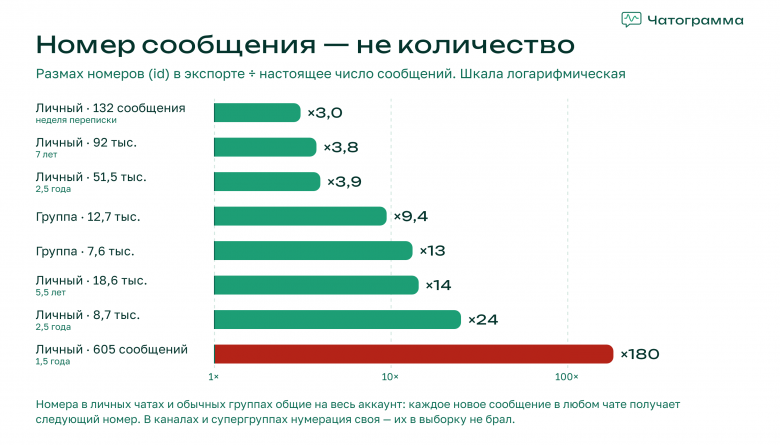
В чате на 51 тысячу номеров в 3,9 раза больше, чем сообщений. В чате на 605 сообщений — в 180. Причина в том, как Telegram нумерует сообщения в личных чатах и обычных группах: счётчик общий на весь аккаунт, а не свой у каждого чата. Каждое новое сообщение в любом из моих чатов — от любого человека — получает следующий номер. Номера одной переписки разбросаны среди номеров всех остальных чатов, как редкие занятые клетки в большой таблице.
В самом большом чате из 346 428 «подряд идущих» номеров занято 92 253 — только каждый четвёртый. Остальные ушли другим чатам.
Заодно у этого счётчика интересное свойство: он монотонный, то есть работает как часы. Вот самый большой чат: настоящее число сообщений (тёмная линия) и номер сообщения (зелёная линия) по месяцам.
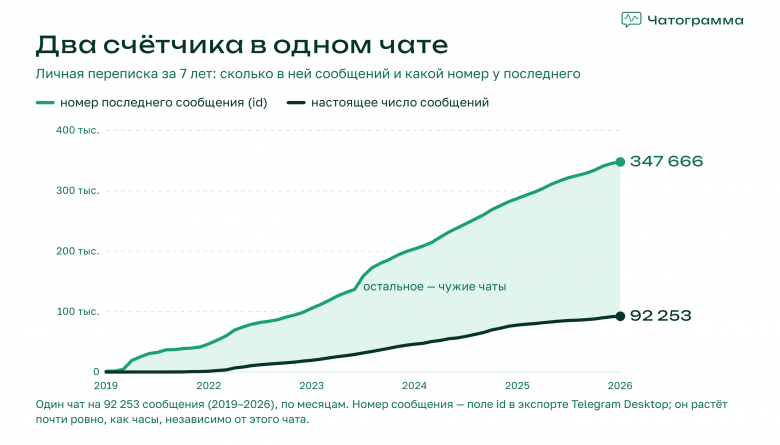
Номер растёт почти ровно: примерно по 6 тысяч в месяц у меня в 2024–2026 годах, то есть около 200 сообщений в день проходит через аккаунт.
Где этот совет работает. В каналах и публичных супергруппах нумерация своя у каждого чата, и номер последнего сообщения действительно ≈ числу сообщений за всё время (плюс удалённые — их номера пропущены). Я их в выборку не брал, проверять не буду, но по документации API так и должно быть. Для личных чатов и обычных групп — нет.
Вывод: в личном чате номер — это не количество. Но им можно пользоваться как часами.
Способ 3. «Просто посчитать записи» в экспорте
Допустим, у вас есть result.json. Первое, что приходит в голову: len(data["messages"]). Почти правильно:
Чат |
Записей в |
Сообщений ( |
Разница |
|---|---|---|---|
личный, 92 тыс. |
92 291 |
92 253 |
+38 |
личный, 51 тыс. |
51 623 |
51 549 |
+74 |
группа, 7,6 тыс. |
7 622 |
7 617 |
+5 |
личный, 132 сообщения |
132 |
132 |
0 |
Лишнее — служебные записи: пропущенные звонки, закрепления, подарки, приглашения. В моих чатах это 0,04–0,18 %. Не страшно, но «примерно» — это не то, ради чего считают.
Поэтому фильтр по типу нужен всегда, а ещё лучше — один из способов ниже.
Способ 4. Свой скрипт (Python, grep, PowerShell)
Самый простой точный вариант — Python в пять строк:
import json

with open("result.json", encoding="utf-8") as f:
    data = json.load(f)

messages = [m for m in data["messages"] if m["type"] == "message"]
print(len(messages))
На 23-мегабайтном файле с 51 549 сообщениями это 0,27 секунды, на 43-мегабайтном (92 тысячи) — 0,56 (Ryzen 7 5800X, Python 3.14, лучшее из трёх запусков).
Если не хочется писать код, можно вообще обойтись без разбора JSON. Telegram Desktop пишет экспорт с отступами, по одной записи на «объект», и строка "type": "message" в нём встречается ровно по разу на сообщение:
grep -c '"type": "message"' result.json
(Select-String -Path result.json -Pattern '"type": "message"' -SimpleMatch).Count
Я сверил grep на всех восьми файлах — результат совпал с Python до единицы; занимает 0,03 с на 23 МБ (PowerShell — 0,7 с). Это не законный парсинг, а прагматичный трюк: он опирается на форматирование экспорта и сломается, если Telegram его поменяет. Для разовой цифры хватит.
Но ловушки начинаются, когда считаете не «сколько всего», а что-то про текст. Три, на которые я сам налетел:
text— то строка, то список. Если в сообщении есть ссылка, жирный шрифт или упоминание, Telegram записывает текст массивом кусков:["Привет, ", {"type": "link", "text": "…"}]. У меня таких 2,8 % сообщений (1452 в чате на 51 тысячу). Наивноеlen(m["text"])для них посчитает куски, а не символы, аm["text"].lower()упадёт.У сообщений без текста
text— пустая строка, а не отсутствующее поле. Их не отличить от «ответа без слов», пока не посмотреть наmedia_type/photo/file.Поля бывают не у всех. У меня одно сообщение из 92 253 пришло без
textвовсе —m["text"]упадёт сKeyError; для необязательных полей (from,media_type,forwarded_from) беритеm.get(...).
Безопасный способ склеить текст:
def text_of(m):
    t = m.get("text", "")
    if isinstance(t, str):
        return t
    return "".join(p if isinstance(p, str) else p["text"] for p in t)
И чтобы разделить сообщения по авторам:
from collections import Counter
by_author = Counter(m.get("from") for m in messages)
Способ 5. API: у приложения нет счётчика, а у сервера есть
Всё это время мы пытались вытащить число из того, что показывает интерфейс. Но сервер Telegram число знает: ответ на messages.getHistory содержит поле count — сколько сообщений в диалоге. Интерфейс просто не показывает его.
В Telethon это одна строка:
from telethon.sync import TelegramClient

with TelegramClient("session", API_ID, API_HASH) as client:
    chat = client.get_entity("username")
    print(client.get_messages(chat, limit=0).total)
С limit=0 сообщения не скачиваются — приходит только число. По тому же принципу можно спросить число фото, голосовых или видео (filter=InputMessagesFilterPhotos и так далее).
Я проверил это на чате, в котором с июня 2025 ничего не менялось: в экспорте 18 640 сообщений плюс 37 служебных записей (звонки и закрепы). API вернул 18 677. Это ровно длина списка messages, а не число сообщений: count считает всё, что лежит в истории, включая служебные записи. Так что «точно» здесь с оговоркой: чистое число — это count минус служебные.
Нужны api_id и api_hash вашего аккаунта (получаются на my.telegram.org) и файл сессии, который открывает доступ к аккаунту целиком. Хранить его надо как пароль, а после замера — удалить и завершить сеанс в «Настройки → Устройства». Для разового подсчёта это перебор; для регулярного — единственный способ без выгрузки файла.
Итог: что и насколько врёт
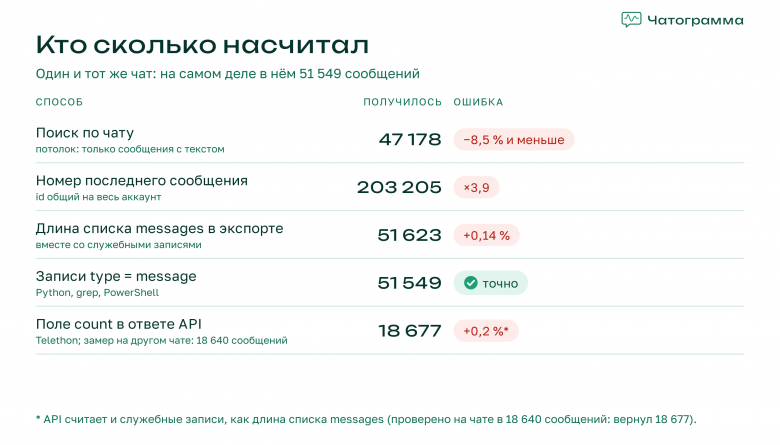
Для чата на 51 549 сообщений:
Способ |
Что получилось |
Ошибка |
|---|---|---|
Поиск по чату (потолок: только сообщения с текстом) |
не больше 47 178 |
−8,5 % и меньше |
Номер последнего сообщения |
203 205 |
×3,9 |
Длина |
51 623 |
+0,14 % |
|
51 549 |
0 |
API |
18 677 (в другом чате на 18 640) |
+0,2 %: тоже со служебными |
Что считать «сообщением»
Даже когда способ выбран, остаются три вопроса, на которые математика не ответит:
Удалённые. Если сообщение удалили у обоих, его нет ни в экспорте, ни в счётчике API. Если только у одного — в вашем экспорте оно останется.
Пересланные и правки. В чате на 51 тысячу 4,3 % сообщений пересланные (2208), а 13,7 % отредактированы (7080). Правка не создаёт нового сообщения, пересланное считается.
Медиа и служебные. Фото, голосовое и кружок — по одному сообщению. Звонки и закрепы — служебные записи, в «количество» их обычно не включают.
Число — только начало. Интереснее, как оно делится: кто пишет первым, кто отвечает быстрее, в какие часы вы на связи. Но для этого файл надо разобрать, а разбор экспорта — отдельная история: форматы Telegram, ВКонтакте и WhatsApp не похожи друг на друга, в каждом свои сюрпризы. Об этом — в следующей статье.
Если считать не хочется
Из-за этих ловушек и из-за вопроса «что дальше с цифрой» я написал инструмент, который берёт файл экспорта и считает всё сам, прямо в браузере, не отправляя переписку на сервер: Чатограмма. Пошаговая инструкция и разбор — по ссылке.
А если вы сравните свои цифры с моими — мне интересно, во сколько раз ваш номер сообщения оторвался от настоящего количества. Пишите в комментариях.