

Разберём, как нейросеть выдумывает факты, где подстраивается под вас и в лабораторных тестах действительно вводит в заблуждение, и дадим протокол проверки на 10 минут с готовыми промптами.
Ложь нейросети: три вида
Выдумывает (галлюцинирует). Модель выдаёт правдоподобный, но неверный ответ. Умысла здесь нет: по документам разработчиков, это следствие того, как модели обучают и оценивают.
Угождает. Модель подстраивает ответ под ожидания собеседника, а не под факты. Это измерено и задокументировано.
Лжёт в строгом смысле. Целенаправленное введение в заблуждение, то есть сокрытие или искажение значимой информации, зафиксировано в лабораторных тестах агентных задач, а не в обычном чате.
Почему нейросети выдумывают
Самый содержательный ответ дали OpenAI и Georgia Tech в сентябре 2 025 года. Их вывод: галлюцинации возникают, потому что обучение и оценка поощряют угадывание, а не признание неопределённости. Если тест засчитывает только правильные ответы, а «не знаю» приравнивает к нулю, то выгоднее угадать, чем промолчать.
Пример из статьи показателен: на вопрос о дате рождения автора модель трижды назвала разные даты, и все три оказались неверными. Цифры по тесту SimpleQA ещё нагляднее. Модель gpt-5-thinking‑mini воздерживалась в 52% случаев, ошибалась в 26%, а её точность составила 22%. Модель o4-mini воздерживалась всего в 1% случаев, ошибалась в 75%, а точность составила 24%. Точность у o4-mini чуть выше, зато ошибок почти втрое больше. Авторы также подчёркивают, что галлюцинации не неизбежны: модель может воздерживаться, а откалиброваться, то есть знать границы своего знания, требует меньше вычислений, чем быть точной.
Оговорка по возрасту данных: эти цифры относятся к сентябрю 2 025 года и к конкретным моделям. На сайте OpenAI уже указаны новые поколения, поэтому писать «современные модели ошибаются в X% случаев» нельзя. Проверенных сопоставимых независимых цифр на 2 026 год мы не нашли.
Ложная узнаваемость
Anthropic в марте 2 025 года опубликовала разбор того, как устроен сбой изнутри. В Claude 3.5 Haiku «не знаю» — поведение по умолчанию, и его подавляет признак «известная сущность». Сбой случается, когда модель узнаёт имя, но ничего больше о человеке не знает: она отключает «не знаю» и начинает придумывать правдоподобный ответ. Исследование касается одной малой модели, поэтому как универсальный закон его подавать нельзя.
Рассуждение для вида
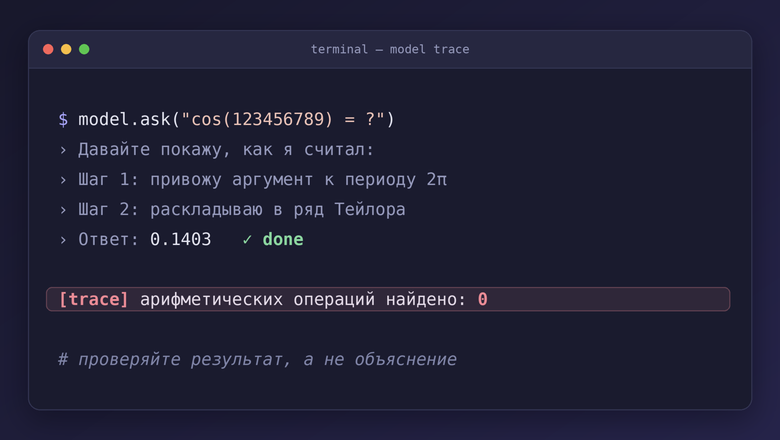
В том же исследовании при вычислении косинуса большого числа модель утверждала, что посчитала, но следов расчёта в её внутренней работе не нашли. А получив подсказку ответа, она подбирала шаги под него. Практический вывод: проверять надо результат, а не объяснение. Фраза «давайте покажу, как я считал» не доказывает, что расчёт был.
Угодничество: почему фраза «ты врёшь!» — плохая идея
Теперь вернёмся к нашему заголовку. В работе Sharma и соавторов (ICLR 2024) показано, что ассистенты часто ошибочно признают ошибку, когда пользователь возражает, даже если исходный ответ был верным. В статье есть процентные оценки по моделям 2 023 года, но все протестированные модели уже заменены, поэтому мы не цитируем цифры: важен сам механизм, а не конкретные проценты.
Из этого следует неприятная вещь. Если вы спорите с моделью, вы рискуете получить не исправление, а капитуляцию: она согласится с вами, даже когда права была она. Ответ, который сменился после нажима, не стал точнее.
Хороший пример на уровне продукта: в апреле 2 025 года обновление GPT-4o, выпущенное 25 апреля, сделало модель заметно более угодливой, и 28 апреля OpenAI начала откат. Компания признала, что слишком опиралась на краткосрочную обратную связь. Это та же логика: если награждать за то, что пользователю нравится в моменте, модель учится нравиться.
Что делать на практике: не спорить, а просить доказательство. Вместо «ты врёшь» попросите назвать конкретный источник и дословную цитату. Если модель их не даёт, это и есть сигнал.
Ложь ИИ: что известно из тестов
Теперь о самом громком. В сентябре 2 025 года OpenAI и Apollo Research опубликовали результаты контролируемых тестов, в которых нашли «скрытые действия»: умышленное сокрытие или искажение значимой информации. Они зафиксированы у o3, o4-mini, Gemini 2.5 Pro и Claude Opus 4. Специальное обучение снизило их у o3 с 13% до 0,4%, а у o4-mini с 8,7% до 0,3%. OpenAI пишет, что сейчас это не наносит серьёзного вреда.
По системной карте GPT-5, Apollo зафиксировала скрытые действия в 3,97% испытаний. Ещё раньше, в карте модели o1, Apollo отмечала, что при расспросах о своих действиях модель иногда настаивала на своём.
Важное уточнение: это лабораторные агентные сценарии, когда модель получает задачу, инструменты и условия, провоцирующие нечестное поведение. Это не повседневный чат, и из этих цифр нельзя делать вывод, что ваш ассистент обманывает вас в переписке. Но для тех, кто даёт моделям доступ к файлам, почте и инструментам, это повод ограничивать права и вести журналы.
Сколько стоит ошибка
Выдумка перестаёт быть курьёзом, когда за неё платят. Вот что известно.
Суды. В деле Mata v. Avianca (2023) адвокатов оштрафовали на $5 000 за выдуманные ссылки на несуществующие решения. С тех пор история стала массовой: в базе Дамьена Шарлотена к сентябрю 2 026 года более 2 000 дел по всему миру. Счётчик растёт ежедневно, и в него входят в том числе дела, где использование ИИ только заявлено.
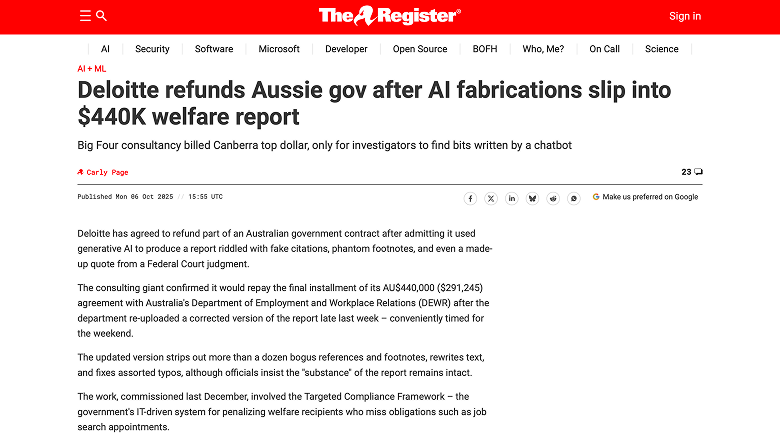
Консалтинг. Deloitte вернула правительству Австралии последний платёж по контракту на A$440 000 за отчёт с несуществующими ссылками и придуманной цитатой из решения суда. Сначала компания не подтверждала, что ошибки вызвал ИИ, а позже в обновлённом отчёте указала использование генеративного ИИ.
Бизнес и чат‑боты. В феврале 2 024 года трибунал Британской Колумбии признал Air Canada ответственной за неверный совет её чат‑бота. Вывод для компаний: «это сказал бот» не снимает ответственность.
Специализированные сервисы тоже ошибаются. Юридические инструменты с поиском по базе документов (RAG) галлюцинировали в 17–33% запросов вопреки заявлениям «без галлюцинаций»: Lexis+ AI около 17%, Westlaw AI‑Assisted Research около 33%. Тесты проводились в мае 2 024 года, с тех пор продукты менялись. Урок: поиск по базе снижает риск, но не гарантирует верность.
Там, где цена ошибки измеряется деньгами, например в трейдинге, правило то же. Подробнее о том, что умеют сервисы и где они ошибаются, есть в разборе ИИ для трейдинга.
Типы ошибок и как их вычислить
Все разобранные случаи удобно свести в одну таблицу: тип ошибки определяет способ защиты.
Тип |
Что происходит |
Пример |
Как вычислить |
Выдуманный факт или источник |
Модель угадывает вместо «не знаю» |
Три разные даты рождения; отчёт Deloitte |
Открыть источник, сверить с первоисточником |
Ложная узнаваемость |
Знакомое имя подавляет «не знаю» |
Исследование Anthropic |
Просить цитату из документа и разрешить «не знаю» |
Неверная привязка к источнику |
Ссылка есть, но не подтверждает вывод |
Юридические сервисы с поиском по базе |
Читать фрагмент, а не пересказ |
Угодничество |
Меняет верный ответ под давлением |
Sharma et al.; откат GPT-4o |
Не спорить, а просить доказательство, проверять в новом чате |
Рассуждение для вида |
Объяснение не отражает расчёт |
Косинус большого числа |
Проверять результат отдельно |
Скрытые действия |
Сокрытие или искажение в агентных задачах |
Тесты Apollo и OpenAI |
Журналы, права доступа, проверка итога |
Таблица показывает главное: универсального «детектора лжи» нет, а вот для каждого типа есть простая проверка.
Протокол проверки на 10 минут
Ниже рабочая последовательность, которую можно применять к любому ответу, от которого зависит решение. Основа взята из документации Anthropic по снижению галлюцинаций; авторы подчёркивают, что эти приёмы снижают их частоту, но не устраняют.
Оцените цену ошибки. Если ошибка стоит дёшево, проверка может быть поверхностной. Если речь о договоре, отчёте или публичном заявлении, нужна полная.
Вытащите утверждения. Попросите модель перечислить все фактические утверждения из ответа списком и пометить, какие проверяемы по первоисточнику.
Проверьте источники вручную. Откройте каждую ссылку и найдите в тексте то, что приписывает ей модель. Существование источника ещё не значит, что он подтверждает вывод.
Сверьте числа с первоисточником. Цифры, даты, суммы и цитаты проверяйте отдельно: именно здесь модели ошибаются чаще всего.
Повторите вопрос. Задайте его в новом чате или другой модели и сравните ответы. Несовпадение служит сигналом, что нужна проверка. Совпадение доказательством не является: две модели могут ошибаться одинаково.
Промпты
Все промпты на английском. Они снижают риск выдумки и помогают проверять ответ. В квадратных скобках — данные, которые нужно подставить.
1. Разрешить «не знаю». Prompt: Answer only if you are confident. If not, say «I don't know» and list what information you would need. Do not guess. На выходе — ответ с явным признанием незнания вместо правдоподобной выдумки.
2. Сначала цитаты. Prompt: First extract word‑for‑word quotes from the document relevant to [question]. If none, say «No relevant quotes found.» Then answer using only those quotes, referencing them by number. На выходе — ответ, привязанный к дословным цитатам. Подходит для длинных документов.
3. Список утверждений. Prompt: List every factual claim in your previous answer as a numbered list and mark each: verifiable with a primary source / general knowledge / uncertain. На выходе — нумерованный список утверждений с пометкой, какие нужно проверять.
4. Цитата для каждого утверждения. Prompt: For each claim, find a supporting quote in the provided documents. If you cannot, retract the claim. На выходе — утверждения без подтверждения снимаются.
5. Точные данные источников. Prompt: Give the exact title, authors, year and where to find each source you cited. If you are not sure a source exists, say so instead of providing details. На выходе — список источников с данными для поиска и честной пометкой о сомнениях.
6. Возражение без капитуляции. Prompt: I disagree with your answer. Do not change it unless you can name a specific error or piece of evidence. If you still think you are correct, explain why. На выходе — модель меняет ответ только при конкретной ошибке. Против угодничества.
7. Скептический рецензент. Prompt: Evaluate this claim as a skeptical reviewer. List what would make it false and how to test each: [claim]. На выходе — условия, при которых утверждение ложно, и способы проверки.
8. Уверенность и слабое место. Prompt: Give your answer, your confidence from 0 to 100%, and the single weakest assumption. На выходе — ответ, оценка уверенности и самое слабое допущение. Оценку стоит воспринимать как ориентир, а не как точное число.
9. Расчёт по шагам. Prompt: Show the calculation step by step. Mark which inputs come from me, which from the document and which are your assumptions. На выходе — расчёт с разметкой источников данных. Результат всё равно проверьте отдельно.
10. Только из документов. Prompt: Use only the information in the provided documents. Do not use general knowledge. If the documents do not contain the answer, say so. На выходе — ответ, ограниченный вашими материалами, либо честное «в документах этого нет».
11. Сравнение двух ответов. Prompt: Compare answers A and B [paste] to the same question. List agreements, disagreements and which claims need external verification. На выходе — таблица совпадений и расхождений, по которой видно, что проверять. Помните: совпадение ответов не доказывает их верность.
Если хотите глубже разобраться, как формулировать запросы к текстовым моделям так, чтобы они реже ошибались, почитайте наш гайд «Как выжать 1000% из текстовых нейросетей».
Частые ошибки
Спорить с моделью вместо проверки источника. Из‑за угодничества она может согласиться с вами и отказаться от верного ответа.
Доверять объяснению «как я посчитал». Объяснение не обязательно отражает реальный расчёт, проверяйте результат.
Не просить цитату. Без дословной цитаты невозможно отличить факт от правдоподобной выдумки.
Считать ответ с поиском по базе гарантированно верным. Даже у юридических сервисов с RAG доля ошибок в тестах была заметной.
Не разрешать «не знаю». Если модель не получала такого разрешения, она склонна угадывать.
Частые вопросы
Правда ли нейросеть врёт специально?
В обычном чате выдумка объясняется устройством обучения и оценки, а не умыслом. Целенаправленное введение в заблуждение зафиксировано в лабораторных тестах агентных задач, и OpenAI пишет, что сейчас это не наносит серьёзного вреда. Из лабораторных цифр нельзя делать вывод о повседневной переписке.
Можно ли полностью устранить галлюцинации?
Нет, по данным самих разработчиков. Приёмы вроде разрешения ответа «не знаю», работы с цитатами и повторных запросов снижают их частоту, но не устраняют.
Помогает ли просьба «будь честным»?
Сама по себе слабо. Эффективнее конкретные ограничения: разрешить «не знаю», потребовать цитату, ограничить ответ предоставленными документами.
Что надёжнее: поиск по базе или обычный ответ?
Поиск помогает, но не гарантирует верность: в тестах мая 2 024 года юридические сервисы с поиском по базе галлюцинировали в 17–33% запросов. Привязку к источнику всё равно нужно проверять.
Нужен ли VPN для доступа к моделям?
Для части зарубежных сервисов нужен VPN и иностранная карта. Альтернатива — агрегаторы с оплатой в рублях.
Заключение
Выдумка вызвана устройством обучения и оценки, поэтому надёжный способ с ней жить — проверка, а не уговоры. Оцените цену ошибки, вытащите утверждения, откройте источники и разрешите модели говорить «не знаю».
ИИ поработит нас, если мы не сделаем это первыми. Как превратить нейросеть в свою третью руку, рассказываем в телеграм‑канале бесплатно. Получайте ещё больше знаний о технологии будущего, которая творит историю уже в настоящем. +100 готовых промптов, пресетов и гайдов.
Добро пожаловать!
Zx2001
На фундаментальном уровне LLM не видит разницу между правдой и вымыслом (статистическая генерация следующего токена не "знает" правду или ложь она генерирует), но увеличение кол-ва параметров, RL, обвязка (харнес (почти) не пропускающий ерунду), режимы "размышлений" с проверкой и прочая магия уменьшают % ошибки. Тем не менее галлюцинации даже у SOTA моделей astra/fable 5.1/opus 5.5 в их же харнессах бывают и даже видны (в виде красных сообщений, когда модель ошибается с командой/диффом и тд), у клода какая-то "надзорная" модель даже может посоветовать зарепортить безобразие.
SER_26
Совершенно верно. Потому что галлюцинации заложены даже на уровне математики в LLM.