

Привет, Хабр! Меня зовут Тимур, я отвечаю за маркетплейс в Cloud.ru: партнеры публикуют в каталоге свои сервисы и приложения, а клиенты облака подключают их в несколько кликов и оплачивают вместе с остальными облачными ресурсами. Все больше таких сервисов строится на ИИ, и работают они в том же облаке, что и клиенты. Поэтому модели и инфраструктура в расчете ниже взяты из каталога Cloud.ru: это наши сервисы, и их тарифы я знаю лучше чужих.
Тема цены интересует меня не из любопытства. Вендор на маркетплейсе должен назначить цену своему агенту, клиент должен ее понять, а площадка должна сделать так, чтобы цены на витрине можно было сравнивать между собой. Пока все три стороны меряют стоимость токенами, ничего из этого не получается.
Мои прошлые две статьи были про OpenClaw: как развернуть агента и не слить ему данные и почему мажорную версию мы ставим в каталог рядом, а не поверх. Эта статья будет про деньги.
«Закрыто» и «решено» — разные понятия
Прежде чем что‑то считать, нужно договориться о единице. Токен в этой роли плох: клиент покупает не токены, а закрытые обращения. Но и «закрытый диалог» оказывается единицей лукавой.
Если агент ответил и клиент замолчал, большинство платформ считают диалог решенным. Intercom в документации Fin честно делит решенные диалоги на два вида. Подтвержденные решения получаются, когда клиент написал «спасибо, помогло». Предполагаемые решения засчитываются, когда клиент просто вышел из диалога и не попросил помощи. Оплачиваются оба вида. Правда, с оговоркой, которую стоит взять на вооружение: если клиент вернулся в тот же диалог за помощью, решение снимается и не оплачивается.
Lorikeet, которые собрали 195 публичных кейсов по 38 вендорам, приводят показательный пример. Из 4 200 диалогов, закрытых ИИ, 900 были закрыты ссылкой на статью базы знаний. Без них доля решенных падает с 70 до 55%.
Разница между «закрыто» и «решено» равна разнице между отчетом вендора и тем, что клиент увидит в повторных обращениях.
Поэтому единицей в этой статье я беру полезный ответ: диалог закрыт без человека, клиент не вернулся с тем же вопросом в течение 72 часов и не поставил негативную оценку. Все, что не прошло хотя бы один из трех фильтров, в знаменатель не попадает, зато попадает в числитель. В этом и состоит главный прием всей арифметики: неудачные попытки оплачиваются удачными.
Кейс: ИИ‑оператор первой линии в интернет‑магазине
Кейс модельный, я собрал его из типовых параметров, а не из отчета конкретного клиента. Сценарий я сознательно взял самый массовый, то есть поддержку, потому что по ней больше всего публичных данных.
Интернет‑магазин получает 40 000 обращений в месяц. Маршрутизация отдает ИИ‑агенту 90% из них, то есть 36 000 диалогов.
Диалоги, которые агент закрыл сам без передачи оператору, я дальше называю автозакрытиями. Это та самая метрика, которую вендоры показывают первой.
Сам агент устроен так: поиск по базе знаний с генерацией ответа (RAG) плюс инструмент «статус заказа». На один диалог уходит три вызова LLM:
понять запрос и выбрать маршрут,
ответить по найденным фрагментам,
сходить в инструмент или собрать резюме для оператора.
В сумме это около 12 000 входных токенов (системный промпт, найденные фрагменты, история) и 800 выходных, а запросов к базе знаний получается два на диалог. Сверху работает модель‑фильтр, которая проверяет реплику клиента и ответ агента перед отправкой, по 1 000 токенов на каждый из трех вызовов. Еще 15% токенов я закладываю на повторные генерации.
База знаний лежит в Evolution Managed RAG, сам агент работает в Evolution AI Agents, логи диалогов пишутся в Evolution Managed PostgreSQL. Это наши сервисы, они у меня под рукой так же, как и тарифы, поэтому инфраструктуру я считаю по ним.
Оператор поддержки в Москве стоит работодателю примерно 125 000 ₽ в месяц: 85 300 ₽ составляет средняя предлагаемая зарплата специалиста техподдержки по данным hh.ru за 2 025 год, сверху ложатся взносы и накладные. При 40 тикетах в день один тикет обходится в 149 ₽ Минута оператора стоит 15,5 ₽: 125 000 я делю не на все 10 080 минут месяца, а на 80% из них, потому что перерывы, планерки и неровная очередь съедают остальное.
Эти две цифры — 149 ₽ за тикет и 15,5 ₽ за минуту — дальше встретятся несколько раз, и они же самые спорные в статье. Оператор чата в ритейле дешевле специалиста техподдержки и закрывает больше тикетов. При 60 обращениях в день один тикет стоит уже 99 ₽, и часть выводов ниже заметно бледнеет. Я покажу, где именно.
Остальные допущения я свел в таблицу. Если ваши цифры другие, подставьте их: весь расчет линейный.
Параметр |
Значение |
Откуда |
|---|---|---|
Доля автозакрытий (диалогов, которые агент закрыл без человека) |
50% |
Медиана по 195 публичным кейсам составляет 70%, но это внедрения, которые вендоры сами выбрали для публикации. Российский ориентир дает Ozon: бот закрывал 27% обращений в 2 020 году и 62% в 2022-м. Беру середину |
Закрытые диалоги, не прошедшие фильтр: клиент вернулся за 72 часа или поставил минус |
6% |
Допущение, скорее оптимистичное: в примере Lorikeet 21% закрытых диалогов были закрыты одной ссылкой на статью. Чувствительность до 15% разбираю ниже |
Цена одного такого диалога |
≈ 200 ₽ |
Компенсация 150 ₽ плюс 3 минуты оператора на разбор вернувшегося диалога сверх обычного тикета. Сам повторный тикет не считаю: без агента он стоил бы те же 149 ₽ |
Эскалация |
1,5 мин оператора сверх обычного тикета |
Среднее по больнице: при теплой передаче с резюме и предзаполненным тикетом оператор может и сэкономить минуту, без резюме теряет три и больше. Чувствительность разбираю ниже |
Выборочная проверка |
3% всех диалогов агента по 3 мин |
Ручная проверка, без нее качество не увидеть |
База знаний, промпты, проверочные наборы |
100 000 ₽/мес |
Половина ставки специалиста. Оптимистично, реальнее целая ставка, ее тоже посчитаю |
Внедрение |
600 000 ₽ на год |
Амортизация, 50 000 ₽/мес. Для интегратора с подключением к CRM и заказам ближе к 1 500 000 ₽ |
Инфраструктура |
13 420 ₽/мес |
По тарифам Cloud.ru, расчет ниже |
Цены на модели я взял из тарифа Evolution Foundation Models версии от 2 октября 2 026 года, с НДС 22%, за миллион токенов (вход / выход):
Модель |
Вход |
Выход |
|---|---|---|
Qwen3-30B‑A3B |
16,24 ₽ |
64,94 ₽ |
GigaChat-3-Pro |
73,03 ₽ |
176,39 ₽ |
Claude Haiku 4.5 |
196,42 ₽ |
982,10 ₽ |
Claude Sonnet 4.6 |
589,26 ₽ |
2 946,30 ₽ |
HiveTraceGuard‑Pro (модель‑фильтр) |
42,70 ₽ |
бесплатно |
Между самой дешевой и самой дорогой моделью в этой четверке разница в 36 раз по входу и в 45 раз по выходу. Запомните и ее: дальше она почти исчезнет.
Инфраструктуру я посчитал по тарифам платформы Cloud.ru Evolution от 28 сентября 2 026 года, тоже с НДС, из расчета 730 часов в месяце:
Сервис |
Конфигурация |
Тариф |
В месяц |
|---|---|---|---|
Evolution AI Agents |
4 vCPU + 8 ГБ RAM, выделенные |
1,5616 ₽ за vCPU‑час, 0,3904 ₽ за ГБ‑час |
6 840 ₽ |
Evolution Managed RAG |
2 ГБ базы знаний, 72 000 запросов |
1,3664 ₽ за ГБ‑час, 0,0976 ₽ за 1 000 запросов |
2 000 ₽ |
Evolution Managed PostgreSQL |
2 vCPU, 4 ГБ RAM, 100 ГБ SSD, под логи |
1,49145 ₽ за vCPU‑час, 0,4026 ₽ за ГБ‑час, 0,016836 ₽ за ГБ диска в час |
4 580 ₽ |
Итого инфраструктура обходится в 13 420 ₽ в месяц. Запомните эту цифру тоже: инфраструктура окажется самой дешевой строкой во всем расчете.
Токены — это 5% цены ответа
Сначала я считаю один диалог:
на Qwen3-30B‑A3B он стоит 0,43 ₽,
на GigaChat-3-Pro 1,32 ₽,
на Claude Haiku 4.5 3,76 ₽,
на Claude Sonnet 4.6 10,99 ₽
Разница получается в 25 раз, и если бы статья заканчивалась здесь, выбор модели был бы главным решением проекта.
Теперь я делю расходы не на диалоги, а на полезные ответы. Из 36 000 попыток при 50% автозакрытий закрыты 18 000, из них 6% оказываются ошибками, остается 16 920 полезных. На каждый полезный ответ ложатся не только его токены, но и токены неудачных попыток, минуты операторов на эскалации, стоимость ошибок, проверка, база знаний и внедрение.
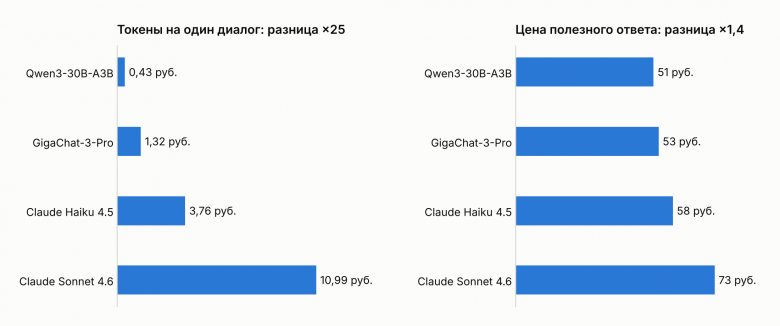
Разница в 25 раз превратилась в разницу в 1,4 раза: от 51 ₽ до 73 ₽ за полезный ответ. Модель, которая дороже в 25 раз по токенам, в цене результата дороже на 40%. Токены не подешевели, просто все остальное в этом расчете стоит одинаково для любой модели.
«В этом расчете» здесь важная оговорка: я намеренно держу долю автозакрытий и ошибок одинаковой для всех четырех моделей, чтобы увидеть чистую цену токенов. Что происходит, когда дорогая модель действительно умнее, я покажу ниже с цифрами.
Вот из чего складываются 53 ₽ на GigaChat-3-Pro:
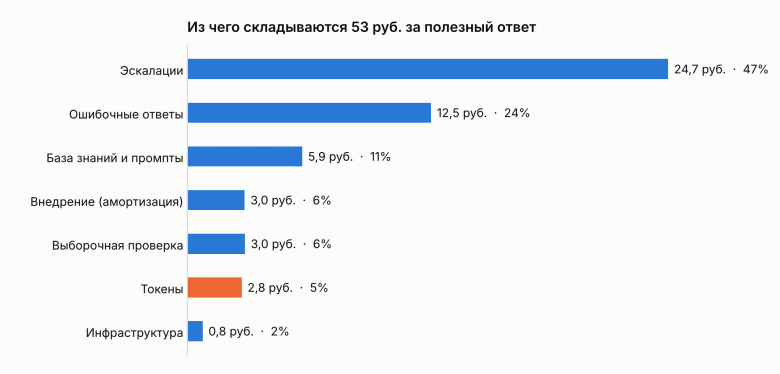
Две верхние строки, эскалации и ошибочные ответы, дают 71% цены. Ни та, ни другая не выглядят как «расходы на ИИ» ни в одном бюджете: эскалации сидят в зарплатах поддержки, ошибки прячутся в компенсациях и оттоке. Токены, единственная строка, которую все сравнивают при выборе, стоят 2,8 ₽ из 53, то есть 5%. Вся облачная инфраструктура стоит 80 копеек.
На дорогой модели картина другая: на Claude Sonnet 4.6 токены занимают уже 32% цены ответа. Здесь экономить на токенах имеет смысл, и самый дешевый способ состоит не в замене модели, а в урезании контекста. 12 000 входных токенов на диалог означают щедро нарезанную выдачу поиска. Если сократить контекст до 6 000, полезный ответ на Sonnet дешевеет с 73 до 65 ₽
Второй рычаг дает кеширование. Чтение из кеша у Claude в тарифе стоит в десять раз дешевле обычного входа, и если половина контекста состоит из неизменного системного промпта, те же 73 ₽ превращаются в 66. На Qwen оба приема экономят копейки.
Главный рычаг — не цена модели, а доля автозакрытий
Если вместо модели двигать долю диалогов, которые агент закрывает сам, кривые выглядят так:
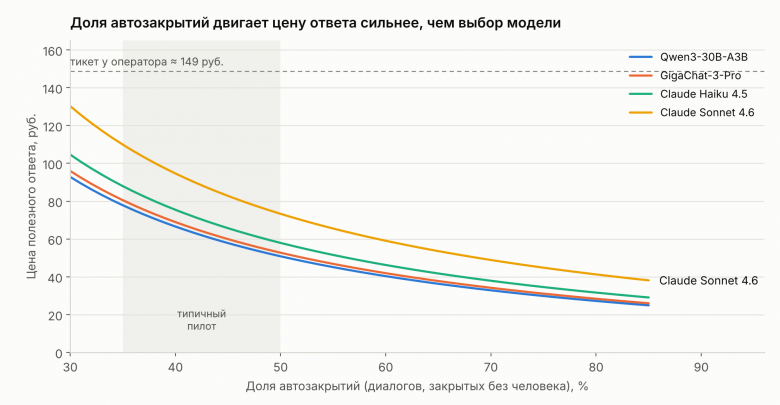
Серой полосой я отметил зону типичного пилота: 35–50% автозакрытий. Ozon, судя по их же статье, стартовал ниже, с 27%, и за два года дошел до 62%, так что полоса не теоретическая. На левом краю этой полосы полезный ответ на Sonnet стоит 110 ₽, на Qwen 78 ₽ На правом краю получается 73 и 51 ₽ Переход от пилота к рабочему контуру с 65% автозакрытий дает еще минус 15–19 ₽
Десять процентных пунктов автозакрытий дают примерно столько же, сколько переход на класс дешевле: на Sonnet рост с 50 до 60% экономит 14 ₽, замена Sonnet на Haiku экономит 15 ₽ Только первое работает на любой модели, а второе срабатывает один раз.
С ошибками история та же, только круче. Долю закрытых диалогов, которые не прошли фильтр, мало кто измеряет, а она двигает цену сильнее, чем вся строка «токены»:
Доля не прошедших фильтр |
Цена полезного ответа |
Расходы на них, руб. в месяц |
|---|---|---|
3% |
45,0 ₽ |
106 000 |
6% |
52,7 ₽ |
212 000 |
10% |
63,8 ₽ |
354 000 |
15% |
79,1 ₽ |
531 000 |
Снижение с 6 до 3% экономит 8 ₽ на каждом полезном ответе. Переход с GigaChat-3-Pro на Qwen3-30B‑A3B экономит 2 ₽ А 15% ошибок стоят уже больше половины цены оператора, и такие 15% легко получить, если считать решенным каждый диалог, где клиент замолчал.
Цифры сильно зависят и от того, во сколько вы оцениваете один такой диалог. Я взял 200 ₽, то есть компенсацию и три лишние минуты оператора, и для интернет‑магазина с промокодом «извините» это скорее нижняя граница. Для финтеха или B2B, где вернувшийся клиент может и не вернуться, цифра будет на порядок другой.
Третий рычаг прячется в строке, которую вообще никто не считает расходом на ИИ, то есть в эскалациях. Я заложил полторы минуты оператора сверх обычного тикета: прочитать резюме диалога и продолжить. Это работает, только если передача теплая и агент отдает оператору сжатую историю, номер заказа и список того, что уже пробовал. Если передача холодная и оператор читает сырой диалог, в котором бот три раза ответил не на тот вопрос, а потом еще извиняется за него, полторы минуты превращаются в три, а то и в шесть.
При трех минутах полезный ответ на GigaChat-3-Pro дорожает с 53 до 77 ₽, при шести минутах — до 127 ₽, и это уже дороже регионального оператора. Работает это и в обратную сторону: если агент уже идентифицировал клиента, сходил за статусом заказа и предзаполнил тикет, оператор экономит минуту‑две, и строка уходит в минус. Качество передачи оказывается отдельной статьей бюджета с самым широким разбросом во всей модели, и ее стоит измерять: среднее время обработки эскалированных тикетов нужно считать отдельно от обычных.
Возражение, которое я слышу чаще всего, звучит так: бороться за точность значит жечь токены, проверочные вызовы и длинные рассуждения съедят экономию. Я посчитал и это.
Если ради снижения ошибок с 6 до 3% токены на диалог вырастают в 1,6 раза, на GigaChat-3-Pro полезный ответ все равно дешевеет с 53 до 46 ₽ На Sonnet получается 78 против 73: там лишние токены уже дороже выигранной точности, и бороться за нее выгоднее базой знаний, а не проверочными вызовами. Токены становятся заметной строкой только на премиальных моделях, и только там этот компромисс надо считать.
Отсюда следует практический вывод, который звучит неинтуитивно для людей, выбирающих модель по результатам тестов: в рабочем контуре поддержки дороже всего не токены, а знаменатель. Все, что увеличивает долю полезных ответов, окупается быстрее, чем любой торг за цену миллиона. Я имею в виду качество базы знаний, маршрутизацию простых вопросов к агенту и сложных мимо него и проверочный набор, на котором ловят деградацию.
Здесь я должен честно назвать допущение, на котором держатся графики: качество во всех четырех строках одинаковое. Я сравнивал модели при одной и той же доле автозакрытий и одной доле ошибок, а в жизни дорогая модель обычно и закрывает больше, и ошибается реже.
Та же модель дает ответ, сколько именно она должна выигрывать, чтобы окупить разницу в токенах. Sonnet при 60% автозакрытий и 4% ошибок стоит 54 ₽ за полезный ответ, почти столько же, сколько GigaChat-3-Pro при 50% и 6%. То есть модель в 25 раз дороже по токенам отбивается, если приносит десять пунктов автозакрытий и два пункта точности. Если на вашем проверочном наборе разница меньше, вы переплачиваете. Если больше, вы зря экономите на токенах. Ответ на этот вопрос есть только в вашем проверочном наборе, в прайсе его нет.
Про сравнение с человеком я добавлю две оговорки. Первая касается цены тикета. При 149 ₽ за тикет даже пилот с 35% автозакрытий на самой дорогой модели выглядит выгодно: 110 ₽ за полезный ответ, а паритет с оператором наступает уже при 20–27% автозакрытий. Но если ваш оператор закрывает 60 тикетов в день, его тикет стоит 99 ₽, и тот же пилот на Sonnet за 110 ₽ уже дороже человека.
А крупный ритейл первую линию в Москве давно не держит: региональный или аутсорсинговый оператор стоит компании 70 000–85 000 ₽ в месяц. При 80 000 ₽ и 60 тикетах в день тикет стоит 64 ₽ GigaChat-3-Pro при 50% автозакрытий все еще дешевле, 42 ₽, потому что дешевеет и минута оператора на эскалациях. Sonnet дает 62 ₽, то есть паритет.
Вопрос «окупится ли» для поддержки не решен раз и навсегда, он решается двумя вашими цифрами: стоимостью тикета и долей автозакрытий.
Вторая оговорка касается объема. Фиксированные расходы модели составляют 163 000 ₽ в месяц на базу знаний, внедрение и инфраструктуру, и они размазаны по 36 000 диалогов. При 6 000 диалогов полезный ответ на GigaChat-3-Pro стоит уже 101 ₽, при 3 000 диалогов — 159 ₽, то есть дороже оператора. Ниже примерно 3 500 диалогов в месяц агент в этой конфигурации не окупается вообще, какую модель ни выбирай.
И это еще при оптимистичных фиксированных расходах. Допустим, на базу знаний и проверочные наборы нужна целая ставка, а не половина, то есть 200 000 ₽ в месяц, а внедрение с подключением к CRM и статусам заказов обошлось в 1 500 000 ₽ Тогда полезный ответ на GigaChat-3-Pro дорожает с 53 до 63 ₽, а порог окупаемости по объему сдвигается с 3 500 до 7 000 диалогов в месяц. Доля токенов при этом падает до 4%: чем реальнее считаешь остальное, тем мельче выглядит прайс за миллион.
Отдельно скажу, чего в модели нет вовсе, причем в обе стороны. Против агента играет лицензия тикет‑системы или чат‑платформы, в которой живут виджет и рабочее место оператора. Я ее не считал, потому что она у магазина есть и без агента. Если платформа берет отдельно за подключение бота или за трафик, добавьте это строкой.
В пользу агента играет все, что в формуле «149 ₽ за тикет» спрятано в плоскую среднюю. Текучка первой линии в ритейле доходит до половины состава в год, каждый новый оператор два месяца работает медленнее нормы, а рекрутинг и обучение стоят денег, которых в 125 000 ₽ нет. Распродажи поднимают трафик в разы на неделю, под это людей не нанять, а агент масштабируется за минуту. Ночь и выходные по Трудовому кодексу оплачиваются дороже при самой низкой загрузке. Ни одну из этих вещей я не могу посчитать честно без данных конкретной компании, поэтому в модели их нет. Но именно за них бизнес часто и платит, даже когда дневная unit‑экономика выглядит как паритет.
Что это значит для тех, кто агента продает
Для меня это самая интересная часть, потому что маркетплейс устроен как место, где вендор должен назначить цену, а клиент должен ее понять.
Мировой рынок уже проголосовал за единицу. Intercom продает Fin от $0,99 за результат, по курсу ЦБ на 13 октября — это 83 ₽ Salesforce запускал Agentforce в сентябре 2 024 года по $2 за разговор, а в мае 2025-го добавил Flex Credits по $0,10 за действие агента. Оба пришли к тому, что продавать токены клиенту бессмысленно, а дальше разошлись: Intercom берет деньги за результат, Salesforce берет за попытки.
В России до этого пока не дошло. Типичный прайс конструктора ботов строится на уникальных пользователях в месяц, как у Aimylogic, либо на сессиях и подписке. Оплаты за решенный диалог в публичных прайсах я не нашел, так что дальше я моделирую то, что будет, когда рынок до этого все‑таки дойдет.
Возьмем модель Intercom и посмотрим, что она делает с экономикой вендора. Допустим, вендор на маркетплейсе берет 60 ₽ за каждый закрытый агентом диалог. Ставку вендор назначает сам, и 60 ₽ здесь — моя иллюстрация. А вот комиссия площадки настоящая: по условиям партнерства с маркетплейсом Cloud.ru партнер получает 80% платежей клиента, то есть площадка удерживает 20%. Вендор несет токены, инфраструктуру, проверку, базу знаний и внедрение, а эскалации и ошибки остаются расходами клиента.
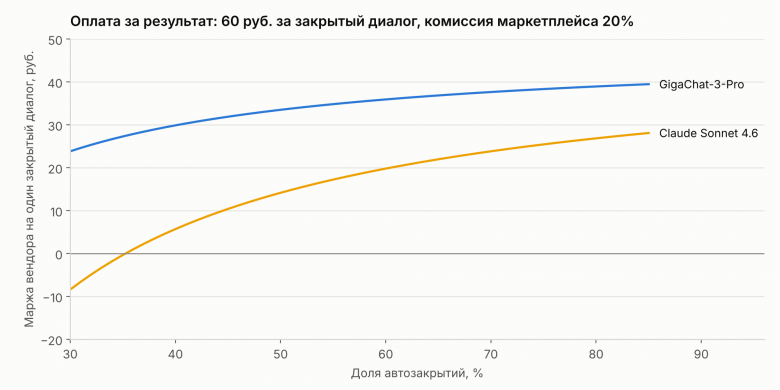
На GigaChat-3-Pro вендор зарабатывает при любой разумной доле автозакрытий: 27 ₽ с закрытого диалога при 35%, 34 ₽ при 50%. На Claude Sonnet 4.6 при 35% маржа составляет минус 40 копеек, то есть ноль с точностью до округления, и первый месяц с плохой базой знаний клиента вендор проводит в минусе. При оплате за результат риск низкой доли автозакрытий переезжает с клиента на вендора целиком, и вендор, который выбирал модель по тестам, обнаруживает это в первом же акте.
Клиенту при этом тоже есть, что считать. При 60 ₽ за закрытый диалог он платит и за те 6% закрытых, которые были ошибками, а потом еще раз платит за них своим операторам. На один полезный ответ выходит 64 ₽ вендору и 37 ₽ собственных расходов на эскалации и ошибки, итого 101 ₽ Это дешевле оператора, но за каждую ошибку агента клиент платит дважды: 60 ₽ вендору и еще около 200 ₽ себе сверх тикета, который все равно решает его оператор.
У оплаты за результат есть и обратная сторона: она подталкивает вендора удерживать клиента в боте любой ценой. Если деньги платят за «закрыто», системный промпт быстро учится не переводить на оператора. Intercom эту дыру в своей документации показывает сам: если раздраженный клиент ушел после ответа Fin, это считается предполагаемым решением и оплачивается. Площадка не видит, ушел клиент довольным или хлопнул дверью. Частично это лечат три фильтра выше: повторный контакт, негативная оценка и доля эскалаций как нижняя граница, за которую штрафуют, а не премируют. Полностью это не лечится ничем, и честнее это признать.
Еще одно возражение я слышу от заказчиков: чтобы сверять возвраты за 72 часа, вендора придется пустить в CRM. На самом деле не придется. Повторное обращение видно там же, где прошел первый диалог, то есть в канале: в чате, в мессенджере, в тикетной системе. Измерять результат должна площадка или канал, через который агент подключен, а не CRM клиента. Если измерение требует интеграции с CRM, модель не взлетит, причем не из‑за нежелания, а из‑за зрелости ИТ у среднего заказчика.
Поэтому для площадки главный вопрос в оплате за результат состоит не в ставке комиссии, а в определении результата. Если «закрыто» у каждого вендора свое, цены на витрине несравнимы, и клиент возвращается к единственной сравнимой цифре — цене за миллион токенов. Вот почему я считаю, что стандарт измерения решенного обращения (повторный контакт за 72 часа, доля эскалаций, негативные оценки) относится к инфраструктуре маркетплейса, а не к функциям вендора. Без него оплата за результат не масштабируется дальше первых двух‑трех кейсов.
Как посчитать у себя за вечер
Формула помещается в одну строку:
Цена полезного ответа = (токены всех попыток + инфраструктура + проверка + база знаний + внедрение + эскалации × минута оператора + ошибки × цена ошибки) / (попытки × доля автозакрытий × (1 − доля ошибок))
Для нее нужно измерить, а не предположить, четыре вещи:
долю автозакрытий по своей маршрутизации, а не по отчету вендора;
долю повторных обращений за 72 часа у диалогов, закрытых агентом, отдельно от закрытых людьми. Разница между ними и есть доля ложных «решено»;
время обработки эскалированных тикетов отдельно от обычных. Разница между ними и есть цена передачи, и обычно она больше, чем кажется;
входные токены на диалог не по прайсу, а по логам. В них обычно сидит половина экономии на дорогих моделях.
Что считать не надо, так это экономию от «освобожденных» операторов, пока они не освобождены в штатном расписании. Это самая частая подмена в презентациях про окупаемость пилотов.
Вместо заключения
Миллион токенов остается честной ценой, просто не на тот товар. Клиент покупает полезные ответы, и в их цене токены занимают от 2 до 32% в зависимости от модели. Остальное составляет качество контура, которое не продается за миллион ничего. Выбор модели от этого не становится неважным, он становится другим вопросом: не «сколько стоит миллион», а «сколько пунктов автозакрытий и точности покупает разница в цене». Для вендора на маркетплейсе при оплате за результат это еще и вопрос риска: дорогая модель съедает маржу не токенами, а первым месяцем на плохой базе знаний клиента.
И ложка скепсиса, куда без нее. Вся арифметика стоит на четырех числах, которые я взял из публичных данных и здравого смысла, а не из вашего контура: 149 ₽ за тикет оператора, 6% ответов, не прошедших фильтр, 200 ₽ за каждый такой ответ и 36 000 диалогов в месяц. Любое из них в вашем случае может отличаться вдвое.
Я прогнал и совсем пессимистичный вариант: целая ставка на базу знаний, внедрение за 1 500 000 ₽, 10% диалогов не проходят фильтр, а оператор закрывает 60 тикетов в день и стоит 99 ₽ за тикет. GigaChat-3-Pro при 50% автозакрытий дает 75 ₽ за полезный ответ. Это все еще дешевле человека, но запас сжался: оператор был дороже почти втрое, а стал дороже на треть. Sonnet в тех же условиях дает 96 ₽, то есть паритет. Тезис про токены выживает, а тезис про «ИИ дешевле» выживает только с оговорками. А если ваша ошибка стоит не промокод, а ушедший B2B‑клиент, цена полезного ответа легко удвоится, и ни одна модель из каталога этого не исправит. Считайте свои цифры.
Если у вас есть реальные данные по автозакрытиям и повторным обращениям, особенно те, что не совпали с моими, делитесь в комментариях. Я соберу из них вторую версию модели.