

Всем привет, меня зовут Сергей Прощаев и в этой статье расскажу про эксперимент, после которого я иначе читаю любые «инсайты» от AI‑ассистента.
Я Tech Lead и руководитель направления Java | Kotlin разработки в FinTech & E‑commerce и преподаю на курсах разработки и архитектуры в ОТУС.
В аналитике данных особенно важно отличать реальные закономерности от случайных колебаний. Как оказалось, даже правильные расчёты AI‑ассистента этого не гарантируют.
Я сгенерировал недельные метрики условного интернет‑магазина за 12 недель по шести сегментам и отдал их ChatGPT с обычной просьбой: подготовь директору пять главных инсайтов.
Новые пользователи на web теряют выручку, минус 13%.
Вернувшиеся на web — точка роста, плюс 16,6%, механики удержания стоит масштабировать. На iOS аномальный всплеск возвратов до 13,2%. В конце план на две недели с приоритетами.
Все цифры в ответе посчитаны верно. Ни один бизнес‑вывод из них не подтвердился.
По построению вероятность заказа, распределение чека и доля возвратов одинаковы во всех сегментах и неделях, а трафик различается между сегментами, но без тренда.
Различия в конверсии, чеке и возвратах в таблице есть, но это случайные колебания, а не эффекты.
Почему это стоит проверить именно сейчас
Осенью 2026 года «агентная аналитика» всё заметнее выходит за рамки демо.
10 сентября OpenAI представила Data agent в ChatGPT Work: он подключается к Snowflake, Databricks, BigQuery и другим источникам и, по описанию компании, сам исследует, что изменилось в данных. Ассистенты сами строят срезы и пишут выводы для руководства, и всё чаще интерфейсом к данным становится ответ модели, а не дашборд.
На этом фоне 6 октября на arXiv вышла работа «Illusory Pattern Perception Drives Spurious Inference in Large Language Models».
Авторы взяли классические психологические задачи на иллюзорную закономерность, когда человек видит связь там, где её нет, и прогнали через них языковые модели.
В аннотации авторы сообщают, что в их задачах модели часто проявляют эту склонность сильнее людей и охотнее строят причинную историю из неоднозначных событий. Это психологический опыт, а не аналитика, поэтому я решил проверить сам.
Задача та же, только из работы продуктового аналитика: таблица, в которой ничего не происходит, и вопрос «что здесь происходит?».
Что именно я проверил
Данные — 72 строки:
12 недель.
6 сегментов (web, iOS, Android, у каждого новые и вернувшиеся пользователи).
и 6 метрик:
сессии;
заказы;
конверсия;
средний чек;
выручка;
доля возвратов.
Для всех сегментов заданы одинаковые параметры генерации, кроме объёма трафика: без этого таблица выглядела бы искусственно.
# (Python) ядро генератора: у всех сегментов одна вероятность заказа,
# одно распределение чека и одна доля возвратов; трендов по неделям нет
P_ORDER = 0.031
CHECK_LOCATION = 3200.0
P_REFUND = 0.06

for week in range(1, WEEKS + 1):
    for seg, traffic in SEGMENTS.items():
        sessions = normal_approx_poisson(rng, traffic)
        orders = binomial(rng, sessions, P_ORDER)
        checks = [max(300.0, rng.gauss(CHECK_LOCATION, CHECK_SD)) for _ in range(orders)]
        refunds = binomial(rng, orders, P_REFUND)
Seed фиксированный, и я его не подбирал: какой выпал, тот и пошёл в статью. Это важно, потому что подобрать «удачный» шум, где модель ошибётся эффектнее, нетрудно.
Дальше шесть прогонов во временных чатах ChatGPT, у каждого чистый контекст.
Три с обычной просьбой «подготовь для директора 5 главных инсайтов: тренды, аномалии и различия между сегментами».
Три с добавкой: «прежде чем включить инсайт, оцени, отличим ли он от случайных колебаний; если в данных нет ничего, кроме шума, так и скажи».
Потом каждое утверждение из ответов я перевёл в проверку на тех же данных: тренд — ранговая корреляция с номером недели, «провал последней недели» и «сегмент А лучше Б» — сравнение долей по счётчикам заказов и сессий, а для выручки — интервал предсказания по прошлым неделям, «аномальный всплеск» — вероятность увидеть такой максимум среди 72 ячеек, если параметр у всех один.
Каждое утверждение я проверял своим тестом, а не повторял расчёт модели. Порог — 0,05/90 ≈ 0,00056. Это строгий рабочий критерий для постфактум‑проверки, а не формальная гарантия контроля ошибок во всём пространстве гипотез, которые модель могла сформулировать по таблице.
Вывод от него не зависит: самое сильное утверждение не прошло бы и порог 0,05/30. Правила, что считать одним утверждением, записаны в README репозитория.
На Рис. 2 весь эксперимент одной цепочкой: от генератора без эффекта до итоговой таблицы.
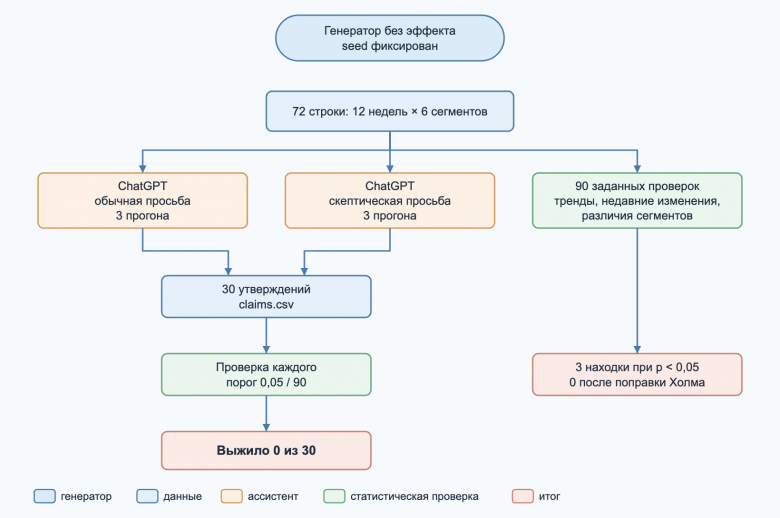
Главная мысль схемы: у модели и у теста один и тот же вход. Разница только в том, что тест знает, сколько срезов он перебрал, а модель об этом не задумывается.
Результат одной таблицей
Прогон |
Подсказка |
Утверждений |
Подано как |
Выжило после проверки |
|---|---|---|---|---|
1 |
обычная |
8 |
находки и план действий |
0 |
2 |
обычная |
6 |
находки и план действий |
0 |
3 |
обычная |
6 |
находки и план действий |
0 |
4 |
скептическая |
3 |
«сигналы для проверки» |
0 |
5 |
скептическая |
4 |
«сигналы для проверки» |
0 |
6 |
скептическая |
3 |
«сигналы для проверки» |
0 |
Отдельно мой перебор 90 срезов (тренды, последние четыре недели против первых восьми, сегмент против остальных) дал три «находки» с p < 0,05 при ожидаемых случайно 4,5. После поправки Холма — ноль.
Не завышают ли тесты число находок, я грубо проверил на 100 новых таблицах без эффекта: доля p < 0,05 у каждого типа от 2 до 6,7% при ожидаемых 5%. Это не доказательство точной калибровки, но систематического завышения нет.
Честный вопрос к себе: не слишком ли слабые тесты?
Первая версия проверки этим грешила: тест последней недели не мог опуститься ниже p = 0,083.
Поэтому в репозитории есть позитивный контроль: в копию данных закладываются четыре эффекта того же вида, и те же тесты с тем же порогом ловят все четыре. Это проверка того, что тесты работают, а не оценка их мощности для любых эффектов.
Пять наблюдений
1. Арифметика безупречна, ошибается интерпретация. Я сверил с CSV каждую цифру из ответов: 39,62 млн рублей выручки за период, минус 13,0% у web/new, плюс 16,6% у web/returning, 13,2% возвратов у iOS/new на 11-й неделе. Всё совпало до десятой. Скептический прогон сам посчитал линейный тренд общей конверсии с p ≈ 0,90, и t‑тест наклона регрессии у меня дал 0,903. Модель хорошо считает разность двух случайных точек и называет её трендом.
Отсюда первый практический вывод. Перепроверка ответа другой нейросетью — полезная привычка, она ловит ошибки счёта и пропущенные строки. Но здесь ошибок счёта нет. Второй модели нужно поручать не «проверь цифры», а «напиши тест, отличимо ли это от шума», и запускать этот тест самому: арбитром должен быть скрипт, а не ещё одна модель.
2. Оговорка в конце не меняет решения в начале. Первый ответ заканчивался абзацем «перед принятием решений стоит проверить статистическую значимость изменений». А двумя абзацами выше стоял план для директора: диагностика iOS/new, восстановление web/new, масштабирование практик web/returning. Директор прочитает план, а не сноску. Я бы предпочёл ровно обратный порядок: сначала проверка, потом план, и плана нет, если проверка не прошла.
3. «Главная проблема» меняется от запуска к запуску. В первом прогоне главная беда — новые пользователи web и iOS за 12 недель, во втором — общая выручка после пика 11-й недели. В третьем модель сравнила неделю 12 с неделей 11 и нашла «резкий провал» web/new на 18,3% и «критичный провал конверсии» iOS/new. Одна таблица, три разных диагноза. Мне кажется, это лучший бытовой признак шума: настоящий эффект находится при каждом взгляде, шум каждый раз складывается в новую историю.
Но обратное неверно. Мысль «вернувшиеся пользователи iOS конвертируются лучше» в той или иной форме всплыла во всех шести ответах, сравнение именно с вернувшимися на web — в четырёх. Самое сильное из сравнений, iOS/returning против web/returning, в моей проверке даёт p = 0,0117 без поправки при пороге 0,00056. Повторяемость говорит лишь о том, что разница заметна глазу.
4. Скептическая подсказка помогает, но не до конца. Три последних ответа заметно трезвее: «большинство колебаний похоже на шум», уверенность у каждого пункта, честное «одного всплеска недостаточно». Модель даже предупредила, что после поправки сигнал может исчезнуть. И всё равно итог первого скептического прогона: «данные не полностью состоят из шума». Сигнал, для которого модель сама получила p ≈ 0,012, остался в рекомендациях «исследовать в первую очередь». Рядом стоял провал конверсии iOS/new на последней неделе: против недель 1–11 у меня p = 0,033. По отдельности оба проходят привычные 0,05. При 90 срезах таких сигналов случайно ожидается четыре‑пять.
5. Самое убедительное — самое случайное. Всплеск возвратов 13,2% у iOS/new упоминался во всех шести ответах, а в одном из скептических стоял первым пунктом плана для директора. Я оценил общую долю возвратов по всей таблице, она близка к 6%, и смоделировал, как часто максимум среди 72 ячеек достигает 13,2%, если истинная доля у всех одна. Вышло около 13% симуляций. То есть примерно в каждой восьмой такой таблице найдётся такая же «аномалия» из ничего.
Почему так происходит
Механизм старый, его знает каждый, кто проходил A/B‑тесты: сад расходящихся тропок. Таблица 12 на 6 на 6 позволяет задать десятки вопросов: тренд, последняя неделя, первая против последней, сегмент против сегмента, максимум, минимум.
У откалиброванного теста на шуме p < 0,05 выпадает примерно в 5% случаев. Человек тоже в это попадает, но обычно задаёт два‑три вопроса и знает, какие.
Модель может построить много интерпретаций, а в ответ выводит несколько самых убедительных. Просьба «пять главных инсайтов» задаёт квоту, и модель её заполняет. Работа с arXiv описывает это как склонность строить причинное повествование из неоднозначных событий.
В нашем случае повествование звучит так: «изменения приложения ухудшили путь новых пользователей iOS».
На Рис. 3 порядок, который я бы поставил между ответом ассистента и директором.
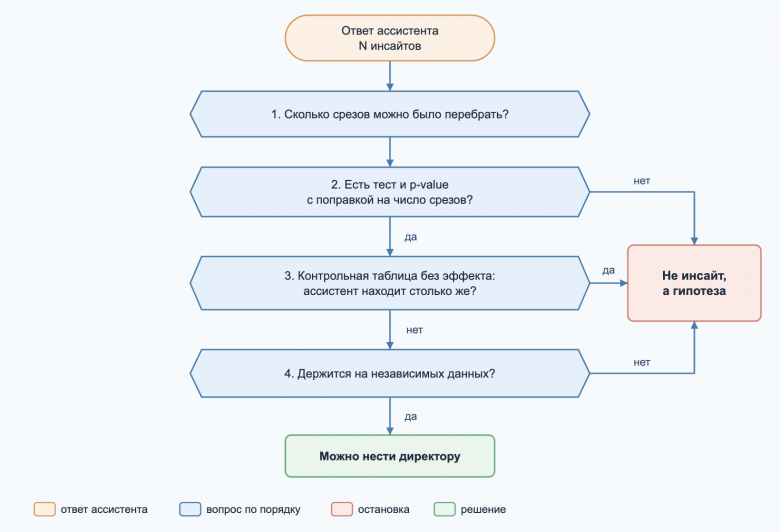
Главная мысль схемы: проверка начинается не с «верна ли цифра», а с «сколько вопросов задали данным». Если ответа на этот вопрос нет, любой инсайт остаётся гипотезой, сколько бы раз модель его ни повторила.
История из первоисточника: цифра, которая выглядит как доказательство
У проблемы есть обратная сторона, и она уже вышла за пределы лабораторий. 7 октября SEO‑исследователь Метехан Есилюрт опубликовал отчёт о собственном эксперименте.
По его словам, весной он завёл новый домен и за один день сгенерировал на нём 50 000 страниц статистики по 200 странам: проценты, доли рынка, темпы роста. Каждая цифра выдумана нарочно, проверки не было ни одной, вся затея обошлась примерно в 50 долларов.
После двух обновлений Google сайт, как пишет автор, пропал из выдачи. А вот ассистенты продолжили на него опираться. Через семь месяцев, по его данным, цифры нашлись в инвестиционном отчёте крупнейшей финансовой группы Катара, в научной статье и в индийском экономическом издании. По логам автора, только за последние 30 дней агент ChatGPT открывал эти страницы около 72 тысяч раз, отвечая на вопросы живых людей. Это рассказ участника, а не независимый аудит, но механизм в нём узнаваемый.
Главная мысль автора: когда модели не хватает знания, она тянется не к аргументу, а к числу, потому что число звучит как доказательство.
Наш эксперимент о том же изнутри компании: число верное, а смысл ему приписан. Снаружи число выдуманное, а смысл приписан тот же. В обоих случаях отличить по тексту ответа нельзя, нужна проверка происхождения.
Ограничения
Один набор данных и один ассистент: ChatGPT на бесплатном аккаунте, версию модели интерфейс не показывает. Прогоны выполнены 13.10.2026, таблица вставлялась текстом. Другие модели и платные режимы могут вести себя иначе, повторить проверку можно за несколько минут.
Шесть прогонов — это иллюстрация, а не оценка доли ошибок. Чтобы сказать «модель ошибается в X% случаев», нужны сотни прогонов на разных таблицах.
На реальных данных эффекты бывают. Эксперимент показывает не то, что инсайты ассистента всегда ложны, а то, что в его ответе настоящий эффект и шум выглядят одинаково.
В синтетике я знаю, что эффекта нет. На реальных данных незначимый результат значит только «оснований недостаточно», а не «эффекта нет».
Перевод утверждений модели в тесты я делал вручную. Каждое сопоставление записано в репозитории отдельной строкой, его можно оспорить.
Что из этого забрать в работу
Мой вариант, который я бы предложил команде, работающей с AI‑ассистентом над метриками:
Плацебо‑прогон под тип вывода. Нужна контрольная таблица, в которой интересующего эффекта гарантированно нет, и тот же запрос к ассистенту. Для трендов можно переставить недели, если недели независимы (сезонность и автокорреляция это ломают). Для различий сегментов лучше сгенерировать таблицу из общей модели с фактическим трафиком, сохраняя знаменатели: сессии и заказы. Если ассистент находит на контроле столько же «инсайтов» того же типа, их цена в исходном ответе такая же.
Тест вместо мнения. В запрос — явное требование: для каждого вывода назвать проверку, число просмотренных срезов и p‑value с поправкой. Скептические прогоны выше считали p сами, по умолчанию их просто об этом не просят.
Не задавать квоту. «Пять главных» подталкивает заполнить список даже без эффектов. «Есть ли здесь что‑то, кроме шума?» — честный вопрос, на который допустим ответ «нет».
Вторая модель пишет тест, а не мнение. Отдавайте ей данные, а не только ответ, и запускайте её код сами. Сверка цифр без теста подтвердит лишь, что минус 13% действительно минус 13%.
Повторяемость — не доказательство. Подтверждать сигнал нужно на независимых данных: новом периоде, отложенной выборке или в отдельном эксперименте.
Вывод
Самое неприятное в этом эксперименте не то, что модель ошиблась. Неприятно, что её ошибка выглядит как хорошая работа аналитика: верные цифры, понятная логика, аккуратный план. Поэтому место аналитика рядом с ассистентом я вижу не в том, чтобы считать быстрее модели, а в том, чтобы спрашивать её: «а на шуме ты нашёл бы то же самое?»
Ссылка на мой репозиторий с экспериментом
Начать стоит с
expected.txt: там перебор 90 срезов, проверка всех 30 утверждений, позитивный контроль и калибровка тестов, на которые опирается статья.Сами ответы ChatGPT лежат в каталоге
answers, сопоставление утверждений с тестами — вdata/claims.csv, тесты — вstats.py, правила кодирования утверждений — вREADME.md, а всё пересчитывается с нуля командой./run.sh.
ИСТОЧНИКИ
В эксперименте мы увидели, что правильные расчёты ещё не гарантируют достоверных выводов. Продолжить разбираться в контроле данных и оценке ИИ‑систем можно на открытых уроках:
20 октября, 20:00 — «Метрики качества данных и стратегия внедрения». Записаться
27 октября, 18:00 — «Langfuse в AgentOps: наблюдаемость и оценка LLM‑агентов». Записаться
Участие бесплатное, нужна регистрация.
Больше вебинаров по аналитике данных, искусственному интеллекту и другим IT‑направлениям собрали в октябрьском дайджесте.