

Вам знакомо, когда под понятием air gap в компании подразумевают только сетевое закрытие контура? Отрезали выход в интернет — и вроде бы всё под контролем. Обычно с этого допущения и начинаются самые эпичные аварии.
Меня зовут Алиса Кириченко, я отвечаю за разработку контейнерной платформы «Штурвал». Сегодня расскажу об уязвимостях в air gap-среде, о которых забывают и в которых чаще виноваты не злодеи снаружи, а мы сами. Один реестр образов на все зоны, неподписанный артефакт, устаревшая база уязвимостей и автоматическая политика, которая в порыве заботы готова отключить кластеру сеть. Под катом — четыре практики, которые держат на плаву закрытые мультикластеры.
Откуда берется ложное чувство безопасности
Air gap — не готовая модель безопасности, а набор ограничений на эксплуатацию. Само по себе отключение сети не отменяет привычных задач: образы по-прежнему нужно доставлять, уязвимости — находить, кластеры — обновлять. При этом часть рисков переезжает внутрь контура вместе с артефактами, а часть никуда и не уходила. Она всегда была внутри, просто иначе проявлялась.
Почему эта тема вообще стала актуальной именно сейчас? Тут сошлись сразу несколько факторов.
Регуляторика. Требования ужесточаются: у ЦБ для банков, для телеком-операторов, для объектов КИИ и госсектора со стороны ФСТЭК. Организации массово уходят в изолированные контуры.
Массовая миграция с зарубежного ПО. Нельзя перенести security-модель как есть: меняются поставщики, цепочки доставки и инструменты обновления. Всю инфраструктуру и процессы приходится выстраивать заново.
Мультикластерность. При переходе к мультикластерным платформам вся ручная экзотика, которая прощалась на одном-двух кластерах, перестаёт работать в принципе.
Нехватка экспертизы. Для такой среды нужны DevOps-специалисты, безопасники и сетевики, которые умеют работать с контейнерами. Таких людей на рынке мало, а в компаниях, которым контейнеризацию навязывают извне, их почти всегда приходится искать с нуля.
Две оси, по которым растет сложность
Все вышеперечисленные факторы работают одновременно, и именно их сочетание делает закрытую среду требовательной: изолированный контур почти никогда не ограничивается одиночным кластером, а сложность растет не линейно, а сразу по двум осям.
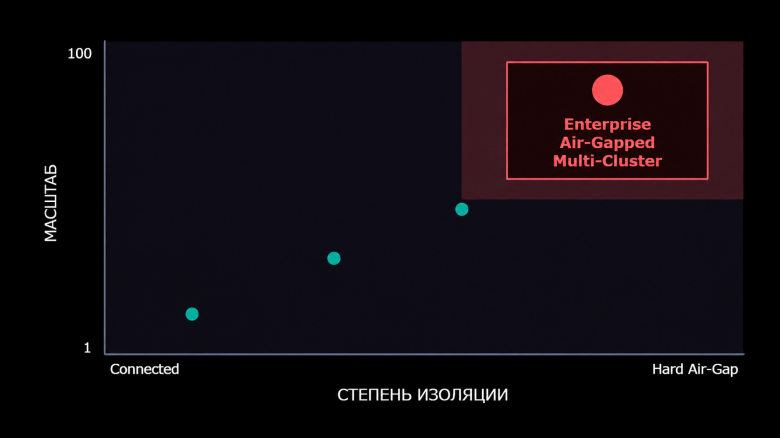
Первая ось — масштаб. Пока у вас один, два, от силы три кластера, многое ещё можно делать руками: зайти на ноду, поправить конфигурацию, перезапустить, посмотреть логи. Это работает, и это экономически оправдано.
Но при переходе на десятки и сотни кластеров, нужна автоматизация: в частности, агрегация логов и поиск дрейфов. Причем дрейфы накапливаются незаметно: что-то поправили руками на одном кластере, забыли раскатать на остальные, и через полгода у вас в платформе живут два десятка почти одинаковых, но очень по-разному сконфигурированных кластеров.
Вторая — степень изоляции. Есть soft air gap, когда изоляция программная, логическая. А есть hard air gap — физическая развязка, когда артефакты переносятся в контур буквально на флешках. И вот здесь обратная зависимость: чем жёстче изоляция, тем сложнее операционно поддерживать целостность. Потому что проверять приходится всё, включая саму процедуру переноса: кто собрал, кто верифицировал, кто подписал, что именно записалось на носитель.
Цепочка поставки артефактов: от источника до кластера
Ниже изображен путь, который проходит контейнерный образ до того, как оказаться запущенным в изолированном контуре.
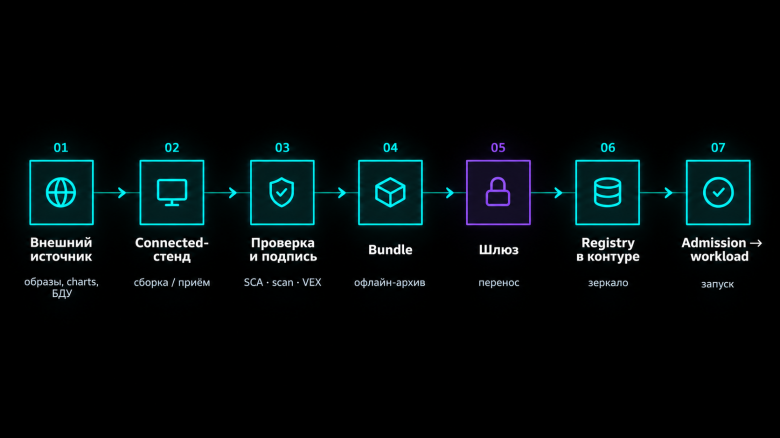
Собираются образы и чарты, проверяется целостность, артефакты упаковываются в бандл, он доставляется через шлюз — или тем же переносом на физическом носителе, — попадает в локальный реестр образов, и уже оттуда нагрузка запускается в кластерах.
Главные риски: человеческий фактор и ошибки конфигурации там, где автоматизация отсутствует. Если каждый шаг делается руками, рано или поздно что-то перепутается: не тот образ уедет не в тот контур, потеряется обновление базы уязвимостей или возникнет несовместимая версия компонента. В закрытом контуре нужно ещё больше времени для исправления подобных ошибок из-за сложности всей цепочки.
Отсюда и четыре практики, которые я хочу разобрать.
Практика № 1. Свой реестр образов в каждом контуре
Заказчики могут выстраивать у себя разные зоны, включая контур ПЦИ, DMZ, КИИ, стейджинг, продовые контуры. Часто всё это они обслуживают одним-единственным центральным хранилищем артефактов. Допустим, Nexus. Один реестр на все зоны кажется удобным из-за единой точки входа.
Но что в мультикластере центральный реестр превращается в то самое узкое место: это единая точка отказа и единая точка заражения одновременно. Любой кривой артефакт становится доступен всем зонам сразу, и сегментация ПЦИ/КИИ/прод формально ломается.
Поэтому первая практика — в каждом контуре должно жить своё хранилище артефактов. Это чуть сложнее в организации, ведь нужно продумать, как артефакты доставляются между зонами, как синхронизируются версии, как проверяется комплектность. Но зато контур больше не зависит от общего центра: отказ реестра в одном месте не валит всё, а проблема в одном контуре не расползается по остальным.
Практика № 2. Разные ключи подписи для команд
Следующая история — про контроль целостности и подпись образов. Здесь в ходу достаточно распространённая связка: Kyverno и Cosign. Kyverno — это admission controller, который живёт прямо в кластере и перехватывает ресурсы в момент их создания, а Cosign — инструмент для подписи контейнерных образов от Sigstore. В платформе «Штурвал» мы научили Kyverno обращаться за проверкой подписи в то же хранилище артефактов, что развёрнуто в закрытом контуре.
Образ подписывается на этапе поставки; подпись уезжает в контур как связанный OCI-артефакт, а Kyverno при создании пода проверяет её локальным ключом. Неподписанный образ или образ с некорректной подписью до развертывания не допускается.
Мы получаем ответ не только на вопрос «Подписан ли образ?», но и на более важный: «Кем он подписан?». И вот тут есть хорошая практика: разделять ключи подписи между командами. Тогда политика не просто пропускает или не пропускает образ, а логи admission controller позволяют точно сказать, какая команда пыталась задеплоить непроверенный артефакт.
Практика № 3. Управление уязвимостями в среде, где нет интернета
Для начала накину контекста. Сканер уязвимостей работает настолько хорошо, насколько свежая у него база. В открытом доступе она обновляется сама, по интернету, незаметно. А в air gap-контуре интернета нет, и обновление базы превращается в отдельный процесс, который нужно спроектировать: получить обновление за пределами контура, проверить, доставить внутрь, разложить, протестировать, что всё легло корректно. Если этот процесс не выстроен, база быстро устаревает, и тогда сканер начинает врать, создавая у команды ложное ощущение, что всё чисто. Ну и обратная сторона: обновления компонентов, особенно в сертифицированных ФСТЭК-редакциях, приходят редко, а критические уязвимости в ключевых компонентах, таких как CoreDNS, никто не отменял.
Как мы с этим живём?
Во-первых, регулярно обновляем базы уязвимостей — не реже, чем раз в две недели. Помимо этого, полезно собирать метрики даты обновления в каждом из контуров, а также оповещения по просроченным обновлениям и уязвимостям высокого и критического уровней.
Во-вторых, собираем данные из нескольких источников: из нативной базы Trivy, сведений по RedOS, Astra Linux и базы уязвимостей ФСТЭК. Тем самым не полагаясь на один источник, потому что для разных операционных систем и разных сценариев важны определенные данные. Этой агрегированной базой мы делимся публично.
В-третьих, наличие уязвимости в базе — это ещё не ответ на вопрос, реальна ли угроза для вас. Уязвимость может быть неприменимой: код не вызывается, компонент сконфигурирован так, что эксплуатировать нечего, есть компенсирующие меры, сетевая модель не даёт дотянуться до уязвимого места. Чтобы отделить фактический риск от теоретического совпадения по номеру версии, мы используем VEX (Vulnerability Exploitability eXchange). VEX позволяет зафиксировать квалификацию уязвимости. В связке с Trivy это работает, к примеру, через репозиторий VEX. Главное — уязвимости квалифицирует человек, который смотрит на конкретную среду, а не нейросеть, сверяющая номера CVE.
Для компонентов «Штурвала», которые есть «в коробке», мы поставляем VEX-отчёт. Если вы собираете свою платформу или одиночный кластер, то подобную разметку нужно делать самостоятельно.
И вот здесь хочу остановиться на одной ловушке, которую мы называем «Как не превратить кластер в тыкву».
Допустим, вы настроили политику, которая блокирует запуск образов с уязвимостями уровня high и critical. Теперь представьте, что свежая уязвимость нашлась в Cilium. А Cilium — не пользовательское приложение, а сетевой компонент самого кластера, который отвечает за сетевые политики, балансировку и eBPF-программы на узлах. Если ваша блокирующая политика сработает на нагрузках компонента, вы не «защитите» кластер — вы его обесточите. Поэтому системные неймспейсы, те, где живут критичные компоненты, должны быть явно добавлены в исключения блокирующих политик и покрыты валидационными. Не для того, чтобы игнорировать уязвимости — уязвимость должна быть видна, зафиксирована и обработана отдельной процедурой, — а для того, чтобы автоматическая реакция не убила инфраструктуру раньше, чем вы успеете среагировать осмысленно.
Практика № 4. Обновление множества кластеров
Представьте кластер с шестьюдесятью и более воркер-нодами. Его обновление занимает не пару часов, это сложная операция, где нужно одновременно держать в голове версии Kubernetes, системных компонентов, образы, зависимости библиотек и бинарников, сетевой плагин, состояние локального реестра, порядок обновления узлов и совместимость всего этого друг с другом. И всё это в контуре, где недостающий артефакт нельзя подтянуть в последний момент — его просто неоткуда взять.
Здесь подключается вендор. Ценность проверенного бандла в том, что совместимость компонентов протестирована заранее. В нашем случае их больше ста: нужно проверить зависимости, собрать образы, включить все необходимые артефакты, а до упаковки выполнить анализ состава ПО (SCA) и сканирование образов. Вручную разобраться в таком количестве компонентов и связей между ними — трудоёмкая задача даже для опытной команды. Но и проверенный бандл не делает обновление всего и сразу безопасным.
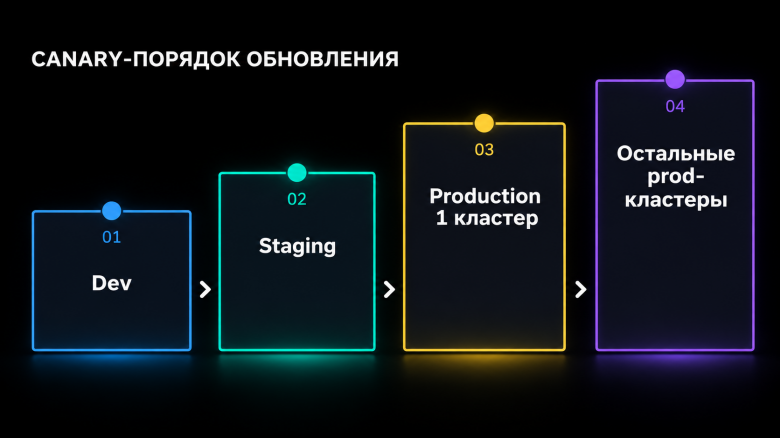
Разумная последовательность такова: сначала бандл доставляется в контур и сканируется. Затем обновляются development-среды — это полигон, где проблемы видны и не больно бьют. Дальше постепенно переходим к менее критичным промышленным кластерам. И только в последнюю очередь трогаем наиболее критичные продуктовые кластеры. Перед самым стартом обновления обязательно проверяем доступность реестров — потому что в закрытой среде неприятнее всего на середине обновления обнаружить, что половины артефактов просто нет. Такой поэтапный подход минимизирует риски. Если проблема всплывёт, то это произойдёт на dev-контуре, а не на самом значимом проде, где за каждый час простоя платят неприличные деньги.
Почему все об этом забывают
В крупных организациях часто выбирают путь попроще.
Используют один реестр на всё, потому что так удобнее. Не проверяют подписи образов, потому что в закрытом контуре угроз нет. Редко обновляют базы уязвимостей: тестовые среды кажутся не такими важными, а в продуктивных сложно быстро что-то изменить.
Какое-то время всё действительно работает. А потом что-то идёт не так, и оказывается, что цена простого пути — авария, которая затрагивает сразу все зоны, потому что они зависели от одной точки. Скандалы на почве «Откуда появился изменённый образ?» оказываются неразрешимыми. А обновление критичного кластера превращается в квест с гаданием, потому что совместимость компонентов никто заранее не проверял.
Что в итоге
Если собрать всё вместе, то безопасный мультикластер в air gap-среде — это история про то, что каждый артефакт проходит свой путь, и на каждом шаге у вас должен быть механизм контроля. Откуда пришёл образ, кто его подписал, где он хранится, свежая ли база уязвимостей, применима ли конкретная уязвимость именно у вас, можно ли безопасно обновить кластер, что случится, если упадёт реестр или сработает политика. Чем больше кластеров и чем жёстче изоляция, тем меньше места остается ручным процедурам и тем больше — автоматизации и встроенным проверкам.
Используйте эти четыре практики и обязательно подумайте заранее о том, что вы будете делать, если что-то пойдёт не так.