

Это перевод статьи Себастьяна Нейтбума, опубликованной в блоге Cloudflare. Автор рассказывает, как им удалось за пару месяцев вдвое уменьшить потребление памяти DNS-кешем, а заодно улучшить его производительность.
BigPineapple — платформа, на базе которой работают 1.1.1.1, Gateway DNS, DNS Firewall, AS112 и несколько других DNS-сервисов Cloudflare, — постоянно хранит более 250 млрд DNS-записей в кеше. На таких масштабах лишний байт в каждой записи превращается в 250+ ГБ потраченной памяти в масштабах всей инфраструктуры.
Внедрив пять последовательных изменений в то, как кешированные записи хранятся в памяти, мы смогли урезать объём занимаемой памяти более чем вдвое. В совокупности это сэкономило нам примерно 100 ТБ — столько же RAM стоит в 130 наших серверах Gen 13. Кеш стал работать быстрее. Пропускная способность при вставках выросла на 43 %, а задержка при поиске упала на 19 % — уменьшение числа аллокаций и улучшение локальности данных в памяти позволили нам не жертвовать скоростью ради экономии места.
Что мы кешируем
После холодного старта кеш BigPineapple абсолютно пустой. По мере поступления DNS-запросов он начинает заполняться. Как только достигается лимит по количеству записей, мы выкидываем старые или редко запрашиваемые элементы, чтобы освободить место под новые.
Точный размер кеша варьируется в зависимости от датацентра. Когда используется EDNS Client Subnet (ECS), авторитативные серверы возвращают разные ответы в зависимости от подсети клиента. Поэтому приходится кешировать сразу несколько вариантов ответа на один и тот же запрос. Из-за этого растут и количество записей, и память, которую они потребляют. Так что оптимизации, о которых тут рассказывается, дают максимальный эффект в локациях, где ECS используется особенно активно.
Каждый элемент кеша — это пара «ключ-значение». Ключ указывает на то, что именно запрашивается:
pub struct CacheKey {
    qname: Name,
    qtype: Rtype,
    authenticated: bool,
    tag: Vec<u8>,
}
В значении лежит сам DNS-ответ: секции answer, authority, additional-записи, плюс метаданные вроде времени создания, счётчика хитов и Time to Live (TTL).
pub struct CacheEntry {
    timestamp: UnixTimeStamp,
    pub inception: Instant,
    pub ttl: Ttl,
    pub hits: u32,
    pub answers: Vec<Record>,
    pub authority: Vec<Record>,
    pub additional: Vec<Record>,
    pub errors: Vec<ExtendedError>,
    ...
}
Обе структуры можно улучшить. В некоторых полях используются типы данных, создающие лишний оверхед, который не нужен после того, как запись оказалась в кеше.
Измеряем потребление памяти
Чтобы оценить эффект от каждого изменения, мы заполняем кеш случайно сгенерированными записями, которые примерно соответствуют распределению трафика в production (56 % A-записей, 25 % AAAA и 19 % TXT). Каждая такая запись в кеше содержит от одной до четырёх DNS-запись.
В нашем бенчмарке TXT-записи заменяют все типы записей, отличных от A/AAAA. Их размер варьируется случайным образом в диапазоне от 64 до 224 байт, что близко к среднему размеру ответа для типов записей переменной длины.
За потреблением памяти мы следим через кастомный аллокатор — он работает как обёртка над Rust'овым аллокатором System и записывает количество и размер аллокаций под каждую запись в кеше. Помимо памяти, мы замеряем пропускную способность при вставках (insert) и задержку при чтении на всём операционном цикле кеша, чтобы убедиться, что экономия памяти не идёт в ущерб производительности.
Конечно, эти цифры только имитируют production, а не воспроизводят его один в один. Память процесса также зависит от структуры трафика, заполненности кеша, состояния аллокатора и памяти, используемой вне кеша. По этой причине в ходе развёртывания также замерялась резидентная память на production-инстансах.
Цена capacity
Тип Vec<T> состоит из трёх полей: указателя на данные в куче (heap), текущей длины и общей ёмкости (capacity). При push'е элемента Vec проверяет, не превысит ли длина доступную ёмкость, и при необходимости перераспределяет память. Если свободное место есть, он просто добавляет элемент и увеличивает счётчик длины.
Но после того как DNS-ответ попадает в кеш, он больше не меняется. Поле capacity становится ненужным, но всё равно съедает 8 байт для каждого Vec. Место в куче тоже пропадает зря: если у Vec capacity равен восьми, а лежит в нём всего пять элементов, то три слота в куче просто не используются.
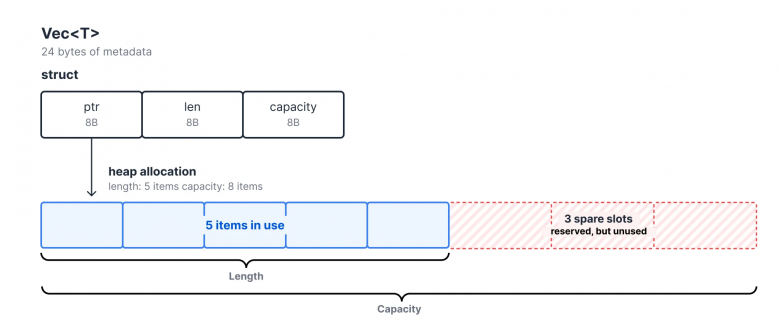
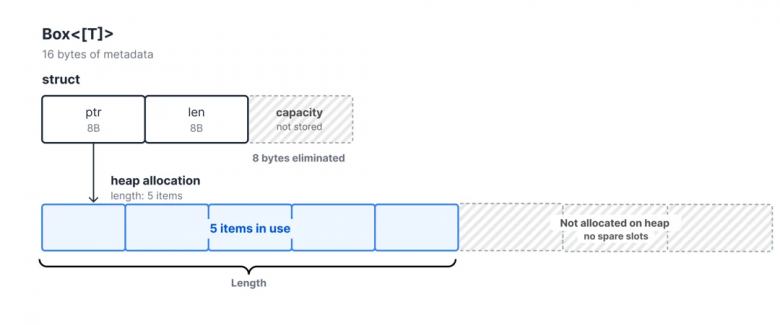
Переход на Box<[T]> решает обе проблемы. Этот тип не может расти после создания, так что ему не нужны поле capacity и резерв места под будущие элементы. То же самое касается и String (у него тоже есть поле capacity). А вот у Box<str> его уже нет.
Каждый элемент кеша содержит 8 полей типа Vec и String. Их замена на Box<[T]> и Box<str> экономит по 8 байт на каждом поле, то есть всего 64 байта на запись. Плюс мы избавились от лишней памяти в куче, которую Vec держит про запас. Для 250+ миллиардов записей в кеше это даёт экономию в 15+ терабайт.
Меньше списков, меньше указателей
Вместо того чтобы хранить секции answer, authority и additional в отдельных списках, можно использовать общий список со смещениями до начала каждой секции. Поскольку число DNS-записей в секции влезает в u16, под каждое смещение достаточно типа u16 (2 байта). Для сравнения: каждый отдельный Box<[T]> требует 8 байт под указатель и ещё 8 байт — под длину.
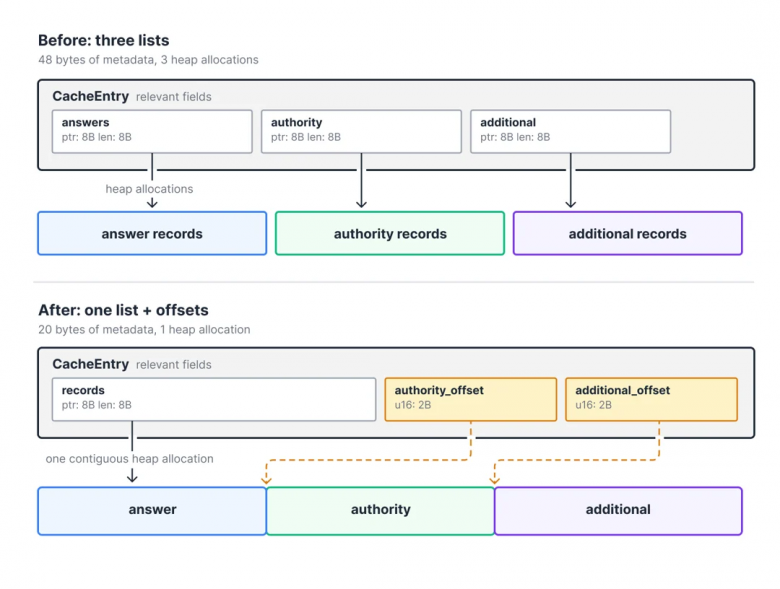
В итоге мы избавляемся от двух списков (каждый с 8-байтовым указателем и 8-байтовой длиной) и заменяем их двумя смещениями по 2 байта. Экономия — 28 байт на каждую запись.
Экономия не всегда в точности равна сумме байтов, удалённых из полей. Дело в том, что Rust делает padding (заполнение), чтобы соблюсти требования к выравниванию памяти, и округляет размер структуры вверх до числа, кратного её выравниванию. Поэтому, удаляя небольшое поле, можно заодно избавиться от лишнего паддинга. К примеру, мы упаковали несколько булевых полей в один битфлаг. Это убрало паддинг вокруг них, и структура «потеряла» больше байт, чем весили сами булевые поля по отдельности.
Удаление владельца
У каждой DNS-записи есть владелец (owner) — домен, к которому она относится. Часто этот владелец полностью совпадает с запрашиваемым доменом. Например, если запросить A-запись для example.com, мы получим две записи с одним и тем же владельцем:
$ dig example.com A

;; ANSWER SECTION:
example.com.        300    IN    A        198.51.100.1
example.com.        300    IN    A        198.51.100.2
Но если в дело вступает, скажем, CNAME-запись, то владелец может отличаться от домена из запроса:
$ dig example.com A

;; ANSWER SECTION:
example.com.        300    IN    CNAME    cdn.example.com.
cdn.example.com.    300    IN    A        198.51.100.1
cdn.example.com.    300    IN    A        198.51.100.2
Сетевой формат DNS решает проблему дублирующихся владельцев, сжимая имена, как описано в RFC 1035. Вместо того чтобы кодировать один и тот же домен дважды, все последующие упоминания хранят лишь 2-байтовый указатель на первое вхождение. Домен типа www.example.com можно закодировать просто как www плюс указатель туда, где example.com уже засветился в сообщении.
Для передачи по сети это работает отлично, но в кеше полное имя владельца хранится прямо в самой записи. Бегать по указателям сжатия во время чтения из кеша слишком накладно для hot path (критичного к скорости участка кода. — Прим. перев.), так что мы жертвуем памятью ради скорости.
С другой стороны, у большинства записей владелец совпадает с запрашиваемым доменом. Для таких случаев можно вообще убрать поле owner и восстанавливать его в момент чтения. Полное имя сохраняем только тогда, когда владелец отличается (как в случае с A-записями после CNAME).
pub struct Record {
    owner: Option<Box<Name>>,
    class: Class,
    ttl: Ttl,
    rtype: Rtype,
    data: RecordData,
}
Если в поле owner лежит None, при сборке ответа запрашиваемый домен восстанавливается из ключа кеша, избегая аллокации в куче. То есть запись перестаёт быть самодостаточной (self-contained); впрочем, ключ кеша и так доступен при каждом поиске. Если же владельцы различаются, в Some сохраняется указатель на полное имя в куче.
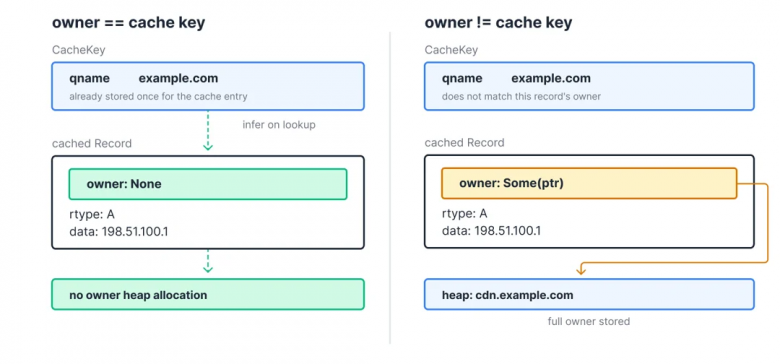
На практике у большинства записей в кеше владелец совпадает с запрашиваемым доменом, так что в подавляющем большинстве случаев аллокация в куче для поля owner не требуется.
Управление размером enum
Enum'ы (перечисления) в Rust — это типы-суммы (sum types): каждый вариант может нести разные данные, но размер самого enum'а всегда равен размеру его самого большого варианта.
pub enum Option<T> {
    Some(T),
    None,
}
Option может быть либо Some (со значением), либо None (пустым). Оба варианта съедают одинаковое количество памяти. Enum хранит тег, указывающий на активный вариант, за которым следует блок памяти, способный вместить данные самого большого варианта. Если вариант None, это место попросту пустует.
В случае с ресурсными записями кажется, что самый логичный вариант — хранить каждый тип DNS-записи как вариант enum:
pub enum RecordData {
    A(Ipv4Addr),
    Aaaa(Ipv6Addr),
    Txt(Txt),
    Naptr(Naptr),
    Svcb(Svcb),
    // ...
}
Но размер enum всегда равен размеру его самого большого варианта. У нас это NAPTR-запись на 136 байт. Она содержит три текстовых поля переменной длины, доменное имя и два целых числа. В итоге полный enum — вместе с тегом варианта и выравнивающим паддингом — раздувается до 144 байт.
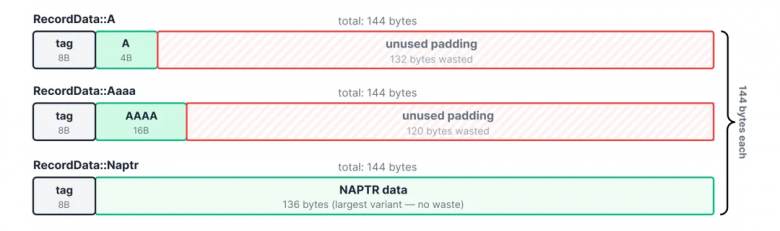
При этом A-записи нужно всего 4 байта, а AAAA — 16 байт. На A и AAAA приходится свыше 80 % нашего трафика, поэтому основная часть записей тратит впустую 120+ байт чисто на паддинг. А так как в одном элементе кеша может лежать много таких записей, потребление памяти растёт как снежный ком.
Упаковка вариантов в Box
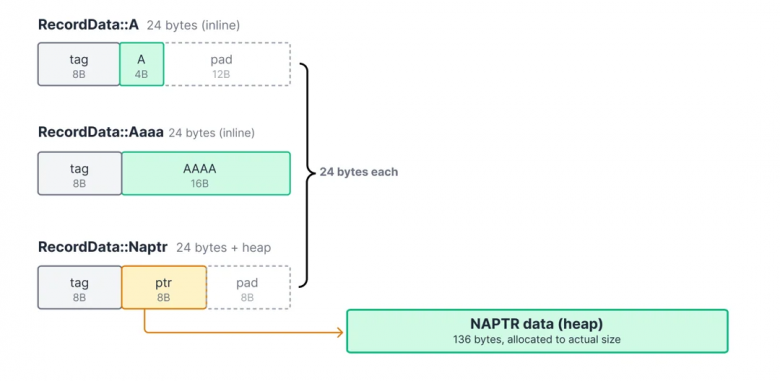
Чтобы решить эту проблему, можно обернуть более крупные варианты enum в Box, вынеся их в отдельную аллокацию в куче. В таком случае enum будет хранить только 8-байтовый указатель на кучу, а сами данные будут занимать ровно столько места, сколько им нужно.
pub enum RecordData {
    // Малые и часто встречающиеся варианты хранятся по месту.
    A(Ipv4Addr),
    Aaaa(Ipv6Addr),
    // Крупные варианты хранятся в куче.
    Txt(Box<Txt>),
    Naptr(Box<Naptr>),
    Svcb(Box<Svcb>),
    // ...
}
Для записей типа A и AAAA это позволяет сэкономить 120 байт на каждую запись. Варианты поменьше, вроде TXT и CNAME, тоже дают экономию. Сам enum для них занимает 24 байта, но их аллокация в куче подстраивается под реальный размер данных, а не раздувается паддингом до 144 байт. NAPTR, как самый большой вариант, теперь обходится даже чуть дороже. К нему прибавляются «стоимость» указателя и оверхед на аллокацию. Но поскольку на практике NAPTR-записи встречаются редко, оно того стоит.
Впрочем, у упаковки более крупных вариантов записей в Box есть и свои минусы.
Издержки упаковки
Упаковка (boxing) влечёт за собой два вида издержек. Первый — оверхед-расходы аллокатора. Каждый упакованный вариант становится отдельной аллокацией в куче, при этом аллокаторы округляют объём выделяемой памяти в бóльшую сторону до ближайшего сайз-класса. BigPineapple использует jemalloc — аллокатор, разработанный для многопоточных рабочих нагрузок с высокой интенсивностью аллокаций. jemalloc группирует аллокации схожих размеров в корзины фиксированного размера. TXT-записи нужно 32 байта, и она идеально помещается в 32-байтовую корзину. А вот MX-запись просит 40 байт, которые округляются до 48 — 8 байт тратятся впустую.
Второй вид издержек — плохая локальность данных в памяти. Без упаковки все значения enum для элемента кеша лежат в памяти одним непрерывным блоком. С упаковкой данные каждого упакованного варианта живут в отдельном сегменте. Чтобы их прочитать, нужно пройти по указателю. Если этот указатель ведёт в место, далёкое от остальной части записи, процессору приходится подгружать новую кеш-линию. Когда записей в кеше миллионы, данные из Box в итоге оказываются размазанными по всей куче, вместо того чтобы компактно лежать рядышком.
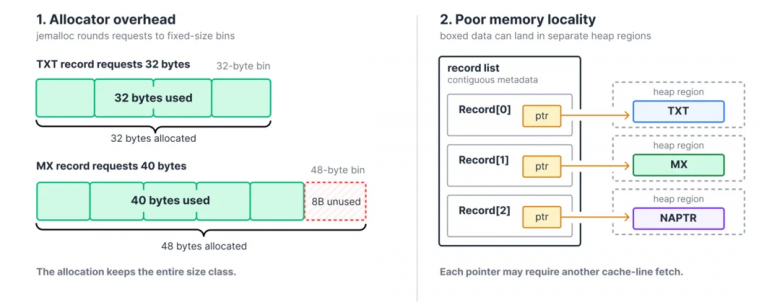
Сами по себе эти издержки не критичны. Но если от них избавиться, получим ощутимый прирост как в экономии памяти, так и в сокращении задержек при поиске.
Хранение записей в сетевом формате
Логично пойти дальше и хранить весь DNS-ответ в сетевом формате, подменяя при каждом поиске только клиентские поля вроде ID сообщения. Но тут есть свои минусы. DNSSEC-записи добавляются в ответ только тогда, когда клиент выставляет флаг DO (DNSSEC OK). Если хранить сообщение в сетевом формате целиком, придётся либо держать в кеше два варианта (с DNSSEC и без), либо вырезать эти записи из уже готового сообщения. К тому же парсинг всего сообщения при каждом поиске стоит ресурсов. Предыдущий подход с enum избавляет от этого, так как хранит уже распарсенные данные.
Мы нашли компромисс: храним в виде raw-байтов только данные самих записей, а остальную часть записи в кеше держим в структурированных полях. Вместо списка распарсенных enum-вариантов мы теперь храним все записи в одном Box<[u8]>. В нём каждая запись представлена 2-байтовым префиксом длины и идущими следом raw-байтами.
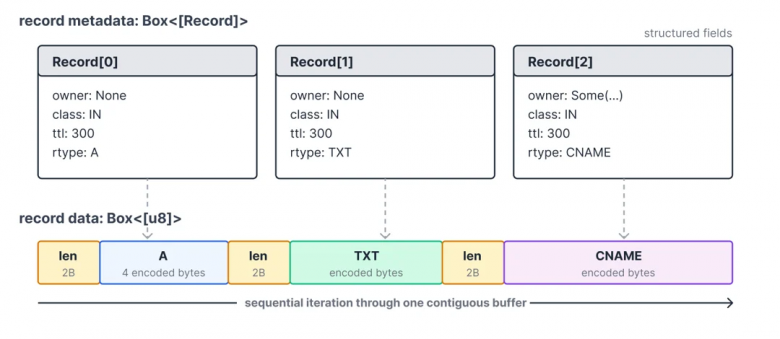
Это устраняет оверхед на варианты enum и убирает аллокации в куче, которые появились на прошлом шаге. Данные теперь лежат в памяти сплошным блоком, что улучшает локальность процессорного кеша. Плата за это — потеря произвольного доступа. Теперь приходится последовательно итерироваться по буферу. Это чуть усложняет жизнь фичам вроде round-robin-ротирования A и AAAA-записей, но так как записей в одном элементе кеша мало, на эти затраты можно закрыть глаза.
При сборке DNS-ответа из кеша большинство записей можно просто копировать из буфера прямо в исходящее сообщение. Раньше каждую распарсенную запись нужно было поле за полем сериализовать обратно в сетевой формат DNS. Новый формат позволяет не делать этого для A, AAAA, TXT и всех DNSSEC-записей — мы просто копируем их закодированные байты как есть. Парсить приходится только записи, содержащие доменные имена (например, CNAME, NS, MX и SOA), чтобы к ним можно было применить сжатие доменных имён в DNS. Так как записи, которые можно просто скопировать, составляют львиную долю нашего трафика, это обновление здорово разгружает процесс поиска. Вместе с улучшенной локальностью памяти это снижает задержки поиска в кеше на 5 % в тестах.
Чтобы собрать буфер с данными, мы пишем их во временный переиспользуемый (scratchspace) буфер, который живет между вставками в кеш. Поскольку прошлые записи уже расширили его до нужных размеров, перераспределение памяти требуется крайне редко. Записи различаются по размеру, поэтому точный размер буфера не известен до полной их сериализации. Как только записи попали в scratchspace-буфер, мы выделяем память под Box<[u8]> и копируем данные туда через memcpy. Это заменяет кучу отдельных аллокаций для каждого Box одной аллокацией на все данные разом. А ещё спасает от потерь памяти при урезании Vec<u8>, когда аллокатор не всегда может вернуть неиспользуемый «хвост» изначальной аллокации. В наших тестах только одно это изменение повысило пропускную способность записи в кеш на 13 %.
Результаты
Из production-метрик отлично видно, как сэкономленные в тестах байты для каждой записи превращаются в реальную экономию резидентной памяти для всего процесса. На графике ниже видно потребление памяти по инстансам BigPineapple в перцентилях p90, p98 и p99. Первая пунктирная линия — это начало выката 18 мая 2026 года, вторая — его завершение по всем сервисам 6 июля 2026 года. Каждый релиз приносил одну или несколько фич из статьи, так что потребление памяти снижалось постепенно.
С выкатом каждого релиза инстансы стартовали с пустым кешем и потребляли память по мере его заполнения. Поэтому «плато» на графике точнее отражают реальное потребление памяти, чем изначальные просадки.
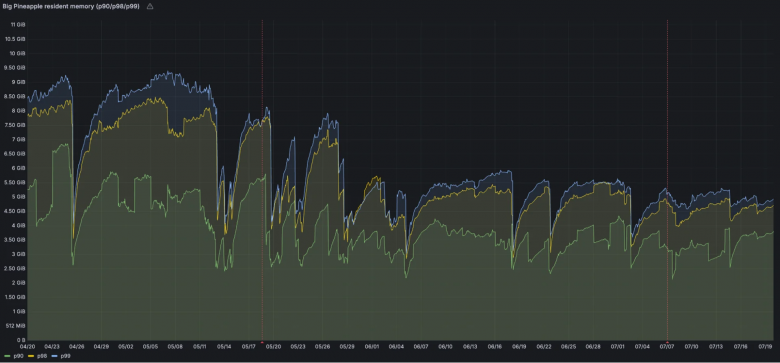
Потребление памяти на инстанс упало по всем перцентилям. На p99 объём памяти снизился с 9,3 до 5,3 ГБ — минус 43 %. На p90 память упала с 6,5 до 3,8 ГБ (минус 42 %). Больше всего в абсолютных цифрах сэкономили инстансы с самым полным кешем.
В наших бенчмарках пять этих оптимизаций сократили объём памяти на одну запись с 953 до 420 байт (минус 56 %). Объём аллокаций на запись упал с 1,1 КБ до 461 байта. Реальные production-цифры оказались меньше, поскольку резидентная память процесса включает не только кеш, но и все остальные данные. По окончании выката совокупный объём потребляемой памяти по всему парку серверов сократился примерно на 100 ТБ.
Производительность также выросла. Пропускная способность при вставке в кеш подскочила на 43 %, а задержка при поиске упала на 19 %.
Метрика |
До |
После |
Изменение |
Чистый объём памяти на запись |
953 байта |
420 байт |
−56 % |
Аллокации на запись |
1,1 КБ |
461 байт |
−58 % |
Пропускная способность при вставке в кеш |
625 000 записей в секунду |
893 000 записей в секунду |
+43 % |
Задержка поиска в кеше |
828 нс |
670 нс |
−19 % |
Всю освободившуюся память мы собираемся пустить на увеличение ёмкости кеша, не меняя потребление памяти. Это повысит процент попаданий в кеш и снизит количество запросов к upstream-серверам. Ну и, конечно же, мы продолжаем искать новые пути по оптимизации самого кеша.
Чтобы узнать больше о BigPineapple, почитайте статью «Как Rust и Wasm обеспечивают работу Cloudflare 1.1.1.1». Работаете с DNS или похожими высоконагруженными системами? Расскажите о своих успешных оптимизациях в Cloudflare Community или на сервере Cloudflare Developers в Discord.
P. S.
Читайте также в нашем блоге: