

Или история о том, как 5408 байт обфусцированного JavaScript, прилетающих в HTTP-заголовке, превращаются в свободный доступ к GPT, Claude, Mistral и генерации картинок если построить браузерный манекен на чистом JS.
Пролог: та самая ошибка
Всё началось с невзрачного сообщения в логах:
Ошибка API (ddg_haiku): Error code: 500 - {'error': 'no x-vqd-hash-1 token'}
Если вы когда-нибудь пробовали написать прокси к duck.ai встроенному в DuckDuckGo AI-чату, где под капотом живут GPT и Claude, вы почти наверняка видели что-то из этого репертуара: то 500 no x-vqd-hash-1 token, то дразнящую 418 I'm a teapot, то молчаливый обрыв соединения. Открытые прокси-проекты (вся братва в духе duck2api) периодически отваливаются на ровном месте
Мы с напарником делали Telegram-бота-прокси к duck.ai и, разумеется, встали на эти грабли обеими ногами. Пришлось разбираться. Эта статья подробный разбор того, как устроен антибот DuckDuckGo в 2026 году, что именно проверяет их челлендж (мы деобфусцировали четыре варианта «вкуса» и теперь знаем о них всё), и как мы построили headless-браузер, в котором нет ни одного байта настоящего браузера: только ~40 КБ чистого JavaScript, исполняющего их собственный код против фиктивного DOM.
Спойлер: работает. На день публикации челлендж решается за ~580 мс без единого фолбэка, а бот стримит ответы моделей прямо в чат Телеграма.
Что такое duck.ai и почему это лакомый кусок
Для тех, кто не следил: duck.ai - это ИИ чат от DuckDuckGo, доступный прямо на duckduckgo.com. Его главная магия в том, что DuckDuckGo оплачивает модели за вас: в интерфейсе доступны свежие модели OpenAI, Anthropic, Mistral и открытые весовые модели, а пользователь платит ноль рублей, ноль центов и даже не логинится. Сервис работает анонимно (DuckDuckGo славится своим отношением к приватности и анонимизирует запросы перед передачей вендорам моделей).
Живой список моделей из нашего бота на день публикации :
Модель |
Доступ |
Что умеет |
|---|---|---|
|
free |
текст, генерация картинок |
|
free |
текст, картинки |
|
free |
текст |
|
free |
текст |
|
free |
открытая модель |
|
free |
открытая модель |
|
premium |
текст, генерация картинок |
|
premium |
текст, генерация картинок |
|
premium |
самый жирный Claude |
Шесть бесплатных моделей, стриминг, веб-поиск, загрузка картинок, генерация изображений и всё это через один HTTP-эндпоинт /duckchat/v1/chat, без API-ключей, без регистрации. Единственное, что стоит между вами и моделями - антибот. DuckDuckGo не может позволить, чтобы их щедрость сливали в безлимитные API-прокси, поэтому вход на эндпоинт охраняет система, которая хочет убедиться: с той стороны сидит настоящий человек с настоящим Chrome.
Архитектура бота за 90 секунд
Прежде чем нырять в антибот, зафиксируем, что мы вообще строим. Бот называется headless-duckapi - это Telegram-бот, который принимает сообщения, пересылает их в duck.ai и стримит ответы обратно. Работает на serverless-платформе Telegram (BotFather → Serverless): апдейты приходят вебхуком в изолят, код исполняется по запросу, никакого постоянно живущего сервера.
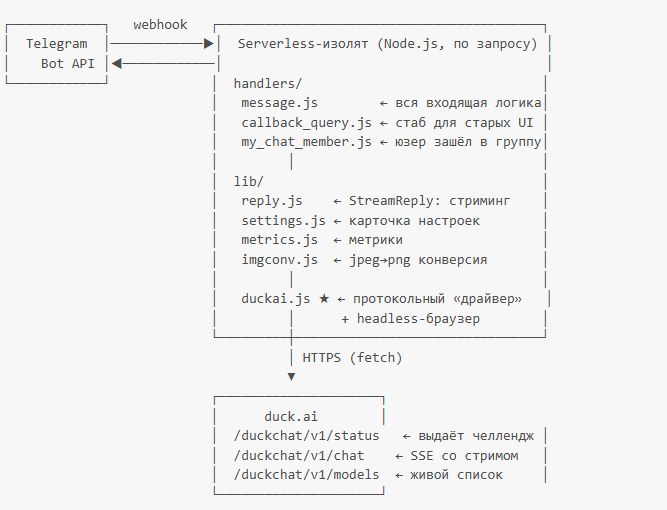
Ключевые архитектурные решения:
Один файл протокола. Вся магия обхода антибота живёт в
lib/duckai.jsсамодостаточном модуле на ~950 строк без единой npm-зависимости. Свой SHA-256, свой base64, свой HTML5-парсер, свой браузерный манекен. Это принципиально: код должен одинаково работать и в serverless-изоляте (где нетBuffer,atobи половины Node-API), и в обычном Node-процессе.SQLite для всего состояния. Настройки чатов, история диалогов, метрики в схеме из шести таблиц (
chats,messages,users,stats_daily,duck_daily,config). Последняя таблица ключ к выживанию: в ней хранится решённый челлендж-токен, переживающий рестарт изолята.
Главные фичи
Коротко, что бот умеет на момент публикации:
Стриминг. Одно Telegram-сообщение, которое прогрессивно редактируется по мере прихода токенов (не чаще раза в секунду и не раньше, чем накопится 8 новых символов иначе Telegram душит rate-limit'ом). Длинные ответы аккуратно перекатываются в следующее сообщение на 3600 символах. Markdown на лету конвертируется в Telegram-HTML, причём незакрытые посреди стрима
**и```дорисовываются виртуальными закрывателями, чтобы половина ответа не выглядела мусором.10 моделей с живым списком. Список не захардкожен - бот дергает
/duckchat/v1/modelsи показывает то, что актуально прямо сейчас (когда DDG добавили GPT-5.6 и Claude 4.8, они появились у нас без единого коммита)./imgгенерация картинок. Внутри обычного чат-хода включается тулGenerateImage(GPT Image 2 на бэкенде): сначала приходит заголовок («Painting a cute robot duck...»), потом черновик-превью уже на ~9-й секунде, потом финал 1024×1024 за ~13–17 секунд. Работает и спонтанно: попросите в обычном чате «нарисуй утку-космонавта» картинка приедет сама.Фото + vision + img2img. Шлёте фото с подписью «замени утку на кота» модель редактирует изображение. Забавная деталь: duck.ai отвергает JPEG в любой обёртке (бэкенд сниффает байты, а не MIME), а Telegram присылает фото строго в JPEG. Пришлось вендорить JPEG-декодер и PNG-энкодер (итого ~46 КБ), чтобы конвертировать фото в PNG с даунскейлом до 640px прямо в изоляте, без ImageMagick.
Память диалога. История последних N ходов передаётся модели с каждым запросом; «очистить историю» вычищает таблицу.
Настройки текстом. Никаких команд-зоопарков:
claude,размышления низкий,поиск выкл,очистить историюexact-match грамматика на русском и английском прямо в чате.Метрики здоровья протокола. В отдельной таблице
duck_dailyкопятся счётчики: сколько челленджей решено, сколько ушло в fallback, сколько 418/429. Команда/stats(только владелец) рисует панель в том числе «здоровье» антибот-обхода в динамике по дням.
А теперь - то, ради чего вы, собственно, здесь.
Антибот DuckDuckGo: как выглядит честный браузер
Сначала разберёмся, что сервер ждёт от клиента. Полный цикл одного запроса к чату выглядит так:
Шаг 1. GET /duckchat/v1/status. Браузер стучится в статусный эндпоинт с набором заголовков, маскирующихся под браузерные:
user-agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) ... Chrome/149.0.0.0 Safari/537.36
sec-ch-ua: "Google Chrome";v="149", "Chromium";v="149", "Not)A;Brand";v="24"
sec-ch-ua-mobile: ?0
sec-ch-ua-platform:"Windows"
sec-fetch-dest: empty
sec-fetch-mode: cors
sec-fetch-site: same-origin
origin/referer:https://duck.ai
cookie: dcm=3
x-vqd-accept: 1
В ответ сервер кладёт в заголовок x-vqd-hash-1... челлендж. Не токен, не хеш а 5–6 килобайт base64-кодированного обфусцированного JavaScript. Челлендж приходит в том же заголовке, в котором потом надо вернуть ответ на него.
Шаг 2. Браузер исполняет челлендж. Тот JS - это async IIFE, которая внутри проверяет окружение (об этом ниже целая глава) и возвращает объект с массивом client_hashes значений, вычисленных на основе проверки окружения.
Шаг 3. POST /duckchat/v1/chat. Решение челленджа уезжает в заголовке x-vqd-hash-1 (того самого имени), рядом с ним ещё пара заголовков честности:
Заголовок |
Что содержит |
Зачем серверу |
|---|---|---|
|
base64(JSON) с ответами челленджа |
доказательство «я браузер» |
|
версия сборки фронта, напр. |
сверка, что фронт свежий |
|
base64(JSON) лог телеметрии сессии |
доказательство «я человек» |
|
случайный hex |
идентификатор сессии |
Ответ text/event-stream (SSE) со стримом токенов, в котором между чанками болтаются служебные события (вплоть до [PING]) и ивенты тулов вроде генерации картинок.
Теперь о штрахах. Если заголовка x-vqd-hash-1 нет вовсе - сервер честно отвечает 500 {'error': 'no x-vqd-hash-1 token'} (та самая ошибка из пролога: так умирают все прокси первого поколения, которые еще шлют старый токен x-vqd-4 и не знают про новый). Если заголовок есть, но содержимое не проходит проверку вас ждёт 418 I'm a teapot. Не 403, не 429 418, что придаёт всему действию особый цинизм.
Челлендж изнутри
Декодируем x-vqd-hash-1 из status-ответа и видим знакомую картину - классический obfuscator.io:
(async function() {
const 0x53c4ff = 0x3dda;
function 0x3dda(0x8a4cc5, _0x54eae6) {
const 0x2b9bc6 = 0x2b9b();
return 0x3dda = function(0x3ddaef, _0x4750ce) {
0x3ddaef = 0x3ddaef - 0x181;
let 0x3acba3 = 0x2b9bc6[_0x3ddaef];
return _0x3acba3;
}, 0x3dda(0x8a4cc5, _0x54eae6);
}
// ...
Классика жанра: массив строк, функция-декодер со сдвигом индексов, а сверху ротатор, который до запуска основного кода перетасовывает таблицу строк, пока чек-сумма из parseInt-ов не сойдётся. Цикл выглядит безобидно:
while (!![]) {
try {
const _0xefc59c = -parseInt(...)/0x1 + parseInt(...)/0x2 * ... ;
if (_0xefc59c === _0x1c89fc) break;
else 0x5f3a68.push(0x5f3a68.shift());
} catch (_0x51be09) { 0x5f3a68.push(0x5f3a68.shift()); }
}
Это значит, что статически расколоть код нельзя - индексы строк меняются при каждом обновлении, и деобфусцировать надо уже после самой ротации (мы гоняли код через AST-трансформацию и собственный резолвер строк-таблицы на это ушла пара вечеров).
После деобфускации скелет челленджа прост до безобразия: он исполняет набор проверок окружения, каждая из которых либо возвращает булево значение, либо число, затем сворачивает результаты проверок в числа вида:
String(BASE + сумма_проверок) // например: String(0x11a0 + innerHTML.length querySelectorAll('').length)
и возвращает объект:
return { client_hashes: [hash1, hash2, ...], ... }
А дальше - важный нюанс, который многие упускают: сырые значения из челленджа ещё не токен. Наш клиент прогоняет каждый элемент client_hashes через собственную чисто-JS реализацию SHA-256 (в изоляте нет crypto.subtle, а ждать его негде), добавляет метаданные:
meta.origin = 'https://duck.ai';
meta.stack = 'Error\nat l (https://duck.ai/dist/duckai-dist/entry.duckai.<hash>.js:2:1446307)\n...';
meta.duration = String(случайные_3_30_мс);
И только затем сериализует всё это в JSON, кодирует в base64 и отправляет заголовком. Да, meta.stack - это фальшивый stack trace, который должен выглядеть так, будто ошибка выпала внутри собственного бандла duck.ai. Строку entry.duckai.<hash>.js мы живьём выдираем регуляркой из главной страницы duck.a она меняется при каждой выкладке фронта. А duration мы подмешиваем, потому что честно: реальный браузер исполняет челлендж за десятки миллисекунд, и значение 0 выглядит подозрительно синтетическим.
Четыре вкуса: что именно проверяет челлендж
В момент нашего исследования актуальными были четыре варианта челленджа - мы прозвали их вкусами. Каждый комбинирует проверки по своему, но строительные блоки одни и те же. Разберём все четыре.
Вкус 1. UA и «jsa-iframe»
Первый хеш тривиален: в client_hashes первым элементом уходит navigator.userAgent. А вот вторая проверка этого вкуса уже интереснее. Челлендж создаёт <iframe>, выставляет ему srcdoc и смотрит, как устроен его внутренний мир:
const iframe = document.createElement('iframe');
iframe.srcdoc = 'DuckDuckGo Fraud & Abuse'; // ← без комментариев
document.body.appendChild(iframe);
let result;
if (iframe.contentWindow && iframe.contentWindow.self && iframe.contentWindow.self.get) {
result = iframe.contentWindow.self.get.toString();
} else {
result = undefined;
}
document.body.removeChild(iframe);
return !!result;
Обратите внимание на строку DuckDuckGo Fraud & Abuse отдел борьбы с фродом DuckDuckGo буквально подписывает своё оружие. Сама проверка тонкая: в настоящем Chrome у contentWindow.self из srcdoc-iframe есть свои особенности структуры, и манекен, который вернёт здесь что-то отличное от реального браузера, немедленно палится.
Вкус 2. Математика HTML5-парсера
А вот это моя любимая проверка, потому что она бьёт по самому больному месту любого фейкового DOM: innerHTML в настоящем браузере это не «сохранённая строка», это результат полноценного HTML5-парсера:
const div = document.createElement('div');
div.innerHTML = '<p><div></p><p></div';
return String(0x11a0 + div.innerHTML.length div.querySelectorAll('').length);
Строка на входе намеренно сломанный HTML с незакрытыми тегами и оборванным концом (
</divбез закрывающей скобки!). Какой результат должен получиться в настоящем Chrome? Раскрутим по спецификации HTML5 («in body»):
<p>- открыт параграф;
<div>-divвходит в список тегов, закрывающих открытый<p>(p-closers in button scope):<p>закрывается, открывается<div>;
</p>- закрывающего</p>при открытом<div>нет... но по спеке сиротский</p>синтезирует пустой<p></p>да, именно так делает настоящий браузер;
<p>- открывается параграф внутри div;
</div- обрыв посреди тега (EOF-in-tag) вся лексема отбрасывается, а открытый<p>дожимается на EOF.
Итог: innerHTML возвращает <p></p><div><p></p><p></p></div> и из этой нормализованной строки считается length, а querySelectorAll('*') считает узлы. Числа умножаются, прибавляется база 0x11a0 и любой фейковый DOM, который тупо хранит innerHTML как строку, выдаёт совершенно другое число. Серьёзно, попробуйте угадать: сколько узлов в этом мусоре на самом деле?
Второй вариант той же проверки использует строку '<div><div></div><div></div' и другую базу (0x25f4). Всё, что нужно чтобы парсер, сериализатор и счётчик узлов были побитово совместимы с Chrome.
Вкус 3. V8-фингерпринт
Третий вкус - дюжина проверок, каждая из которых по отдельности кажется тривиальной, а вместе образуют отпечаток конкретного JS-движка. Полный список из деобфусцированного кода:
const bits = [];
const bits = [];
// 1. Нативные функции содержат [native code] в toString()
bits.push(nativeFn.toString().includes('[native code]'));
// 2. Субклассирование Array: map() возвращает экземпляр субкласса (спека V8)
class Sub extends Array {}
const arr = new Sub(1, 2, 3);
bits.push(arr.map(x => x * 2) instanceof Sub);
// 3. window.toString() === '[object Window]'
bits.push(Object.prototype.toString.call(window) === '[object Window]');
// 4. new Error() instanceof Error
bits.push(new Error() instanceof Error);
// 5. Error.captureStackTrace: undefined ИЛИ функция (V8-специфичное!)
bits.push(Error.captureStackTrace === undefined || typeof Error.captureStackTrace === 'function');
// 6. Object.isSealed(Math) — фолс в норме
bits.push(Object.isSealed(Math));
// 7. Sloppy-идиома: (function(){return this;})() === window
bits.push((function() { return this; })() === window);
// 8. children живой: после appendChild длина коллекции выросла на 1
const kids = document.body.children;
const len = kids.length;
const div = document.createElement('div');
document.body.appendChild(div);
bits.push(kids.length === len + 1);
document.body.removeChild(div);
// 9. querySelectorAll('*') НЕ массив...
const qsa = document.querySelectorAll('*');
bits.push(!Array.isArray(qsa));
// 10. ...а NodeList с точным именем конструктора
bits.push(qsa.constructor.name=== 'NodeList');
// 11-13. Цепочка прототипов DOM-классов
bits.push(div instanceof HTMLDivElement);
bits.push(HTMLDivElement.prototype instanceof HTMLElement);
bits.push(HTMLElement.prototype instanceof Element);
return String(bits.map(Number).reduce((a, b) => a + b, 0x1b1e));
Здесь прячутся самые коварные ловушки:
Пункт 7 - легендарная sloppy-идиома
(function(){return this;})(). В настоящем браузере она возвращаетwindow. Но если вы исполняете челлендж, скажем, в Node-изоляте черезnew Function, она вернёт настоящий глобальный объект рантайма а не ваш фейковый window. Мы решаем это регэксп-переписыванием исходника:(function(){return this;})()→(function(){return window;})()до исполнения. Грубо? Грубо. Работает? Работает.Пункт 10 -
constructor.name=== 'NodeList'. Значит, наш манекен должен иметь класс, именованный ровно NodeList минификация и переименование сломают проверку. В коде это даже прокомментировано:// NOTE: named exactly "NodeList".Пункт 3 -
Object.prototype.toString.call(window)требуетSymbol.toStringTag === 'Window'у объекта-манекена, плюс классWindowс прототипом, замкнутым на сам объект.Пункт 2 - если ваш
Arrayэто не настоящий V8-шный Array,map()на субклассе вернёт не то.
Вкус 4. Webdriver-тройка
Последний блок охота на автоматизацию:
return String([
navigator.webdriver === false, // 1. явный флаг puppeteer/selenium
/* 2. iframe contentWindow.self.get — см. вкус 1 */
/* 3. поиск алиасов песочниц: */
Object.keys(window.top).filter(k =>
['Array','Object','Promise','Proxy','Symbol','JSON','Window'].some(base =>
k !== base && k.endsWith('_' + base) &&window.top[k] ===window.top[base]
)
).length > 0
].map(Number).reduce((a, b) => a + b, 0xcdb));
Пункт 3 - самый занимательный: челлендж ищет в глобальной области алиасы вида Array, Promise, _Window, равные настоящим конструкторам. Это классический артефакт JS-песочниц, которые «оборачивают» глобальные объекты в подчёркнутые копии. Фактически DuckDuckGo держит в челлендже детектор популярных схем эмуляции браузера: если ваша песочница так делает вы уже спалились до остальных проверок.
Headless-браузер без браузера
Теперь главное. Как исполнять челлендж, если у тебя нет браузера?
Классический ответ индустрии: поднимать настоящий headless Chrome (Puppeteer/Playwright). Это работает, но для серверлесс-бота приговор: сотни мегабайт бинарников, секунды на холодный старт, память на каждый инстанс, CAPTCHA-инфраструктура на каждый чих. Для лёгкого прокси это стрельба из пушки по воробьям.
Наш ответ радикальнее: зачем браузер, если челлендж проверяет лишь узкий набор фактов об окружении? Мы построили браузерный манекен - объектную модель, достаточно правдоподобную, чтобы челлендж не отличил её от Chrome. ~300 строк кода, ноль зависимостей, исполнение за миллисекунды.
Как это устроено
Ядро - функция buildBrowserMock(ua), которая строит два связанных объекта: «окно» (win) и «документ» (doc), плюс navigator, location, screen, localStorage, performance, заглушки таймеров, crypto, TextEncoder... Собственно исполнение:
const { params } = buildBrowserMock(ua); // window, document, navigator, btoa, ...
const argNames = Object.keys(params);
const argVals =argNames.map(k => params[k]);
const fn = new Function(...argNames, 'return (' + jsCode + ');');
let result = fn(...argVals); // челлендж исполняется!
if (result && typeof result.then === 'function') result = await result;
Заметьте элегантный трюк: окружение инжектится параметрами функции. Челлендж обращается к window, document, navigator - и получает наши объекты, потому что они замыкают настоящие глобалы изолята. Никакого vm.createContext, никакой изоляции просто область видимости функции, в которой «window» объявлен.
Дальше детали, каждая из которых родилась из конкретной проверки:
NodeList обязан называться NodeList. Класс назван ровно так, потому что челлендж читает constructor.name. Комментарий в коде: // NOTE: named exactly "NodeList" - challenges check constructor.name.
window обязан притворяться окном. Три хака в одном флаконе:
win.self = win;win.top= win; win.parent = win; win.window = win;
win[Symbol.toStringTag] = 'Window'; // →Object.prototype.toString.call(win) === '[object Window]'
win.Window = function Window() {};
win.Window.prototype = win; // → instanceof-проверки
innerHTML это парсер. Самая трудоёмкая часть (~100 строк) мини-реализация HTML5-фрагментного парсера. При div.innerHTML = '<p><div></p><p></div' наш сеттер не сохраняет строку, а парсит её с соблюдением спецификации:
const VOID_TAGS = new Set(['br','img','hr','meta','input','link','area','base','col','embed','source','track','wbr']);
// Теги, закрывающие открытый <p> (button scope) - по спецификации "in body":
const P_CLOSERS = new Set(['address','article','aside','blockquote','center','details','dialog','dir','div',
'dl','fieldset','figcaption','figure','footer','header','hgroup','main','menu','nav','ol','p','section',
'summary','ul','h1','h2','h3','h4','h5','h6','pre','listing','form','li','dd','dt','plaintext','table','hr','xmp']);
const SCOPE_STOPPERS = new Set(['html','table','td','th','caption','applet','marquee','object','template','select','optgroup','option']);
плюс гейт-кейсы: сиротский </p> синтезирует пустой <p></p>, оборванный тег (EOF-in-tag) отбрасывается целиком, комментарии пропускаются. Геттер возвращает нормализованную сериализацию дерева как настоящий браузер, который пересобирает разметку из DOM. Именно она даёт те самые числа, которые челлендж перемножает и сравнивает.
querySelectorAll - это движок. Весь селектор-движок поддерживает три вида селекторов - *, tag, #id ровно то, что используют челленджи, и возвращает объект класса NodeList (см. выше). А children живой: геттер каждый раз отдаёт актуальную длину, поэтому проверка «appendChild увеличивает длину на 1» проходит.
Sloppy-идиома чинится переписыванием исходника. До исполнения челлендж прогоняется через:
function normalizeChallengeSource(js) {
return String(js).replace(
/\(\s*function\s*\(\s*\)\s*\{\s*return\s+this\s*;?\s*\}\s*\(\s*\)\s*\)/g,
'(function(){return window;})()'
);
}
navigator правдоподобный обыватель. platform: 'Win32', vendor: 'Google Inc.', hardwareConcurrency: 4, deviceMemory: 8, webdriver: false, пустые plugins/mimeTypes, languages: ['en-US', 'en']. Значения согласованы с User-Agent (Chrome 149 на Windows x64) рассинхрон между UA и navigator-ом тоже палится в реальных антиботах.
Честность таймингов. После исполнения в meta.duration пишется реальное время работы (с нижней планкой 3–30 мс): «0 мс» выглядит синтетикой.
А если челлендж упал? Оборачиваем всё в try/catch и внимание всё равно формируем токен: сериализуем исходник челленджа, текст ошибки, стек и origin в строку и кодируем в base64 (флаг fallback: true). Это не шаманство: так делал клиент-протокол первого поколения, и сервер какое-то время принимал такие «сломанные» ответы. Сегодня это аварийный люк: даже если DDG добавят проверку, которую мы пока не фейкаем, бот не умрёт мгновенно, а метрика fallbacks в /stats покажет, что пора патчить манекен.
Что происходит дальше
Решённый токен отправляется заголовком x-vqd-hash-1 в POST-запросе, и если сервер доволен начинается SSE-стрим. Тело запроса тоже небанально:
const body = {
model, // 'gpt-5.4-mini', 'claude-haiku-4-5', ...
metadata: {
toolChoice: { GenerateImage: !!image, WebSearch: !!webSearch,
NewsSearch: false, VideosSearch: false,
LocalSearch: false, WeatherForecast: false },
},
messages: [...], // история диалога
canUseTools: true,
reasoningEffort: 'none' | 'low' | 'medium',
canDelegateImageGeneration: image ? true : null,
durableStream: await makeDurableStream(), // RSA-ключи для канала догоняющего стрима
};
toolChoice - это врубалки тулов (генерация картинок, веб-поиск), которые мы переключаем фичами бота, а durableStream генерит RSA-OAEP-пару ключей (или берёт зашитый fallback-JWK, если crypto.subtle недоступен). SSE-ответ парсится построчно: data: {"message": "..."} дельты текста, data: {"name": "generate-image", ...} прогресс генерации картинок (заголовок → превью → финал в base64), data: [DONE] - конец.
Не хешем единым: fe-signals, fe-version и прочие мелочи
Челлендж центральная, но не единственная проверка. Протокол ожидает ещё два заголовка, без которых тоже можно словить 418.
x-fe-signals это base64-сжатый лог телеметрии «сессии человека». Настоящий duck.ai-фронт пишет события: пользователь увидел онбординг, кликнул, начал чат. Наш клиент генерирует правдоподобный лог:
{
start: now - end,
events: [
{ name: 'onboarding_impression', delta: 50..150 },
{ name: 'action', delta: +5..30 сек, trusted: true },
{ name: 'onboarding_finish', delta: ... },
{ name: 'startNewChat_free', delta: ... },
],
end: 0..10
}
То есть мы имитируем человека, который «открыл страничку, повнимал на онбординг, нажал Start a new chat» с таймингами, случайно разбросанными в человеческих пределах. Поле trusted: true телеметрия «настоящего» пользовательского действия. Захардкодить один и тот же лог на все запросы нельзя тайминги должны различаться, как различаются реальные сессии.
x-fe-version версия сборки фронта. Вот тут начинается самое интересное для вопроса «как DDG меняет антибот». Значение выглядит так:
serp_20261021_143533_ET-add6453709b9fbf89b2650161444a93199480dda
Присмотритесь: 20261021 дата. DuckDuckGo выкатывает новый билд фронта чуть ли не каждый день, и каждый билд несёт новую версию-тег, новый entry.duckai.<hash>.js и (потенциально) новый набор проверок в челлендже. Поэтому мы не хардкодим версию: бот периодически (кэш на 25 минут) скачивает главную страницу duck.ai и выдирает data-version-tag и data-version-sha из HTML, а также свежий URL entry-бандла для фальшивого stack trace. Любая выкладка фронта подхватывается автоматически, без релиза.
Мелочи, без которых тоже не взлетает: cookie dcm=3 (судя по всему, consent-флаг DDG), заголовок priority: u=1, i (браузерный приоритет fetch), корректная связка origin/referer/sec-fetch-*, и cache-control: no-store. По отдельности каждая мелочь может и не проверяется но отклонение любой из них делает отпечаток клиента менее правдоподобным, а на фоне тысяч запросов статистика не врёт.
Гонка вооружений: как DuckDuckGo часто меняет антибот
Постоянно. Вот что мы наблюдали за время жизни проекта:
Ежедневные сборки фронта.
serp_20261021_...в версии-теге это буквально сборка от 21 октября 2026. Вместе с билдом меняется entry-бандл (следовательно, «правильный» stack trace), а раз в несколько недель и сам челлендж.Ротация обфускации. Таблицы строк, индексные базы (
0x181в одном варианте,0x136в другом), контрольные суммы ротатора всё это пересобирается при каждой выкладке. Деобфускатор, привязанный к конкретным индексам, живёт ровно до следующего билда.Ротация комбинаций проверок. Четыре известных нам вкуса это разные миксы блоков (iframe, innerHTML-математика, V8-фингерпринт, webdriver-детектор) с разными базами. Очевидно, сервер раздаёт варианты динамически вероятно, и A/B-тестирует новые проверки, выдавая их подмножеству клиентов.
Ужесточение протокола. Исторически хватало токена
x-vqd-4(просто число из status-ответа). Потом появилсяx-vqd-hash-1с исполняемым челленджем - и всё поколение прокси, которое не умело исполнять JS, получило ту самую500 no x-vqd-hash-1 token. Дальше добавилась телеметрияx-fe-signals, сверкаx-fe-version... Тренд очевиден: каждое полугодие новый слой.
Почему мы всё ещё живы? Потому что наша архитектура построена на единственно правильной для такой гонки идее: мы не хардкодим ответы - мы исполняем их собственный код против фейкового окружения.
Смотрите на разницу подходов. Прокси, которые хардкодят: «на проверку X отвечай числом 4640» умирают при каждой смене базы или комбинации. Мы же скармливаем челлендж манекену, и челлендж сам вычисляет ответ из нашего окружения. Пока новые проверки спрашивают о вещах, которые наш манекен уже умеет правдоподобно изображать (DOM-парсинг, прототипы, имена конструкторов, тайминги), смена вкусов и баз проходит для нас незамеченной. Смена типа проверок (например, добавят Canvas/WebGL-фингерпринт или WASM-вычисления) потребует патча, но точечного, а не переписывания всего клиента с нуля.
Вторая половина живучести self-healing. Токен кэшируется на два уровня: L1 в памяти изолята (~9 минут), L2 в SQLite-таблице config (переживает рестарт изолята). При 418/429 бот молча выкидывает токен, заново решает челлендж и повторяет запрос (до 4 попыток с нарастающей задержкой). Пользователь этого не видит ему просто приходит ответ на секунду позже. А все события пишутся в метрики: в /stats видно по дням, сколько челленджей решено, сколько 418 отработано, сколько запросов ушло в fallback.
Где реальные пределы этой схемы? Честно:
TLS/HTTP2-фингерпринт. Мы контролируем заголовки, но не конвейер TLS. Если DDG начнут сверять JA3/JA4-отпечаток соединения с заявленным Chrome 149 эмуляция чистым
fetchперестанет проходить. Пока (по нашему опыту) на duck.ai этого нет.IP-репутация. Бесплатный лимит у DDG привязан в том числе к IP; изолят с общим адресом быстрее упирается в квоты (429), чем домашний браузер. Антибот тут ни при чём это просто честная квота.
Каждый новый DOM API - новый патч. Если челлендж завтра попросит
canvas.getContext('2d').measureText(...), придётся рисовать ещё один кусок манекена. Фундамент (парсер, прототипы, NodeList) уже стоит докладывать кирпичи проще, чем строить дом заново.
Живой трейс: цифры дня публикации
Чтобы не быть голословным, прогнали весь цикл прямо перед написанием статьи (22 октября 2026, холодный изолят):
GET /duckchat/v1/status → HTTP 200
challenge (x-vqd-hash-1) → 5408 байт base64
начало (декодированное): (async function(){const 0x111979=0x...
solveChallenge() → 580 мс, fallback=false
токен (base64 JSON) → 952 байта
GET /duck.ai/(fe-meta) → feVersion serp_20261021_143533_ET-add64...
entry.duckai.b64cc6ca5bb8451f4f08.js
GET /duckchat/v1/models → 10 моделей (6 free, 4 premium)
POST /duckchat/v1/chat
попытка 1 → 418 (холодная сессия)
попытка 2 (новый челлендж) → 418
попытка 3 (новый челлендж) → 418
попытка 4 (новый челлендж) → 200 OK, SSE
ответ модели → "pong" за 1.64 с суммарно
Любопытная деталь: первые три попытки с корректно решённым челленджем всё равно словили 418. Это «прогрев» сессии сервер, судя по всему, какое-то время не доверяет freshly-выданным токенам с незнакомого клиента (репликация токена между нодами? накопление статистики по путешествию?). Важно другое: ретраи с пересолом челленджа это лечат автоматически, и на тёплой сессии (токен из L2-кэша) первый же запрос проходит с ходу. Мы не знаем точной серверной логики но протокол сам подсказывает, как с ним ладить.
Итого вся цепочка «сообщение в Telegram → ответ модели»: ~2.5 секунды на холодном изоляте, ~1 секунда на тёплом. Стриминг в Телеграм начинается с первым же дельта-чанком.
Потрогать руками
Если дочитали досюда у нас есть подарок: всё описанное упаковано в опенсорс-проект headless-duckapi. Это тот самый бот целиком: протокольный драйвер с браузерным манекеном, Telegram-обвязка со стримингом, генерация картинок, vision, память диалога, rich-text настройки и метрики.
Внутри:
lib/duckai.jsгерой этой статьи: клиент duck.ai + headless-браузер, ~950 строк без единой npm-зависимости (свой SHA-256, свой base64, свой HTML5-парсер);Telegram-часть: хендлеры, стриминговый рендер ответов,
/imgс черновиками-превью, конверсия JPEG→PNG для фото;деплой в двух режимах: serverless-платформа Telegram (BotFather → Serverless) или обычный Node-процесс (Docker Compose / systemd в комплекте);
единственная обязательная переменная окружения
BOT_TOKEN.
Деплой занимает минуты: git clone → вписать токен бота из BotFather → docker compose up (или node .). Никаких API-ключей от OpenAI/Anthropic не нужно модели оплачивает DuckDuckGo, вы лишь притворяетесь браузером. Релиз v1.0.0 уже в releases, звёздочки и issues с новыми «вкусами» челленджа приветствуются если DDG что-то подкрутили, чинить будем вместе.