Прикладное руководство, помогающее с азов понять, как организованы атаки с переполнением стекового буфера под Windows. Ведь по Unix‑подобным системам таких разборов уже хватает.
Все знают, что ничем не ограниченный код scanf — это плохо. Но почему?
Проблема
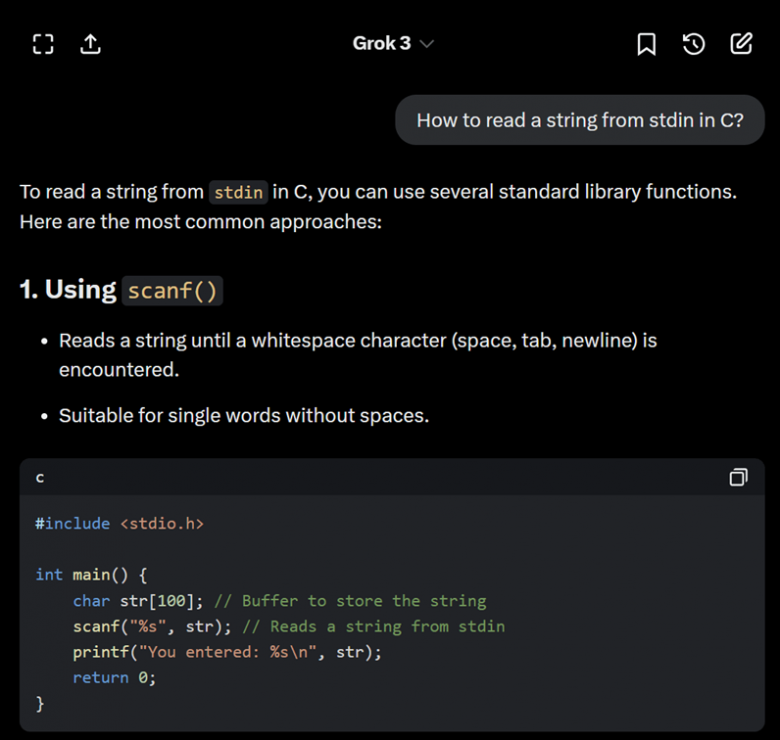
Что ж, пока ИИ нас не заменил.
Код вопиёт:
Так нельзя! Вы в зоне риска! Мы все умрём!
Это вполне ясно и оправданно: действительно, так делать нельзя. Если размер буфера не указать, то scanf запишет данные и за его пределами, если ввод не умещается в буфер. Из‑за такой ошибки, именуемой «переполнением буфера» (buffer overflow), агрессивный злоумышленник может наделать самых гнусных дел.
Но каких именно? Что случится, если кто‑то точно не вы заронит что‑то подобное в базу кода?
Согласно сайту cppreference.com, спецификатор формата %s в scanf подбирает последовательность символов, не содержащих пробелов и сохраняет их в буфере, предоставленном пользователем, добавляя нулевой символ (‘\0’). Так формируется строка, завершённая нулём.
Таким образом, если кто‑то введёт строку в формате «ABCDEFG» при length=7 — всё нормально. Вот как она расположится в памяти:
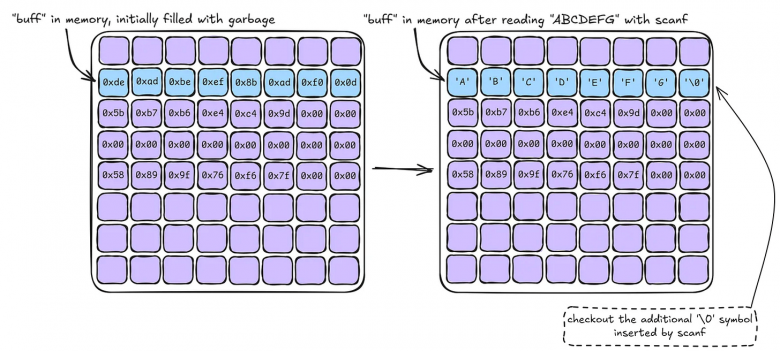
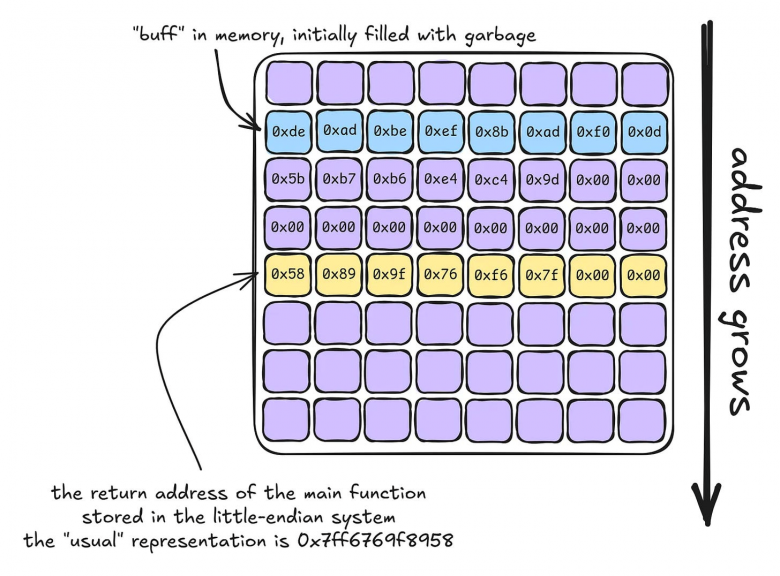
Если в подаваемую на вход строку вставить дополнительный символ, например, ‘H’, то scanf спровоцирует переполнение буфера. Если не учитывать размер буфера (buff), то scanf легко запишет данные сверх выделенного объёма. Поэтому она затрёт нулём первый байт ‘0x5b’ смежной структуры данных, следующей далее:
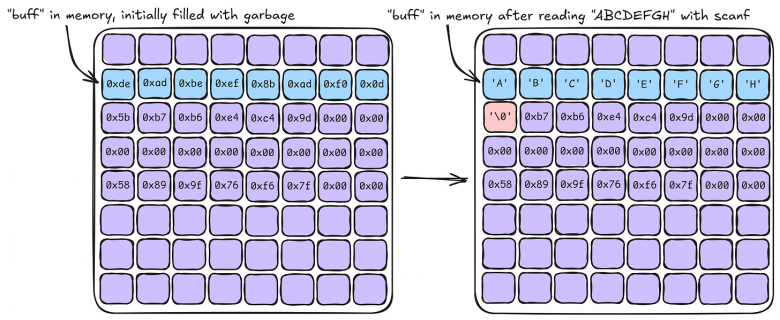
Переполнение буфера — серьёзная проблема, поскольку при этом затирается прилегающая память. Поскольку память непрерывна, могут быть повреждены чувствительные данные, сохранённые вплотную к буферу — например, пароли или финансовая информация. Это само по себе опасно, но злоумышленник может и далее эксплуатировать допущенное переполнение, например, для выполнения произвольного кода.
Модель памяти
Прежде, чем продолжать тему, давайте кратко рассмотрим, как именно объекты занимают области памяти.
Память можно представить как огромный массив байт и для удобства изобразить в виде прямоугольника. На отдельные байты можно ссылаться по их адресу, обеспечивая таким образом доступ для чтения/записи:
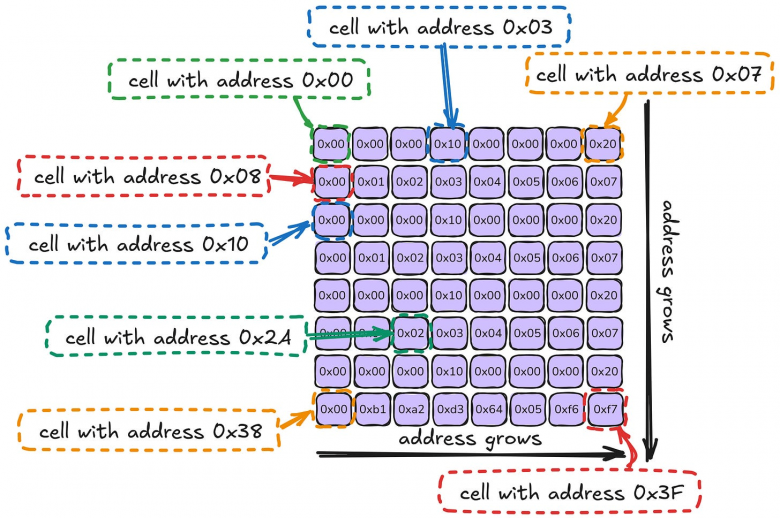
В реальности обычно приходится оперировать гораздо более крупными участками памяти, чем показанные здесь 64 байта, но принципиально ситуация не меняется.
Далее: память делят на сегменты, имеющие разное назначение:
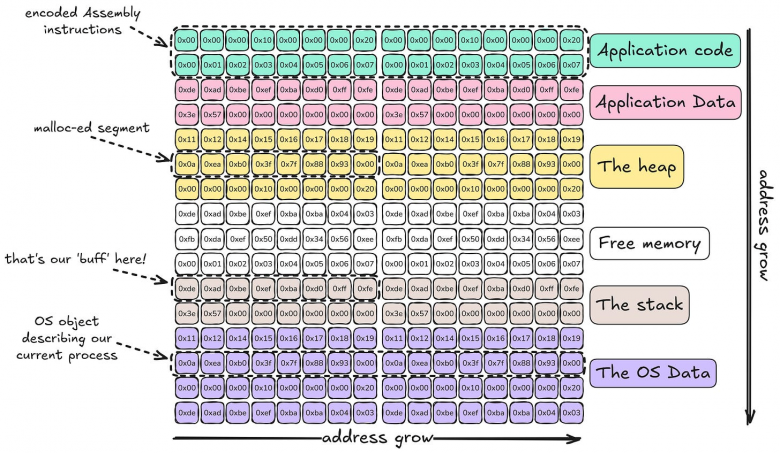
Как видите, наш объект buff занимает область в стеке. Также в стеке хранятся другие категории данных, и на одной из них мы остановимся как на особенно интересной.
В памяти хранятся как данные, так и код (запрограммированные инструкции), и процессору необходимо их различать.
Ассемблерные инструкции
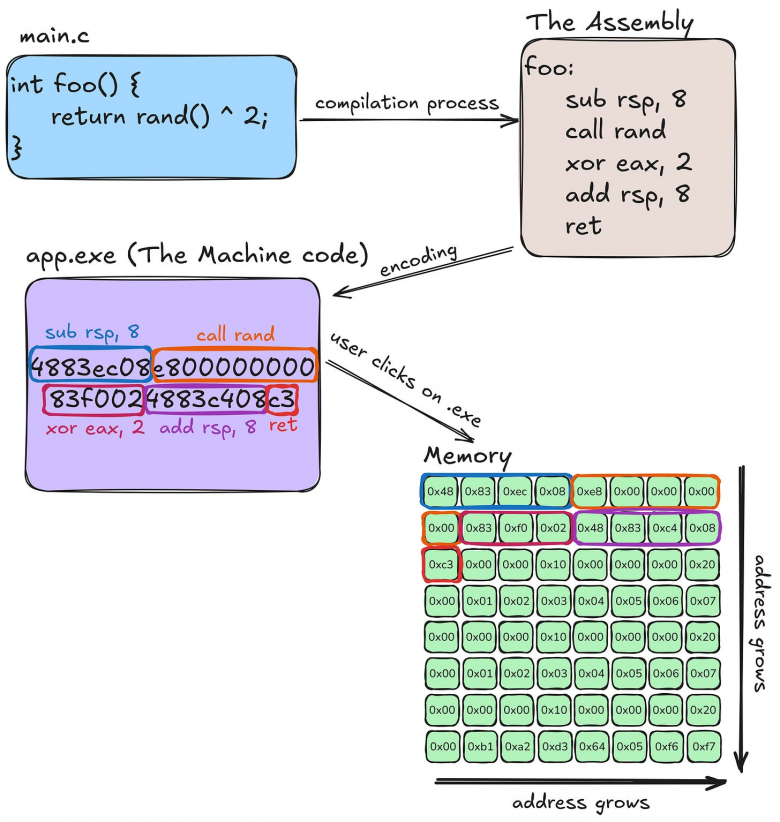
Компилятор обрабатывает ваш исходный код, преобразует в ассемблерный код, который затем преобразует в машинный код.
Как показано на картинке выше, каждая ассемблерная инструкция кодируется в одном или более байтах. Например, инструкция sub rsp, 8 представляется как последовательность байт [0x48, 0x83, 0xec, 0x08], тогда как инструкция ret кодируется единственным байтом 0xc3. Кодирует её таким образом компилятор. В ходе выполнения программы процессор декодирует эти инструкции, определяя, что нужно сделать.
Далее машинный код вновь собирается в исполняемый файл (с расширением.exe), служащий удобным представлением программы.
Процессор работает
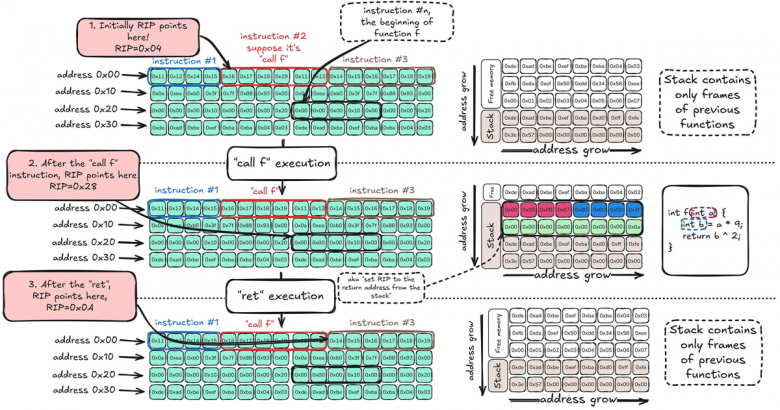
Процессор выполняет машинный код, сгенерированный компилятором. Для этого используется регистр RIP (указатель инструкций), в котором хранится адрес инструкции, выполняемой в настоящий момент. Регистр RIP определяет, какую инструкцию выполнять следующей. Когда пользователь запускает исполняемый файл, процессор инициализирует RIP в начальное значение:
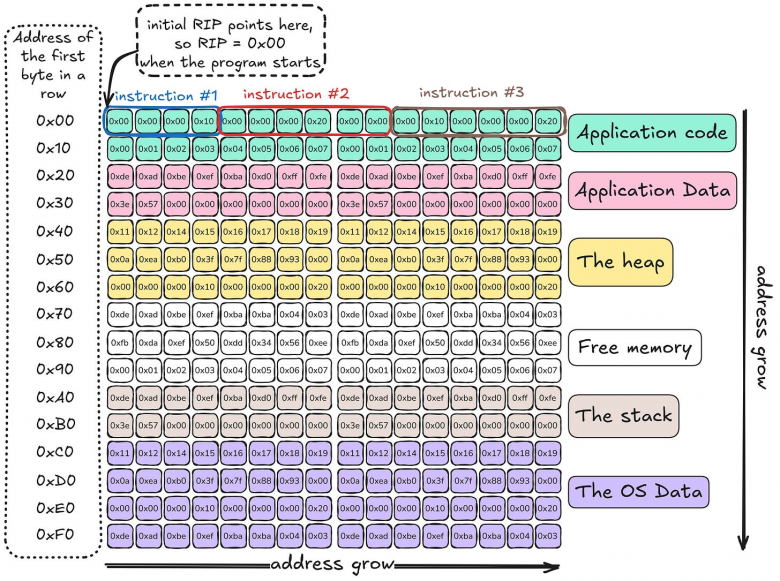
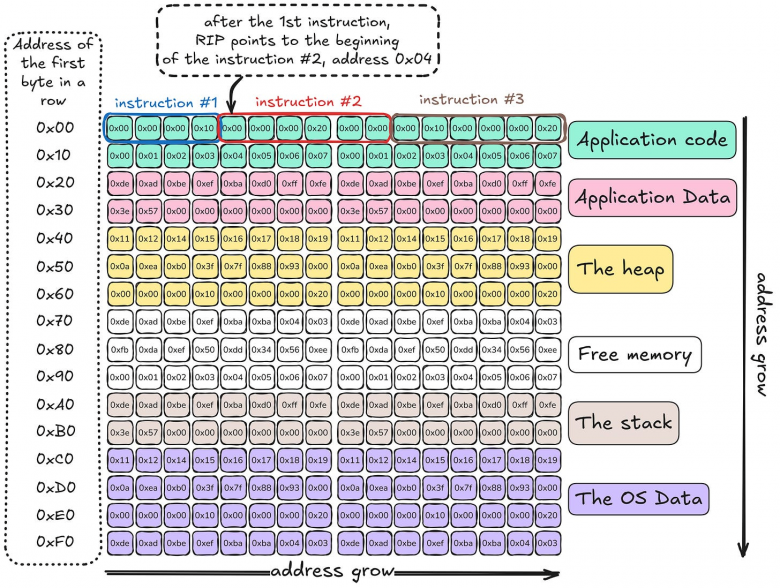
Процессор выполняет инструкции одну за другой, последовательно. Выполнив instruction #1, указатель инструкций RIP переходит к следующей инструкции вот так:
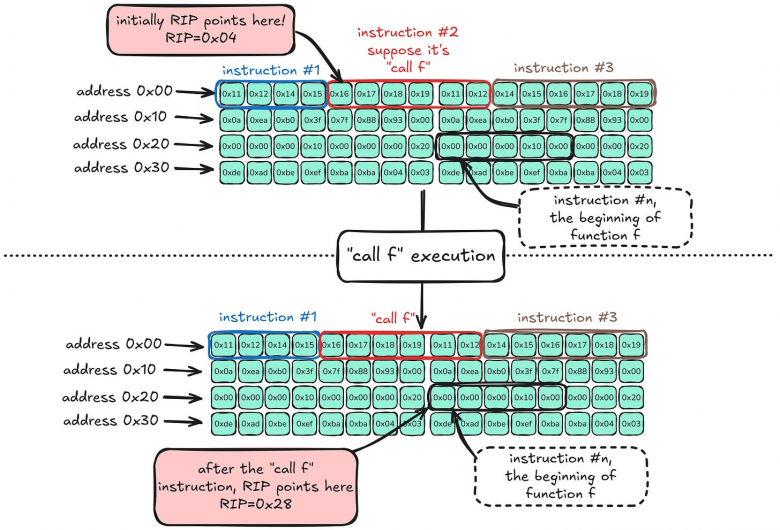
В правиле последовательного выполнения есть ряд ключевых исключений — например, по поводу инструкции call, при помощи которой вызывается функция. Как правило, адрес целевой функции кодируется прямо внутри инструкции. Когда процесс встречает инструкцию call, он обновляет RIP до её адреса, передавая управление в начале целевой функции:
Стек
Ранее мы уже видели стек, когда рассматривали модель компоновки памяти:
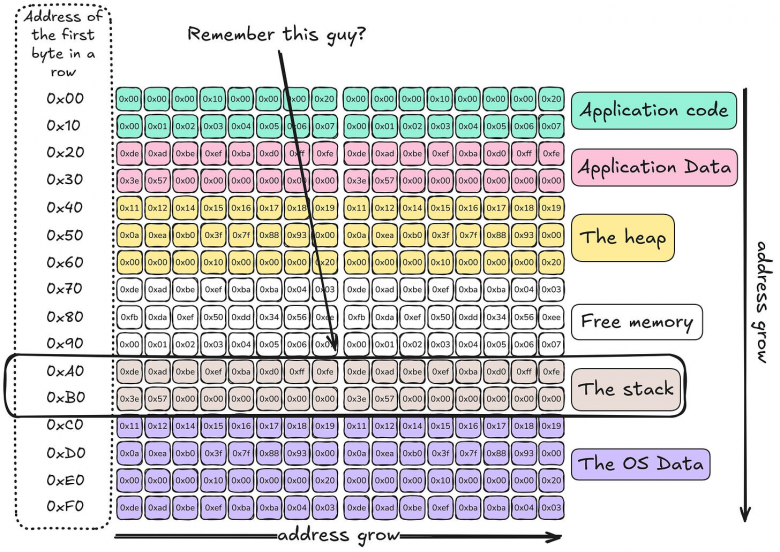
Стек работает как структура данных вида LIFO (последним пришёл — первым обслужен). Например, если мы укладываем в стек 8-байтный сегмент данных, то память под него выделяется из числа байт, расположенных в области «свободной памяти»:
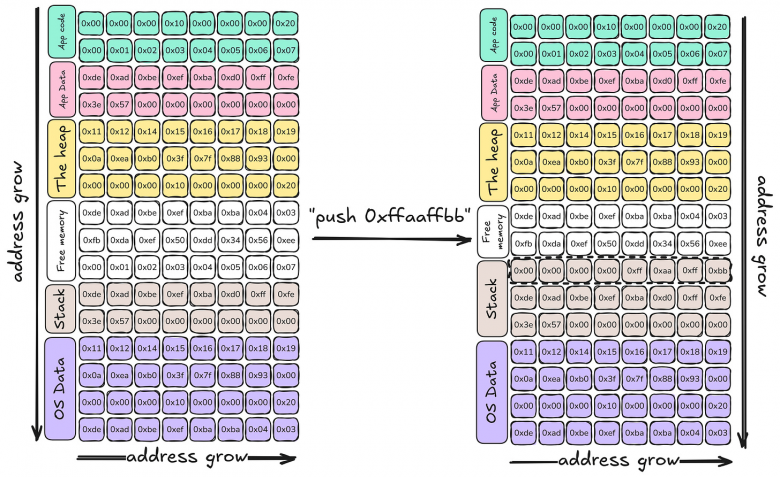
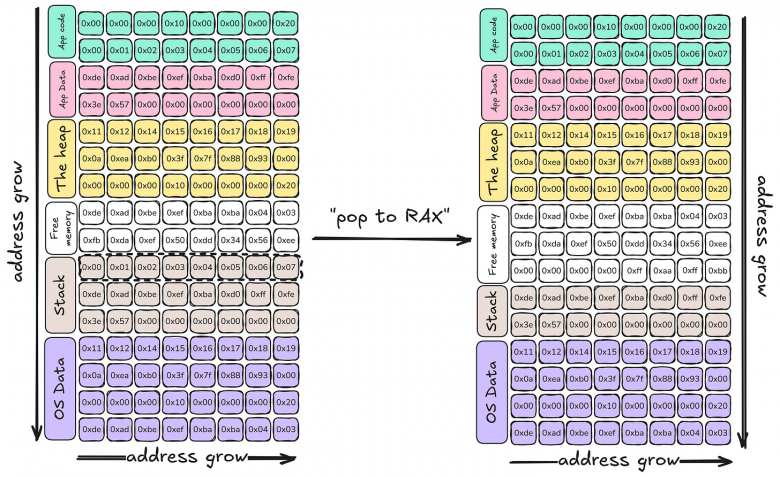
Затем можно вытолкнуть значение из стека, вернув выделенную под него память и увеличив область свободной памяти:
Кадр функции
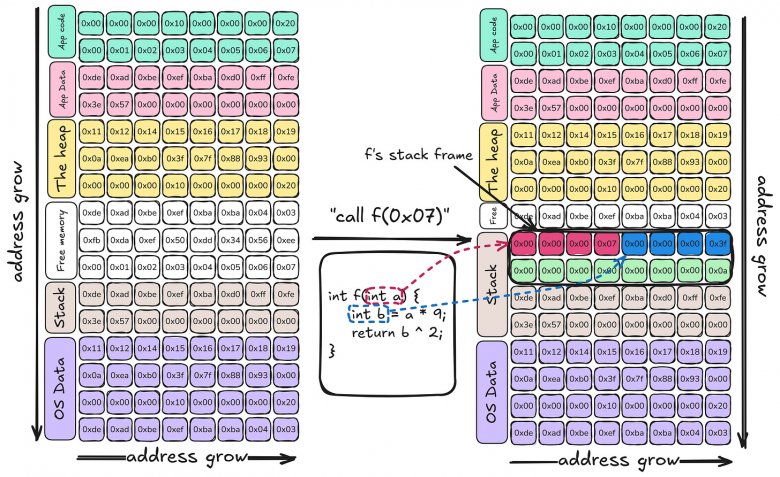
Стек управляет вызовами функций, локальными переменными и потоком управления. При вызове функции создаётся новый кадр стека. Например, при вызове функции (0x07) требуется выделить 4 байта (показаны красным) для аргумента (но в некоторых архитектурах аргументы передаются через регистры), 4 байта (синим) для локальной переменной b и 8 байт для адреса возврата.
Адрес возврата
На большинстве платформ адреса возврата хранятся бок о бок с данными функции. Чтобы объяснить, зачем нужны такие адреса, необходимо сначала определить, что такое соглашение о вызовах.
Инструкция call передаёт управление по другому адресу, но как происходит возврат управления? Когда функция вызывается с применением инструкции call, эта функция выполняется, может вернуть значение, а затем возобновляет выполнение с инструкции, следующей за вызовом:
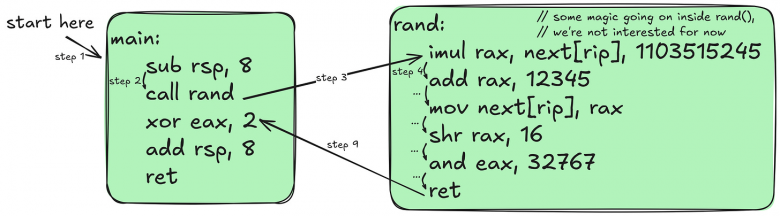
Инструкция ret (возврат) должна определить, куда направить управление (т.e., куда должен указывать RIP). Но как? В отличие от инструкции call, кодирующей адрес целевой функции, инструкция ret занимает всего один байт (0xc3) и такого адреса не содержит.
Ответить на этот вопрос поможет инструкция call. Инструкция call просто задаёт в качестве значения RIP тот адрес, по которому начинается целевая функция: сначала записывает в стек адрес следующей инструкции. Когда функция (напр., f) завершает работу, инструкция ret выталкивает этот адрес и обновляет RIP так, чтобы он на него указывал. Этим процессом управляет соглашение о вызовах, которое варьируется от архитектуры к архитектуре.
(Ещё не) эксплойт
Довольно слов — попробуем сами провернуть атаку!
Как мы обсудили выше, при атаке через переполнение буфера именно адрес возврата будет нашей основной целью. При помощи scanf злоумышленник может затереть адрес возврата, потенциально расположенный прямо за пространством, выделенным под буфер. Так можно перенаправить управление программой и выполнить вредоносный код.
Давайте углубимся в эту задачу и научимся обращаться с WinDbg, хакерским отладчиком Windows. О том, как его установить, рассказано здесь. Далее выполним следующие шаги:
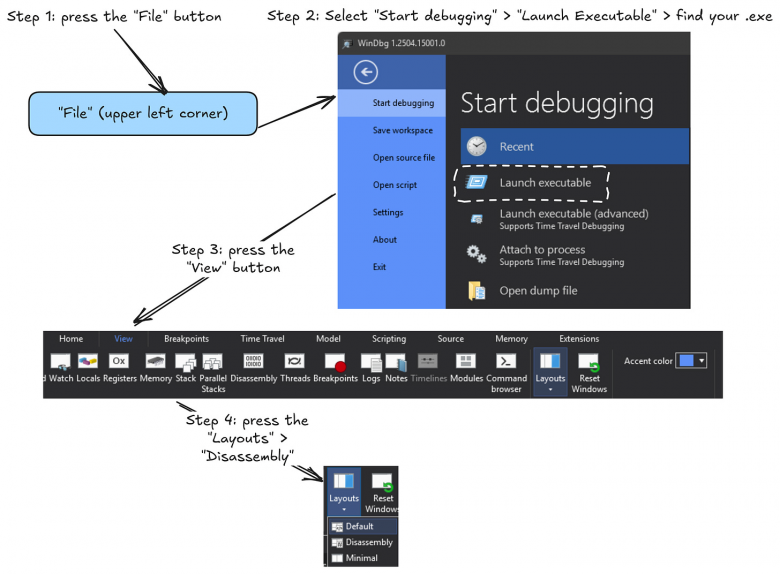
Когда сделаете всё это, перед вами должно открыться примерно такое окно:
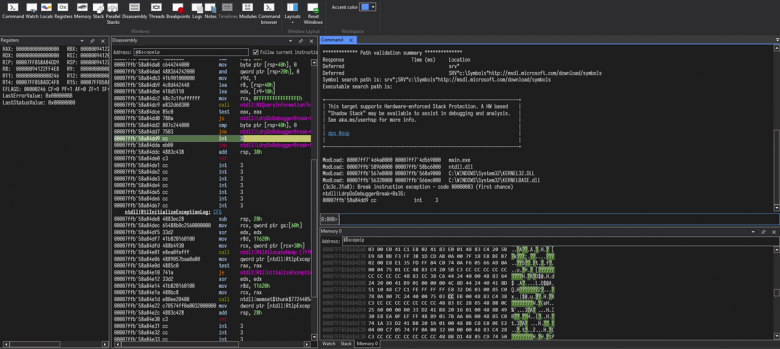
WinDbg управляется преимущественно через командную строку, но и в её пользовательском интерфейсе есть удобные функции. В этой статье сосредоточимся на командной строке, чтобы обеспечить согласованные и воспроизводимые результаты. Ниже — краткое руководство по доступным командам:
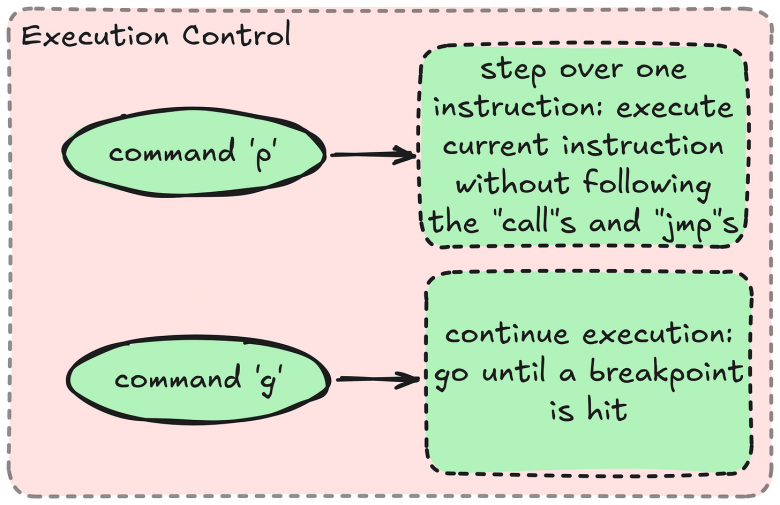
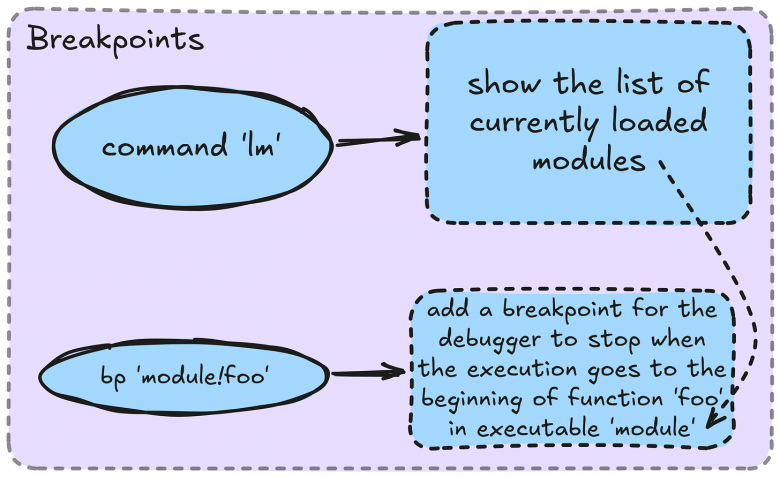
В окне 'Command' введём команду ‘bp main!main’, затем нажмём Ввод, а потом — ‘g’:
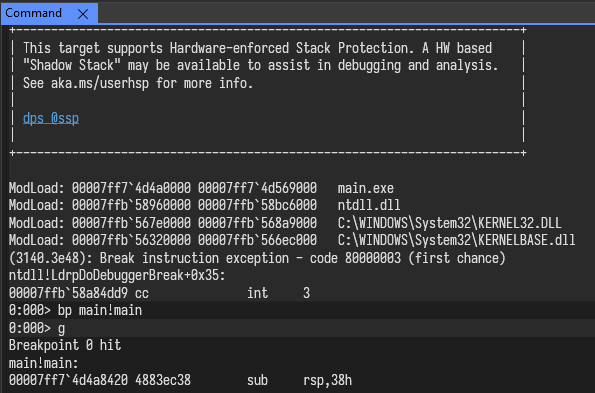
Эта последовательность команд задаёт точку останова (bp) в самом начале функции main, а затем возобновляет выполнение, чтобы попасть в неё.
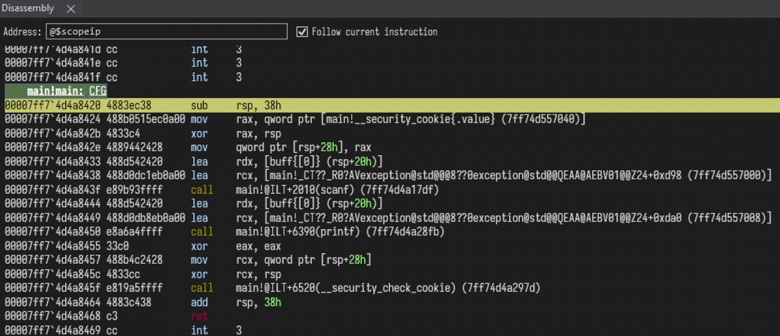
В окне 'Disassembly' должно отобразиться начало функции main, так, как показано ниже:
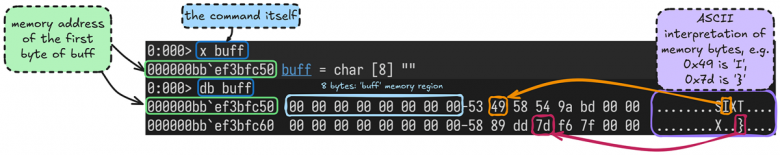
Кроме того, при помощи команд «x buff» и «db buff» можно узнать, что содержится в buff, и где именно в памяти она находится:
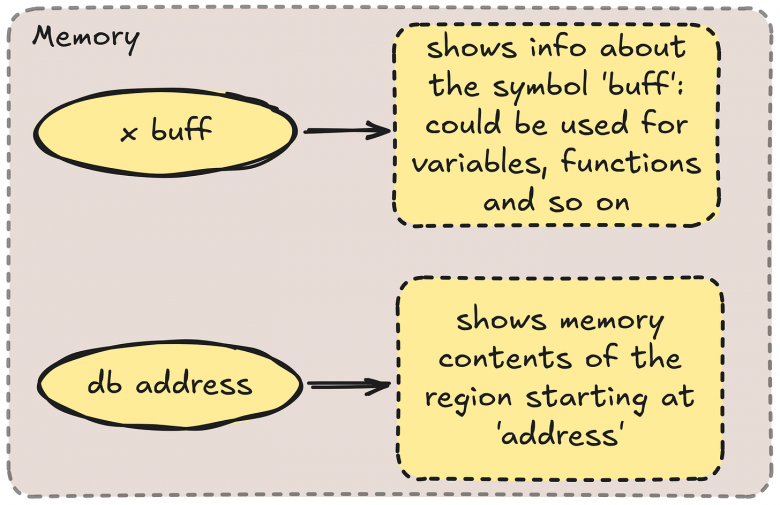
Краткая справка по командам x/db (позже будет скомпонована в единый файл image‑helper вместе с предыдущими командами):
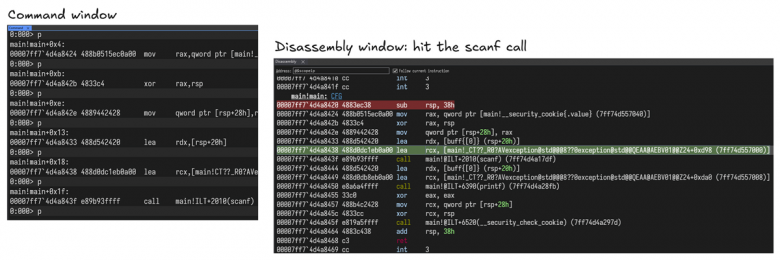
Теперь давайте посмотрим в динамике. Несколько раз выполним команду ‘p’ (шаг с обходом инструкции), и в командной строке появится приглашение ввести следующую строку:
Введите в окне консоли «ABCDEFGH12345678». По нашему замыслу, эта строка должна заполнить buff буквами «ABCDEFGH», а следующие 8 байт цифрами «12345678». Теперь перейдите в окно Windbg и снова выполните ‘x buff’ и ‘db buff’, а затем посмотрите, что произошло в памяти:
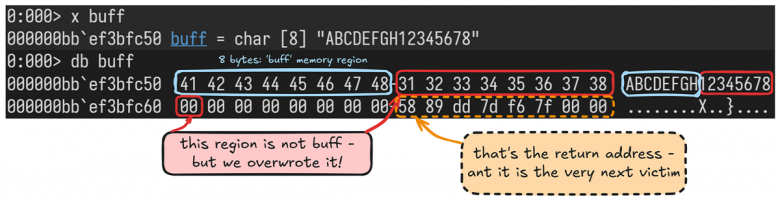
Всё прошло точно как мы планировали — первые 8 байт (собственно, область буфера) оказались заполнены буквами, а следующие 8 байт (другие данные, находившиеся в стеке) были затёрты цифрами.
Давайте попробуем ещё раз, теперь подадим на вход строку ‘ABCDEFGH12345678abcdefghIJKLMNOP», которая должна затереть и адрес возврата:
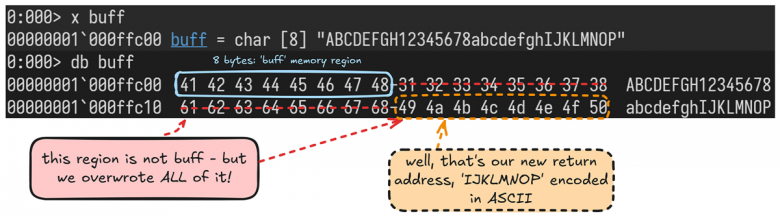
Что произойдёт, если мы позволим продолжать выполнение?
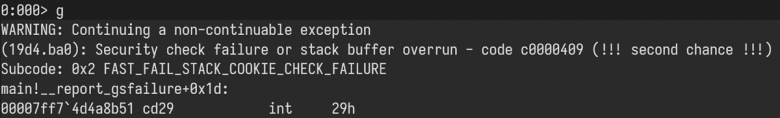
Что ж, тут не до смеха! Наше приложение только что рухнуло с исключением «Fail Fast Exception» — это сигнал, что Windows пытается защитить нас от потенциальной хакерской атаки. Операционная система вместе с компилятором MSVC реализует дополнительные проверки, помогающие предотвратить затирание адресов возврата. Разгадка этой «тайны» заключается в «стековой канарейке» — специальной страховочной фиче, размещаемой сразу же за объектом “buff”. Она появилась в компиляторе MSVC много лет назад и нужна с единственной целью — предотвратить атаки, связанные с переполнением буфера. Это уникальное значение, размещаемое после уязвимых объектов, например, после массивов или структур. Данный механизм проверяет, не было ли изменено это значение, и при любой попытке затереть адрес возврата придётся сначала повредить канарейку, что сразу же будет обнаружено.
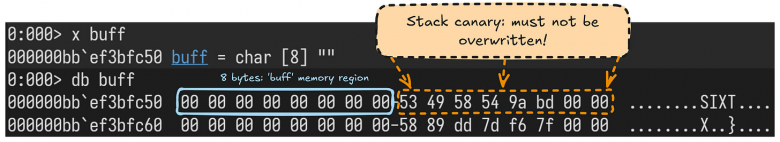
В конце главной функции выполняется вызов к __security_check_cookie, призванный подтвердить, что значение стековой канарейки не изменилось. Если проверка не пройдена, то исключение «Fail Fast Exception» инициируется именно из этой функции.
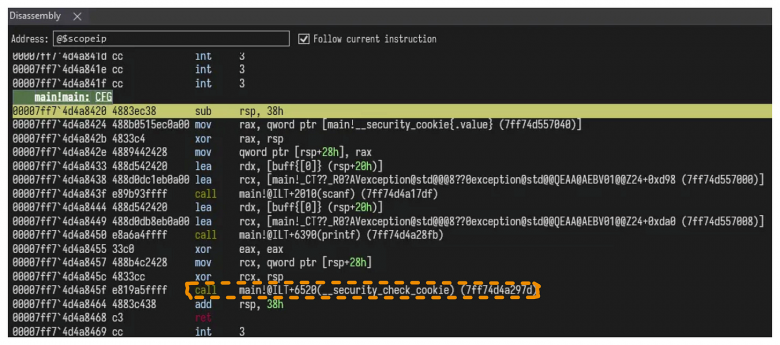
Чтобы справиться с этой проблемой, придётся откорректировать полезную нагрузку, то есть, те данные, которые мы вставляем. В них должна содержаться корректная 8-байтная канареечная последовательность. Затерев канарейку её оригинальным значением, можно обойти этот фильтр следующим образом:
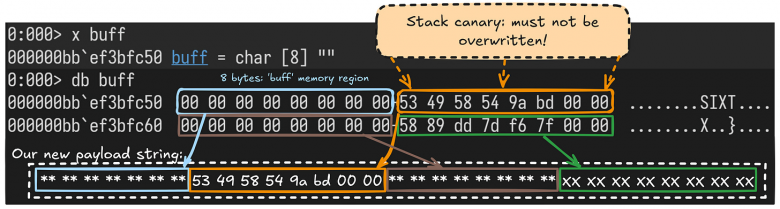
Но здесь есть и другая проблема — невозможно вставлять нулевые байты (пробелы, табуляцию, так далее), поскольку scanf трактует их как окончание пользовательского ввода! Поэтому нам ничего не остаётся, кроме как пока оставить всё как есть и затирать канарейку лишь частично. После того, как найдём способ выполнять произвольный код, придётся вернуться к этой проблеме и не допустить, чтобы сделанное нами попадало под проверку __security_check_cookie. Можете считать, что, смываясь с места преступления, мы немного заметаем следы.