

Проверить наличие подписи в выделенной области документа сложнее, чем кажется: рядом могут находиться печатный текст, печати и защитные узоры, а сама подпись бывает бледной, размытой или частично перекрытой.
Мы в Smart Engines решаем эту задачу с помощью компактной CNN на основе ResNet18 с пространственным вниманием. На вход модель получает фрагмент изображения, на выходе определяет, есть ли в нём подпись.
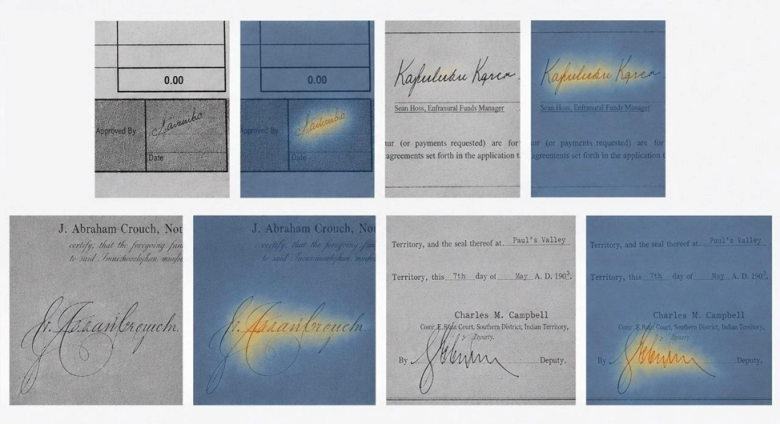
В статье покажем, как устроен модуль пространственного внимания и как его добавление повлияло на долю ложных срабатываний. А с помощью карт внимания посмотрим, какие участки области подписи модель выделяет при обработке.
Почему подпись трудно отличить от фона
При автоматической обработке документов нужно проверять, заполнены ли обязательные поля. Для договора или акта одной из таких проверок может быть наличие подписи в отведённом месте. Ошибка в этой проверке приведёт к тому, что неподписанный документ пройдёт на следующий этап обработки или пользователю придётся повторно отправлять уже подписанный.
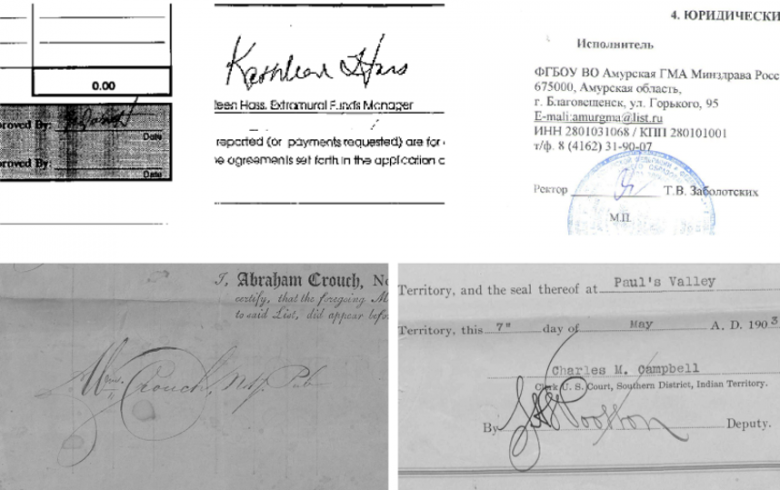
У подписи нет устойчивой формы. Она может состоять из нескольких коротких штрихов, напоминать написанную от руки фамилию или представлять собой росчерк с длинными петлями. Меняются и размер, и положение: подпись может занимать небольшой угол поля, растягиваться на всю его ширину или выходить за границы. Даже если область подписи заранее известна, внутри неё остаётся много посторонней информации.
Отделить подпись от этой информации непросто. Её штрихи пересекаются с линиями бланка, печатным текстом или оттиском печати. Защитная сетка может содержать похожие изгибы и пересечения. При этом фон нередко контрастнее самой подписи: модель может реагировать на хорошо различимый узор и пропускать бледные штрихи поверх него.
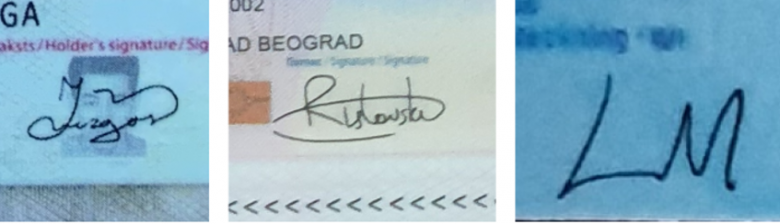
Условия съёмки дополнительно усложняют задачу. При фотографировании под углом меняются пропорции изображения, размытие сглаживает тонкие линии, а блики и тени скрывают части подписи. После уменьшения фрагмента до входного размера модели некоторые детали становятся ещё менее различимыми. Эти трудности возникают и на других этапах обработки документов. Подробнее о том, как система распознавания работает с фотографиями и видеопотоком, мы рассказывали в статье.
Таким образом, заранее выделенная область сужает поиск, но не снимает основную сложность: нужно отличить фрагмент с подписью от фрагмента без неё, несмотря на фон и потерю деталей. Именно эту задачу мы решаем с помощью бинарной классификации.
Постановка задачи
Мы рассматриваем бинарную классификацию заранее выделенной области документа, или ROI (Region of Interest). На вход модель получает фрагмент изображения, в котором может находиться подпись, и относит его к одному из двух классов: «подпись есть» или «подписи нет».
Выделение ROI выполняется до запуска классификатора. Для документов с фиксированной структурой положение поля можно задать в шаблоне — о таком подходе мы уже рассказывали на Хабре. В других случаях область может определяться алгоритмами анализа структуры документа. При этом мы не предполагаем, что фрагмент вырезан точно по границам подписи: внутри могут оставаться текст, элементы бланка и другие помехи.
На этом этапе нас интересует только наличие подписи. Определение её точных границ, выделение отдельных штрихов и проверка принадлежности конкретному человеку — отдельные задачи. Поэтому для обучения самого классификатора достаточно метки для каждого входного фрагмента; пиксельная разметка подписи не требуется.
У такого классификатора возможны два типа ошибок. Ложное срабатывание (False Positive) возникает, когда модель обнаруживает подпись на фрагменте без неё, например принимает за неё текст или защитный узор. Пропуск (False Negative) — когда подпись присутствует, но модель её не обнаруживает.
Модель на основе ResNet18 с пространственным вниманием
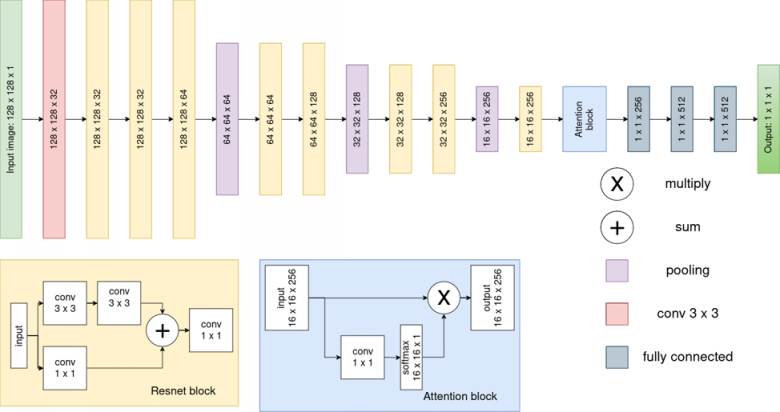
В качестве основы мы использовали облегчённую версию ResNet18: уменьшили число каналов в блоках и адаптировали сеть для работы с изображениями в оттенках серого размером 128×128 пикселей. Получившаяся модель содержит около 3 млн параметров против 11,7 млн у стандартной ResNet18.
К свёрточной части сети мы добавили модуль пространственного внимания. Он вычисляет веса для разных позиций карты признаков и использует их для взвешивания признаков перед классификацией. Так модель получает возможность усиливать вклад одних участков и ослаблять вклад других.
В нашей модификации ResNet18 на вход модуля внимания поступает карта признаков ( ) размером 16×16×256. Первые два измерения соответствуют пространственным позициям, третье — каналам признаков. Модуль обрабатывает эту карту в три шага.
Шаг 1. Вычисляем оценки для пространственных позиций
Свёртка 1×1 преобразует 256 каналов признаков в одно значение для каждой позиции. Получаем карту оценок ( ) размером 16×16×1:
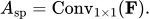
Шаг 2. Нормализуем оценки
Применяем softmax по всем пространственным позициям карты:
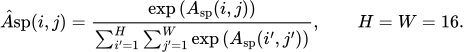
Получаем маску внимания с неотрицательными весами, сумма которых равна единице. Эти веса описывают относительное внимание к разным позициям карты признаков. Их не следует трактовать как вероятность наличия подписи в каждой точке.
Шаг 3. Взвешиваем признаки
Умножаем признаки в каждой пространственной позиции на соответствующий вес внимания. Один и тот же вес применяется ко всем 256 каналам:
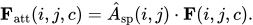
Далее взвешенные признаки поступают в классификационную голову, которая определяет наличие подписи во входном фрагменте.
Все операции модуля дифференцируемы, поэтому он обучается совместно с остальной сетью по меткам «подпись есть» и «подписи нет». Отдельно размечать штрихи подписи для обучения внимания не требуется.
Данные для обучения и тестирования
Для обучения мы подготовили 170 000 фрагментов изображений, или патчей. Набор включает три группы:
50 000 патчей на основе реальных подписей из Tobacco800. Для каждой из 705 исходных подписей генерировали случайные вырезки разного масштаба и соотношения сторон. Так мы моделировали неточности выделения ROI: подпись могла занимать разную часть входного фрагмента и находиться на разном расстоянии от его границ.
30 000 синтетических патчей с подписями. Подписи из публичных датасетов бинаризовали и случайным образом размещали на фонах документов, бланков и шумовых изображений. Это позволяло создавать дополнительные сочетания подписи и фона.
90 000 отрицательных примеров. В эту группу вошли пустые поля, текстовые блоки и другие фрагменты без подписи. Такие примеры нужны, чтобы модель училась отличать подпись от остальных элементов документа.
Для тестирования использовали фотографии макетов удостоверений личности из открытого датасета MIDV2020. В отличие от синтетических обучающих композиций, эти изображения получены при съёмке физических документов и содержат характерные для неё искажения: перспективу, размытие и неравномерное освещение.
На основе MIDV2020 мы сформировали два тестовых набора:
Набор |
Фрагменты с подписью |
Фрагменты без подписи |
Сложный |
800 |
8 000 |
Упрощённый |
600 |
6 000 |
Сложный набор использовали для оценки работы на фрагментах со сложным фоном и помехами. В упрощённый вошли подписи на однородном фоне и пустые области тех же документов. Он служил дополнительной проверкой качества в менее сложных условиях. В обоих наборах на один положительный пример приходится десять отрицательных.
Чтобы оценить вклад пространственного внимания, мы обучили две модели: с attention-модулем и без него. Остальная архитектура, обучающие данные и гиперпараметры были одинаковыми.
Результаты сравнения моделей
Чтобы оценить вклад пространственного внимания, мы сравнили облегчённую ResNet18 с такой же моделью, дополненной attention-модулем. Остальная архитектура, обучающие данные и гиперпараметры были одинаковыми.
В таблицах приведены четыре метрики. Precision показывает долю фрагментов с подписью среди положительных ответов модели, Recall — долю обнаруженных подписей среди всех положительных примеров. F1 объединяет Precision и Recall, а FPR показывает долю отрицательных примеров, на которых модель ошибочно обнаружила подпись.
Сложный набор
На выборке из 800 фрагментов с подписью и 8000 фрагментов без неё получены следующие результаты:
Модель |
Precision |
Recall |
F1 |
FPR |
ResNet18 |
90,40% |
93,00% |
91,68% |
0,99% |
ResNet18 + attention |
95,42% |
96,38% |
95,90% |
0,46% |
Добавление пространственного внимания улучшило все четыре показателя. Количество ложных срабатываний сократилось с 79 до 37 — примерно на 53%. Одновременно число пропущенных подписей уменьшилось с 56 до 29.
Таким образом, снижение FPR не сопровождалось ростом числа пропусков: модель с attention реже ошибалась на отрицательных примерах и находила больше присутствующих подписей.
Упрощённый набор
На выборке из 600 фрагментов с подписью и 6000 фрагментов без неё результаты также улучшились:
Модель |
Precision |
Recall |
F1 |
FPR |
ResNet18 |
94,96% |
91,00% |
92,94% |
0,48% |
ResNet18 + attention |
98,16% |
97,67% |
97,91% |
0,18% |
Количество ложных срабатываний сократилось с 29 до 11 — примерно на 62%. Число пропущенных подписей уменьшилось с 54 до 14, а Recall вырос на 6,67 процентного пункта.
На обеих выборках модель с пространственным вниманием показала более высокий Precision и Recall и более низкий FPR. На сложном наборе FPR снизился примерно в 2,1 раза, на упрощённом — в 2,6 раза.
Результаты attention-модели на упрощённом наборе выше, чем на сложном. Это согласуется с предположением, что фон и условия съёмки затрудняют классификацию.
Что значит увидеть подпись
На изображении документа все элементы равноправны: линия бланка может быть темнее подписи, печать — крупнее, а защитный узор — сложнее по форме. Значимость этих элементов появляется вместе с задачей. Для проверки наличия подписи несколько бледных штрихов могут оказаться важнее всего остального содержимого фрагмента.
Пространственное внимание позволяет модели учиться такому выбору. При этом карта внимания даёт нам повод внимательнее посмотреть и на собственные ожидания: какие признаки мы считаем существенными, какие помехи недооцениваем и насколько условия эксперимента похожи на те, в которых системе предстоит работать.
За небольшой задачей определения наличия подписи стоит общий вопрос компьютерного зрения: как выделять значимое в изображении, где ничто заранее не помечено как главное. В нашей работе этот вопрос принимает вполне конкретную форму — сможет ли модель заметить подпись, даже когда фон привлекает гораздо больше внимания.