

Я провожу существенную часть рабочего дня на встречах и обсуждениях. Когда родился ребёнок и начались бессонные ночи, я стал упускать детали. Какой срок назвали? Кто обещал вернуться с ответом? О чём мы в итоге договорились?
Так началась история Рекордера. Сначала я собирался купить готовое приложение. Потом стал сравнивать Whisper, Parakeet и GigaAM. В итоге проверил 32 конфигурации распознавания и собрал каскад из двух моделей: одна даёт основу текста, другая исправляет неточности. На моих датасетах это исправило каждую пятую ошибку (WER упал с 27,0% до 21,7%).
Из экспериментов получилось бесплатное приложение для Mac, которое записывает встречи и переводит аудио и видео в текст локально. Расскажу, как выбирал модели, что измерял и какие очевидные решения не сработали. В статье есть промт для агента, чтобы собрать все самому.
Почему я искал только локальную транскрибацию
Стандартное решение: набрать в поиске «транскрибация встречи» и выбрать сервис. Проблем с количеством вариантов нет. Проблема в том, чтобы понять, чем они отличаются.
Я сразу ограничил поиск локальными приложениями. На моих встречах обсуждают бюджеты, кадровые решения, условия договоров и внутренние проблемы компаний. Не каждую встречу C-level можно отправить во внешний сервис.
Знаю, что многие отдают такие записи Claude или ChatGPT. Но мне некомфортно передавать туда и сами разговоры и голоса участников. Поэтому, требование было простым: аудио и расшифровка должны оставаться только на моем ноутбуке.
Кажется, что все приложения устроены одинаково: взяли открытую модель, добавили интерфейс и предложили подписку. Есть несколько доп. фичей: запись звука, разделение участников, работа с длинными файлами. До этого я ещё дойду.
Список знакомых моделей внутри разных программ действительно повторяется. Whisper используют MacWhisper, Buzz и SuperWhisper. Handy поддерживает не только Whisper, но и Parakeet.
Вообще, я собирался просто купить SuperWhisper Pro. Помню цену около 85 долларов за год, но оплата не прошла. Возможно, если бы покупка удалась, на этом я бы и успокоился. А так, пришлось разбираться что к чему.
Начал с Whisper, это база. Он выдавал понятный текст, но заметно ошибался на моих русскоязычных встречах и работал медленно. Для некоторых задач такого качества достаточно. Мне хотелось лучше.
Что есть на Хабре
Задачу локального распознавания здесь решали не раз. Мне пригодились статьи:
Whisper без облака: локальное распознавание чувствительных записей.
Я ошибался: бенчмарк 23 ASR-нейросетей для русской айтишной диктовки.
Как я собрал полностью локальную диктовку: GigaAM, Whisper, Qwen и Apple.
После чтения Хабра и Deep Research с Claude, Gemini и ChatGPT основными кандидатами для меня стали Whisper в версиях large-v2, large-v3 и turbo, Parakeet TDT v3 и GigaAM-v3. Позже, для чистоты эксперимента, добавил Breeze-ASR, Qwen3-ASR и другие модели.
Само подключение модели оказалось самой простой частью. Прототип, который принимает файл и возвращает текст, делают даже локальные агенты. Но рабочий прототип не отвечает на главный вопрос: какую модель выбрать и почему?
На него пришлось отвечать самому и это заняло существенно больше времени чем код.
Сначала я выбирал модель на глаз
Я прогонял записи своих встреч и читал расшифровки. Пришлось навайбкодить diff-инструмент, чтобы удобнее сравнивать тексты. Первые впечатления были такими:
GigaAM хорошо слышит обычную русскую речь. Мне нравится пунктуация. Но на терминах, названиях продуктов и ИТ-сленге начинались проблемы. Текст выглядел связным, а понять суть разговора не всегда было возможно.
Parakeet существенно лучше слышал термины и англоязычный сленг. Итоговый текст выглядел хуже, модель мультиязычная и не заточена под русский язык как GigaAM, но по его тексту почти всегда можно было восстановить смысл.
Обе модели работали быстро.
Whisper показался очень внимательным к некоторым деталям. Иногда он сохранял то, что пропускал Parakeet и GigaAM. Но работал медленнее, а в некоторых местах дописывал фразы, которых на записи не было. Разброс по качеству у него был большой. Результат не выглядел стабильным, но иногда он поражал.
Это были впечатления от анализа моих расшифровок (архив из 36 часов встреч).
На тот момент я выбрал Parakeet. Для моих записей он выглядел разумным компромиссом между скоростью, точностью и сохранением терминов.
Какое-то время меня это устраивало. Потом захотелось улучшить качество, и стало понятно: дальше без измерений я буду просто выбирать текст, который больше нравится. Нужны метрики!
Как я собирал данные для сравнения ASR
Самой долгой частью оказалась разметка. Запустить модель легко. Проверить, что именно она пропустила, заменила или придумала, гораздо дольше.
Я собрал четыре набора.
Набор |
Что записано |
Длительность |
Слова / термины |
|---|---|---|---|
Бизнес-встречи |
Выбрал 82 фрагмента рабочих встреч, где модели расходятся сильнее всего. И добавил столько же случайных фрагментов. |
Около 24 минут |
1 870 / ~5% |
ИТ-речь |
Специально подготовленный текст с плотными ИТ-терминами |
Около 24 минут |
1 679 / ~41% |
Кормушка |
Рассказ про умную кормушку для кота, прочитанный двумя голосами. Что-то среднее между первыми двумя датасетами. Аналог текста из статьи @egorsokolov |
Около 24 минут |
2 391 / ~14% |
Синтетика |
200 фраз с терминами с Хабра, озвученных Silero TTS. Посмотреть насколько этот метод показывает реальность |
Около 26 минут |
2 831 / ~14% |
Получилось около 1 часа 38 минут звука с эталонным текстом и 8,7 тысячи слов. Отдельно был архив из 185 записей общей длительностью 36 часов на котором я смотрел результат после проверки гипотез на размеченной выборке. Полного эталона у него нет и нет полной разметки для подсчета WER. В архиве примерно 230 000 слов.
У набора встреч есть важная особенность: я отбирал трудные места. В 40 фрагментах модель была не уверена в результате, ещё в 42 текст выглядел странно для LLM. После чего добавил туда 82 случайных фрагмента для баланса.
Синтетику проверял отдельно. Хотел проверить, можно ли озвучивать тесты с нужными терминами и насколько этот метод подойдет для анализа.
Как считал ошибки и скорость
Основной показатель WER, считает замены, пропуски и лишние слова относительно эталона. Чем ниже значение, тем лучше. Перед сравнением я приводил текст к нижнему регистру, заменял «ё» на «е» и убирал пунктуацию. «Клод» вместо Claude считался ошибкой. Пунктуацию эта проверка вообще не оценивала.
Звук подавался кусками до 20 секунд, с разрезами по паузам. Для Whisper использовал Silero VAD, чтобы отделять речь от тишины. Замеры проводил на Intel Core i9 без ускорения на видеокарте.
Whisper, GigaAM и Parakeet на русской речи
В основной таблице оставил модели, по которым хорошо видна разница. Всего в подробном сравнении было 32 конфигурации, включая разные квантования, промпты и способы запуска.
Модель |
Встречи, WER |
IT-речь, WER |
Кормушка, WER |
Всего, WER |
|---|---|---|---|---|
GigaAM-v3 e2e |
14,8% |
52,9% |
16,3% |
27,0% |
Parakeet TDT 0.6B v3 |
24,6% |
40,0% |
13,9% |
24,6% |
Whisper large-v2 |
30,1% |
39,0% |
11,5% |
24,8% |
Whisper large-v3 |
27,1% |
59,8% |
11,6% |
30,3% |
Whisper large-v3-turbo |
28,7% |
66,5% |
11,1% |
32,5% |
Whisper medium |
39,4% |
43,9% |
13,5% |
29,6% |
Breeze-ASR-25 |
35,4% |
43,4% |
9,6% |
26,7% |
Qwen3-ASR 1.7B |
30,1% |
48,6% |
14,7% |
29,0% |
NVIDIA Canary 1B v2 |
31,9% |
47,4% |
16,4% |
29,9% |
GigaAM Multilingual 600M |
21,1% |
58,4% |
22,2% |
32,9% |
Здесь Whisper запущен с явно заданным русским языком без текстового промта, Breeze с промптом. Меньшее значение WER - лучше.
Главное наблюдение: у каждой модели есть свои преимущества и недостатки.
На фрагментах встреч точнее GigaAM. На IT-речи впереди Whisper large-v2 и Parakeet. В среднем, Parakeet действительно лучше. На начитанном рассказе лучшее значение у Breeze, что совпадает с тестами @egorsokolov.
Whisper large-v2 лучше v3 только на речи с терминами, она точнее их передает. Но на встречах v3 немного точнее. Плотный поток английских терминов v3 слышит искаженно. Вероятная причина в обучении: большую часть данных для v3 разметила сама v2, и смешанная русско-английская речь от этого лучше не стала.
Breeze-ASR-25 - это Whisper large-v2, дообученный на речи, где китайский перемешан с английским. На «Кормушке» у неё лучший результат, в основном за счёт терминов. На живых встречах Breeze ошибается и хуже почти всех моделей.
Со сжатыми моделями картина была спокойнее. У GigaAM Q8 и F32 результаты почти совпали. У Parakeet на встречах получилось 24,6% для F32, 25,5% для Q8 и 25,7% для Q6_K. Разница небольшая, но она есть. Это я не включал в таблицу, как и разные промты, они не сильно влияют на результат.
В тестах были ещё russian whisper fine-tune модели, но все они давали на моих датасетах результаты хуже чем у исходных моделей, из таблицы тоже убраны.
Синтетика отличалась по метрикам от живой речи: у Parakeet WER 16,8%, у GigaAM 22,8%. Там были видны перекосы, поэтому, я исключил ее из рассмотрения и оценок.
Почему одного WER недостаточно
После замеров стало понятнее, почему таблица и впечатления от текста иногда расходились.
WER не знает, какое слово важно для разговора. Замена названия системы и замена слова «ну» дают по одной ошибке. Но для человека последствия разные. Без названия или термина иногда нельзя понять суть разговора.
Есть и обратная ситуация. Модель написала «эластик» вместо Elastic. Для строгого сравнения это ошибка. Для читателя, который знает продукт, смысл может сохраниться.
Я хотел отделить ошибки написания от случаев, когда модель действительно исказила слово. Поэтому добавил собственную эвристику и назвал её WER по звучанию (WERx).
Она работает с текстом, а не слушает аудио. Латиница переводится в кириллический фонетический ключ, убираются мягкие знаки, пробелы и дефисы. Например, Cloud-MD и «клауд мд» получают одинаковый ключ. Дальше сравнивается близость ключей или их согласных. При этом два обычных русских слова должны совпасть точно: «пропадал» и «пропадает» не становятся одним словом.
Это не универсальная фонетическая метрика и не оценка сохранения смысла. Она нужна для вопроса: сколько ошибок связано с тем, что похожее звучание записали иначе?
Модель |
IT-речь: WER |
IT-речь: WERx |
Точно записанные термины |
|---|---|---|---|
GigaAM |
52,9% -> |
40,6% |
19% |
Parakeet |
40,0% -> |
30,7% |
47% |
Whisper large-v2 |
39,0% -> |
30,3% |
54% |
У GigaAM после такой нормализации показатель заметно улучшился. Часть ошибок действительно была связана с написанием. Но отставание от Parakeet осталось почти в десять процентных пунктов. Значит, одной транслитерацией проблему не исправить.
На встречах результат менялся гораздо меньше: у GigaAM с 14,8% до 14,1%, у Parakeet с 24,6% до 23,6%. Там не такая высокая плотность терминов.
Так у меня появились два разных требования. Нужна модель, которая хорошо передаёт обычный русский разговор. И нужен способ сохранять термины (англицизмы / сле́нг), на которых эта модель ошибается.
Каскад из двух моделей: GigaAM и Parakeet
Мне нравился русский текст GigaAM и то, как Parakeet справлялся с терминами (+ он 4 раза быстрее). Захотелось совместить их результаты.
Я взял расшифровку GigaAM за основу. Parakeet распознавал тот же звук независимо. Затем я выравнивал два текста, находил расхождения и проверял возможные замены.
Из Parakeet брал вариант, если он содержал латиницу и был достаточно похож по звучанию на соответствующий фрагмент GigaAM. Остальной текст оставлял без изменений.
Например, так удавалось заменить «апкид» на AppKit, «Sweeft» на Swift, «Промиус» на Prometheus. Но появлялись и ошибки: «диф» мог превратиться в div, а «клот» в Cloud вместо Claude. Похожее звучание ещё не означает правильную замену.
Главным параметром стал порог похожести. При низком пороге каскад охотнее принимал исправления, при высоком пропускал больше кандидатов.
Правило замены |
IT-речь, WER |
Встречи, WER |
|---|---|---|
Только GigaAM |
52,9% |
14,8% |
Латиница, похожесть от 0,3 |
41,0% |
14,5% |
Латиница, похожесть от 0,4 |
41,9% |
14,5% |
Латиница, похожесть от 0,5 |
43,4% |
14,5% |
Латиница, похожесть от 0,7 |
49,1% |
14,6% |
Похожесть от 0,5, без требования латиницы |
43,6% |
17,4% |
Без ограничения на латиницу результат на встречах ухудшался. Каскад забирал у Parakeet не только полезные термины, но и ошибки в обычных русских словах.
Для дальнейшего разбора я взял вариант с порогом 0,4. Это не универсальный оптимум, но он дает “безопасную” замену. И вот что получилось при пороге 0,4:
Вариант |
Встречи, WER |
IT-речь, WER |
Кормушка, WER |
Всего, WER |
|---|---|---|---|---|
GigaAM |
14,8% |
52,9% |
16,3% |
27,0% |
Parakeet |
24,6% |
40,0% |
13,9% |
24,6% |
GigaAM с исправлениями Parakeet |
14,5% |
41,9% |
12,0% |
21,7% |
На плотном IT-тексте каскад уступил одному Parakeet. Зато относительно GigaAM он убрал 11 процентных пунктов WER и увеличил долю точно написанных терминов с 19% до 44%.
На встречах сохранилось качество GigaAM. Разницу между 14,8% и 14,5% я бы не считал главным достижением на такой маленькой выборке. Важнее, что исправление терминов не ухудшило общий показатель. На «Кормушке», где обычный рассказ сочетался с техническими словами, каскад оказался лучше обеих моделей по отдельности.
За это пришлось заплатить вторым проходом распознавания. У каскада получился RTF около 0,3 на моём Intel. Для самого распознавания это примерно 18 минут на час аудио.
Почему основой стала GigaAM, а не Parakeet
До каскада я пользовался Parakeet. Поэтому обратный вариант тоже проверил: оставить его текст, а неуверенные слова исправлять через GigaAM. Эта схема не обогнала одну GigaAM.
Ну и дополнительный фактор: основную часть разговора составляет обычная русская речь. На ней GigaAM показывала лучший результат на моих данных. Ей и стоит доверить основу, а второй модели поручить исправления в неточностях.
Это не означает, что GigaAM должна быть основой любого распознавания. Для записи с плотным потоком английских терминов один Parakeet оказался лучше этого каскада.
Какая модель лучше исправляет GigaAM
Следующий вопрос: почему исправления должен предлагать именно Parakeet? Может, с этим лучше справится другая модель, даже если её собственная расшифровка хуже?
Я сравнил кандидатов в отдельной серии. Для всех использовал одно правило исправления, более строгое, чем в предыдущем разделе.
Модель, предлагающая исправления |
Встречи, WER |
IT-речь, WER |
«Кормушка», WER |
Всего, WER |
|---|---|---|---|---|
Нет, только GigaAM |
14,8% |
52,9% |
16,3% |
27,0% |
Parakeet |
14,8% |
42,5% |
12,1% |
22,0% |
Whisper medium |
14,4% |
41,9% |
11,3% |
21,4% |
Whisper large-v2 |
15,2% |
41,3% |
11,6% |
21,5% |
Breeze-ASR-25 с промптом |
16,7% |
43,4% |
10,2% |
22,0% |
Whisper large-v3 |
14,3% |
50,1% |
11,6% |
24,0% |
Qwen3-ASR 1.7B |
15,2% |
45,8% |
11,8% |
23,0% |
Whisper medium дал более низкий WER, чем Parakeet, на всех трёх наборах. Но работал примерно втрое медленнее. Большой Whisper large-v2 немного лучше исправлял IT-текст, зато ухудшал результат на встречах относительно одной GigaAM.
Я остановился на Parakeet, он не победил по точности, но дал хороший баланс качества и скорости: RTF Whisper medium от 0,45 до 0,68 против 0,15–0,23 у Parakeet. Large-v2 и Breeze ещё медленнее, от 0,8 до 1,7.
Заодно стало видно, что хорошая самостоятельная модель и хороший источник исправлений не обязательно одно и то же. Например, Whisper medium в основной таблице заметно проигрывал на встречах, но в роли исправляющего оказался полезен.
Что не сработало
Словарь терминов исправлял знакомые ошибки и создавал новые
Первая идея была очевидной: собрать словарь замен. Модель пишет «клот», я заменяю на Claude. Пишет «кафка», заменяю на Kafka.
Словарь, собранный по коротким IT-записям, улучшил результат на этих же записях на величину от 6 до 13 процентных пунктов. Но на длинной записи, которой не было при составлении словаря, выигрыш составил всего от 0,3 до 0,5 пункта. Исправлять уже известные ошибки оказалось проще, чем новые.
Потом я взял большой словарь из 8 130 терминов и прогнал его по архиву. «Нас» превратилось в NAS 1 246 раз, «нет» в .NET 864 раза. На IT-текстах словарь убрал 94 ошибки, а на встречах добавил 24.
Помог фильтр по частотам слов на Хабре: не делать замену, если кириллическую форму пишут не реже латинской. После очистки количество срабатываний на архиве сократилось с 3 175 до 449. Значит, проблема была не в словаре вообще, а в безусловных заменах без учёта неоднозначности.
Перекрытие аудиофрагментов не улучшило целые записи
Модели получали звук кусками до 20 секунд. У границ кусков ошибок было больше, чем в середине. Казалось логичным добавить перекрытие в две секунды, чтобы модель повторно услышала начало и конец.
На 74 коротких фрагментах WER снизился на 0,4 процентного пункта. На целых записях вырос с 30,8% до 31,3%. Улучшение на коротком тесте не выдержало проверки на длинном.
Потом выяснилось, что слова рядом с обычной паузой, где разреза не было, тоже распознаются хуже. Я связал проблему с нарезкой, хотя значительная её часть была связана с границами фраз.
Промпт улучшал один тип речи и портил другой
Я пробовал подсказывать Whisper, как записывать английские термины. У large-v3 на IT-тесте WER снизился с 59,8% до 58,1%. Зато на встречах вырос с 27,1% до 66,7%.
Подсказку нельзя оценивать только на тех примерах, ради которых её добавили. В моей задаче модель должна была справляться и с терминологией, и с остальным разговором.
Более умная метрика не улучшила каскад
Я обучил метрику, чтобы лучше различать похожие варианты GigaAM и Parakeet. Её собственный показатель AUC вырос с 0,926 до 0,941. WER каскада не улучшился.
В этой постановке даже идеальный выбор среди рассматриваемых замен мог дать на встречах лишь около 0,3 процентного пункта. Полезные и вредные замены часто были одинаково похожи по звучанию. Самой похожести не хватало, чтобы установить правильный ответ.
Попробовал учитывать и уверенность Parakeet. На встречах это убрало 0,2 пункта WER, на IT-речи добавило столько же. Для моего варианта конвейера заметного выигрыша не получилось.
Как я проверял исправления на настоящих встречах
Одного итогового процента мало. Мне нужно было видеть, какие слова меняются и почему. Дальше все пришлось проверить на архиве из 230 000 слов. На это понадобилось около 250 часов работы в фоне.
Папку с расшифровками я сделал git-репозиторием. Каждый шаг обработки сохранялся отдельным коммитом. В diff можно было посмотреть замену вместе с соседними репликами.
Так обнаруживались ошибки, которые за средним WER легко не заметить. VPN превращался в SPN. «Квик» становился Quick. «НПР1» сокращалось до NPR и теряло цифру.
Для рабочего разговора такие изменения могут быть важнее нескольких исправленных обычных слов. Особенно когда речь о названиях систем, идентификаторах и числах.
Так из экспериментов с моделями получился “Рекордер”
Рекордер использует ту же пару моделей: GigaAM даёт основу, Parakeet исправляет термины. Текст появляется сразу после первого прохода GigaAM, а исправления приходят следом, в фоне.
Рекордер записывает звук приложения и микрофон отдельно. Для системного звука используется ScreenCaptureKit. Без виртуального аудиодрайвера и ботов на встречах. Работает для звонков в Zoom, Яндекс Телемост, Google Meet, Teams и других приложений.
Две дорожки пригодились для разделения участников. На одной микрофон, на другой собеседники. Определение говорящих выполняется по дорожкам, поэтому системе не приходится с самого начала разбирать всех в одной смеси.
Итак, как перевести аудио и видео в текст бесплатно и без смс?
Скачайте Рекордер если у вас Mac со страницы приложения. Приложение принимает mp3, m4a, wav, mp4 и mov. Без ограничений длины записи. Можно расшифровать уже сохранённый звонок или перевести речь из видео в текст, не загружая файл во внешний сервис.
Текущий сценарий рассчитан на русскую речь с англицизмами. Не очень подходит для полностью англоязычных встреч.
Если у вас Windows или Linux или вы хотите самостоятельно повторить результат, то для вас есть промт, с которым это сделает ваш кодовый агент. Пишите в комментах что получилось.
Что получилось и что осталось на следующую статью
Я начинал с попытки сохранить детали рабочих встреч. В итоге больше всего времени потратил на проверку ошибок разных моделей, подбор параметров и разметку данных.
Короткий итог: GigaAM лучше справляется с обычным русским разговором, Parakeet помогает с терминами. Их каскад не стал победителем на каждом тесте. Он оказался хорошим компромиссом для встреч, где смешаны обычная речь, технические обсуждения и англицизмы.
Следующий вопрос: можно ли обобщить этот подход, выбирать основу, модели для исправлений и порядок их применения не вручную? С этим я тоже экспериментировал и нашёл хорошие цепочки каскадов. Но это отдельная история с сериями замеров.
Если статья получит отклик, то напишу продолжение.
PS: если у вас есть размеченный датасет звук -> текст и вы готовы им поделиться, то стукните в личку.
Комментарии (30)

Miller777
17.10.2026 10:08Пользуюсь GigaAM для разбора своих диктофонных записей и Handy для надиктовки в реальном времени.
Решение автора выглядит очень интересным.
Сам собрать не смогу.
Если кто-то соберет для себя под Windows/Linux, был бы рад возможности протестировать.

dsignmark
17.10.2026 10:08а ошибки на цифрах и именах отдельно не считали? для встреч WER немного обманывает, "сделаем до пятнадцатого" и "до пятого" это одна ошибка на сотню слов, а по смыслу ровно то ради чего все и затевалось) интересно было бы глянуть каскад именно на таких словах
и вопрос по виспер, тишину перед ним резали? на длинных записях без vad он у нас в паузах выдавал "Субтитры сделал DimaTorzok" и прочее наследие ютуба, в WER это тоже неплохо добавляет

pahaz Автор
17.10.2026 10:08Смотрел. Поищу что там было с WER и напишу. Делал отдельный тест.
Можно заметить, что в промте есть правило: замена, при которой пропадает цифра, не принимается. Я добавил его после проверки настоящих замен в архиве: "НПР1" превращался в "NPR", и почти каждая замена, терявшая цифру, оказывалась вредной.
pahaz Автор
17.10.2026 10:08Вернулся с цифрами. Тест был такой: надиктовал текст на 300 слов, почти целиком из чисел. В нём телефоны, коды домофона, дроби, деньги, даты, время, номера квартир, проценты и диапазоны, плюс блок того, что должно остаться словами («один из нас», «сто лет не виделись»). Распознал его GigaAM, Parakeet и двумя Whisper.
Обычный WER здесь врёт, модели пишут цифры по разному. Поэтому я номализовал и эталон, и ответы (все к цифрам) и сравниваюал по значениям, а не по записи.
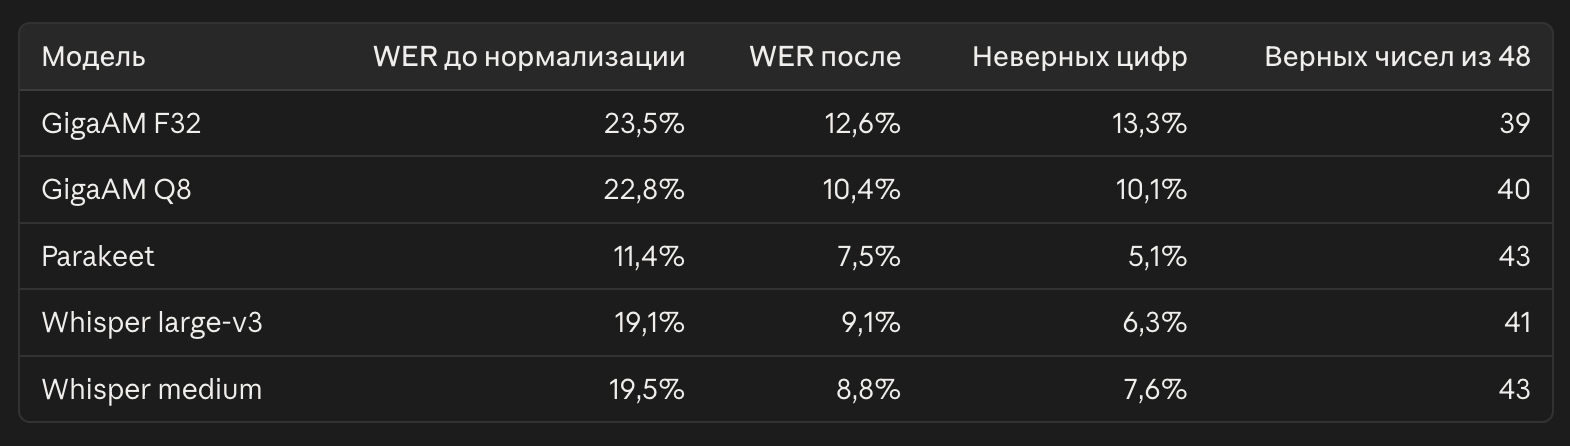
Ваш пример нашёлся почти дословно. "Дедлайн к пятнадцатому ноября" GigaAM записала как "Дедлайн ноября", Parakeet как "5 ноября", правильно написали только оба Whisper.
Выборка маленькая, одна начитанная запись, не встреча.

SavelevMatthew
17.10.2026 10:08Интересный подход. Но WER-based метрики кажутся мне немного слишком "синтетическими" для прикладной задачи "не ходить на мир и ничего не пропустить" :)
Зачастую мне хочется получить какой-то summary встречи. Выжимку фактов / выводов. Текстовые модельки хорошо умеют работать с опечатками. Из-за чего возникает закономерный прикладной вопрос: "а на практике разница WER вообще играет роль? на каком этапе стоит остановиться гнаться за метрикой?"
Возможно стоит собрать дадасет в формате: "запись" + "summary" (даты, выводы, решения...) и попробовать прогнать готовые транскрипты через какой-то LLM as a judge для того, чтобы понимать, насколько WER реально влияет на финальный результатpahaz Автор
17.10.2026 10:08Все так, но WER дает хорошую корреляцию с точностью будущего summary. Я еще отдельно смотрел на точность терминов, как дополнительную метрику. На долгих встречах, кстати, WER будет хороший, но если модель не "услышит" ключевой термин, то в summary будет какая-то ерунда.
Многие вещи LLM может понять из контекста, но я боролся не за это. Вот несколько примеров ДО -> ПОСЛЕ, где LLM не помогает:
Хочется гит-ап, с доступом по SASHO. -> Хочется GitLab, с доступом по SSH.
То есть, ответа Джейсона, достаточно -> То есть, ответа JSON, достаточно
Бинарный был протокол, там семье -> Бинарный был протокол, там CME
Биржами напрямую, там поик-фикс -> Биржами напрямую, там Quick Fix
Последние два хорошо показывают разницу ДО / ПОСЛЕ каскада. Без него не будет важных "технических" деталей. С "ответ Джейсона" и "SASHO" LLM еще разберется, но уже не каждая. Если делать summary локально, то точность терминов важна.
pahaz Автор
17.10.2026 10:08Кстати, для summary, я бы выбрал Parakeet / Wisper (v2/v3/turbo), текст будет хуже, но для summary важно не потерять термины. Ну или мой каскад, он тоже их не теряет.

Galkihtuw
17.10.2026 10:08Для итогового саммари реально важнее сохранить факты и принятые решения, чем спорить о пропущенных запятых


Akanameis
17.10.2026 10:08Я для винды делал транскрибацию английского (для учёбы)
https://github.com/ItIsAllForKira/file_small_faster/releases
Уже добавил русский, но ещё не выкладывал релиз. Если кому интересно, то могу поднапрячься и выложить. Всё локально. При первом запуске ждём загрузки модели. От мощности компа зависит очень много. 16 Гб оперативки минимум. Работает на CPU.

Shashkov_ai
17.10.2026 10:08Тоже использую GigaAm, локально скриптом на пайтоне, сначала режет длинную запись на короткие куски потом распознает и склеивает. Работает по принципу батника drop me. Супер удобно особенно если очень большая запись. Whisper large юзал, но работает дольше требует значительно больше мощности. А GigaAm гораздо лучше понимают русскую речь.
pahaz Автор
17.10.2026 10:08Да, на обычной русской речи GigaAM у меня тоже была лучшей: на фрагментах встреч 14,8% ошибок против 27–34% у Whisper. И быстрее в разы.
Но статья как раз о том, что одной GigaAM мне не хватило.
Пока разговор идёт на русском, всё отлично. Как только появляются термины и названия, она ошибается. Примеры: https://habr.com/ru/articles/1095512/comments/#comment_30538814
На моей IT-записи это 52,9% ошибок, хуже Whisper и Parakeet. Поэтому у меня GigaAM даёт основу текста, а Parakeet в местах, где модели расходятся, подставляет термины.
Если у вас записи без терминов, одной GigaAM вполне хватит.

xaxexa
17.10.2026 10:08Просто купи самсунг…

funca
17.10.2026 10:08Телефоны дообучают модели распознавать речь владельца. Это крутая фича для личного использования. Но непонятно как ее можно применить хотя-бы в рамках команды. Транскрибация рандомных записей эфира штатными средствами даёт ужасное качество.
funca
17.10.2026 10:08В своих экспериментах с транскрибацией я уперся в неоднозначность, которую непонятно как побороть. Иногда нужен точный текст - как именно говорил человек - с ошибками, неточностями, особенностями артикуляци. В другом случае смысловой, - что он хотел сказать - очищенный от слов-паразитов, нормализованный по лексике (здесь, что считать за норманость сильно зависит от контекста). В обоих случаях проблем добавляет пунктуанция (пресловутое "казнить нельзя помиловать"). Я пока лишь понял, что труд стенографистки или субтитровщика это не механическая работа, а искусство.
Качество работы моделей whisper сильно зависит от диктора и нарезки звука. У разных людей свои особенности речи (клод, клауд, клавдия). Паузы не всегда означают конец предложения или мысли. Фрагменты, разорванные в середине выссказывания (а ещё хуже - слова), сильно увеличивают количество ошибок распознавания.
Я пробовал использовать аудио книги и их текстовые оригиналы в качестве датасета. Но начитка профессиональными дикторами сильно отличается от речи обычных людей. У роликов и субтитров с YouTube свои проблемы: нужно предварительно очищать шум и часто текстовка вызывает вопросы не только у моделей.
pahaz Автор
17.10.2026 10:08Мне в голову сразу пришёл пример: на собеседовании кто-то говорит «ЯваСкрипт», а в расшифровку это попало как «JavaScript» :)
Для HR это, возможно, не самая удачная транскрибация.
А вообще, все так, у каждого решения есть свои границы применимости.

True_form
17.10.2026 10:08Не пробовали обмазать сверху небольшой локальной моделью llm, чтобы она восстанавливала из контекста и исправляла ошибки?
pahaz Автор
17.10.2026 10:08Пробовал, выставление встреч в календаре, прикрепление summary, много кастомизации под "предпочитаемые" мной инструменты. Хорошо работает поверх папки с расшифровками. Даже локальные AI-агенты в состоянии делать summary, выделять задачи и поручения. Но это очень индивидуально из-за выбора инструментов.

AleX83Xpert
17.10.2026 10:08Спасибо за статью! Особенно полезно было увидеть реальное сравнение моделей. Теперь захотелось попробовать заменить Vosk в своем умном доме. А если текст подтолкнул кого-то к действию, то это вдвойне круто! Уважение!

SmileyK
17.10.2026 10:08Либо я не увидел либо вы не делаете разделение речи где говорите вы и где собеседник(ки)?
pahaz Автор
17.10.2026 10:08Это есть в реализации Рекордера. В статье упомянуто вскользь, она и так большая.
Рекордер пишет микрофон и звук звонка двумя отдельными дорожками, поэтому где я, а где собеседники, видно сразу. Собеседников внутри второй дорожки он дальше разделяет по голосам, имена можно задать руками.
Отдельная история с эхо. Если слушать звонок через динамики, микрофон слышит собеседника, и одна реплика попадает в обе дорожки. Оставил правило: если на микрофоне в этом месте в основном эхо, реплика с микрофонной дорожки убирается.
В промте это тоже есть: микрофон подписывается "Я", системный звук "Собеседники", а собеседников можно разделить диаризацией из sherpa-onnx.
Galkihtuw
17.10.2026 10:08Разделение системного звука и микрофона по двум физическим каналам решает 90% проблем с диаризацией без всяких тяжелых нейросеток

pover_gara
17.10.2026 10:08Интересный подход, я о варианте с каскадом не думал, за то попробовал кое-что другое:
В оригинальной библиотеке gigaam от Сбера используется greedy search, я его заменил на Beam Search что позволило в свою очередь добавить буст по префиксам используя предварительно построенное дерево всех возможных токенизаций словаря терминологии. Есть ряд ухищрений, который позволяет этой истории работать не сильно медленнее обычного beam search без наворотов, замеров мы не делали, да и датасет у нас небольшой, но за то получилось достичь двух вещей:
Word level timestamp
Очевидно улучшение распознавания терминологии.
Решение пока ещё доводится до ума, задача не приоритетная, так что подеоиться особо нечем:(
pahaz Автор
17.10.2026 10:08Интересная идея, о бусте прямо в декодере я не думал. Я бы попробовал пойти дальше: брать на каждом куске несколько вариантов распознавания сразу от разных моделей и вести параллельные цепочки. Дальше либо собирать итог из цепочек нескольких моделей, либо вообще обучить поверх этого классификатор, который решает, какой модели верить в конкретном месте.
Пробовал это делать на уровне слов: вредные замены звучат так же похоже, как полезные, а уверенность модели их хоть и отделяет, но на итоговом тексте почти ничего не дала (около -0,2 пп). Нужно выборка больше, я это не стал добавлять.
С каскадом может получиться: сейчас у меня в спорном месте всего по одному варианту от каждой модели, а с вашим бустом их будет больше и с оценками.
Но есть сложность: тайминги у моделей выровнены не очень. Начала слов у GigaAM и Parakeet у меня совпадали неплохо, а концы устроены по-разному: у GigaAM слово заканчивается почти там же, где началось, а Parakeet растягивает его до следующего. Так что распознанные куски придётся как-то синхронизировать по времени, прежде чем сравнивать цепочки.
Идея интересная, надо тестировать. Если доведёте до замеров, напишите, очень интересно сравнить.
pover_gara
17.10.2026 10:08Чисто интуитивно что-то мне подсказывает, что предскаания следующего токена могут просто напросто сломаться, если одной модели выдать перетокенизированное предсказание другой модели в качестве предыдцщего результата(говорю о RNNT в первую очередь)
Отнсительно таймингов - не замечал такой проюлемы. посмотрю в своей реализации, я там границы слов сам собираю
pahaz Автор
17.10.2026 10:08У каждой модели свои предидущие токены. В параллель собрать несколько цепочек от двух моделей. И выбирать из них.
vmkazakoff
Оч круто. Себе сделал диктофон в обсидиан + распознает в нем же. Тоже остановился на сберовской модели. Не совсем понял, а как вы сделали сравнение? Две модели получили чуть разные тексты, а потом...? Вот это выпало, но очень интересно. Мне такое надо, а то вечно "иишка" в "яичницу" транскрибируются (((
Диктофон из коробки мне не нравится, нифига не понятно было пишет или нет, так что тоже пришлось сделать свой.
pahaz Автор
Спасибо! Склейка устроена так:
Обе модели распознают одни и те же куски звука (до 20 секунд, режутся по паузам). За основу берётся текст GigaAM.
Два текста выравниваю по словам, как diff двух строк (
difflib.SequenceMatcherпо словам в нижнем регистре, без пунктуации). Совпадения пропускаю, смотрю только места, где тексты разошлись.В каждом расхождении сравниваю 1–2 слова GigaAM с 1–2 словами Parakeet и беру вариант Parakeet, только если выполнены все условия:
вариант Parakeet целиком латиницей;
со стороны GigaAM нет предлогов, союзов и частиц;
по звучанию варианты похожи хотя бы на 0,4;
при замене не теряются цифры.
Похожесть по звучанию считаю так: латиницу перевожу в кириллицу по правилам английского чтения (sh→ш, ch→ч, c перед e/i → с, j→дж…), ё/э→е, й/ы→и, мягкий и твёрдый знаки убираю, двойные буквы схлопываю. Похожесть = 1 − (расстояние Левенштейна) / (длина более длинной строки). Так «апкид» и AppKit оказываются близки, и замена проходит.
В промте для АИшка подробно расписано: https://gist.github.com/pahaz/db2faf33bd0e1ca45b815b0f705a9b41
Главное правило: русское слово не меняется на русское. Без него Parakeet приносил в текст свои ошибки в обычных словах, и на встречах WER рос с 14,8% до 17,4%.
pahaz Автор
Кажется, что «иишка» → «яичница», к сожалению, такой каскад не вылечит. Можно поправить словарем, я себе такое тоже добавил для похожих кейсов, но для общего случая, тут нужно чтобы одна из моделей "слышала" это слово.
У меня есть локальная версия с более сложными каскадами, попробую ваш текст, позже напишу что получилось.
pahaz Автор
Сравнил, как четыре модели распознали эту запись (около 70 секунд, один голос, микрофон ноутбука).
... ИИшка ...
GigaAM-v3 e2e RNN-T: «яишка»
Parakeet TDT 0.6B v3: «ИИшка»
Whisper medium: «ИИшка»
Whisper large-v3: «ишка»
... Синхрофазотрон ...
GigaAM-v3 e2e RNN-T: «синхропозотрон»
Parakeet TDT 0.6B v3: «синхрофозотрон»
Whisper medium: «синхрофазотрон»
Whisper large-v3: «синхрофазотрон»
... Штуку-дрюку ...
GigaAM-v3 e2e RNN-T: «штуку-дрюхку»
Parakeet TDT 0.6B v3: «штуку дрюку»
Whisper medium: «штуку, Дрюку», сделал из слова имя
Whisper large-v3: «штуку-дрюку»
... Фигурина ...
GigaAM-v3 e2e RNN-T: «фигурина»
Parakeet TDT 0.6B v3: «фигурино»
Whisper medium: «фигурина»
Whisper large-v3: «фигуре на»
Забавно, что на этом примере тоже видны особенности моделей.
У GigaAM самая аккуратная пунктуация и оформление, но он ошибается в редких словах. Whisper лучше знает термины, но теряет пунктуацию. Parakeet услышал «ИИшку», но спотыкается на мелочах.
Поэтому тут помог бы каскад, но он пока подставляется только латиница, так что ни «ИИшку», ни «синхрофазотрон» каскад здесь не подхватил.
Я еще пробовал собирать общий текст из вариантов разных моделей и давать в LLM, но они начинают "выдумывать слова" и в итоге мне не удалось найти какой-то стабильной конструкции, которая стабильно улучшала WER.
Описанный в статье каскад в этом плане стабилен, он увеличивает WER. Для вашего примера подошел бы каскад со словарем, я об этом хотел писать в следующей статье. Я еще эксперементирую.