

Всем привет! Меня зовут Владимир, я DS-инженер и сегодня расскажу, как оценивать агентные системы. Разберём, как замерить и выстроить пайплайн оценки, который показывал бы вам, насколько хорошо повлияли те или иные фичи на качество вашего продукта.
Определения
Прежде чем погружаться в тестирование, договоримся о терминах:
LLM (Large Language Model) — большая языковая модель, обученная предсказывать следующий токен на огромных корпусах текста.
Tool (инструмент) — функция, которую LLM может «вызвать» во время генерации. Технически это описание сигнатуры (имя, параметры, описание), которое мы передаём модели вместе с промптом. Модель решает, нужен ли вызов, и возвращает структурированный JSON с аргументами. Дальше запускается функция, в которую передаются аргументы. Типичные инструменты: поиск по базе знаний, обращение к внешнему API, запуск SQL-запроса.
Агент — система, в которой LLM работает в цикле «подумай — вызови инструмент — получи результат — подумай дальше», пока не достигнет цели или не упрётся в ограничение.
Если вы ещё не знаете, как сделать своего агента, рекомендую мою вводную статью.
В чём проблема
LLM известны своей недетерминированностью. Если вы зададите ChatGPT один и тот же вопрос, результаты будут различаться. Это в первую очередь связано со стохастической (вероятностной) природой, на которой строятся современные большие языковые модели.
Когда возникает стохастика, прошлые подходы, работающие в классическом тестировании, применять сложно, но при этом мы хотим, чтобы наши тесты покрывали и corner-кейсы, и регрессии, и негативные сценарии, и основной путь пользователя. Добавим к этому, что у агента есть ещё и траектория вызовов инструментов, и получим, что классический assert response == expected не работает почти никогда.
Если мы говорим про агентов, то они используют инструменты много шагов подряд, меняют состояние окружения и адаптируются по ходу, и именно поэтому ошибки распространяются и накапливаются. Соответственно если простая LLM ошиблась, то мы получили плохой ответ. Если ошибся агент — он мог за десять шагов до этого свернуть не туда и теперь делает осмысленные действия в неправильном направлении.
Как же здесь быть?
Методология тестирования
Тестирование можно сделать в несколько шагов (Anthropic называет это Swiss cheese model). Каждый слой защиты сам по себе дырявый, но, наложенные друг на друга, они закрывают почти все ошибки.
Я бы разделил тестирование на следующие компоненты:
Бенчмарки — широкое измерение качества на стандартизированных данных
Функциональное тестирование — проверка корнер-кейсов и регрессий
Оценка траектории — проверка, какими инструментами и в каком порядке агент дошёл до ответа
G-Eval / LLM-as-a-Judge — оценка с помощью LLM-судьи
Асессоры — внешняя ручная разметка для масштаба
Разметка командой разработки/продукта/QA — внутренняя экспертная разметка
Продакшен-мониторинг и A/B-тесты — оценка на реальном трафике
Anthropic называет это Swiss cheese model — швейцарский сыр:
Ни один из компонентов не работает в одиночку:
Бенчмарки дают объективность, но быстро устаревают.
Функциональные тесты ловят регрессии, но не отвечают на вопрос «стало в среднем лучше или хуже».
LLM-судьи дают масштаб, но шумят.
Асессоры — глубину, но медленно.
Команда — экспертизу, но не масштабируется.
Продакшен — правду, но бывает уже поздно.
Давайте рассмотрим каждый элемент по отдельности.
Бенчмарк
Бенчмарк — это заранее заготовленные данные, которые содержат вход (то, что будет поступать в нашу систему) и эталонный ответ, которым наша система должна ответить. Иногда вместо эталонного ответа задаётся проверяемый критерий — например, прошёл ли итоговый код тесты.
Бенчмарки можно как собирать самостоятельно, так и брать открытые.
Открытые бенчмарки для агентов
SWE-bench — реальные issues с GitHub из популярных Python-репозиториев. Агент должен сгенерировать патч, который проходит скрытые тесты.
GAIA — общий benchmark для агентов-ассистентов: задачи, требующие веб-поиска, чтения файлов, рассуждений. Позволяет оценить способность агента строить длинные траектории.
BFCL — фокус на корректности вызова tools: имя функции, типы параметров, обработка параллельных вызовов.
Главная ловушка открытых бенчмарков — они могли утечь в обучающую выборку моделей, и тогда вы измеряете не способности, а память. К тому же ваш продакшен почти никогда не выглядит как открытый бенчмарк, поэтому самописный бенчмарк под свой домен ценнее любого публичного.
Свой бенчмарк
Для сбора собственного бенчмарка есть несколько источников:
Синтетика через LLM — быстро, дёшево, удобно для покрытия редких сценариев. Минус — модель склонна повторяться и упрощать и бывает достаточно далека от продакшен распределения.
Исторические данные — логи диалогов или транзакций из старой системы. Дают реалистичное распределение, но требуют разметки эталона.
Логи продакшена с разметкой — самый ценный источник. Семплируем долю трафика, отправляем на разметку, складываем в бенчмарк.
Функциональное тестирование
Из классической теории тестирования мы берём функциональные тесты. Здесь можно разбить их на два типа:
Output функции всегда фиксированный
Output функции может меняться
Если output фиксированный — классический assert. Это сценарии, где у агента есть однозначно правильное действие: вернул ли он нужный tool call, отказался ли отвечать на запрещённый запрос, вернул ли структурированный JSON нужного формата.
Если output меняется — используем судей (LLM-as-a-Judge). Например, проверяем, что ответ агента содержит указанный факт, поддерживает заданный тон или не противоречит политикам.
Главное в функциональном тестировании — поместить туда именно corner-кейсы и баги, которые вы чинили в прошлых релизах. Это страховка от регрессий: при новой фиче мы не должны ломать сценарии, критичные для продукта.
Я рекомендую делать сбалансированные тесты: на каждый позитивный кейс «здесь агент должен сработать» должен быть негативный «здесь агент не должен срабатывать».
Иначе оптимизация может уйти в одну сторону, например, фильтр токсичности станет блокировать всё подряд, потому что вы тестировали только «должен блокировать».
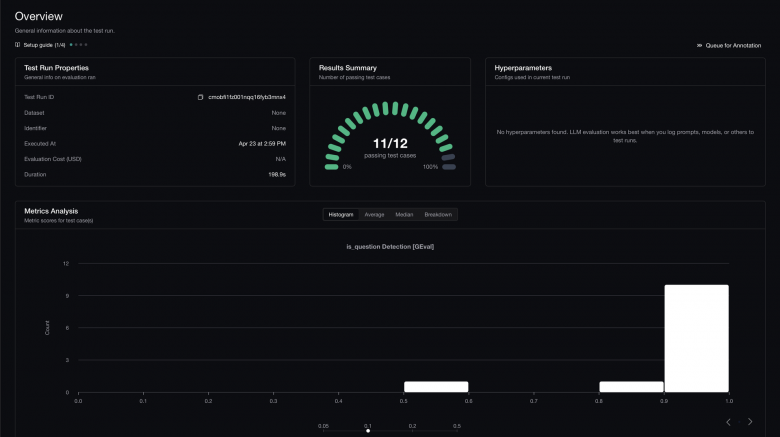
Что касается технической реализации, можно использовать фреймворк DeepEval. Под капотом он позволяет реализовать как простые функциональные тесты, так и тесты с судьями. Плюс ко всему у него есть достаточно приятный веб-интерфейс с историей прогонов, сравнением версий и трендами по метрикам.
Оценка траектории
Trace траектории — это полный лог исполнения: каждый tool call, каждый ответ модели, каждый результат, возвращённый инструментом.
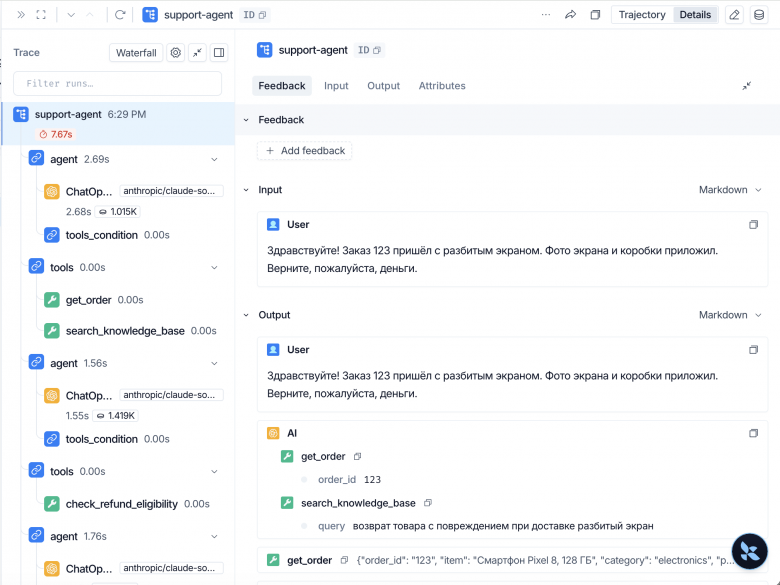
Финальный ответ может быть хорошим, но если агент при этом вызвал 40 инструментов вместо 4 или вытащил приватные данные из соседнего сервиса - это всё равно провал.
Есть несколько возможностей сравнивать с эталонной траекторией:
Strict — точно такая же последовательность tool calls в том же порядке. Уместно, когда порядок принципиален.
Unordered — те же tool calls, что и в эталоне, в любом порядке.
Superset — агент вызвал все нужные инструменты, может вызвать ещё (например, дополнительные проверки).
Subset — разрешено вызвать меньше, чем в эталоне, но нельзя вызвать то, чего в эталоне нет.
Также еще можно навешивать LLM-as-a-Judge поверх траектории: судье даётся весь лог и просьба оценить, разумной ли траектория была. Нужно калибровать, иначе может быть достаточно шумной метрикой.
Совет из практики
Современные модели регулярно находят валидные подходы, которые вы можете не предусмотреть. Жёсткая проверка траектории штрафует за креативность.
Практический компромисс: проверяем траекторию только на критичные ограничения (вызвал ли проверку прав, не вызвал ли запрещённый инструмент), а остальное оцениваем по результату.
G-Eval
G-Eval — это подход, в котором LLM выступает в роли судьи: получает на вход вопрос, ответ системы и критерий и возвращает оценку.
Типичные критерии для G-Eval:
Faithfulness — нет ли галлюцинаций относительно предоставленного контекста.
Relevance — отвечает ли система на вопрос пользователя.
Coherence — связность и логичность ответа.
Policy compliance — соблюдение бизнес-правил и тона.
Рекомендации
Прежде чем калибровать судью, есть смысл задуматься о шкале самой оценки. Лучше использовать бинарные оценки, чем шкалы 1–5 или 0–100%. Бинарный вердикт проще согласовать между людьми и LLM. Если нужны пояснения, добавляйте reason рядом с вердиктом.
Про калибровку. LLM тоже нужно калибровать, потому что ваше чувство прекрасного и модели могут различаться. Соберите 100–200 примеров, разметьте самостоятельно или командой, прогоните через судью и посчитайте корреляцию (Cohen's kappa, Spearman).
И еще:
Verbosity bias - Сильные модели (Claude, GPT-4 класса) более согласованы с человеком, но и они переоценивают «многословные и уверенные» ответы.
Judge capability limitations — выбирайте оценщика, который превосходит оцениваемую LLM на задачах вашего домена.
Self-Preference Bias - модель узнаёт свой собственный текст по статистике токенов без явных подсказок. Sonnet, ревьюющий Haiku, заведомо лоялен, потому что они из одного семейства. На критичных проверках держите судью из чужого семейства: Claude → GPT/Qwen/DeepSeek-судья.
Position bias — при попарном сравнении (ответ A против ответа B) судья систематически предпочитает ответ на определённой позиции, чаще первый. Прогоняйте оба порядка и засчитывайте победу, только если вердикт не поменялся.
Многосудейный консенсус — для критичных критериев стоит брать оценку от нескольких разных моделей и усреднять.
Несколько прогонов — g-eval достаточно шумный, поэтому один и тот же ответ оценивайте k раз (в качестве метрики можно взять pass@k) и берите большинство голосов.
Асессоры
Когда нужен масштаб разметки, в дело идут асессоры, внешние разметчики на специализированных платформах.
Главная сильная сторона: если грамотно все организовать, можно получить конвейер для разметки данных. Подкидывай туда угли деньги, и он будет жить вечно.
Слабые стороны:
Много подготовки. Нужно написать инструкцию, разметить часть данных, составить задания, согласовать бюджет, проверять экзамены, следить за разметчиками и т.д.
Это стоит денег.
Это медленно: от постановки задачи до готовой разметки проходят дни, а то и недели.
Как добиться хорошего качества:
Экзамен — сначала проверяешь разметчиков на заранее размеченных примерах и только потом допускаешь в бой.
Перекрытие — каждое задание размечают 3–5 человек, итог берётся мажоритарным голосованием.
Honey pots (контрольные задания) — в поток подмешиваются примеры с заранее известным ответом, в том числе специально сломанные данные, на которых правильный ответ только один. Разметчик, который на них ошибается, наказывается, а его разметка перепроверяется.
Согласованность разметчиков. Если согласованность низкая у всех, проблема почти всегда в инструкции, а не в людях. Критерии сформулированы неоднозначно.
Контроль скорости и других метрик— подозрительно быстрые ответы обычно означают, что человек кликает не читая. Ставьте минимальное время на задание и отслеживайте аномалии.
Пилот и итерации инструкции — сначала запускайте небольшой пул заданий, разбирайте спорные кейсы и дописывайте в инструкцию примеры. Обычно нужно 2–3 итерации, прежде чем запускать разметку на весь объём.
Также рекомендую обзавестись удобным интерфейсом для разметки - это будет уже половина победы.
Разметка командой
Первую часть данных можно собрать с помощью команды. Зачастую они уже хорошо понимают доменную область, поэтому смогут достаточно быстро и без лишнего геморроя разметить первые данные.
Когда оправдано:
На старте проекта — пока нет ни инструкции, ни понимания, что считать хорошим ответом. Разметка командой и есть процесс выработки этих критериев.
Sanity check — небольшая выборка перед каждым релизом, которую смотрит человек, понимающий продукт.
Сложные домены — медицина, юриспруденция, финансы.
Калибровка судей и асессоров — золотая выборка от команды как ground truth для всего остального пайплайна.
Рекомендация: чтобы это не сжирало команду, выделяйте ограниченный бюджет (например, 30 минут в день у дежурного), заведите удобный интерфейс разметки и считайте межэкспертную согласованность.
Продакшен-мониторинг
Никакой офлайн-бенчмарк не воспроизводит реальный трафик. Что мониторить в проде:
- Технические метрики: latency p50/p95/p99, доля таймаутов, стоимость токенов на запрос, длина траектории.
- Поведенческие: доля fallback-ответов, доля диалогов, в которых пользователь повторил запрос (признак того, что первый ответ не помог).
- Продуктовые метрики: CSAT от пользователей, retention, доля диалогов с эскалацией к человеку.
- Семплированный G-Eval на проде — небольшой процент диалогов уходит в оценку судьёй с теми же критериями. Это даёт онлайн-метрику качества без ожидания асессорской разметки.
Как это устроено у нас
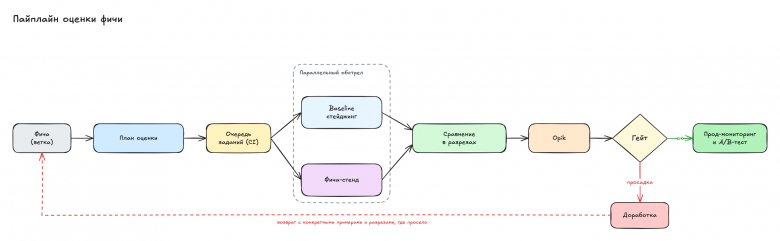
Теперь расскажу, как мы собрали все эти слои в единый пайплайн. Его основа гейты: контрольные точки, через которые должна пройти любая фича, прежде чем попасть в прод.
План оценки — до разработки
Когда мы берём в работу фичу, мы заранее фиксируем, на чём будем её проверять. Набор состоит из двух частей:
Обязательная часть (регрессионная) — прогоняется для любого изменения: safety-проверки и функциональные тесты на регрессии. Это тот самый «нижний слой сыра», который не даёт сломать то, что уже работает.
Специфичная для фичи часть — бенчмарки, g-eval, асессорская разметка, которые покрывают именно тот сценарий, который мы меняем.
Так мы заранее договариваемся, какие метрики должны вырасти, а какие как минимум не просесть.
Очередь и CI
Прогон оценки встроен в CI-процесс. Когда фича готова к проверке, в очередь ставится задание: какие бенчмарки и тесты прогнать и на каких окружениях. Очередь нужна потому, что прогоны долгие и дорогие.
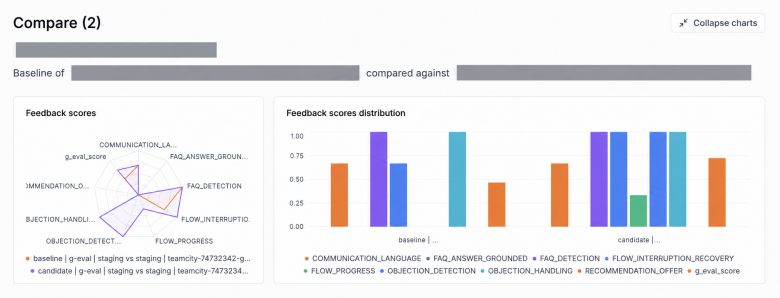
Дальше происходит обстрел baseline против кандидата. Мы параллельно «обстреливаем» два окружения одним и тем же набором данных:
Baseline — стейджинг, то есть текущая версия агента без изменений.
Кандидат — фича-стенд, окружение, на котором раскатана ветка с новой фичей.
Почему именно параллельно, а не сравниваем со вчерашним прогоном?
Потому что результат агента зависит не только от нашего кода: внешние API, версии моделей у провайдера, данные в базе знаний всё это меняется со временем.
Сравнение в разрезах
Одной агрегированной цифры недостаточно: фича может поднять среднее качество, но сломать какой-то узкий, но важный сценарий. Поэтому мы сравниваем результаты в разных разрезах:
по бенчмаркам и отдельным метрикам
по нескольким сценариям, чтобы рост в одном сценарии не перекрывал просадку в другом
по позитивным и негативным кейсам
по траекториям: число шагов, лишние или запрещённые вызовы инструментов
по техническим метрикам: latency и стоимость токенов на запрос.
Визуализация
Результаты обоих прогонов складываются в Opik. Там мы видим эксперименты рядом друг с другом: какие метрики выросли, какие упали и на сколько, а главное, можем провалиться до конкретного примера и его траектории и понять, почему агент на кандидате ответил хуже, чем на baseline.
Решение гейта
По итогам сравнения гейт либо пропускает фичу дальше, либо нет. Если обязательная часть просела или целевые метрики не выросли, фича возвращается на доработку, и мы уже точно знаем, на каких примерах и в каком разрезе искать проблему. Если всё зелёное, то фича идёт дальше, в продакшен-мониторинг и A/B-тест, где проходит последний слой проверки на реальном трафике.
Итоги
Оценка агентной системы должна помогать ответить на конкретный вопрос: стало ли после нашего изменения лучше пользователю и какие сценарии мы могли сломать. Для этого нужны несколько способов проверки: тесты на известные ошибки, оценка результатов и действий агента, человеческая разметка и наблюдение за реальным трафиком. У каждого способа есть ограничения, поэтому они дополняют друг друга.
Если вы тоже разрабатываете LLM-продукты, заглядывайте в мой Telegram-канал ML без потерь. Там я разбираю, как устроены агенты, где они ошибаются и как проверять, что очередное изменение действительно улучшило систему. Буду рад видеть вас среди читателей.