

Читая новости, невольно офигеваешь удивляешься тому, что могут современные роботы. Судите сами: гуманоид Tesla наливает гостям напитки, гуманоид Figure укладывает детали на заводе BMW, китайские роботы бегают полумарафон и крутят сальто (не спрашивайте, зачем), а наш сберовский Грин уже вовсю танцует.
Это реально впечатляет, и за всем этим стоит серьёзная работа и достижения. И всё же… Тут есть нюанс. Изнутри мир робототехники выглядит иначе, чем он видится людям снаружи.
Напоминаю, что меня всё ещё зовут Олег Плотников, я руководитель продукта «Цифровая промышленность». Как и обещал, сегодня я расскажу про ИИ. Но начнётся этот разговор совсем не с RAG, ИИ-агентов, LLM и прочей офисной автоматизации. Поговорим сразу про тяжёлую артиллерию будущего: Physical AI. Говорят, что это ИИ для роботов. Отчасти это правда, но не вся.
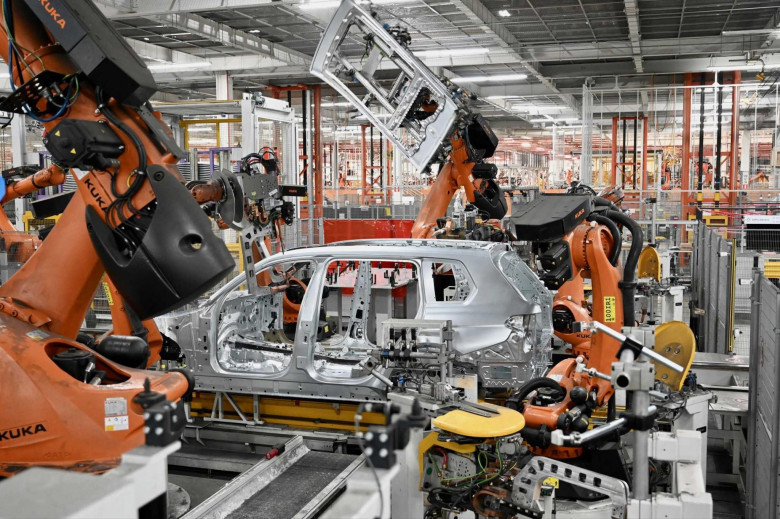
Итак, в новостях роботы крутят сальто, а на настоящих заводах — например, на том самом заводе BMW в Спартанбурге, где снимали ролики с гуманоидами Figure, — работают тысячи обычных промышленных роботов. Больше 2000 в одном только кузовном цехе. И некоторые из них программируют почти так же, как в 1985 году: человек с пультом подводит руку к нужной точке и жмёт «записать». Потом к следующей, и так всю программу, точка за точкой. Да, на больших автозаводах активно используют офлайн-программирование, но принцип воспроизведения заранее подготовленной траектории никуда не делся.
Получается удивительное соседство. С одной стороны, мы уже живём в мире, где робот адекватно ходит по заводу и даже может что-то перепрыгнуть. С другой — реальная роботизация строится на роборуках, которые всю смену ездят по записанным координатам и, по сути, являются специфичным станком с ЧПУ. Не всегда и не везде, но на огромном числе операций именно так.
Напрашиваются вопросы: заводы что, тормозят? Или они знают про физический мир что-то, чего не знают инвесторы, занесшие в гуманоидов десятки миллиардов долларов? А зачем тогда инвесторы хотят развивать именно гуманоидов?
Отвечать в лоб я не буду — пока. Дело в том, что говорить про Physical AI, не разобравшись в классической заводской робототехнике, бессмысленно: это будет взгляд снаружи. Нам же надо заглянуть изнутри, и тогда вы поймёте реальные проблемы и опасения наступающего будущего.
Поэтому план такой: сначала разберём «тупую железку» — как устроен обычный промышленный робот, почему его часто оставляют без органов чувств и отчего это осознанный выбор отрасли; потом выясним, почему роботу так трудно делать то, что умеет ребёнок, и откуда берутся данные для обучения; затем возьмёмся за Physical AI и VLA-модели. И только после этого вернёмся к главному вопросу — пустят ли всё это добро в настоящую промышленность. Или уже пустили?
Текста много, я предупредил. Поехали.
Слепой снайпер
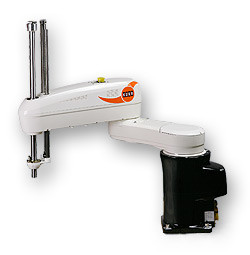
Стандартный промышленный манипулятор выглядит примерно как на картинке ниже: роборука, шесть суставов, у каждого свой двигатель и датчик положения. Почему именно шесть? Потому что для произвольной позы инструмента в пространстве нужны шесть координат: три на положение и три на ориентацию. Хотите держать сварочные клещи под любым углом — извольте обеспечить шесть степеней свободы. Бывают, правда, машины и на четыре оси — сборочные SCARA, дельта-пикеры, укладчики коробок. Просто там набор необходимых движений другой, и все шесть степеней свободы не всегда нужны.
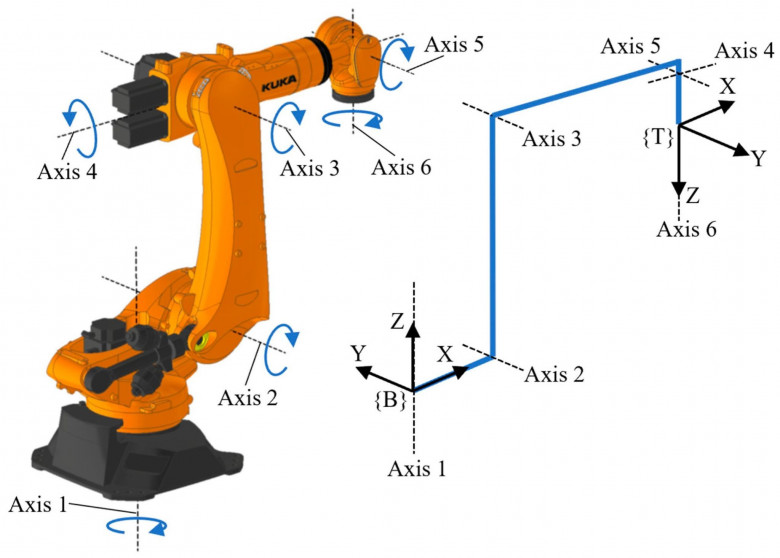
Чем этот робот занят? Он воспроизводит траектории. В его памяти лежит программа — список поз, скорости переходов, сигналы на захват. Доехал до точки 12 — сомкнул клешню, доехал до точки 13 — разжал. Если очень упрощённо, то промышленный робот — это станок с ЧПУ, у которого есть рука. И этому роботу абсолютно всё равно, что он делает. Он может перекладывать детали с конвейера на другой конвейер, приваривать что-то к чему-то или складывать упаковки с яйцами в большую коробку. Он просто повторяет заранее заданную операцию. И это совсем не робот из рассказов Азимова: перед нами двигатели, датчики, механика и контроллер, собранные в одну систему — автомат. И никаких моральных дилемм.
Теперь главный вопрос: откуда робот узнаёт, что именно он должен делать? Чаще всего его настраивают специальным пультом — teach pendant, или пультом обучения.
Пусть вас не смущает слово «обучение». Оно применено в самом доисторическом смысле: оператор джойстиком подводит манипулятор к нужному месту, смотрит, щурится, подводит ещё на миллиметр и записывает позу. Потом следующую. И так все операции. Дальше робот их просто повторяет.
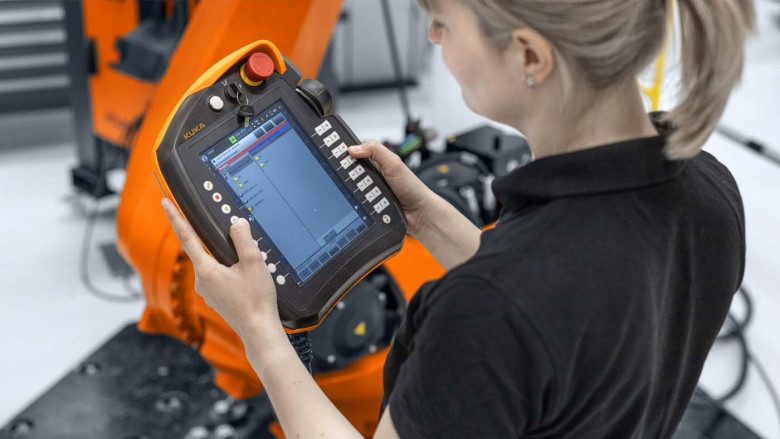
Точной мировой статистики, какую долю роботов до сих пор программируют с пульта, я не нашёл. Но для небольших ячеек и наладки на производстве teach pendant остаётся одним из самых привычных инструментов.
Записанные точки «склеиваются» логикой на фирменном языке производителя. У KUKA это KRL, у ABB — RAPID, у Yaskawa — INFORM. У FANUC для типовых движений используют программы TP (Teach Pendant), а для дополнительной логики и интеграции — KAREL; это не прямая замена TP в программировании перемещений.
Да, вы правильно поняли: у крупнейших производителей разные экосистемы программирования, плохо совместимые между собой. Есть и офлайн-среды вроде RobotStudio или RoboDK, где ячейку собирают в симуляторе и выгружают программу в контроллер. Большие автозаводы живут именно так: тысячи сварных точек никто не записывает джойстиком, их генерируют из CAD-модели. Но финальная подгонка часто всё равно происходит на месте, с тем же пультом в руках.
ОК, а где камеры? Во многих простых ячейках их просто нет. Типичный манипулятор, выполняющий повторяющуюся операцию в фиксированной оснастке, может прекрасно работать без зрения. Есть встроенные датчики положения в суставах, ему этого достаточно.
Сам по себе такой робот не видит деталь и не понимает, кто стоит рядом. Это не значит, что промышленная робототехника поголовно слепая, камера может всё-таки присутствовать в контуре управления или безопасности для коррекции действий робота. Но она нужна лишь как дополнительный источник данных. Слепой робот безо всяких ИИ прекрасно себе работает.
Как слепой может собирать автомобили? Очень просто: мир вокруг него выстроен с точностью до миллиметра. Деталь приезжает в строго определённое место, паллета встает на штифты, винты высыпают в строго определенной ориентации. Робот ходит по заученным точкам, и его работа осмысленна только потому, что рядом с ним расставлены нужные детали. Если убрать их, то он либо продолжит свои движения уже вхолостую, либо остановится по сигналу внешнего датчика. Всё, тут магии ноль. Но для фиксированной операции более чем достаточно.
Сколько такого добра на планете? Согласно свежему World Robotics 2026, работающий парк промышленных роботов на конец 2025 года дошёл до 5,079 миллиона. За год установили 603 тысячи новых роботов, из них около 354 тысяч — в Китае. Для сравнения: отчёт годом ранее показывал 4,66 миллиона работающих машин. По плотности роботизации Южная Корея остаётся одним из мировых лидеров: на каждые десять тысяч работников обрабатывающей промышленности там приходится более тысячи роботов. То есть примерно на десять заводчан — один железный коллега. Для России называют цифры в 25 тысяч, но наш ежегодный прирост +10%, а за 2026 может получиться и больше.
Значительная часть этого парка занята как раз такими повторяемыми операциями: подготовленная оснастка, заданная программа, предсказуемые движения. Но зрячие, силочувствительные и адаптивные ячейки тоже существуют.
Тут я хочу отметить, что словом «робот» мы интуитивно называем машины, частично похожие на людей. У конвейера тоже есть двигатели и контроллер; он тоже может разгоняться или тормозить по команде. Но конвейер не похож на человека, и мы не наделяем его антропоморфностью в своей картине мира. Хотя, по большему счёту, это такой же агрегат, как роборука.
Патент на «программируемое перемещение предметов» подал в декабре 1954 года Джордж Девол — тогда робототехника ещё жила главным образом на страницах научной фантастики. Первый робот-манипулятор Unimate появился на заводе General Motors в 1961-м, чтобы извлекать горячие отливки из машины литья под давлением.
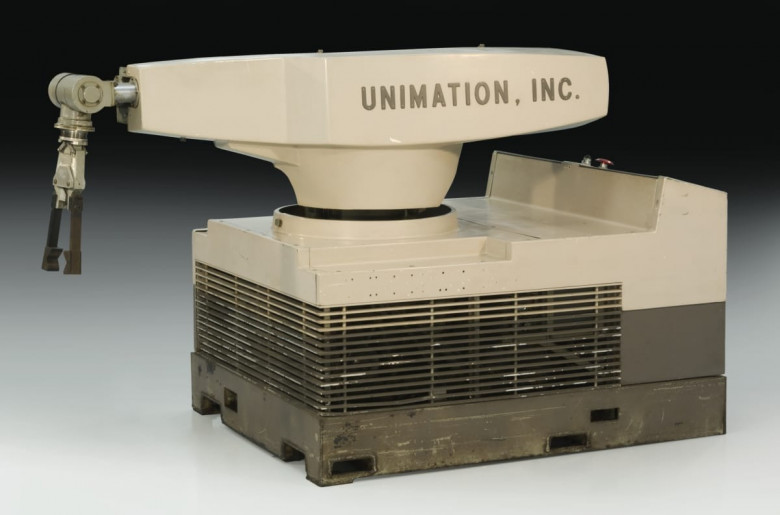
Джозеф Энгельбергер, продавший его GM, позже вспоминал, что себестоимость машины была около 65 тысяч долларов, а продали её примерно за 18. В убыток в 3,5 раза — зато с референсом от крупнейшего автопроизводителя планеты. Такой вот маркетинг образца 1961 года. И ведь сработало — через два десятилетия роботизированные линии уже стояли почти на всех автозаводах.
Опоздавший кадр
Хорошо, робот-манипулятор в ячейке слепой и заучивает позы. Давайте ему куда-нибудь внедрим ИИ, чтобы он поумнел? Везде ж внедряем! Круто выйдет: у всех RAG, а у нас умный манипулятор! Сразу на выставку везти можно!
Эммм… Есть ряд нюансов. Для начала давайте посмотрим, с какой скоростью вообще живёт мир манипуляторов (и заодно у нас будет ярчайшая картина по экономике этих штук).
Возьмём сварку кузова. На один автомобиль приходится от трёх до семи тысяч сварных точек, в зависимости от модели. В примере ABB на китайском заводе GAC восемнадцать роботов делают 72 прихваточные точки за 16 секунд, а вся станция укладывается в такт 46 секунд. Каждые 46 секунд — кузов. Логистика ещё быстрее: дельта-робот ABB FlexPicker делает цикл «взял — перенёс — положил» за 0,3—0,6 секунды, в зависимости от версии и груза. Это порядка 100—200 циклов в минуту, часами, без перерыва на подумать. Думать ему, впрочем, и нечем.
Теперь спустимся ниже, в контуры управления. Управление сервоприводом может работать с частотой в единицы и десятки килогерц. Полевая шина EtherCAT (я про неё рассказывал в этой статье), по которой контроллер раздаёт команды приводам, живёт циклами от десятков микросекунд, и задержка там не может быть больше определённого числа. Если внешняя система хочет корректировать траекторию KUKA на лету, то ей выдают такт в 4 или 12 миллисекунд, смотря какой режим выбран. Не успел ответить вовремя? Контроллер просто закрывает сеанс. Без обид — у него кузов каждые 46 секунд.
Напомню, что промышленная автоматика часто живёт в системе жёсткого реального времени (об этом тоже есть в предыдущей статье). Не «в среднем быстро», а «никогда не позже». Обычный Ethernet, при всех его гигабитах, не гарантирует, что кадр придёт вовремя: очереди, коллизии, ретрансляции. А линии хватит одного опоздавшего кадра в неудачный момент, чтобы пресс встретился с рукой робота. Поэтому заводские сети устроены слегка непривычно, зато задержки в них не просто малы — они предсказуемы и рассчитываемы. Вокруг таких задержек уже можно проектировать такт.
Простой тут стоит невероятных денег. По отчёту Siemens за 2024 год, час незапланированного простоя автомобильного производства доходит до 2,3 миллиона долларов. Это примерно 38 тысяч долларов в минуту.
Оговорюсь: сумма взята из отраслевых оценок, а Siemens продаёт софт для предиктивного обслуживания. Заинтересованная сторона, заинтересованная давить в большую сторону. Но масштаб потерь представить можно.
Отсюда же растёт культ надёжности. Интеграторы порой приводят впечатляющие оценки наработки промышленных роботов на отказ, вплоть до десятков тысяч часов. Только не надо воспринимать условные 80 000 часов как официальную характеристику любого FANUC. Это среднее по большому парку машин, а не гарантия для конкретной железки. Отдельный робот может сломаться и на второй год, но сам порядок требований поражает воображение. Попробуйте назвать бытовой механизм, который проживёт девять лет, непрерывно чем-то махая со скоростью два метра в секунду.
И последний этаж этой пирамиды — безопасность. Робот очень даже может причинить вред человеку, это ещё Азимов в своих книгах писал, правда, эту часть его посылов как-то не запомнили в массовой культуре. Но у Азимова роботы хотя бы как-то воспринимали внешний мир, а робот-манипулятор не воспринимает мир вообще никак, он только получает команды из контроллера. Если на пути сварки окажется человек — приварит его к кузову машины и не испытает ни капли жалости от этой жуткой картины. Поэтому рядом с роботом, способным убить человека одним движением, всегда живёт отдельный контур — лазерные сканеры, световые завесы, двери с замками и специальный safety-контроллер. Контур намеренно устроен консервативно: там максимально простая логика.
Итого промежуточно: классический промышленный робот не тупой, а предельно специализированный: повторяемость в доли миллиметра, циклы в миллисекундах, долгий ресурс, понятные правила безопасности. И даже если в ячейке есть зрение, то её проектируют ради одной главной задачи — предсказуемого результата. Неожиданное отклонение может разрушить весь техпроцесс. Деталь стала приходить со сдвигом на десять сантиметров? Зовите наладчика: наш железный гигант теперь всегда промахивается. Если же есть соответствующие датчики и алгоритмы коррекции, то справится и сам. Просто за эту адаптивность придётся заплатить.
И консервативная промка десятилетиями жила именно в такой парадигме. Во-первых, она прекрасно работает. Во-вторых, всё описанное выше хоть и не идеально, но обладает главным качеством: предсказуемостью. А с предсказуемостью и посчитать можно много всякого: от экономики проекта до срока следующего ППР. Все довольны. Были. До недавнего времени.
Как научить робота?
Physical AI — термин модный и пока ещё очень размытый: им сейчас называют любую штуковину с мотором и нейросетью. Маркетологи поработали на славу, а у меня флешбэки: нечто похожее было с термином IIoT.
Давайте договоримся, я буду использовать термин так: Physical AI — это когда обученные модели помогают машине воспринимать физическую среду, предсказывать последствия действий и адаптивно взаимодействовать с ней.
Идея, вообще-то, совсем не новая. Она отлично ложится в контекст моделей машинного обучения. Судите сами: мы подаём на вход LLM текстовый вопрос, модель обрабатывает его и на выходе выдаёт ответ. Тут всё понятно и никого не удивляет.
Ещё мы можем подать на вход текст, а получить картинку. Так работают, например, диффузионные модели (и не только они). Суть похожая: подали что-то на вход, получили результат.
Можем подать изображение и получить текст? Можем. Распознавание объектов, описание сцены, чтение надписей — всё это уже делают модели машинного обучения.
Можем подать видео, а получить текст? Можем.
А можем подать не просто видео, а картинку с камеры, а на выходе получить не просто текст, а координаты для сервоприводов?
Можем. Только у нас две проблемы.
Проблема номер один — время и обратная связь. В привычном чат-боте мы что-то подали — что-то получили. Потом повторили. Роботу же приходится постоянно смотреть, куда он едет, что схватил и не начал ли предмет выскальзывать из пальцев. Это решаемо. Модель может раз в десятки или сотни миллисекунд выдавать целевое движение или пачку будущих действий, а обычный контроллер — выполнять их плавно и с нужной частотой. Задержки, конечно, остаются проблемой, особенно если мир быстро меняется, но это проблема архитектуры, вычислений и реакции на ошибки, а не принципиальное ограничение.
Вторая беда посерьёзнее: чтобы модель чему-то научить, нужны данные. LLM и диффузионки невероятно выросли буквально за несколько лет. Это может казаться чудом, но у этого есть объяснение: появились алгоритмы и вычислительные ресурсы, способные освоить колоссальные массивы текстов и изображений. А текстов и изображений у нас полный Интернет, учись не хочу. Однако с движениями ситуация принципиально иная: где вообще взять такую выборку?
Ферма рук
Первые масштабные опыты такого рода Google проводила ещё в середине 2010-х, а к 2018 году представила QT-Opt. Логика была простая: если модели нужны данные, например о захвате, то пусть робот хватает предметы и учится на собственных попытках. Это называется «обучение с подкреплением», reinforcement learning: действие, сигнал об успехе или неудаче, улучшение политики. Поставили семь манипуляторов в ряд, насыпали в лотки всякого хлама и оставили хватать. Пресса прозвала установку arm farm — фермой рук. Звучит жутковато.
Ферма несколько месяцев собирала данные и накопила примерно 580 тысяч попыток захвата. Итоговая система QT-Opt брала незнакомые предметы с успешностью около 96% в условиях эксперимента, по сравнению с гораздо более скромным результатом при базовом подходе. Казалось бы, вот он, ответ.
Погодите. Давайте посчитаем, что именно получили за месяцы работы нескольких роботов. ОДИН относительно узкий навык: брать предметы из лотка сверху двухпальцевым захватом. Не вкручивать, не вставлять, не переворачивать. Месяцы сбора данных — один навык. А навыков в человеческой работе тысячи, и у каждого вариации. Умножьте сами: масштабирование такого подхода обходится дорого даже Google. Реальный робот — очень дорогой источник данных: он медленный, он ломается, а после многих попыток кто-то должен вернуть хлам обратно в лоток.
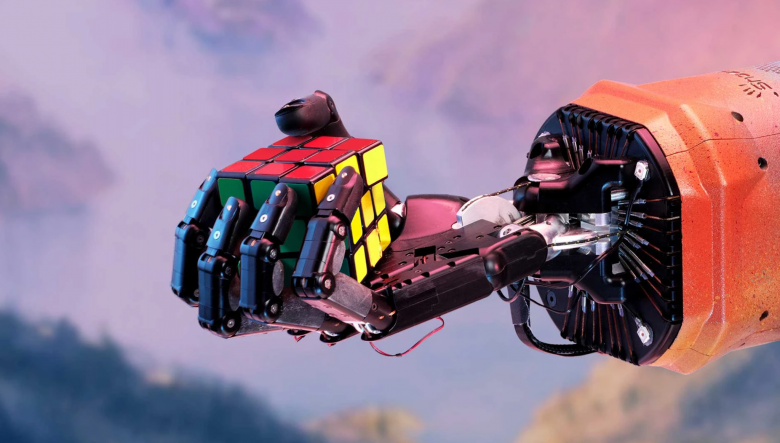
Флаг подхватила OpenAI. Если в реальности учиться дорого — давайте учиться в симуляции: там много попыток можно выполнить быстрее и дешевле. Их рука Dactyl собирала кубик Рубика одной кистью, а в симуляторе набрала эквивалент тысяч лет опыта по оценке исследователей. Чтобы навык пережил переезд в реальность, симуляцию нарочно портили случайностями: меняли трение, массы, освещение, задержки. Приём называется «доменной рандомизацией», и он до сих пор один из главных в отрасли. Модель, выжившая в тысяче кривых миров, может выжить и в нашем.
Результат? В простых ситуациях реальная рука справлялась в 60% случаев. В сложных, из 26 поворотов кубика, — в 20%. И это после 13 тысяч виртуальных лет обучения. Почему так? Потому что есть разрыв между симулятором и реальностью. Невозможно смоделировать реальный мир достаточно точно. Этот разрыв, кстати, так и называют: sim2real gap.
В конце 2020-го — начале 2021 года OpenAI свернула тогдашнюю робототехническую команду.
И ребёнок справится!
Ещё в 1988 году Ганс Моравек сформулировал наблюдение, которое потом назовут его именем: сравнительно легко заставить компьютер решать тесты на интеллект или играть в шашки на уровне взрослого, но трудно дать ему навыки годовалого ребёнка в том, что касается восприятия и подвижности. Шахматы, олимпиадная математика, а теперь даже сочинения — пожалуйста, а вот взять со стола чашку и не разлить чай — проблема.
Всё дело в том, что логике и математике наш мозг учится сравнительно недавно — по меркам эволюции со вчерашнего вечера, и учится, прямо скажем, с трудом. А сенсомоторику биологическая эволюция отлаживала сотни миллионов лет: кто не умел хватать и уворачиваться, тот просто не оставил потомства.
Скрытый текст
Вовочка: «Да, может, компьютер и смог обыграть меня в шахматы, но в спарринге он оказался просто слабак».
Мы носим в голове совершенный движок и даже не замечаем его работы. Поэтому грузчик и кажется нам профессией попроще гроссмейстера, хотя по меркам эволюции всё наоборот.
Для робота любая новая среда — источник проблем. Он тут ещё не был и не знает, как тут всё работает. Освоиться и делать здесь что-то осмысленное для него очень тяжёлая задача. Но и это ещё не всё.
Парадокс Моравека проявляется даже в движениях. Роботу иногда проще продемонстрировать эффектный, хорошо отработанный трюк, чем справиться с обычным домашним беспорядком. Условно разделим двигательные задачи на две большие группы:
Локомоция — передвижение в пространстве. Задача сложная, но на подготовленной поверхности её научились решать весьма впечатляюще: устойчивое двуногое шагание уже мало кого удивляет. Atlas от Boston Dynamics давно показывал сальто. Да-да, сальто, прыжки — это всё локомоция, то есть как двигаться в пространстве и не упасть. Это более-менее освоили.
А вот манипуляция, особенно ловкая работа кистью со множеством пальцев, остаётся адски трудной задачей. У человеческой кисти более двадцати степеней свободы — точное число зависит от модели подсчёта, — а ещё плотная сеть тактильных рецепторов и огромная площадь сенсомоторной коры. Воспроизвести это в железе дорого, а научить всем этим управлять — ещё дороже. Роботизированные кисти высокого класса могут иметь десятки подвижных сочленений, а приводы, сухожильные передачи и датчики создают и механические, и алгоритмические проблемы. Сложить простыню после сушилки — иной раз куда более коварная задача, чем выполнить заранее отрепетированное сальто.
Ведь что такое сальто для робота? Натренированное динамическое движение, обычно с датчиками, оценкой состояния и обратной связью. Нужны подходящая поверхность, место для прыжка и работающая стабилизация. Робот оценивает обстановку и, если пол ровный и высота потолка позволяет, включает навык. Готово сальто.
А что такое простыня? Это огромный кусок материи, который КАЖДЫЙ раз принимает новую форму, в разных местах идёт складками, натягивается, мнётся и проскальзывает между пальцами. Даже одна и та же простыня после каждого движения выглядит иначе. Для железяки, которая привыкла к определённой геометрии, это настоящий кошмар.
Попробуем переосмыслить всё, что мы только что проговорили. Роботы иначе живут свою робожизнь, не так, как люди. Им легко то, что для нас непосильно, но любой ребёнок пока уделает многие роботосистемы в сенсорике, манипуляции и ориентации в новом или изменившемся пространстве.
Именно поэтому история обучения роботов постоянно упирается в то, где взять для них опыт. И в то, что этот опыт нереально дорогой.
Сто тысяч лет форы
Насколько велика дыра в данных, в 2025 году в журнале Science Robotics попытался оценить Кен Голдберг из Беркли. Он предложил впечатляющее сравнение: масштабы текстовых и видеоданных, доступных большим моделям, соответствуют примерно 100 000 лет человеческого чтения и просмотра. А корпуса робототехнических действий по аналогичному способу подсчёта набирают несколько лет. Разрыв посчитайте сами.
Чтобы было совсем предметно: открытый датасет Open X-Embodiment объединил материалы десятков лабораторий, около миллиона траекторий от 22 типов роботов. Звучит солидно, но это именно траектории — короткие эпизоды, часто по десятку секунд. Компания Physical Intelligence собрала для своей модели около 10 000 часов демонстраций и называла это одним из крупнейших обучающих корпусов в робототехнике на момент публикации. 10 000 часов — это 1,14 года, если сложить всё время записанных действий в одну непрерывную ленту. На фоне интернет-масштаба просто копейки.
Дыру, конечно, пытаются засыпать деньгами и людьми. В Китае выросла целая индустрия сбора данных: человек со специальной оснасткой или в VR-очках весь день записывает движения — свои и роботов, — получая за это около 20 юаней в час, порядка трёх долларов. JD.com и вовсе объявила план собрать за два года 10 миллионов часов данных о действиях людей и роботов, мобилизовав 100 тысяч своих сотрудников и ещё полмиллиона внешних. Пока это только план, но очень китайский по размаху.
Многие известные научные датасеты движений открыты. И не потому, что роботов строят исключительно поклонники опенсорса. Просто данных настолько мало, что даже вклад подвальной лаборатории может помочь сообществу.
А ещё Open X-Embodiment произвёл важную мини-революцию. Когда десятки лабораторий сложили свои датасеты в общий котёл и обучили на нём модели RT-X, выяснилась удивительная вещь. Маленькая RT-1-X, обученная на смеси данных от роботов 22 типов, в опубликованных экспериментах превзошла узкие модели лабораторий в среднем примерно на 50% по выбранной метрике. Чужой опыт переносится, хотя роботы очень разные: кинематика, камеры, захваты. Для отрасли это был сигнал, что данные можно и нужно объединять.
В условиях такого «информационного голода» и эффективности общей работы как-то само родилось правило, что крысить датасет с движениями не по-робопацански. То есть это не запрещено, но не поощряется.
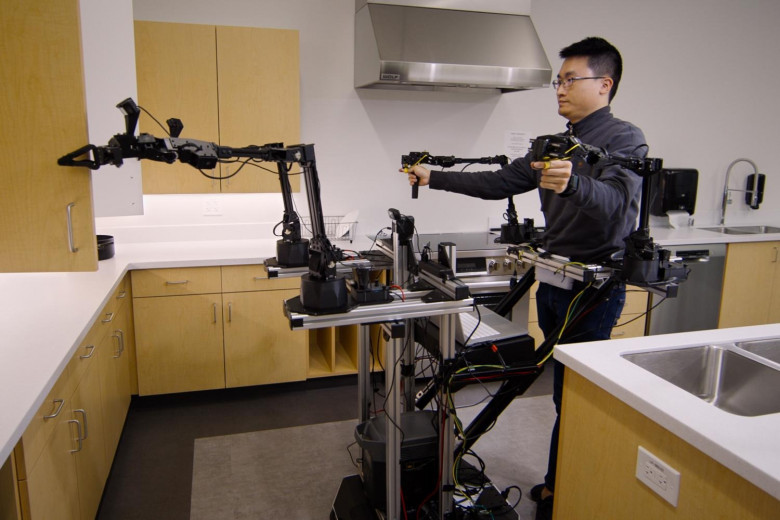
Откуда вообще берутся часы демонстраций? Во многом из телеопераций: человек управляет роботом, а тот синхронно пишет картинку с камер и собственные движения. Это долго было дорогим удовольствием: промышленный манипулятор с обвязкой мог тянуть на сотни тысяч долларов.
Серьёзный сдвиг случился в 2023-м, когда Стэнфорд показал ALOHA — установку из пары ведущих и пары ведомых манипуляторов дешевле 20 тысяч долларов (по меркам робототехники — даром!), частично напечатанную на 3D-принтере. И внезапно оказалось, что аспирант с ALOHA может за вечер показать роботу навык, на который с классическим обучением с подкреплением обычно уходили недели. Для отдельных задач хватало десятков демонстраций, а успешность могла достигать 80—90%. Дешёвое железо сделало для роботоданных примерно то же, что смартфон сделал для фотографии. Но всё равно этого не хватало.
И тут у роботов появился неожиданный союзник — большие языковые и мультимодальные модели. Идея звучит многообещающе: если данных о действиях мало, то давайте возьмём модель, которая уже видела огромную часть интернета, и доучим её действовать. Пусть знание о мире приедет из текстов и картинок, а моторика — из скромного роботодатасета. Из этой идеи и родились VLA — vision-language-action-модели, главные герои нынешнего хайпа.
Действие как слово
Первой ласточкой была RT-1 от Google, конец 2022 года. Сама модель по нынешним меркам просто смешная — всего 35 миллионов параметров, — но интересна она другим: данными и способом говорить с роботом. Данные собирали очень долго: 17 месяцев на 13 роботах, катавшихся по офисным кухням Google, — вышло 130 тысяч эпизодов и 700 с лишним задач. А действие закодировали так, как кодируют слова. Каждую из координат движения — куда сместить кисть, как повернуть, что сделать с захватом — порезали на 256 дискретных уровней. Получился словарь, где действие — короткое предложение из номеров бинов, и трансформер предсказывает его токен за токеном, как чат-бот предсказывает ответ.
Бин — это интервал, «корзина», как столбик в гистограмме. Берём диапазон координаты — скажем, смещение кисти от −10 до +10 см — и режем его на 256 равных кусочков с номерами от 0 до 255. Теперь вместо непрерывного «+3,7 см» модель говорит «бин 175», и это уже не число, а слово из конечного словаря. Почему именно 256? Потому что это один байт, и под каждый такой номер удобно завести отдельный токен. По сути, это обычное квантование, как в 8-битном АЦП: вводим конечный алфавит, с которым умеет работать трансформер.
Google даже проверила: может, зря мы дискретизируем, пусть сеть выдаёт плавные числа? В их экспериментальных условиях дискретный вариант оказался лучше. Но это не значит, что непрерывные действия в принципе хуже: дальше увидим, как к ним вернулась робототехника. Дело тут в том, как модель учится на демонстрациях. Представьте: в половине записей оператор брал чашку слева, в половине — справа, и оба варианта правильные. Если модель выдаёт одно непрерывное число и учится минимизировать среднюю ошибку, то лучший ответ для неё — среднее по всем демонстрациям. То есть траектория точно по центру, через чашку. Так не делал ни один оператор, но математика регрессии честно тянет именно туда. А модель с бинами учится предсказывать не число, а вероятности. У неё получается гистограмма с двумя горбами: половина вероятности на бинах «слева», половина — на бинах «справа», посередине пусто. При исполнении модель берёт один из горбов — налево или направо, — а вариант «сквозь чашку» просто не набирает вероятности.
Заработало? Да: в опубликованных тестах RT-1 показывала около 97% успеха в знакомых задачах и 76% в новых формулировках. На своей кухне и со своими предметами, но заработало. Управляла RT-1 роботом с частотой 3 герца, и для 2022 года это было прилично.
Дальше — ход конём. В 2023-м Google взяла готовую мультимодальную модель PaLI-X на 55 миллиардов параметров, которая умела отвечать на вопросы по картинкам, и дообучила её на роботоданных. Так получился один из вариантов RT-2, первой крупной VLA этого семейства. Действия в ней — буквально текстовые токены: модель выдаёт последовательность чисел, обозначающих дискретизированные компоненты действия робота.
Прогресс пошёл! RT-2 узнавала на столе игрушечного динозавра, понимала просьбы вроде «подай вымершее животное» и лучше переносила знания о предметах, для которых роботоданных было мало. Представление о динозаврах пришло из предварительного обучения мультимодальной модели.
Но в разделе ограничений есть кое что, чего восторженные маркетологи хотели бы не замечать: модель не приобрела из одного только Интернета принципиально новых моторных навыков. Она лучше понимает, какой предмет нужен и какое уже освоенное действие выбрать, но не становится автоматически умелым пианистом, сварщиком или футболистом. Если её не научили пинать, одного знания о динозаврах для хорошего пинка недостаточно.
И второе. Крупный вариант RT-2 на 55 миллиардов параметров не помещался на обычном бортовом вычислителе робота. Он выполнялся на внешних TPU, а робот запрашивал новые действия по сети. Частота получалась порядка 1—3 герц. Крошечная RT-1 давала около 3 герц. То есть большой модели требовалась внешняя вычислительная инфраструктура, а не автономный инференс на борту. Впрочем, железные ограничения решаемы.
Следующий ход сделали уже не корпорации, а Стэнфорд с Беркли в 2024-м: они выложили OpenVLA — модель на 7 миллиардов параметров, обученную примерно на 970 тысячах эпизодов из Open X-Embodiment. Код — под MIT, веса — на Hugging Face, но с лицензией нужно быть внимательным: предобученные модели наследуют ограничения базовой Llama 2, то есть «MIT на всё» здесь нет. Инференс — около 6 герц на одной RTX 4090, то есть буквально на игровом компьютере. По опубликованным замерам, OpenVLA обыгрывала 55-миллиардную RT-2-X на 16,5 процентного пункта по успешности в соответствующих тестах, хотя была почти в восемь раз меньше.
Рецепт перестал быть секретом корпораций: бери открытую VLM, бери большой роботодатасет, обучай на GPU — и у тебя своя VLA. Правда, авторы честно вписали в ограничения то, что на испытанных задачах надёжность нередко не дотягивала до 90%. А новый тип тела без адаптации поддерживается далеко не всегда: изволь дообучать.
Пятьдесят герц плавности
У токенов-действий, при всей красоте идеи, есть ограничение: модель часто предсказывает новое действие последовательно, как слова в предложении. Это может быть медленно, а отдельные точки ещё нужно превратить в согласованную траекторию. Само по себе квантование вовсе не обрекает руку на рывки — контроллер способен интерполировать движение. Но попробуйте сложить рубашку, каждый раз заново обдумывая следующий сантиметр пути. Ткань мнётся, висит, пружинит — тут нужны плавность, контекст и согласованность действий.
Помогли две подхода. Первый — action chunking, показанный в том числе в проекте ALOHA: модель предсказывает не одно действие, а пачку — десятки, а в некоторых конфигурациях и до сотни шагов вперёд, — и рука отрабатывает её одним согласованным куском.
Вторая часть «лекарства» — смена самого способа, которым модель выдаёт движение: она рисует не очередное число, а всю кривую движения сразу, целиком.
Именно это делает Diffusion Policy — метод из Колумбийского университета и MIT. Работает он по тому же принципу, по которому нейросети рисуют картинки. Если видели, как в генераторах изображений картинка за несколько шагов проявляется из цветного шума, — здесь то же самое, только проявляется не котик, а траектория руки. Модель начинает со случайных каракулей и шаг за шагом подправляет их, пока каракули не превратятся в плавную осмысленную кривую: подойти, опуститься, сомкнуть захват.
У такого способа есть важное свойство: на выходе всегда один цельный вариант. Помните проблему с чашкой, которую можно взять и слева, и справа? Каракули с первых же шагов уточнения сваливаются в одну из двух форм — либо слева, либо справа. Смешать половинки двух разных решений у диффузии не выйдет при всём желании: каждый шаг тянет кривую к чему-то, похожему на настоящие демонстрации, а «посередине, через чашку» на настоящие демонстрации не похоже.
Насколько это помогло? Авторы намерили в среднем +46,9% к прежним методам — правда, на собственном наборе из 15 задач, так что универсальной прибавкой для любого робота это считать нельзя. Но сдвиг был такой, что диффузию и её родственников быстро растащили по всем новым моделям.
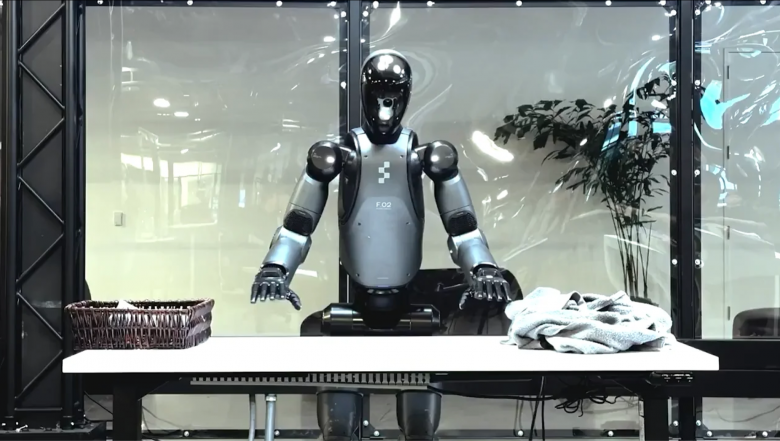
А в конце 2024-го стартап Physical Intelligence собрал всё вместе в модели π0 — одной из самых заметных VLA своего времени. Внутри — VLM на основе PaliGemma, к ней пристыкован отдельный «моторный» модуль, генерирующий непрерывные траектории методом flow matching. Если очень грубо, то это родственник диффузии, позволяющий эффективно генерировать действия. Высокоуровневая часть учитывает сцену и задание, моторная — предлагает пачку движений, которую контроллер может отрабатывать с частотой до 50 герц (это не значит, что огромная VLM работает с такой частотой). Обучено всё это на тысячах часов демонстраций.
Что умеет π0, показывали на видео все, кому не лень: она складывает рубашки и собирает посуду со стола, а у сопоставимых базовых методов в этих задачах получалось заметно хуже. Конечно, красивая запись ещё не раскрывает полную статистику сбоев.
Но мне, честно говоря, интереснее их следующая модель — π0.5 весны 2025 года. Её возили по домам, в которых робот никогда не был, и просили прибраться: задачи на 10—15 минут работы в незнакомой кухне. И ведь в опубликованных демонстрациях получалось. За ней вышли и новые поколения — например, π0.7 в апреле 2026-го. Так что π0 здесь — важная ступень истории, а не последняя модель на сегодня.
Эволюция
Теперь взгляните, во что эволюционировала архитектура VLA к 2025—2026 годам.
Figure, разорвав отношения с OpenAI, показала Helix для своего гуманоида. Внутри две системы, очень разные по темпераменту. В ранней версии медленная VLM примерно на семь миллиардов параметров понимала сцену и команду, а небольшая быстрая модель выдавала движения с гораздо большей частотой, в том числе для пальцев. Позже Figure показала Helix 02 и следующие обновления. Речь здесь не о рекорде одной версии, а о самом принципе разделения уровней управления.
NVIDIA в своём семействе GR00T тоже разделяет высокоуровневое рассуждение и быстрое управление движениями. Google в Gemini Robotics отдельно развивает модели, которые «думают», и модели, которые «делают». Конкретные частоты и число параметров меняются от версии к версии, но идея одна: не заставлять миллиардную модель напрямую изображать сервопривод.
Ничего не напоминает? Если читали книгу Канемана «Думай медленно… решай быстро», то точно помните про две системы мышления внутри нас с вами. Мы идём по пути эволюции, нога в ногу.
Молодой роботоспециалист — в цех!
Вспомним начало статьи: роботы делают сальто, а для производства всё равно массово используют руки, которые по смыслу недалеко ушли от станков с ЧПУ. Доколе? И, главное, почему?
Пока нет той самой гарантии надёжности и гарантии по тактам. В некоторых опубликованных тестах VLA показывают 90—95% успеха, иногда больше, иногда меньше. Но это результат на конкретном наборе задач и при конкретных условиях, а не паспортная надёжность класса моделей. Для производства важно, сколько часов система проработает без вмешательства, сколько деталей придётся переделывать и как дорого обходится ошибка. Даже если взять рекламные 95% за чистую монету, это означает пять неудачных попыток из сотни. Или 50 000 из миллиона.
И это ещё не всё, потому что операции складываются в цепочки. Возьмите сборку из десяти шагов, каждый с вероятностью успеха 0,95. Если исходы независимы, а повторных попыток нет, то на выходе получите 0,95 в десятой степени — около 60%. Значит, примерно два изделия из пяти потенциально улетят в брак. Ни один завод на такое не подпишется.
А ведь ещё важно восстановление после ошибки. Если робот неудачно схватил деталь, понял это и повторил попытку за секунду, то производство может спокойно пережить такой сбой. Если же уронил её и вызвал получасовую остановку, то ситуация совсем другая. Одна и та же успешность 95% в этих случаях означает совершенно разную экономику.
Вторая причина — безопасность. Помните независимый safety-контур? В стандартах функциональной безопасности IEC 61508, ISO 13849 и связанных практиках необходимо обосновывать требуемое снижение риска и поведение системы при отказах. С обучаемыми компонентами такое доказательство пока сложнее, чем с традиционной проверяемой логикой.
Это не значит, что «нейросети запрещены». Вопросы использования ИИ в safety-функциях уже рассматриваются в ISO/IEC TR 5469:2024. Но у сети на миллиард весов нельзя так же прозрачно перечислить все режимы отказа, как у привычного контроллера. Поэтому на реальных машинах обучаемое поведение обычно отделяют от независимых сертифицируемых защит: нейросеть выбирает действие, а safety-контроллеры должны обеспечивать безопасное состояние при опасной ситуации.
Да, в критический контур производства ИИ допускают осторожно. Но это не значит, что на заводах нейросетей нет вообще.
Глаза вперёд рук
Машинное обучение на заводах прекрасно работает. Просто пока оно, скорее, поддерживает штаны, нежели шьёт их.
Пример номер один — контроль качества. Отличать брак от годного начали давно, и уже к 2020 году такие системы широко использовали промышленно. В конце концов, тут процесс часто можно перепроверить. Машинное зрение вообще развилось впечатляюще сильно. Сюда же относится подсчёт выпущенной продукции — задача ещё проще. Яйца на птицефабриках давно считают именно так.
Пример номер два — подсказчики. В промышленном контуре всё равно есть диспетчер, который нет-нет да и вмешается в работу, оптимизирует какие-то параметры, полагаясь на свой опыт. И если решение проверяет человек, то мы можем анализировать данные и предлагать ему варианты, а он вправе согласиться или не согласиться.
Более того, я уже вижу первые аккуратные примеры, когда нейросети доверяют отдельные управляющие решения. Например, ЕвРАЗ недавно писал о внедрении ИИ-системы управления домной. Пока это очень изолированные участки, но всё же.
Пример номер три — аналитика задним числом. Составить полную картину того, как отработал цех за сутки и где можно подкрутить параметры, чтобы следующая смена прошла эффективнее, — это пожалуйста. Такую аналитику сейчас внедряют всё шире.
Пример номер четыре — логистика, и тут масштабы уже совсем другие. Amazon ещё 30 июня 2025 года отчиталась о миллионном роботе на складах и параллельно показала модель DeepFleet — диспетчер, который предсказывает и разруливает трафик всего этого муравейника. Компания заявляет о потенциале сокращения длительности перемещений примерно на 10%. Их же манипулятор Vulcan — один из первых у Amazon с осязанием — щупает содержимое ячеек. ABB в 2024-м купила швейцарскую Sevensense, чтобы её мобильные роботы ориентировались с помощью визуального SLAM, не полагаясь исключительно на фиксированные метки на полу; среди клиентов называли Ford и Michelin. Сварочный стартап Path Robotics сканирует деталь и автоматически планирует траекторию сварки.
И даже LLM нашлось место. Siemens с 2024 года развивает Industrial Copilot — LLM-ассистент, который помогает писать код для промышленных контроллеров. Концерн Thyssenkrupp развёртывал его в инженерных подразделениях.
А мы в прошлом году внедрили на заводе ЧКПЗ ИИ-помощник для сервисного инженера. Суть очень проста: робот-манипулятор — сложная железка с большим объёмом документации. Нашему помощнику можно задать вопрос голосом или текстом в свободной форме, и он не просто выудит ответ из документации, но и добавит рекомендации. Например, при вопросе об аварии он объяснит её причину по доступным материалам, приведёт методы устранения, перечислит необходимый инструмент, который надо взять с собой, и в конце даст чек-лист для проверки. Зашло так хорошо, что мы с этим примером даже стояли на AI Journey 2025.
Замечаете? Зрение, инспекция, выбор точки, маршрутизация, генерирование программы. ИИ зашёл на завод не через контур управления, а пока по стеночке, через периферию и анализ.
>>>>>>>>>Вы находитесь здесь<<<<<<<<<
И всё-таки самое интересное впереди: когда обученная модель не просто подскажет оператору, а начнёт самостоятельно выполнять всё более разнообразные физические задачи? Тут мы подходим к гуманоидам.
Робот идёт на работу
Возможно, во время чтения статьи вас преследовало странное ощущение: вроде рассказываем про роботизированные станки, а в новостях всё время мелькают полноценные гуманоиды. Давайте и эту тему затронем. Если для каждой операции можно придумать специализированную машину, то почему так много денег вкладывают именно в гуманоидов? Какой в них смысл?
Есть формальное объяснение, которое, на мой вкус, даже близко не тянет на те сотни миллиардов долларов, что сейчас в гуманоидов льются. Выглядит оно так. Наш мир создан для людей и под людей. Всё, начиная от лестницы и заканчивая кубиком лего, заточено под среднего человека весом 170 см с двумя руками и ногами. Если мы сделаем такого же робота, то он сможет бесшовно встроиться в наш мир.
На мой вкус, это объяснение хорошо подходит для развития гуманоидной технологии в принципе. Всякие робопомощники, рободворники, и пусть даже роболюбовники.
Но для промки такой подход не работает. Это как если бы мы решили, что все машины могут быть только легковыми, ибо дороги под них уже построены. Понятно, что под каждую задачу нужна своя спецтехника, а даже понятие «легковой» сильно разнится.
Да, специализированные решения не универсальны. Но ведь и цена универсальности очень высока. Куда дешевле сделать робот на колесах, если важна скорость перемещения по цеху. Да, такой робот никогда не поднимется по лестнице. А ему вообще надо? Он всю свою роботожизнь будет кататься по ровной поверхности, а несколько лестниц при переездах ему уж помогут преодолеть.
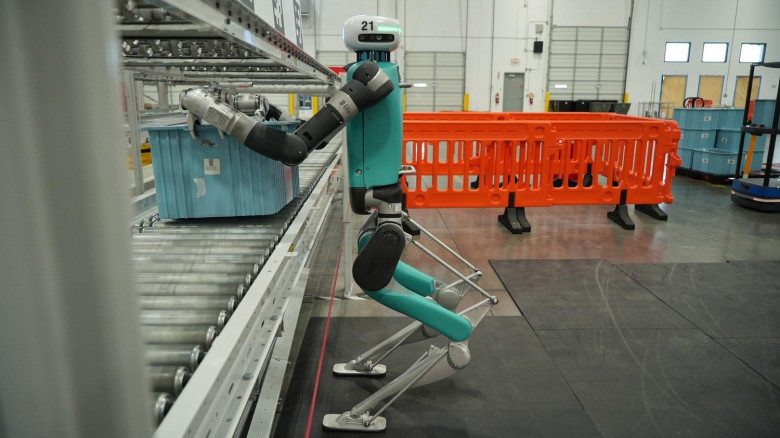
С точки зрения PhysAI нет принципиальной разницы чем управлять, главное, чтобы были «органы чувств» и прошло обучение и адаптация на этом агрегате. А одна у него нога или десять, это не суть важно. Тем не менее, сова не устаёт трещать на глобусе. Я о том, что гуманоидов заставляют заниматься всем подряд.
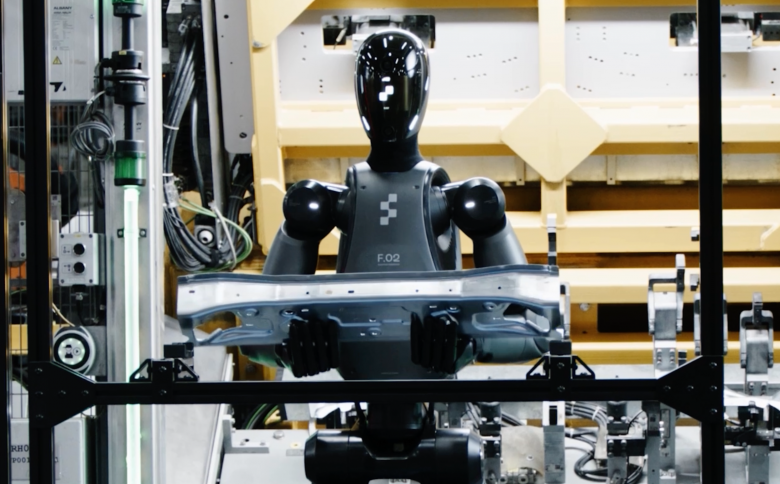
Давайте посмотрим на самый подробно задокументированный гуманоидный прототип на автозаводе — том самом BMW в Спартанбурге. Читаем внимательно, информация от самих Figure и BMW. Два робота Figure 02 — число называет отраслевая пресса, — почти год работы, смены по 10 часов, 1250 часов наработки. Уложили больше 90 000 листовых заготовок в сварочную оснастку, поучаствовав в создании 30 000 кузовов X3. Норматив — 84 секунды на цикл. Сваривал, разумеется, обычный шестиосевой робот.
Проанализируем. Укладка детали в оснастку раз в полторы минуты — это работа, с которой обычно справляется один классический манипулятор с подающим устройством, причём быстрее. BMW, надо отдать должное, никого не обманывала: прототип как прототип, тест прошёл успешно, сотрудничество продолжили. Но на следующем этапе гуманоида перевели на сортировку деталей в тележки. Подальше от такта линии и поближе к той нише, где ошибка и медлительность не так критичны.
Остальные истории из цехов похожи по смыслу, хотя подробностей меньше. У Mercedes гуманоид Apollo переносит комплектующие — пока в рамках прототипа. У GXO роботы Digit перекладывают контейнеры с тележек на конвейер: с июня 2024-го компании сообщали о более чем ста тысячах перенесённых контейнеров. Agility и GXO называют это одним из первых коммерческих развёртываний гуманоидов. Заметьте, снова складская логистика, а не сборка сложного узла.
Tesla, по отраслевым сообщениям, ставила амбициозные планы по производству Optimus в 2025 году, но публично проверенной итоговой статистики выпуска мне найти не удалось: оценки прототипов и поставленных машин смешивать не будем. У китайской UBTech в отчётности за 2025 год фигурируют 1079 поставленных полноразмерных гуманоидов; у Unitree заявлялись ещё большие объёмы поставок. Но даже несколько тысяч гуманоидов — совсем небольшой объём по сравнению с обычной промышленной робототехникой: по отчёту IFR, в 2025 году в мире установили 603 тысячи промышленных роботов.
Подливают масла в огонь разные шоу, которые имеют мало общего с самостоятельной работой. На презентации Tesla в октябре 2024-го роботы Optimus смешивали коктейли и болтали с гостями. Позже выяснилось, что в части демонстраций участвовали удалённые операторы.
Домашний гуманоид 1X NEO за 20 тысяч долларов, одна из главных сенсаций осени 2025-го, допускает телеоперацию: сотрудник компании при предусмотренном режиме помощи может видеть обстановку глазами робота. Компания не скрывает замысел: подключение оператора помогает решать сложные ситуации и собирать недостающие данные. Это не означает, что каждым NEO непрерывно управляет человек. Но к слову «автономный» стоит относиться внимательно. Кроме того, мне было бы жутковато, если бы на мою кухню при определённых условиях мог заглянуть инженер в VR-шлеме. Ничего особенного в моём мусорном ведре не хранится, и всё равно неприятно.
Прибавьте сюда батарейки. У Unitree G1 заявленная автономность — около двух часов; у Digit и Figure 03 — свои режимы работы и зарядки. Смена на заводе, напомню, 8—12 часов, а реальная автономность зависит от задачи, нагрузки и простоев.
И ещё: современные роботы уже умеют «щупать» мир тактильными датчиками. Например, в новых системах Figure используются сенсоры контакта в кистях. Так что проблема не в абсолютном отсутствии осязания, а в том, насколько далеко оно пока от универсальности человеческой руки. В общем, гуманоид в 2026 году — машина с дорогой механикой, непростой энергетикой и серьёзными требованиями к обучению.
При этом деньги туда идут такие, каких традиционные манипуляторы не видели за десятилетия. Figure объявляла оценку в 39 миллиардов долларов; вокруг Physical Intelligence и Skild AI тоже идут многомиллиардные раунды. Отдельные отраслевые прогнозы рисуют рынки на десятки миллиардов к 2030-м и триллионы к середине века. Нам бы такие бюджеты на наши жалкие, но полезные заводики.
Вместо заключения. Так тормозят или знают?
Если вы это читаете, то большое вам спасибо. Вы осилили статью про Physical AI и, надеюсь, почерпнули из неё много интересного. Или не почерпнули, что тоже случается. Надеюсь, мне удалось немного развеять облако маркетинга, которое скопилось вокруг робототехники последних лет.
Так тормозят заводы или знают что-то, чего не знают инвесторы? Думаю, второе. Заводы прекрасно знают цену предсказуемости. Им мало показать, что робот один раз справился с заданием. Надо, чтобы он повторял его сотни тысяч раз, замечал собственные ошибки, безопасно останавливался и быстро возвращался в работу. И чтобы весь этот праздник стоил дешевле привычных рук-манипуляторов с их координатами.
Если ассортимент меняется раз в пять лет, то такая «тупая» автоматизация может оказаться идеальной. А если детали каждый день новые и перестраивать оснастку дороже, чем сам робот, то вот там Physical AI получает шанс. Пока только шанс.
И ещё одна мысль, которая мне нравится. Сейчас многие боятся, что роботы отберут у людей работу. Но проекты автоматизации в первую очередь начинают с мест, где тяжело найти сотрудников: склады, сортировка, фасовка, однообразные и физически тяжёлые операции. Там роботы могут закрывать вакансии и снижать текучку. Они не выкидывают конкретных людей, ибо люди на таких местах сами не задерживаются.
Вот именно эти места и пытаются заткнуть роботом в первую очередь. Робот не будет уставать, ныть, болеть и ходить в туалет. Мал по малу и отобьётся. Ничьё место конкретно он не займёт, а стабильность и эффективность производства повысит.
Мне нравится эта теория, и я искренне верю, что именно так и будет, во всяком случае на первых порах. Что дальше? Увидим.
>>>>>>>>>Вы находитесь здесь<<<<<<<<<