

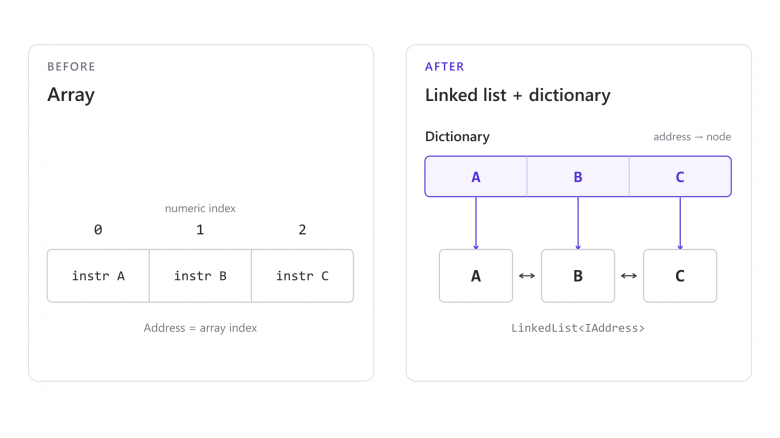
В какой-то момент HydraScript перестал справляться со своей основной задачей — выполнять программы. Статический анализ падал на корректном коде, и его пришлось отключить. Кодогенерация назначала инструкциям неверные адреса: виртуальная машина зацикливалась или падала с исключением.
Логика анализа и генерации кода была размазана по иерархии узлов AST. Добавлять возможности языка становилось всё сложнее, а разобраться в очередном баге было отдельной задачей. Пришлось остановиться и подумать, как вообще дальше развивать проект. Я решил отделить операции от дерева и выбрал для этого Visitor.
Введение
Фрагментом инструкций я дальше называю результат кодогенерации для одного поддерева AST, например для выражения a + b. Родительский узел объединяет фрагменты дочерних узлов и добавляет свои инструкции. Так постепенно собирается программа целиком.
Уже при переносе кодогенерации в визиторы я упёрся в старую адресацию. Методы принимали int start: чтобы сгенерировать фрагмент, нужно было заранее знать, где он окажется в готовой программе. Та самая арифметика смещений, которая уже давала неверные адреса, теперь мешала собрать кодогенерацию из отдельных операций над узлами.
Мне нужно было вернуть интерпретатору возможность выполнять программы и получить код, в котором я смогу искать ошибки и добавлять новые возможности. В процессе пришлось переделать систему адресации инструкций. О ней и пойдёт речь.
Индекс перестал работать
В статье об архитектуре HydraScript я уже показывал старую сигнатуру кодогенерации:
public override List<Instruction> ToInstructions(
    int start,
    string temp)
Внутри постоянно встречались вычисления со start, количеством уже сгенерированных инструкций и номером последней из них. К этой арифметике были привязаны даже имена временных переменных. Хотелось описывать вычисление выражения, а значительная часть метода занималась размещением инструкций.
Кодогенерацией проблема не ограничивалась. Номер инструкции одновременно служил её позицией в массиве. Допустим, есть такая последовательность:
0: a = 1 + 1
1: c = 0
2: b = a + 5
3: s = b as string
4: Print s
5: End
Уберём неиспользуемое присваивание в c. Инструкция с номером 4 — всё ещё Print s, а вот элемент массива с индексом 4 — уже End. Переход по старому номеру приведёт не туда. Номер 5 вообще окажется за пределами массива.
Можно перенумеровывать инструкции и исправлять ссылки после каждого изменения. Но тогда за одной и той же договорённостью придётся следить в каждом преобразовании. Кодогенератор посчитал номера, оптимизатор пересчитал, виртуальная машина надеется, что никто не ошибся.
Поэтому в ходе рефакторинга я сформулировал требование: при смене позиции инструкция должна сохранять свой адрес. Назначать его должна коллекция инструкций, чтобы узлам AST и кодогенератору больше не приходилось рассчитывать размещение всей программы.
IAddress вместо числового индекса
Сначала я отделил сам адрес от способа хранения инструкций. Адресом стал объект IAddress, по которому можно найти инструкцию независимо от её позиции в коллекции:
public interface IAddress : IEquatable<IAddress>
{
    public IAddress? Next { get; set; }

    public string Name { get; }
}
Для обычных инструкций коллекция автоматически создаёт HashAddress. При сравнении таких адресов учитываются хешкод инструкции, переданный как seed, и собственный Guid адреса. Поэтому совпадение хешкодов само по себе не делает два адреса равными. Имя генерируется автоматически с префиксом _t и используется в том числе для временных переменных.
Для целей переходов есть Label, именованная метка. Два объекта Label с одинаковым именем обозначают один адрес. Это удобно при генерации цикла: можно заранее создать метку его конца, сослаться на неё в условном переходе, а инструкцию с этой меткой добавить после генерации тела. Вычислять, под каким номером она окажется, больше не нужно.
AddressedInstructions = LinkedList + Dictionary
Из этого требования получилась AddressedInstructions. Внутри — знакомые коллекции:
private readonly LinkedList<IAddress> _addresses = new();
private readonly Dictionary<IAddress, LinkedListNode<IAddress>>
    _addressToNode = new();
private readonly Dictionary<LinkedListNode<IAddress>, IExecutableInstruction>
    _instructions = new();
Связный список позволяет менять порядок, не сдвигая все последующие элементы. Словари нужны, чтобы найти инструкцию или её узел, не обходя список с начала. Адрес закреплён за местом инструкции в программе и больше не означает «пятый элемент».
Есть одна деталь сверх привычной комбинации списка со словарём: у IAddress есть изменяемая ссылка Next. Её возвращает обычная инструкция после выполнения.
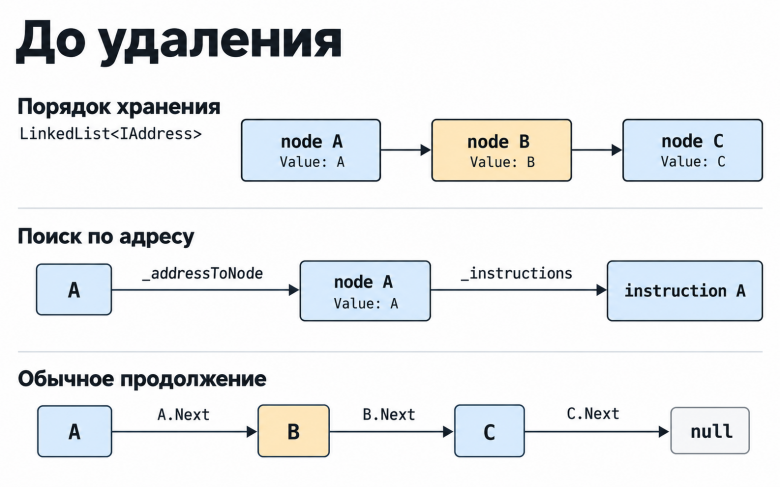
Удаляем B, переподключаем A.Next к C. Оставшимся инструкциям новые адреса не нужны. Коллекция поддерживает и порядок списка, и эти ссылки.
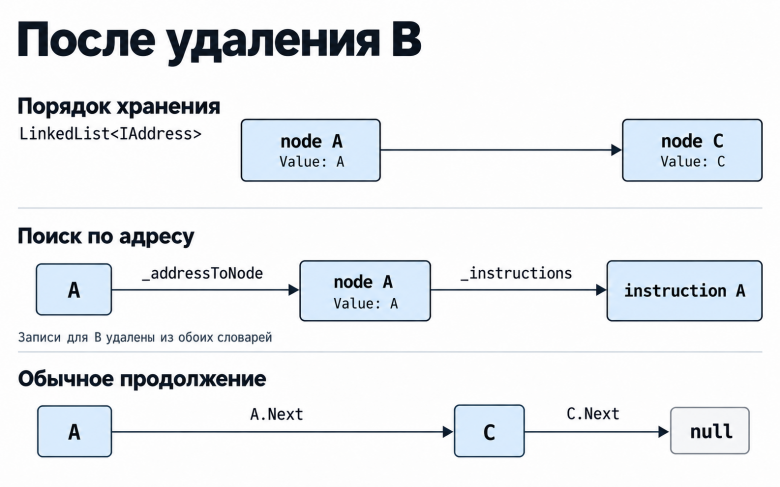
А цикл исполнения виртуальной машины теперь выглядит так:
var address = instructions.Start;
while (address is not null)
{
    var instruction = instructions[address];
    var jump = instruction.Execute(ExecuteParams);
    address = jump;
}
Обычная инструкция возвращает Address.Next, а Goto — целевую метку. Механизм один. Виртуальной машине не приходится отдельно обрабатывать «увеличить индекс» и «перейти куда-то ещё».
Сначала сгенерировать, потом присвоить адрес
Теперь визитор может сгенерировать инструкции для своего поддерева, не зная, сколько инструкций будет перед ними. Он возвращает AddressedInstructions с получившимся фрагментом. Вызывающая сторона добавит результат через эту перегрузку:
public void AddRange(AddressedInstructions instructions)
{
    for (var address = instructions.Start;
         address != null;
         address = address.Next)
    {
        AddWithAddress(instructions[address], address);
    }
}
Адреса исходного фрагмента сохраняются. Если внутри есть условный переход на другую его инструкцию, после объединения он по-прежнему попадёт куда надо. Прибавлять смещение назначения не требуется.
Так при разборе сломанной кодогенерации я пришёл к более простому устройству. Метод посещения работает со своим узлом AST и результатами дочерних узлов. Общий счётчик всей программы ему не нужен. В дебаге можно пройти по цепочке рекурсивных вызовов и посмотреть, откуда пришёл результат, вместо попыток восстановить происхождение очередного смещения.
При добавлении фрагмента всё ещё нужно пройти по его инструкциям. Зато вокруг этого обхода больше не требуется писать код пересчёта адресов.
Поменять инструкцию, оставить адрес
Независимые адреса оказались удобны и в случае, когда одну инструкцию нужно превратить в другую.
Например, при генерации присваивания переиспользуется код обхода цепочки доступа. Для чтения значения и записи в него нужно пройти один и тот же путь по объекту или массиву. Различается последнее действие. Поэтому после генерации цепочки я могу заменить последнее чтение записью:
var lastRead = result.OfType<IReadFromComplexData>().Last();
result.Replace(
    lastRead.ToInstruction(),
    lastRead.ToAssignment(last));
Если удалить старую инструкцию и добавить новую, потеряется адрес, на который могли ссылаться другие инструкции. Replace передаёт новой инструкции старый адрес и оставляет узел коллекции на месте. По прежнему адресу теперь найдётся замена.
У удаления есть отдельное ограничение: переподключение Next у предшественника не исправит Goto, который откуда-то ещё ссылается на удалённый адрес. Преобразование должно сохранить цель через Replace, перенаправить входящие переходы или оставить её в покое. Независимые адреса избавляют от перенумерации, но решать, куда должен вести переход, всё ещё должен код преобразования.
Проверить удаление и замену можно небольшим C#-примером в проекте со ссылкой на HydraScript.Domain.BackEnd:
using System;
using HydraScript.Domain.BackEnd;
using HydraScript.Domain.BackEnd.Impl.Instructions.WithAssignment;
using HydraScript.Domain.BackEnd.Impl.Values;

var first = new Simple(new Constant(1));
var middle = new Simple(new Constant(2));
var last = new Simple(new Constant(3));

AddressedInstructions instructions = [first, middle, last];
var savedAddress = last.Address;

instructions.Remove(middle);
Console.WriteLine(ReferenceEquals(first.Address.Next, savedAddress));

var replacement = new Simple(new Constant(30));
instructions.Replace(last, replacement);
Console.WriteLine(ReferenceEquals(replacement.Address, savedAddress));
Console.WriteLine(ReferenceEquals(instructions[savedAddress], replacement));
Результат:
True
True
True
В конце концов
Исходный параметр int start исчез. Визитор возвращает фрагмент с уже корректными внутренними ссылками, а родительский узел включает его в свою последовательность. Из кодогенератора ушли расчёты смещений, в которых раньше возникали ошибки. Задача начиналась с восстановления сломанного интерпретатора, а в процессе получилось разделить обход AST и хранение инструкций так, чтобы с ними можно было дальше работать.
Ещё я веду Telegram канал StepOne, куда выкладываю много интересного контента о программировании на C#, даю карьерные советы, рассказываю истории из личного опыта и раскрываю все тайны IT‑индустрии!