Привет, Хабр! Меня зовут Виталий, я шесть лет занимаюсь iOS-разработкой, из них два года работаю в платформенной команде hh.ru.
Сегодня я хочу рассказать о пути каждого нашего коммита: от подготовки окружения и генерации проекта на машине разработчика до момента, когда изменения становятся доступны пользователям приложения. Разберём, как пайплайн определяет затронутые сервисы, переиспользует собранный проект в разных тестах, проводит статический анализ и возвращает результаты в PR. Отдельно остановимся на UI-тестах, проследим, как происходит проверка сборок и проекты доходят до релиза. В конце расскажу, какие метрики помогают оценивать скорость поставки и когда можно сокращать повторы тестов.
С чем мы работаем
Для начала введу вас в контекст: всего у нас в работе два приложения (для соискателей и работодателей), Пять региональных версий (отличаются дизайном и текстами), 160 фича-модулей. В команде 30 iOS-разработчиков. Релизы выходят раз в неделю, а за сутки на CI проходит до 55 прогонов. При такой нагрузке скорость и стабильность инфраструктуры влияют на работу всей команды.
Локальное начало
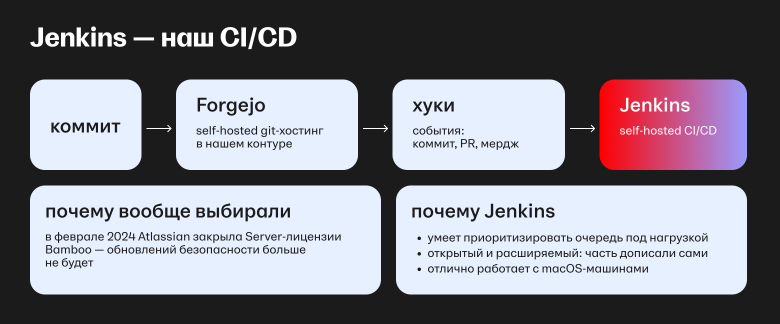
Всё начинается с момента, когда мы настраиваем окружение для коммитов разработчика. Для этого используются два скрипта.
bootstrap.sh полностью настраивает окружение с нуля, в том числе готовит кэш для ускорения последующих запусков и генерирует проект
up.sh используется в повседневной работе для генерации проекта
В процессе генерируются локализации и аналитика (Кстати, о том, как мы генерируем код для отправки событий и синхронизируем аналитику на iOS и Android, коллега Андрей Максимкин подробно рассказал в отдельной статье) — события аналитики мы не пишем вручную. У нас многомодульная архитектура. Для управления модулями и генерации проекта из манифестов мы используем Tuist.
После этого разработчик занимается задачей: например, меняет цвет кнопки, добавляет текст и аналитику. Затем делает коммит и отправляет его в репозиторий.
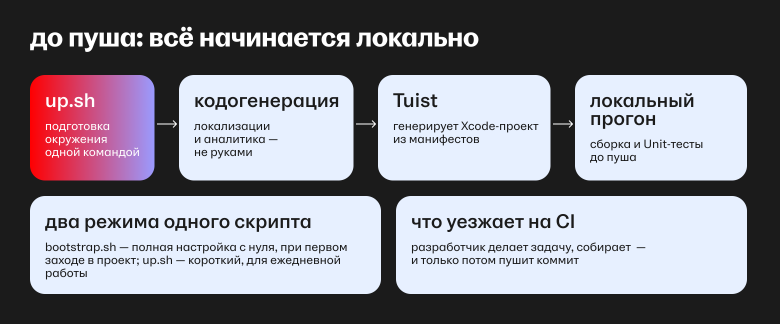
Коммит попадает в Forgejo. Это Git-хостинг, похожий по возможностям на GitLab и GitHub: в нём есть pull request, хуки и разграничение прав. Но его можно развернуть на собственном оборудовании, поэтому работа репозитория не зависит от внешнего сервиса и его политик.
Дальше разработчик может вручную запустить свою ветку на CI/CD или создать pull request. Во втором случае хук автоматически запускает пайплайн в Jenkins.
Раньше для CI/CD мы использовали Bamboo от Atlassian. В 2024 году мы остались без поддержки и критических обновлений используемой версии, поэтому стали выбирать замену между Jenkins, GitLab CI и Forgejo Actions. Остановились на Jenkins по нескольким причинам:
отлично подходит для наших задач в разработке
хорошо работает с macOS-машинами
его можно интегрировать в нашу инфраструктуру
он открыт и расширяем — недостающие возможности можно реализовать в собственных плагинах
он позволяет управлять очередью под нагрузкой, принцип «первым зашёл — первым вышел»
Какие планы запускаются в CI/CD
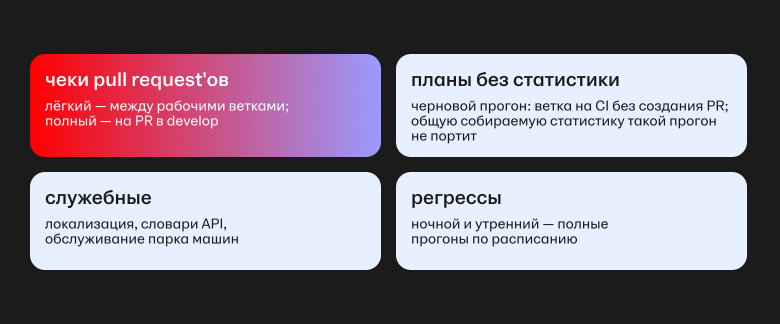
В CI/CD у нас используется четыре вида планов.
Служебные. Например, генерация и обновление словарей и предзашитых API, сбор событий аналитики, синхронизация локализаций и обслуживание парка машин.
Регрессионные. Ночные и утренние регрессы запускаются по расписанию через cron. Кроме того, по будням в час ночи во все открытые PR в develop автоматически вливается свежий develop, и проверки запускаются заново: к утру видно, не конфликтует ли ветка с чужими изменениями.
Планы без статистики. Для обычных прогонов мы собираем данные о длительности, стабильности тестов и количестве повторных запусков. После каждого батча результаты по каждому тесту — длительность, статус, число ретраев, стенд и владелец теста — уходят в сервис статистики. На этих данных строятся метрики, о которых я расскажу в конце. Если разработчик работает с веткой, где ожидаются падения, но не хочет влиять на общую статистику, он может запустить план без её сбора. Это своего рода черновой прогон.
Чеки pull request’ов. Они разделены на лёгкие, между рабочими ветками, и полные — на PR в develop. На его примере давайте посмотрим, что происходит.
Что происходит с PR в develop
Наш полный план состоит из шести стадий, у третьей и четвёртой есть параллельные подстадии. Разберём части этого процесса по порядку.
0. Отмена запущенных билдов
Перед началом мы останавливаем предыдущие запущенные сборки. Если разработчик отправил следующий коммит, собирать предыдущую версию кода уже не нужно: она устарела, но продолжает занимать мощности CI.
1. Детектор
Сам процесс начинается с запуска утилиты, которая анализирует diff в pull request и определяет, какие приложения (у нас их, напомню, два — для соискателей и для работодателей) затронуты изменениями. Если разработчик менял только приложение для соискателей, приложение для работодателей не запускается. То же правило действует в обратную сторону. Если изменения затрагивают core-компоненты или общие модули, собираются и проверяются оба приложения. Если изменена, скажем, только документация, сборка проекта вообще не запускается. Это экономит ресурсы CI: агенты не выполняют ненужные сборки, а разработчику не приходится ждать их завершения.
2. Unit-тесты и стат-анализ
Далее запускаются Unit-тесты и статический анализ. Сначала собирается проект, который затем переиспользуется и в Unit-, и в UI-тестах. Благодаря этому его не нужно пересобирать для каждого подшага.
Статический анализ включает линтеры и проверку неиспользуемого кода, который, например, мог остаться после удаления функциональности. Линтером у нас работает SwiftLint, а неиспользуемый код ищет Periphery. Предупреждения этих инструментов, как и предупреждения компилятора, не дают влить PR: в develop попадает только код без варнингов.
Все эти шаги, как и почти всю остальную автоматизацию, мы описываем на Fastlane. Это open source инструмент для автоматизации сборки и публикации мобильных приложений: шаги оформляются в lanes — небольшие сценарии на Ruby. Jenkins решает, где и когда запустить шаг, а Fastlane — что именно сделать. Поэтому большинство шагов можно повторить на своей машине той же командой, что и на CI.
Переиспользование сборки как раз удобно показать на примере. Проект собирается один раз в режиме build_for_testing, а тесты затем запускаются с флагом test_without_building. Упрощённо это выглядит так:
# Собираем проект один раз — сразу для Unit- и UI-тестов
private_lane :build_test_products do |options|
  scan(
    scheme: options[:scheme],
    testplan: "#{options[:scheme]}-Tests",
    derived_data_path: Path::Output::DERIVED_DATA,
    build_for_testing: true
  )
end

# Запускаем Unit-тесты на уже собранном проекте
private_lane :run_unit_tests do |options|
  scan(
    scheme: options[:scheme],
    testplan: "#{options[:scheme]}-Unit-Tests",
    derived_data_path: Path::Output::DERIVED_DATA,
    test_without_building: true
  )
end
После Unit-тестов собранные продукты вместе с файлом .xctestrun упаковываются в архив и передаются на агенты с UI-тестами. Там архив распаковывается, и тесты запускаются тем же способом — без пересборки.
3. Предрелизная сборка
Создаётся предрелизная сборка (её внутреннее название — AdHoc), которая загружается в TestFlight. Её затем заберёт для ручной проверки QA: запустит приложение, пройдёт нужные сценарии и проверит задачу.
4. UI-тесты
Самая длинная и тяжёлая стадия. Чтобы не гонять все тесты последовательно, мы их делим на части — так называемые батчи, и каждый проводится параллельно на отдельном агенте. Агент — это физически Mac Mini, подключенный к CI/CD. Он получает свою часть тестов и выполняет её.
Разделение на батчи — поиск баланса. Если запустить все тесты на одном агенте, прогон займёт слишком много времени. Если раздробить их слишком мелко, один PR займёт много агентов, и остальным прогонам придётся ждать в очереди. Сейчас на PR в develop приложение для соискателей hh.ru делится на четыре батча, для работодателей на два, а региональные версии проходят тесты одним батчем.
Сам алгоритм деления простой. Из собранного проекта мы получаем список всех тестов (xcodebuild -enumerate-tests), убираем из него нестабильные тесты, временно отправленные на карантин, и делим оставшиеся поровну по количеству: каждый батч берёт свой отрезок списка, последний — ещё и остаток.
Внутри батча тесты тоже идут параллельно — на нескольких копиях симулятора. Их количество агент рассчитывает сам по числу ядер и объёму памяти: на машине с 16 ГБ запускается три симулятора, с 24 ГБ — четыре, с 36 ГБ — пять.
Почему увеличение количества батчей не всегда ускоряет прогон, расскажу в разделе «Инсайты».
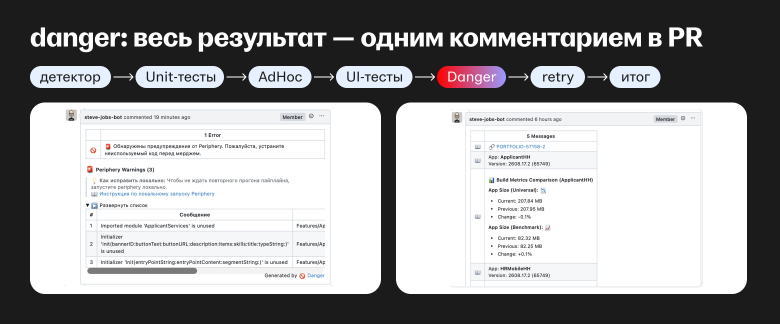
5. Danger
После сборки, статического анализа, Unit- и UI-тестов запускается Danger — open source инструмент для автоматизации рутины в pull request’ах. Из коробки он не работает с Forgejo, поэтому мы используем собственный форк. Он собирает информацию о прогоне и публикует её в pull request. Там можно увидеть предупреждения о неиспользуемом коде и информацию об изменении размеров сборок.
6. Retry
Если сборка упала, то не нужно будет проходить по всем стадиям. Достаточно воспользоваться нашим плагином, нажав буквально одну кнопку. Плагин повторно запускает только упавшие шаги. На стадии UI-тестов перезапускаются только упавшие тесты: раньше приходилось заново прогонять весь батч, даже если в нём упал один тест.
На выходе на CI/CD мы получаем pull request, который прошёл проверки со стороны CI по flow end-to-end UI-тестов, отчёты на состояние мёртвого кода и статистический анализ в одном месте.
Дальше инициатива переходит к QA. Право мерджа в develop ограничено настройками репозитория: влить на изменения может только QA. Так мы защищаем develop от кода, который не прошёл его проверку. QA проверяет, что все чеки зелёные, ошибок или замечаний со стороны Danger и остальных утилит нет. Он берёт сборку из TestFlight и как только убеждается, что всё ок, то мержит наш PR.
Готово: коммит теперь уже висит в develop и ожидает релизного среза.
Как коммит попадает в релиз
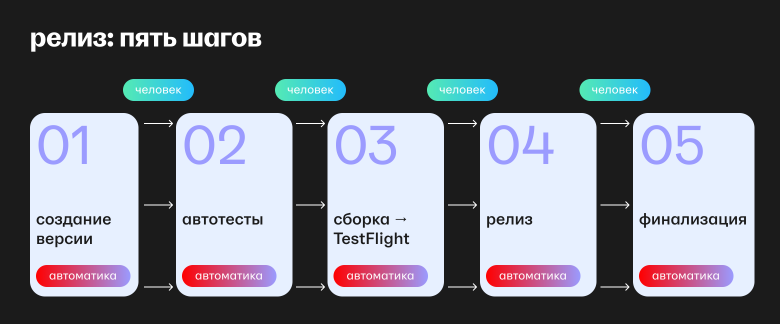
Релизный срез проводится раз в неделю. В него входят все изменения и задачи, накопившиеся в develop, отдельных релизов для одной задачи у нас нет. Весь релизный процесс от начала до конца ведёт дежурный QA.
Процесс состоит из пяти шагов и также автоматизирован отдельным планом. QA нажимает кнопку, а дальнейшая логика строится на состоянии релизной задачи и записей в базе данных. По ним каждый запуск плана определяет, на каком этапе релиз, и выполняет следующий шаг:
Новая версия. План повышает номер версии, создаёт релизную ветку и релизную задачу в Jira, к которой привязаны все вошедшие в релиз задачи, и сообщает о срезе в рабочий чат.
Автотесты. Прогоняются smoke-тесты, результат записывается в релизную задачу.
Сборка. Собираются релизные сборки всех региональных версий и загружаются в TestFlight. QA получает уведомление и проводит ручной прогон.
Ревью и раскатка. Дежурный QA отправляет сборку на ревью в Apple, после одобрения версия поэтапно раскатывается на пользователей.
Завершение. Создаётся PR из релизной ветки обратно в develop, версия помечается выпущенной, а в чат приходит отчёт об изменении размера приложения относительно прошлого релиза.
Для чего мы оптимизируем CI/CD
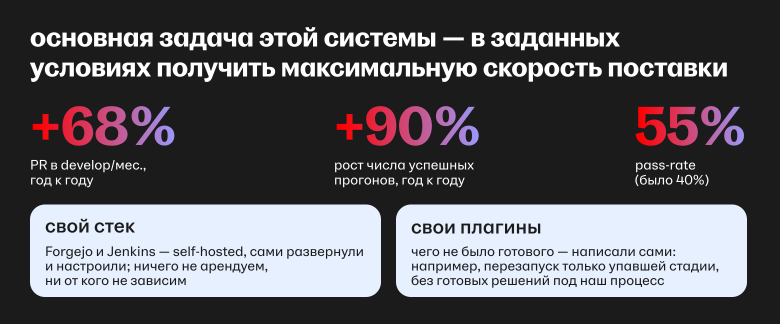
Скрипты, плагины и доработки нужны, чтобы получить максимальную скорость поставки и не увеличивать без необходимости парк оборудования и время прогонов. Количество запусков CI растёт из года в год, растёт и число успешных прогонов и их success rate. Кроме того, мы приобрели независимость от внешних сервисов, что теперь особенно важно.
Отдельно мы занимались стабильностью тестовой инфраструктуры. По приблизительной оценке, эта работа заняла около трёх месяцев: небольшие изменения вносились и раньше, поэтому назвать точный срок сложно. Весной и летом мы увеличили мощности тестового окружения и тестовых стендов, сократили количество ретраев, а стабильность при этом выросла. Поэтому перед сокращением ретраев и других страховочных механизмов сначала нужно стабилизировать инфраструктуру и сами тесты.
Инфраструктура — это не только CI-агенты. UI-тесты работают с бэкендом на тестовых стендах, и стенд может подвести так же, как агент. Перед прогоном мы проверяем стенд и, если он работает неправильно, берём следующий из пула. Результаты проверок уходят в мониторинг, а при сбоях срабатывает алерт.
Агенты тоже регулярно приводятся в порядок. По будням утром они сбрасываются: удаляются симуляторы, неиспользуемые runtimes и старые версии Xcode, чистятся кэши, после чего машина перезагружается и заново настраивает окружение.
В результате можем гордиться нашими результатами:
Инсайты
Есть несколько советов, которые мы вынесли из этих процессов.
Во-первых, смотри не только на время выполнения, но и на время ожидания. Иначе отдельные проверки могут ускориться, а поставка целиком — замедлиться.
Мы увидели это во время эксперимента с батчами UI-тестов приложения для соискателей. В исходной конфигурации тесты были разделены на четыре батча: p80 времени ожидания составлял 25 минут, доля ретраев — 8%. Затем мы увеличили количество батчей до шести. Каждый батч стал выполняться примерно на три минуты быстрее, но p80 ожидания вырос до 63 минут — в 2,5 раза. Одновременно доля ретраев поднялась до 12,5%.
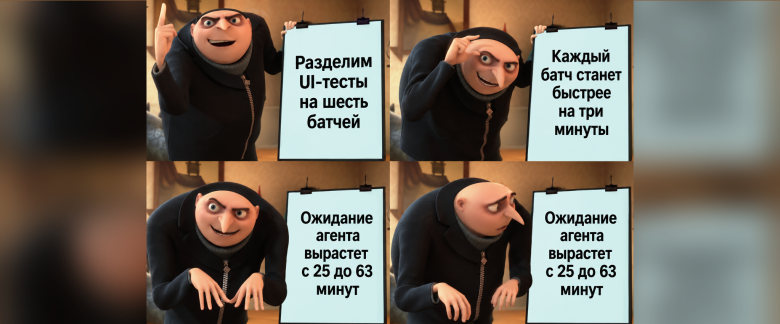
Через три недели мы вернули четыре батча. Обе метрики сразу пришли в норму: p80 ожидания снова составил 25 минут, а доля ретраев снизилась до 7%. К следующему эксперименту решили вернуться после появления новых Mac-машин.
Это не первый подобный случай: годом ранее мы уже уменьшали количество батчей, опираясь на метрики, и получившаяся конфигурация стабильно проработала год. Поэтому, во-вторых, меряй, а не гадай.
В-третьих, сначала починить, потом убирать подстраховку. Нельзя просто сократить количество ретраев и рассчитывать, что система от этого станет стабильнее. Сначала стоит устранить причины нестабильности в тестах и инфраструктуре.
Мы это проходили. С марта по июнь 2026 года наша команда последовательно занималась стабилизацией тестов: за эти месяцы было сделано 23, 26, 28 и 37 (март-апрель-май-июнь) стабилизационных правок соответственно. Параллельно мы нарастили мощности тестового окружения. Только после этой работы количество попыток для упавшего UI-теста сократили с трёх до двух. В результате доля повторных прогонов не выросла, а, наоборот, снизилась с 8–9% до 7%. То есть меньшее количество ретраев стало не способом спрятать нестабильность, а результатом того, что сама система начала работать надёжнее.
Итоги
Путь коммита начинается с локальной генерации проекта. Затем код попадает в Forgejo, а Jenkins запускает нужный план. Для PR в develop пайплайн определяет затронутые приложения, переиспользует собранный проект в разных проверках, готовит предрелизную сборку, параллельно запускает батчи UI-тестов и возвращает результаты через Danger.
Повторяющиеся действия мы автоматизируем, а изменения в инфраструктуре проверяем экспериментами. Решения принимаем по метрикам: учитываем время выполнения и ожидания, стабильность тестов и долю повторных прогонов. При падениях проверяем всю цепочку — сами тесты, стенды, сеть и CI-агенты. Сокращать ретраи стоит после устранения причин нестабильности.
Если у вас есть вопросы, буду рад ответить на них в комментариях.
А ещё подписыватесь на телеграм-канал «Охэхэнные новости» — там мы интересно и без занудства рассказываем о работе в hh.ru.
s0n0ma
Правильный (современный) подход серьёзной компании. А ведь раньше... всё это делали ручками.