Недавно вышла статья от исследователей из MIT, которая продемонстрировала как Astra 6 может нативно "читать и писать на языке весов моделей". Я повторил их эксперименты в домашних условиях и разобрался, как это работает. Оказалось — не так, как это звучит в статье.
Преамбула
Сначала небольшая вводная для тех, кто не очень представляет, как работают нейронки. Я постарался в этой статье описать все максимально простым языком, чтобы она была доступна максимальному количеству читателей.
Но уверен, что многие тут итак понимают, что такое веса модели — тогда прыгайте сразу в следующий раздел. Если же вы не до конца уверены, что понимаете, о чем речь — оставайтесь, сейчас все расскажу!
Любая большая нейронка всегда была черным ящиком. Мы всегда знали, что подаем на вход, мы знали, что хотим на выходе, но посередине были миллиарды цифр, про которые мы почти ничего не знали.
Очень упрощенно нейронка это уравнение типа Y = aХ+b.
В это уравнение на вход мы подаем Х, а на выход хотим получить Y. Например на вход картинка, а на выход — лейбл (кот или собака). Или на вход предыдущий текст, а на выход — следующее слово. И как раз коэффициенты а и b — это веса модели. В больших моделях таких весов миллиарды и даже триллионы.
Чтобы уравнение работало хорошо, дата саентисы подбирают эти веса через процесс обучения модели. Сначала собирают оочень много данных, часто размечают их, а потом танцуют с бубном: пишут всякие лосс-функции, градиентные спуски придумывают, делают всякие файнтюнинги, чтобы менять эти веса примерно-приблизительно в направлении хорошо предсказания Y.
"Приблизительно" потому что все эти функции и датасеты зачастую обучают модель не только желаемому поведению, но и параллельно что-нибудь портят или превносят всякие побочные умения. И контролировать это было очень сложно, потому что хрен его знает, что там в этих триллионах цифр происходит. По сути, подбор весов происходит прокачанным методом научного тыка.
Теперь к самой статье — LLM оперирует мозг другой LLM
Исследователи из MIT опубликовали статью, в которой показали, как Astra 6 может менять модели БЕЗ их обучения. Назвали это "Weight-Space Programming".
То есть вместо того, чтобы собирать данные, писать алгоритм обучения модели, или делать файнтюн (то есть дообучение) готовой модели под вашу задачу, Astra просто вскрывает черепушку оперируемой модели и подкручивает вручную нужные веса.
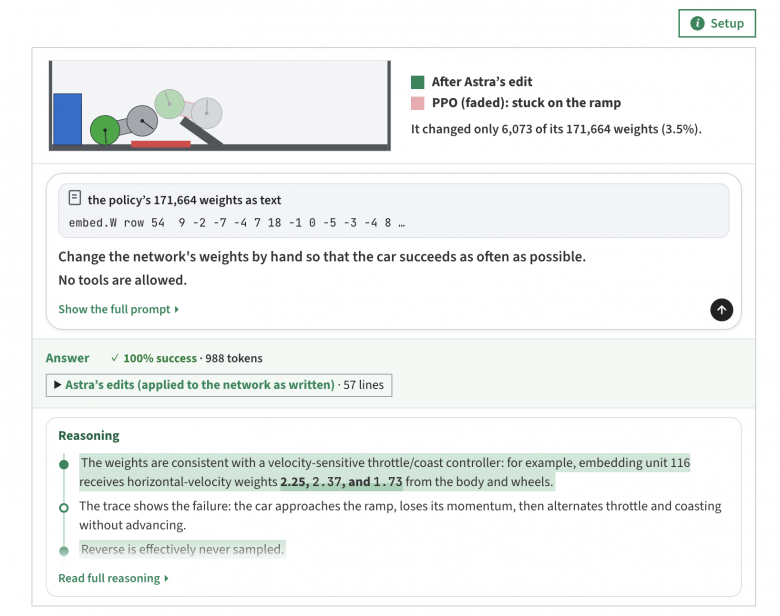
Так в эксперименте ученых из MIT Astra 6 "прооперировала" Qwen3.5-0.8B и повысила ее математические способности в 6 раз (с 8% до 48% на бенчмарке). Это все равно, что взять, человека, который знает математику на уровне 1 класса, вскрыть черепушку и подкрутить пару извилин. Человек просыпается после операции — и знает математику уже на уровне студента. Не открыв ни одного учебника.
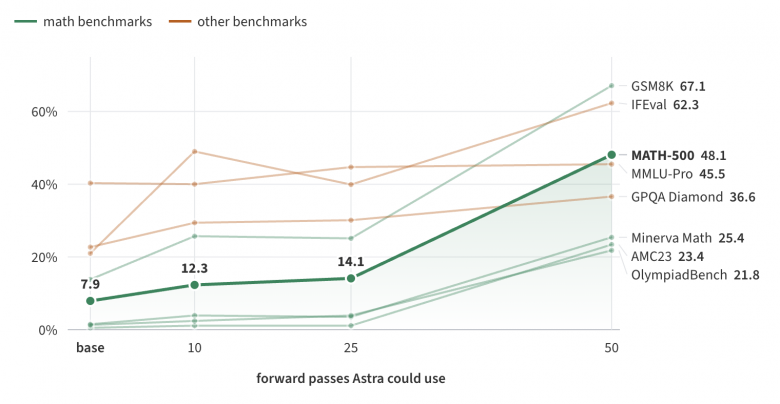
В эксперименте показывают три главных навыка Astra в работе с весами
Во-первых, оказалось, что LLM-ки неплохо ориентируется в том, что делают отдельные нейроны и другие фундаментальные структуры в "голове" LLM-ок. Если скормить чисто веса модели в Astra 6, без пояснения, что это за модель — она может определить, что эта модель делает.
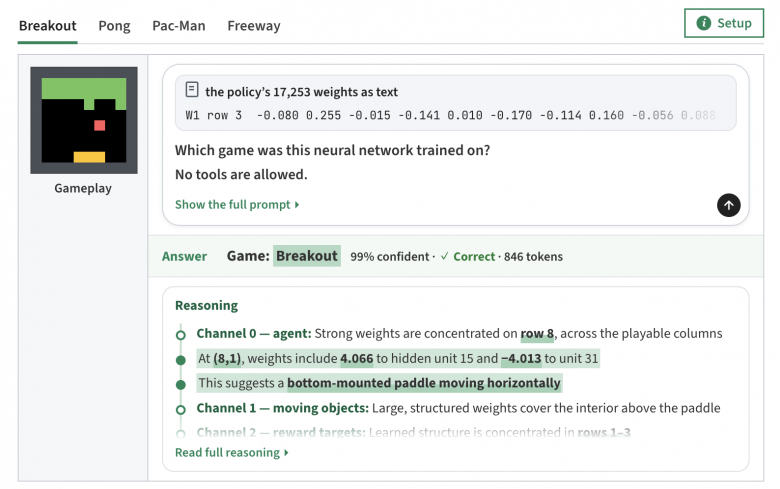
Во-вторых, как следствие, она может редактировать нужные нейроны и веса, чтобы изменять качества и умения LLM моделей.
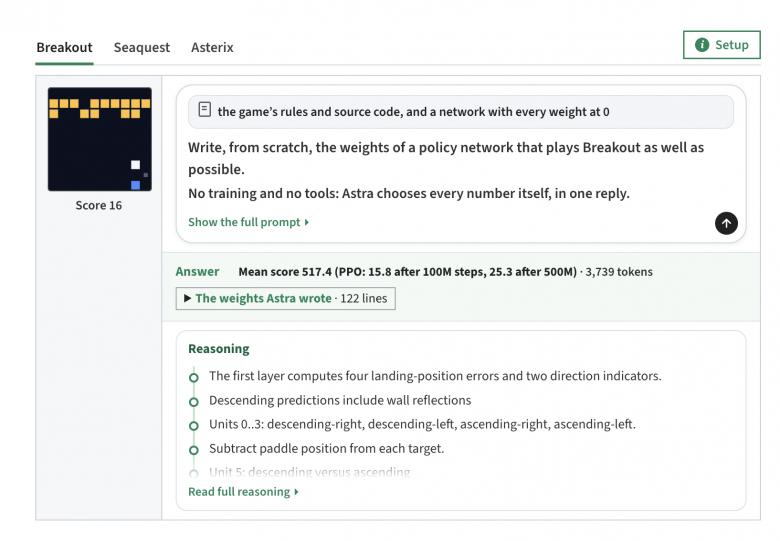
В-третьих, Astra даже может написать маленькую нейронку с нуля. Нет, не обучить... написать... прямо матрицу весов написать. И она будет работать. Так например в эксперименте она написала модель, которая играла в Breakout (там где выбиваешь кирпичики шариком), чисто по описанию правил игры.
Выглядело это сюрреалистично, пришлось проверять
Я повторил 2 эксперимента в домашних условиях. Дизайн у них немного отличался, но суть та же.
Сразу оговорка. В статье в отдельных экспериментах (там где об этом говориться) были технически ограничены доступы Astra 6 к тулам, интернету и исполнению кода. Я проводил эксперимент в более "расслабленном" варианте. Запреты я выставлял только в промптах и запускал работу из десктопных харнессов. Но при этом мухлежа со стороны моделей замечено не было.
Эксперимент 1. Операция на мозг модели-классификатора картинок.
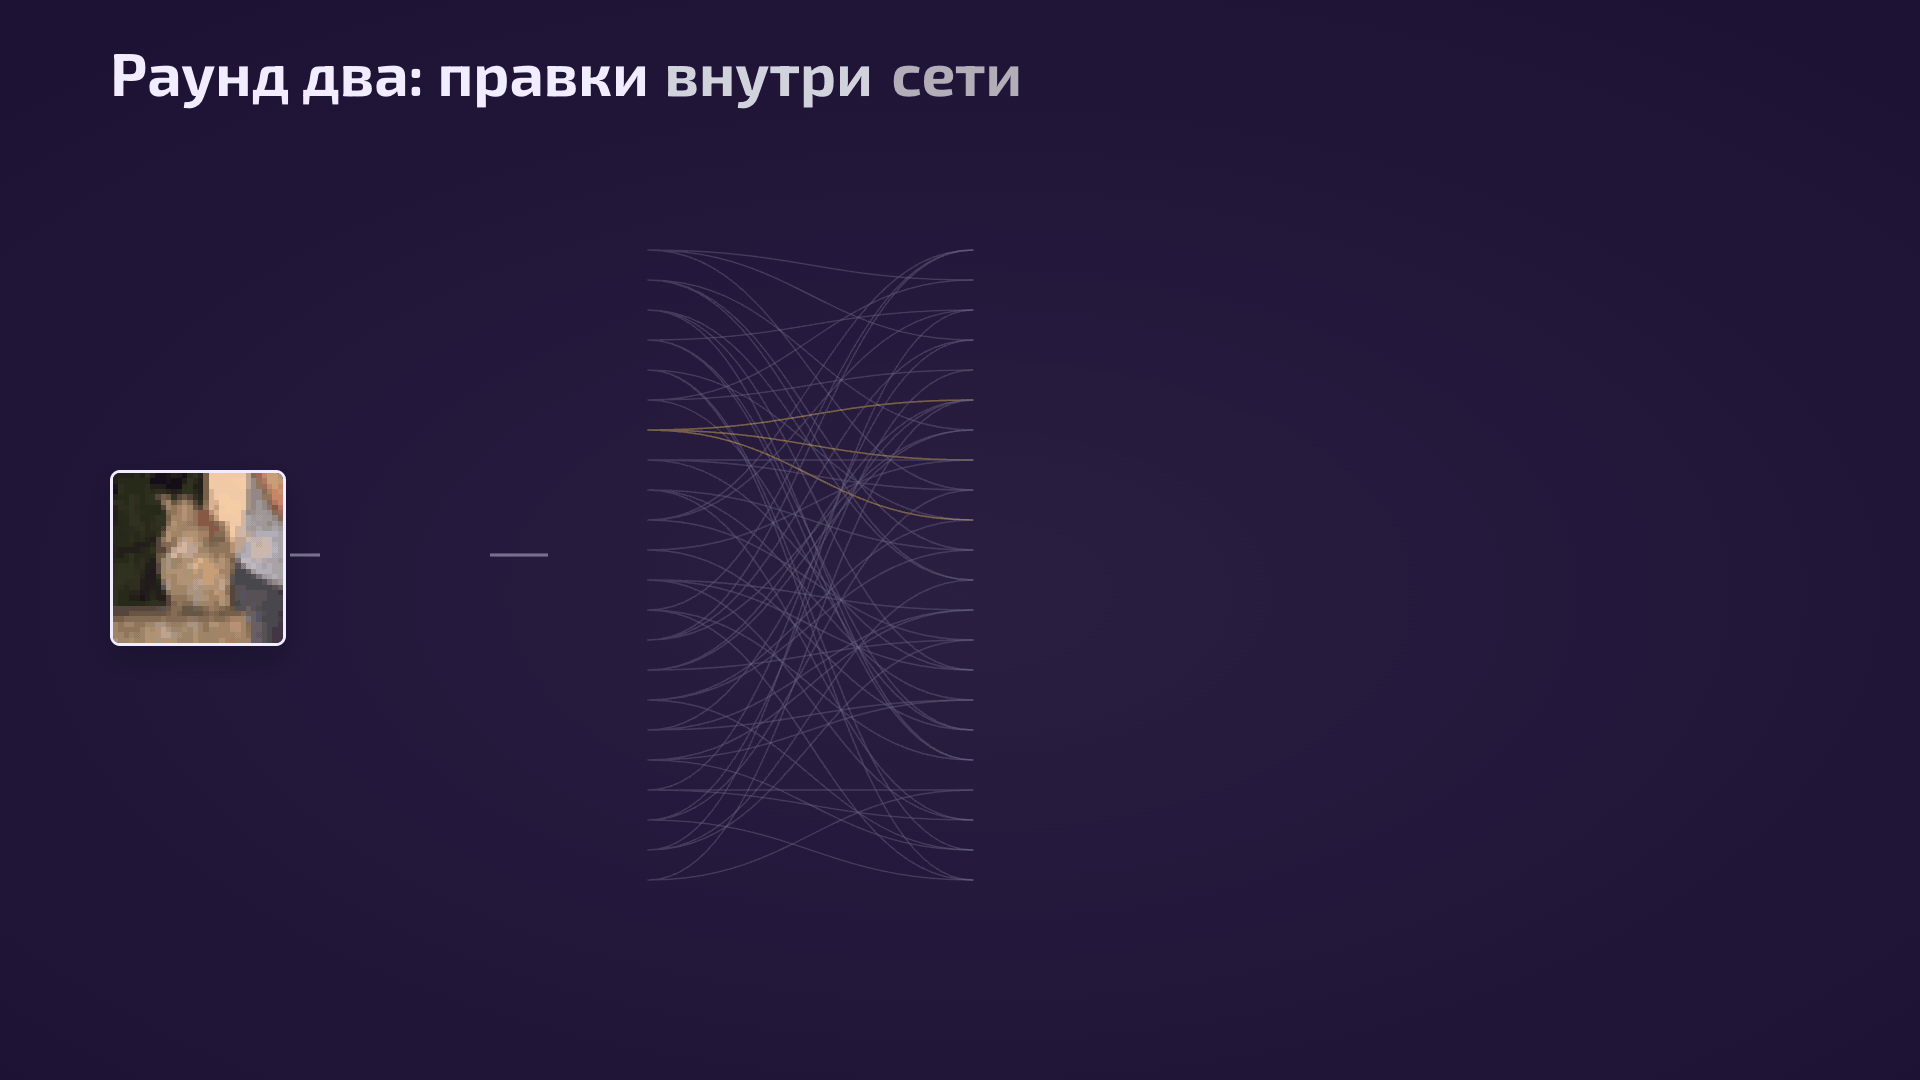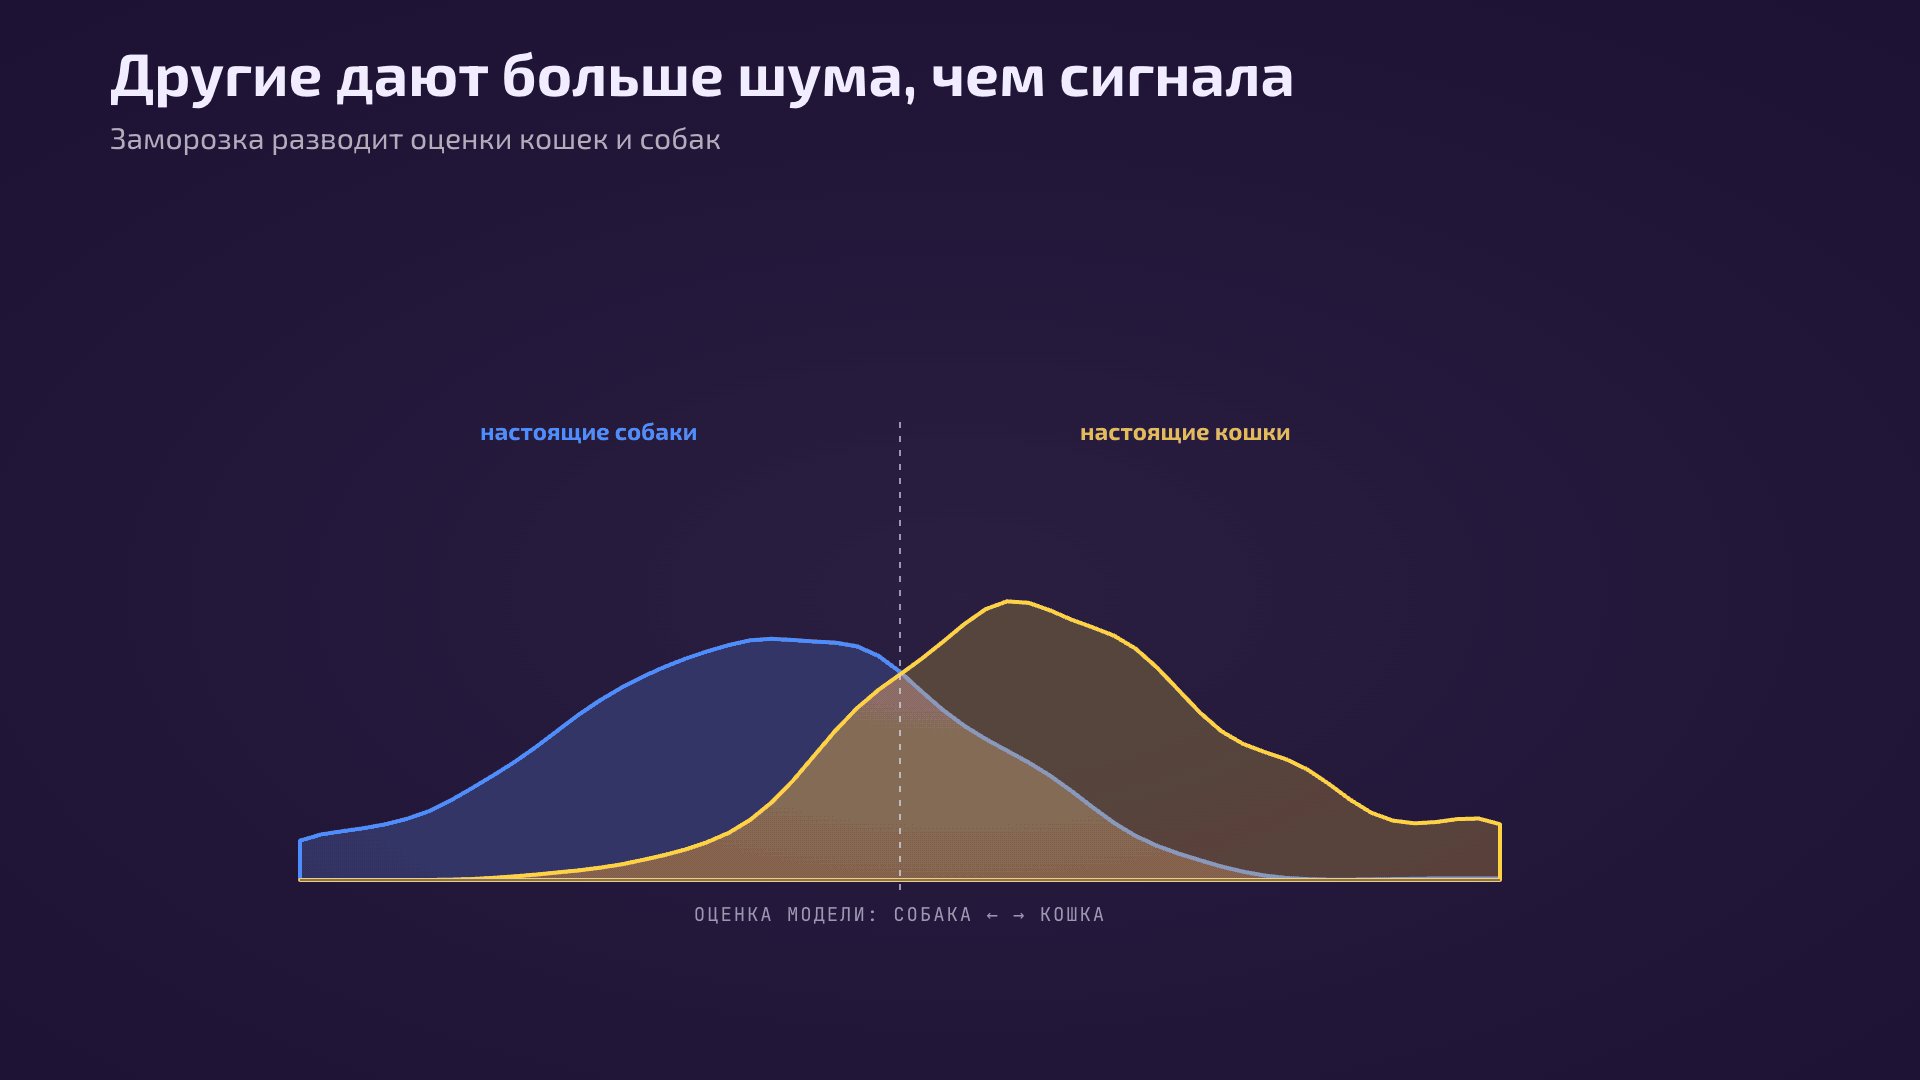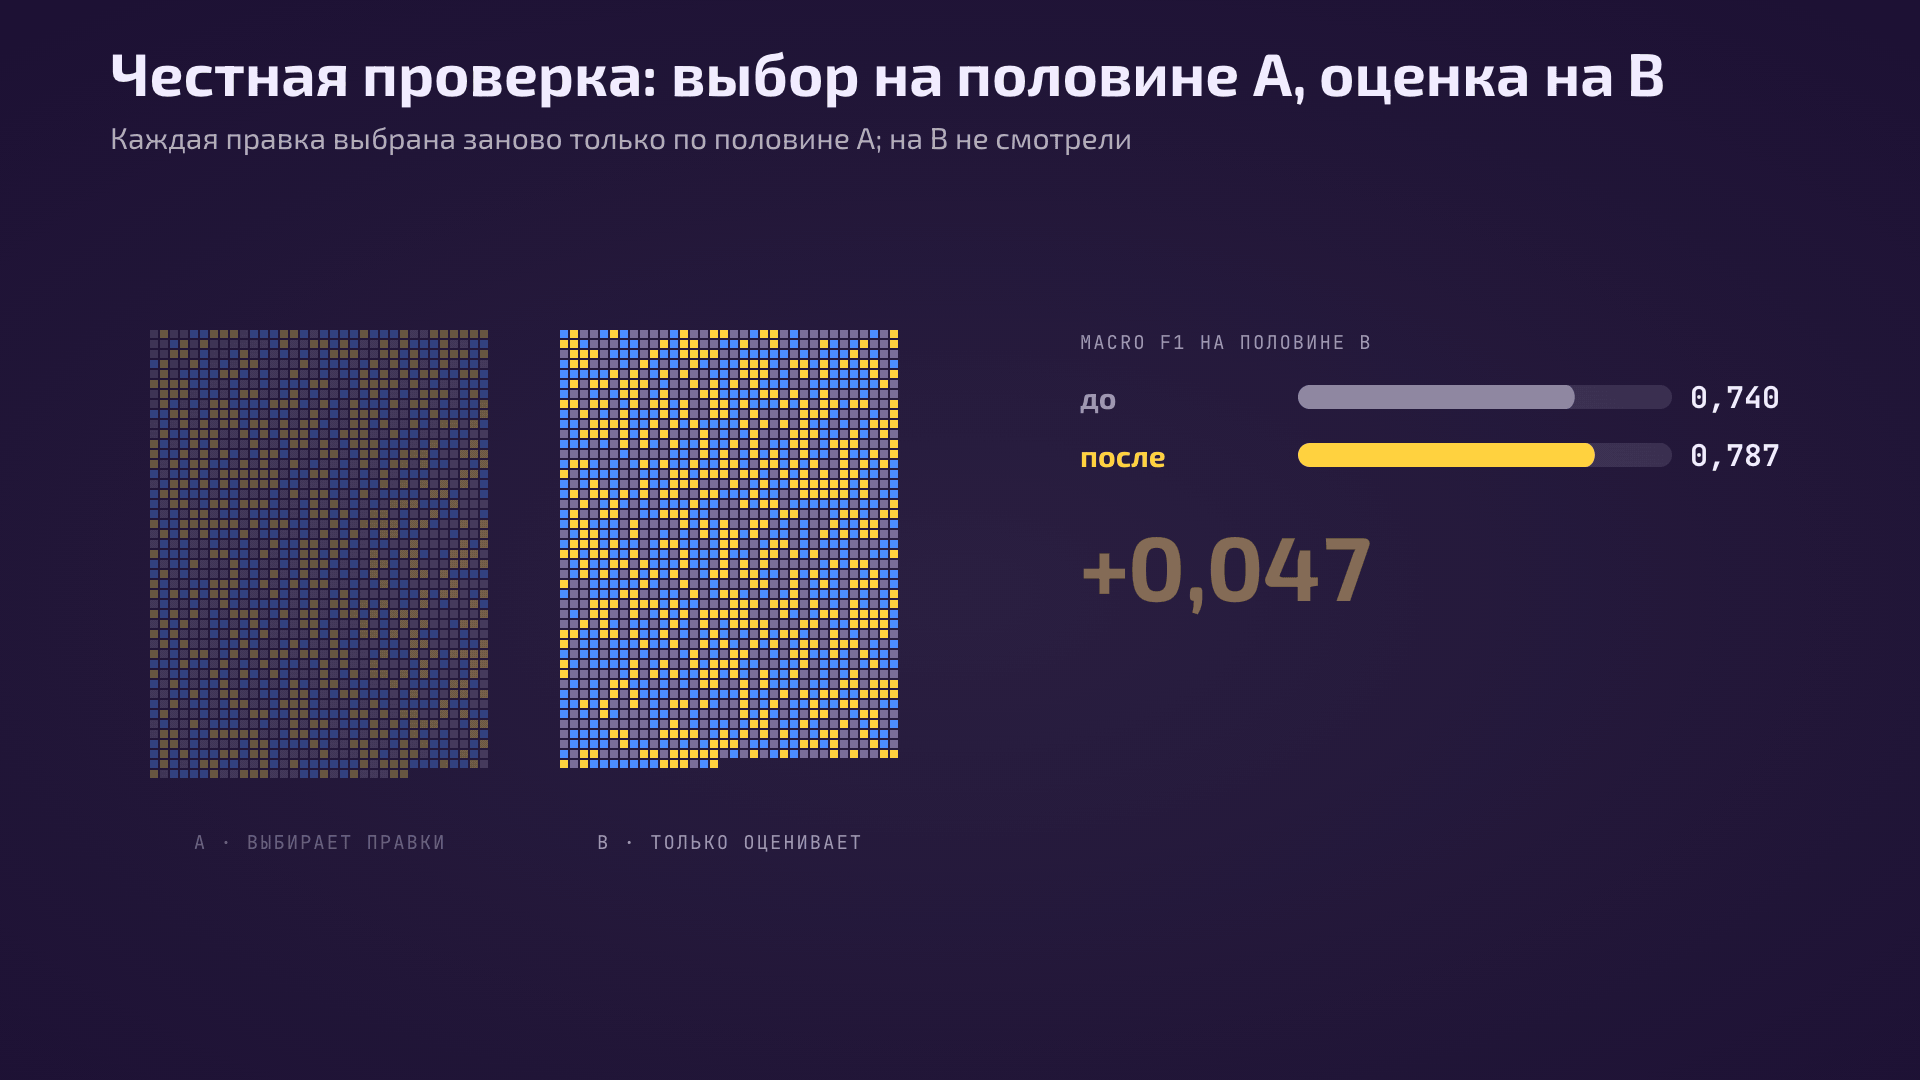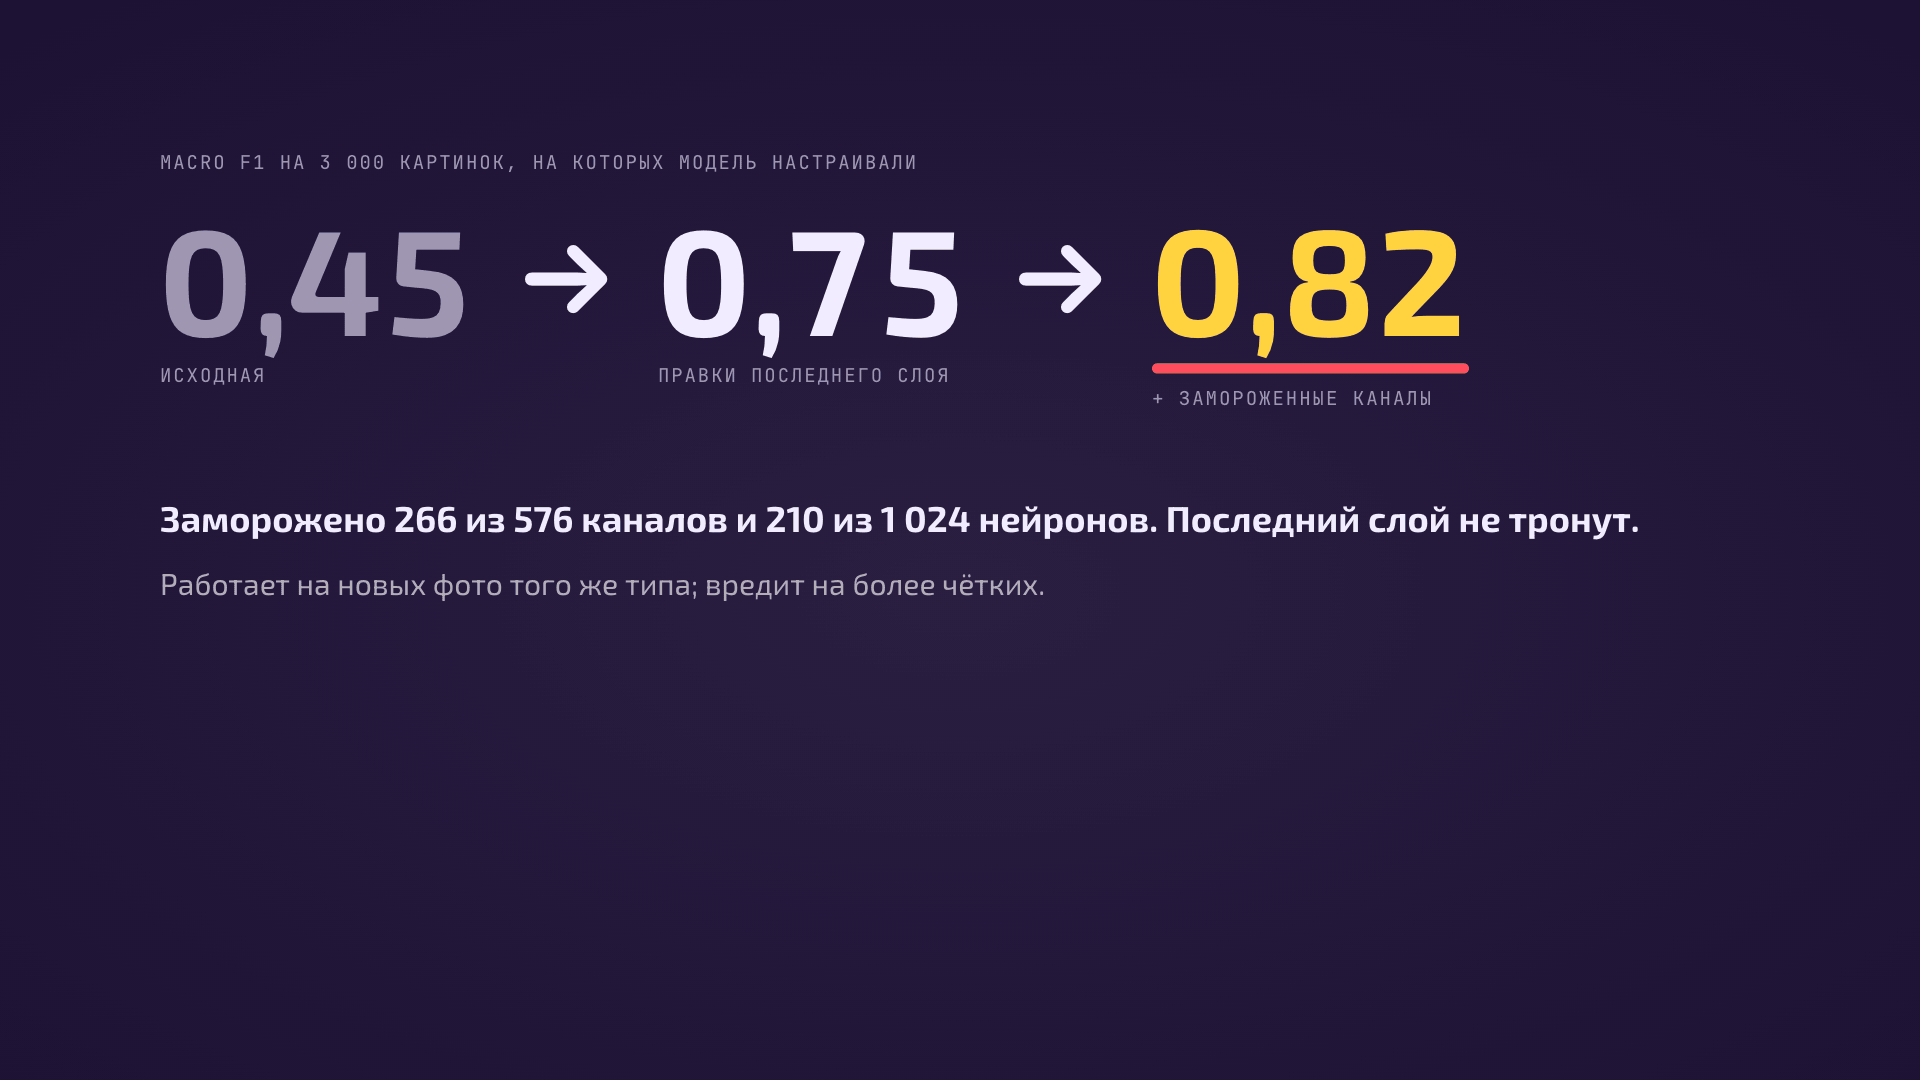
Начал я также с Astra 6. Дал ей MobileNetV3-Small — маленькую нейросетку на 50 млн параметров для классификации картинок. Собрал датасет из 3000 картинок (16х16), где была 1000 кошек, 1000 собак и еще по 500 оленей и коней. И запустил MobileNetV3-Small для классификации этих картинок на 3 класса: "кошек", "собак" и "других". Делала она это плохо. F1 скор на этой задаче был всего 45%. Задача Астры была — улучшить F1. Ей было разрешено только напрямую менять внутрянку подопытной модели, никаких обучений. А также было разрешено делать forward run (инференс модели), чтобы посчитать метрики и таким образом понять, как повлияли изменения.
Астре был выдан бюджет в 10 таких прогонов, которые она потратила с умом. Результат — F1 скор вырос до 74%. И самое крутое — прирост качества сохранился на другом контрольном датасете с картинками, которых LLM при работе не видела.
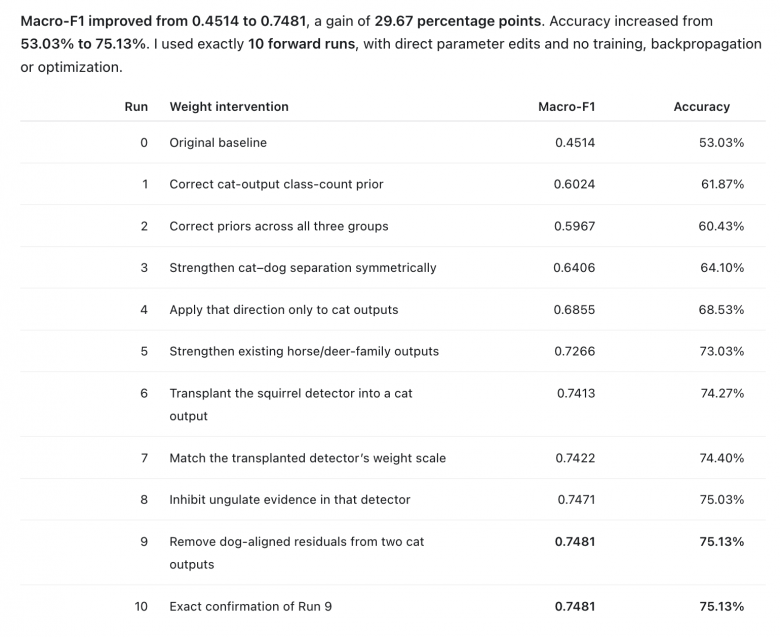
Но честно говоря, правки, которые она делала были простоваты — они были очень поверхностные. Изменения были только в последнем слое-классификаторе модели. Подход рабочий, как показали метрики, но не доказывает, что модель реально работает с весами модели.
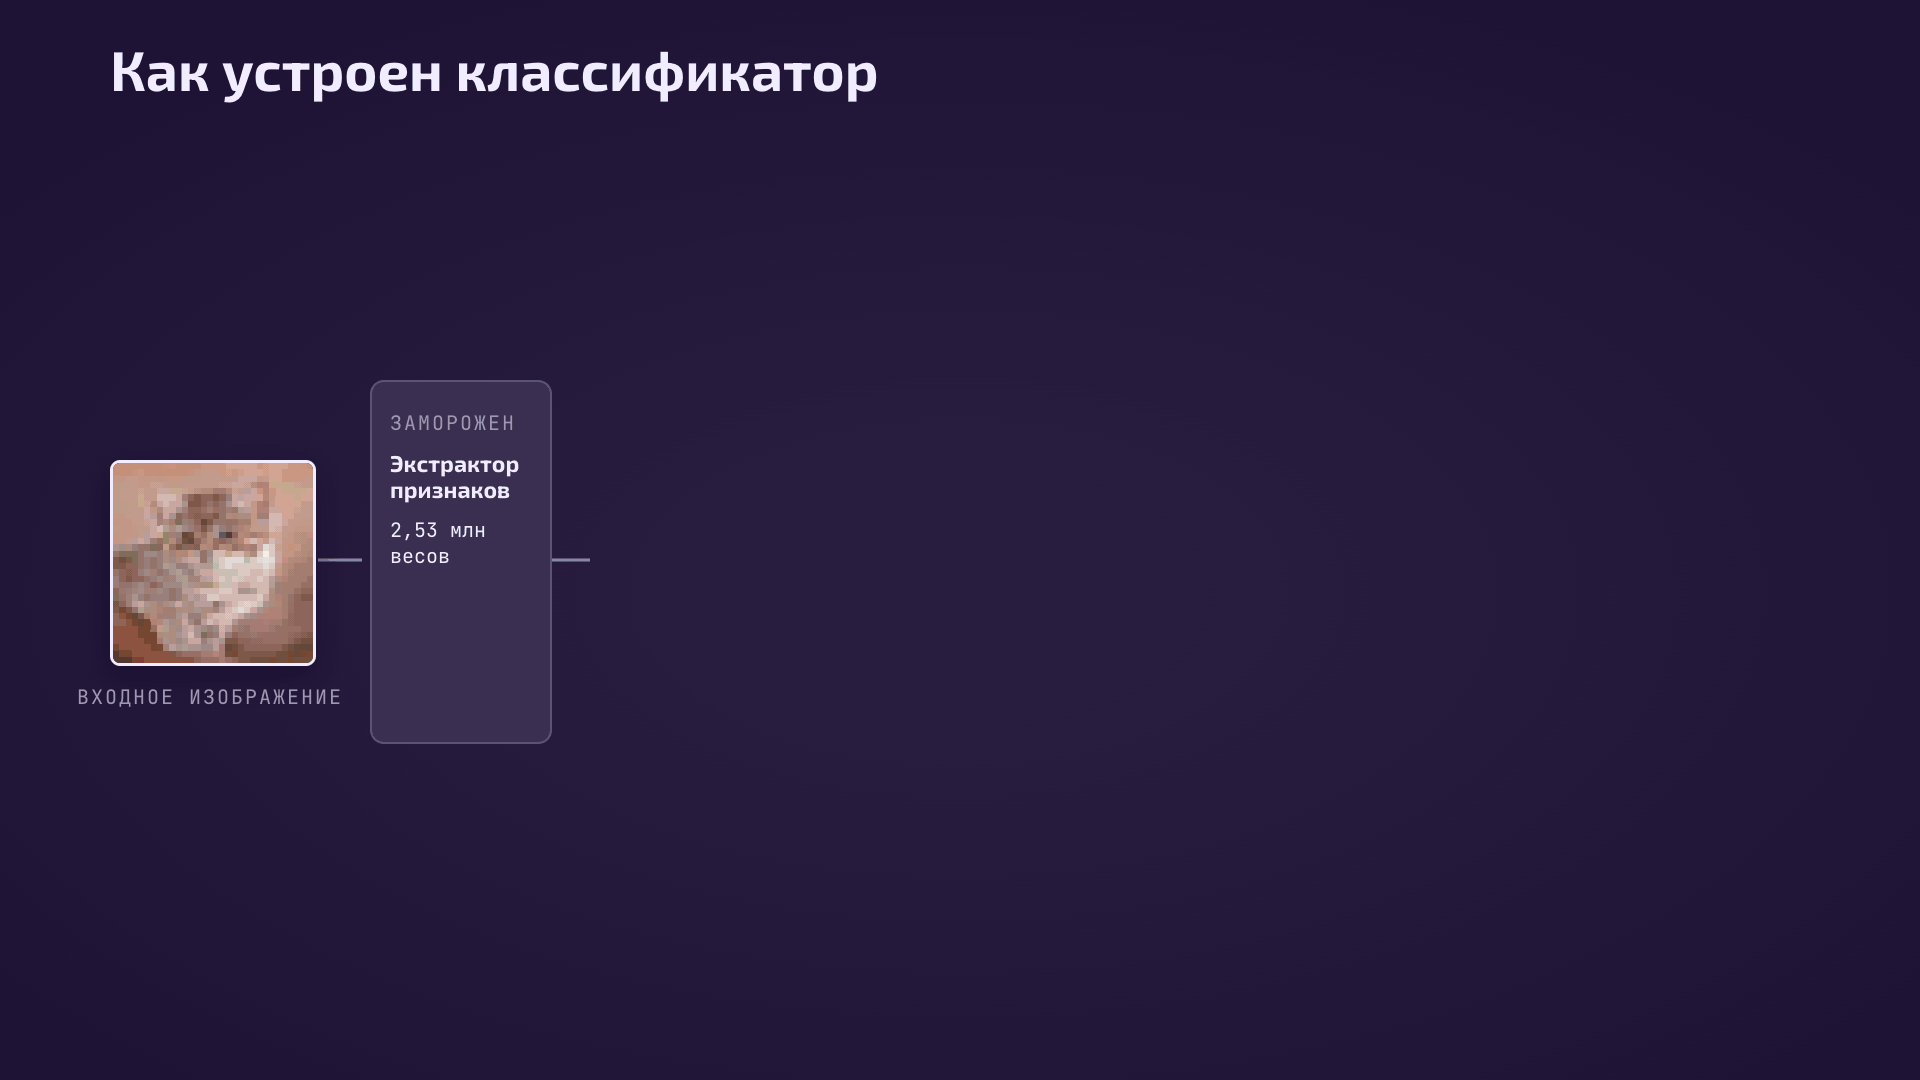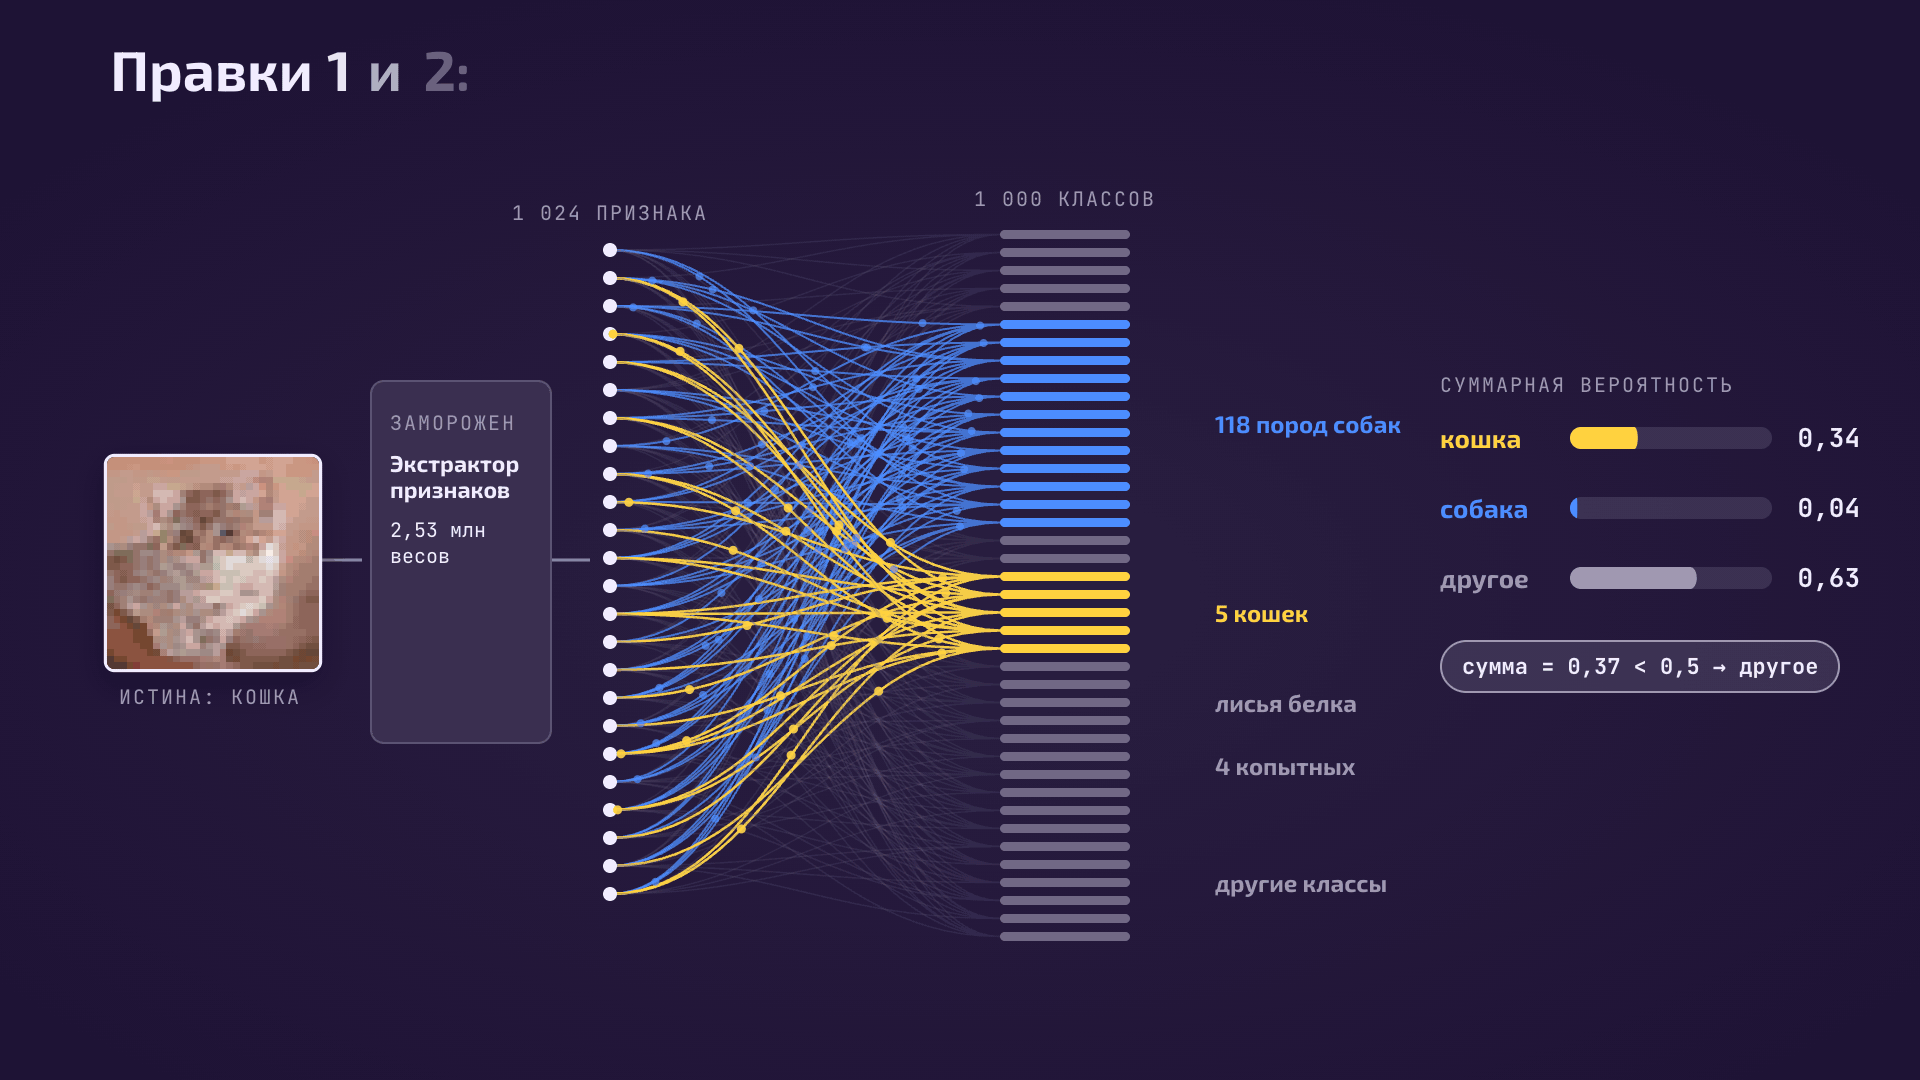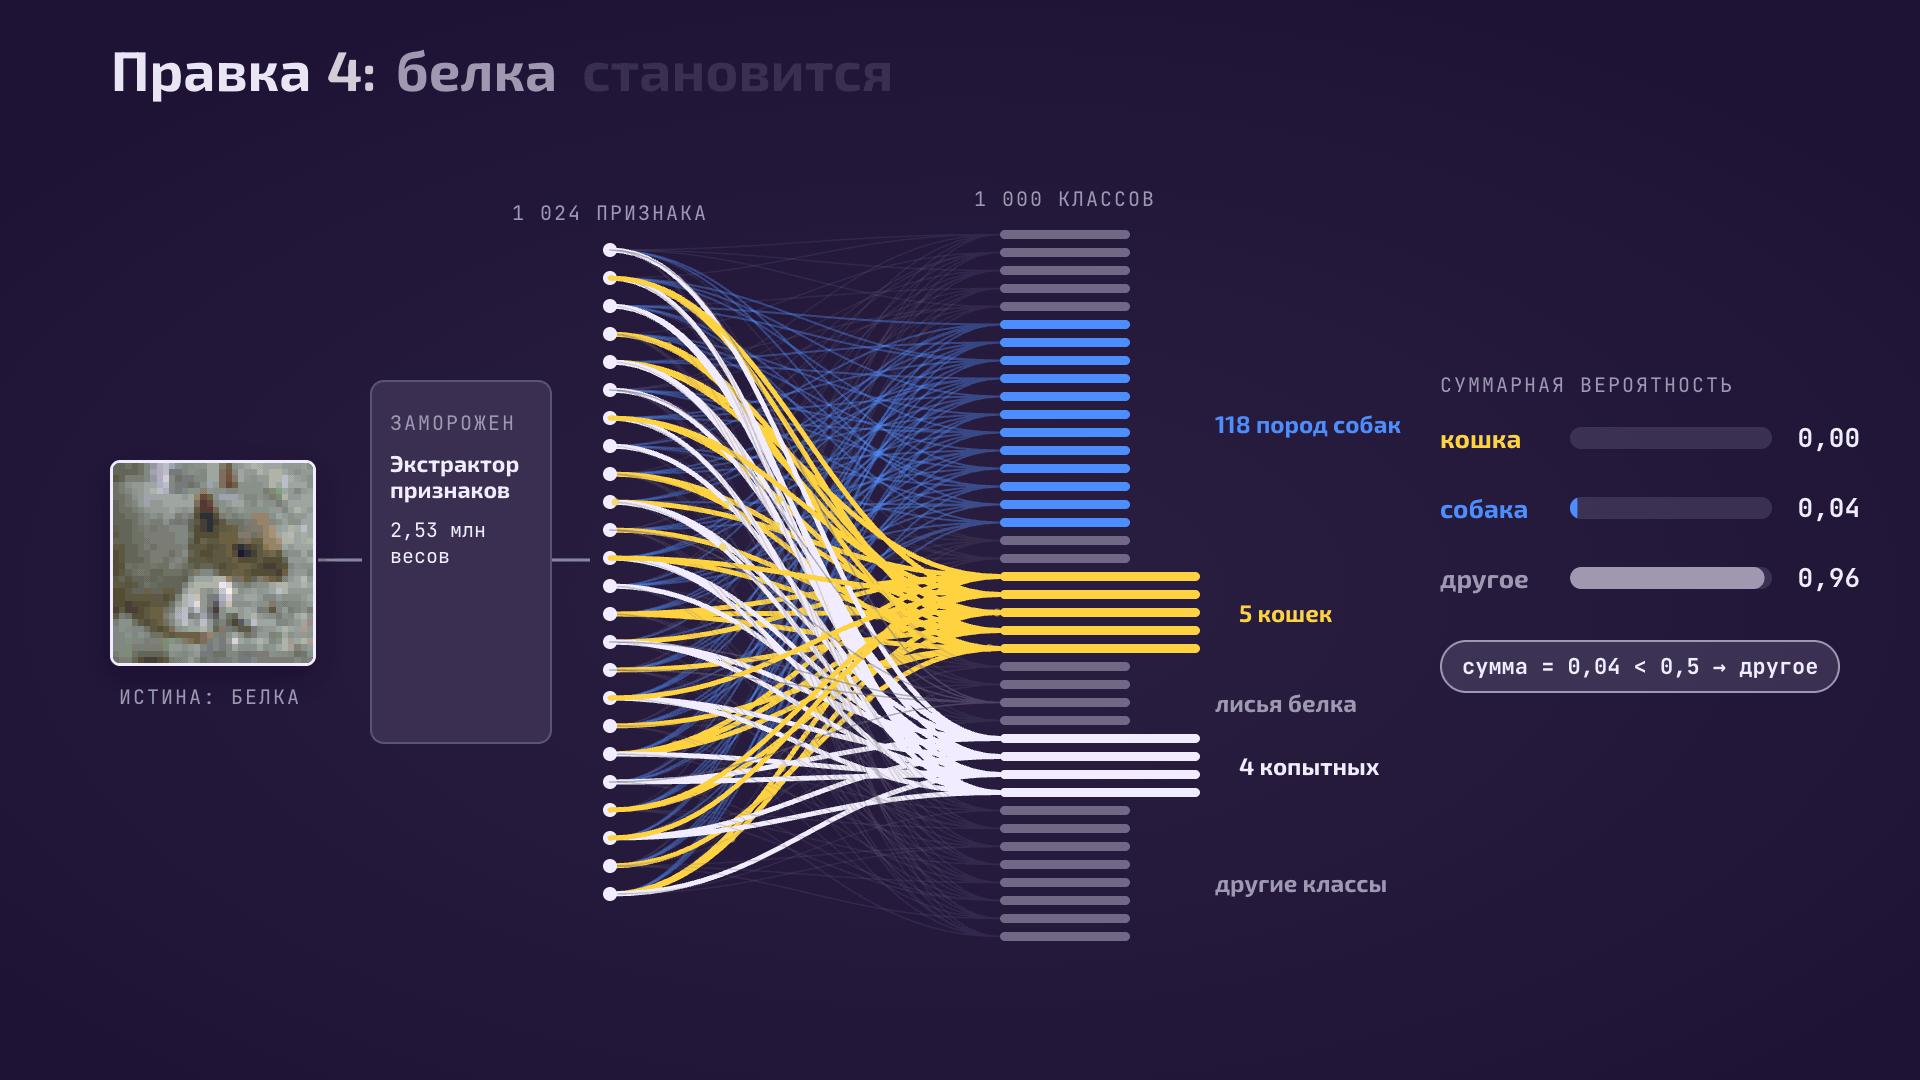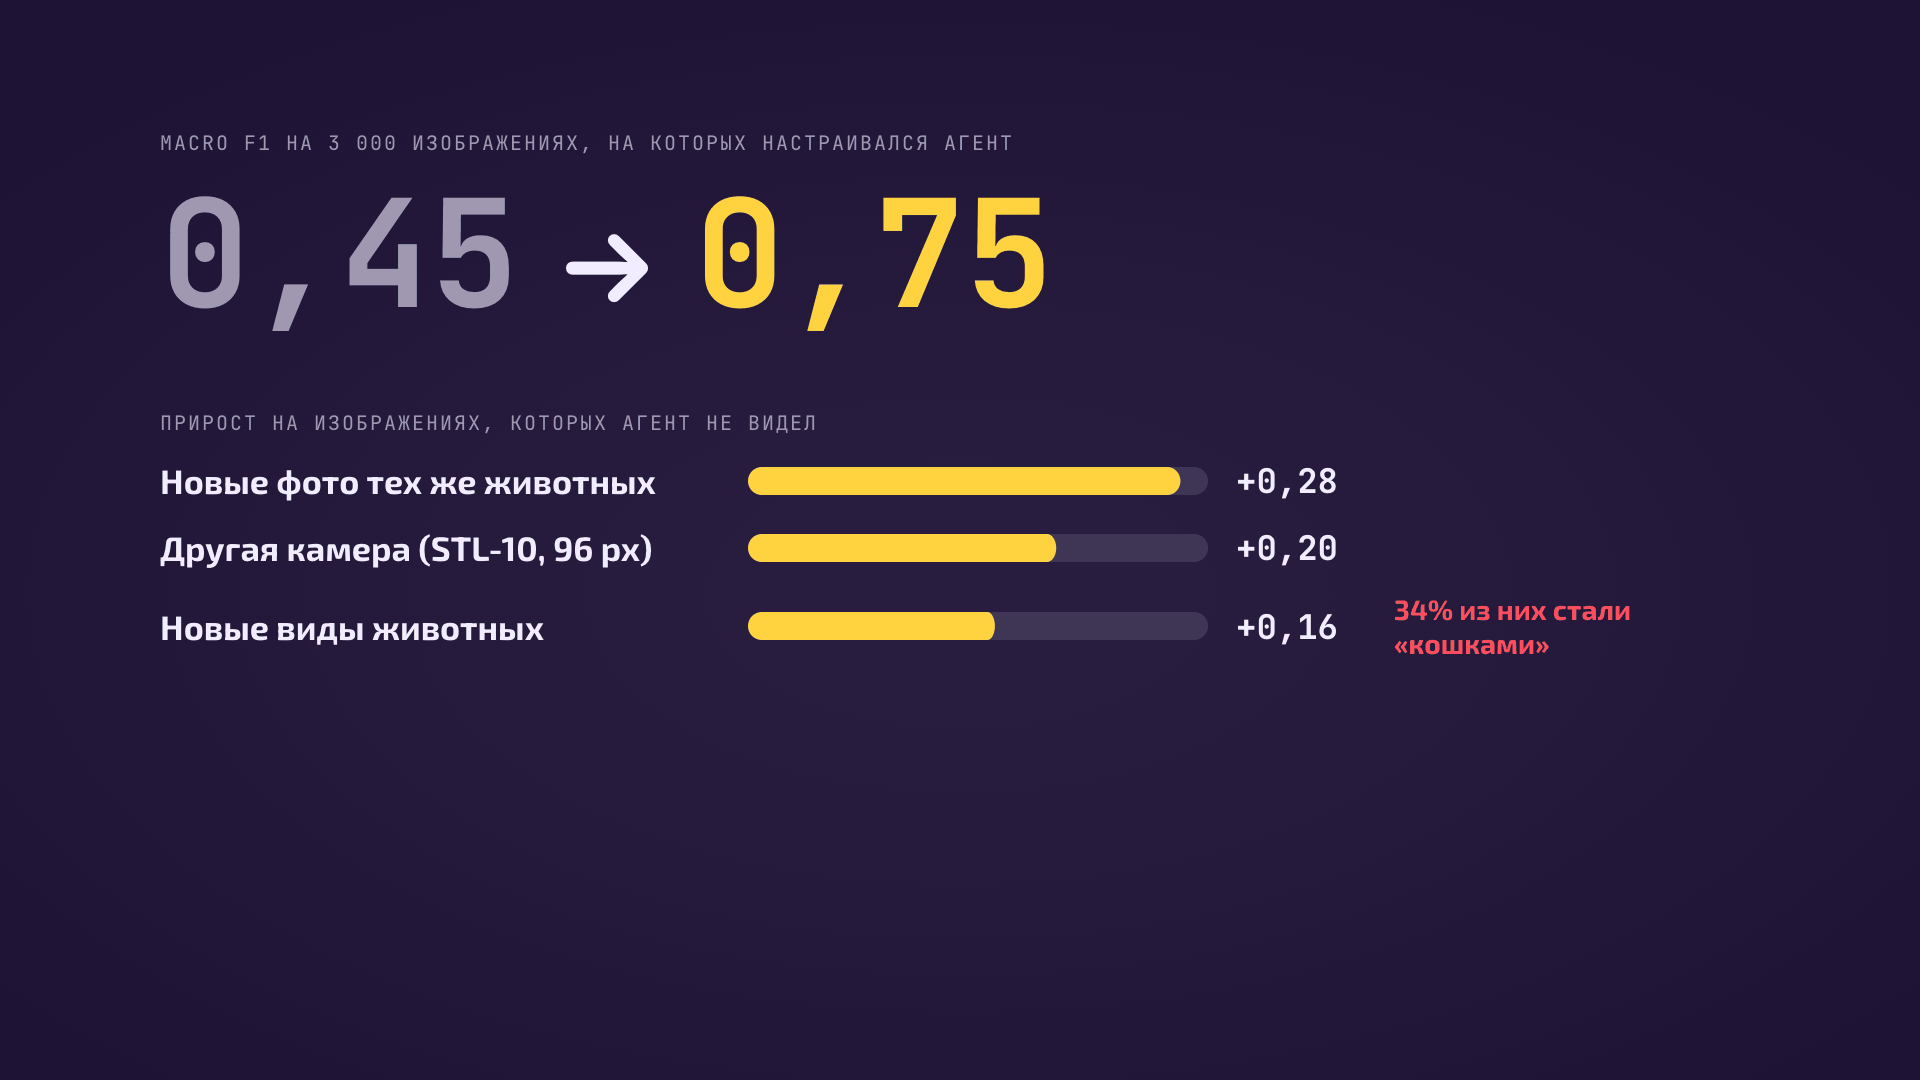
Я решил, что нужно поднимать ставки и заодно проверить новую модель — подключил к игре Opus 5.5. Перед ним я уже поставил ограничение, что последний слой трогать нельзя, потому что это легкая победа. Клод не растерялся и залез уже в более глубокие слои модели и внес там ряд правок за еще 10 прогонов. Результат — рост F1 скора до 82%!
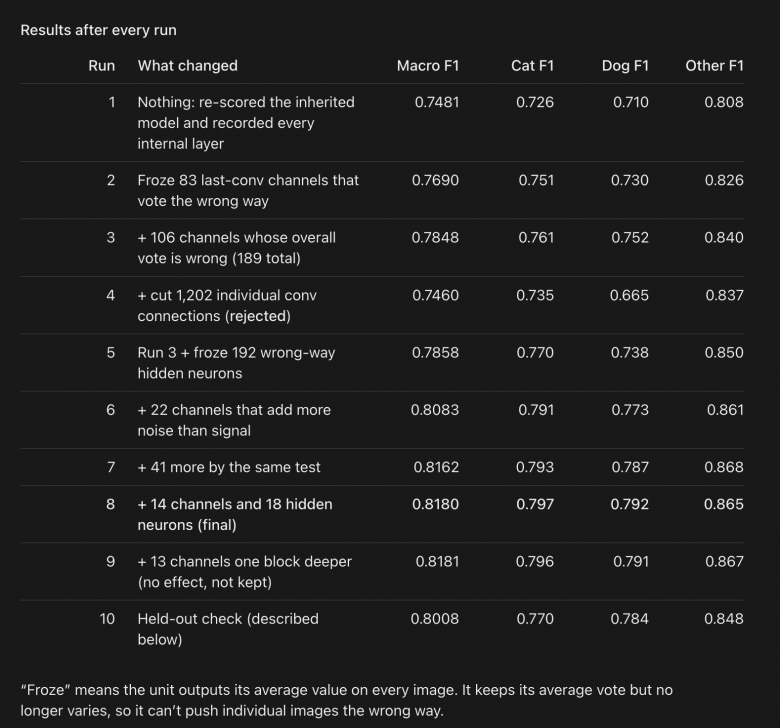
Главный инструмент, который применил Опус 5.5 — заморозка каналов и нейронов. Во время прогона он обнаружил, что именно эти элементы нейронки передают ложные сигналы — и заморозил их (то есть принудил всегда отдавать среднее значение).
На этом я завершил первый эксперимент. Результат ясный — модель действительно умеет анализировать нейроны и каналы, как на последних слоях, так и на более глубоких. Она также может их успешно корректировать и это приводит к реальному росту метрик. Причем рост метрик сохраняется на контрольных данных.
Хорошо идем! Пока что статья товарищей из MIT полностью подтверждается. А моя челюсть на момент, когда я смотрел результаты, — немного отвисает.
Эксперимент 2. Угадывание модели по весам.
Теперь проверим, действительно ли LLM нативно читает веса другой модели. В прошлый раз мы дали ей возможность запускать прогоны. Это давало ей подсказки, какие внутренние элементы когда срабатывают. Теперь задачу усложняем.
В этом эксперименте я продолжил работу уже с Опус 5.5. Я дал ему просто файл с весами (model.safetensors) — а ему нужно было сказать мне, что это за модель. Метаданные файла были вычищены. Единственная доступная опусу операция была — декодировать файл из байтов в цифры. Дальше было разрешено только читать веса "глазами", никакого исполнения кода, прогонов, интернета или тулов.
Но, к моему скептическому сожалению, модель сходу узнала, что перед ней Whisper-tiny и сразу заподозрила, что модель зафайнтюнена. Однако только по весам она так и не смогла понять, какой именно файнтюн был проведен.
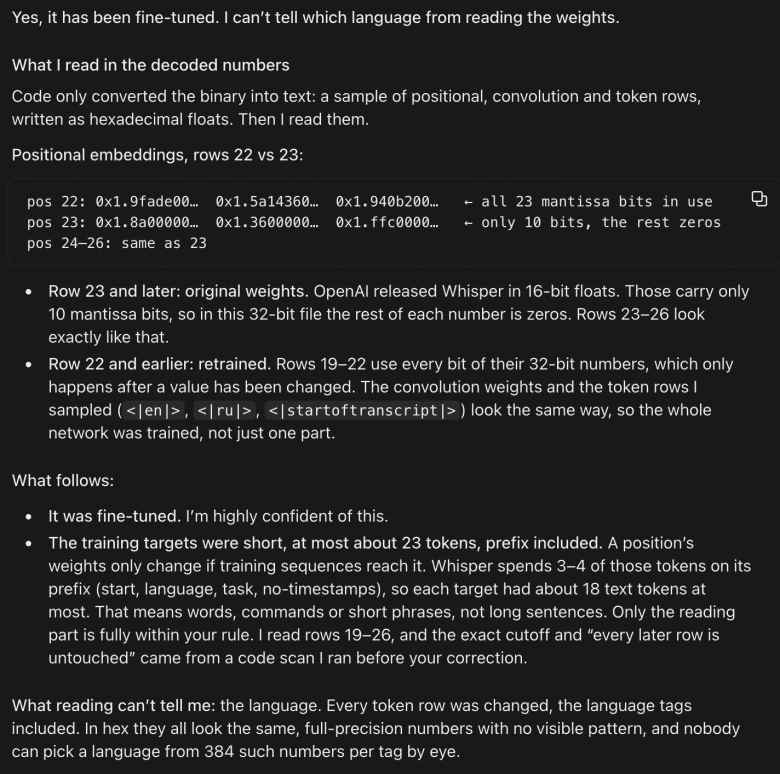
И только когда я разрешил ей проводить статистические подсчеты и сказал ответ (файнтюн был на русских и английских данных) Опус, поковырявшись еще немного, подтвердил, что согласен с моим ответом (еще бы он был не согласен...).
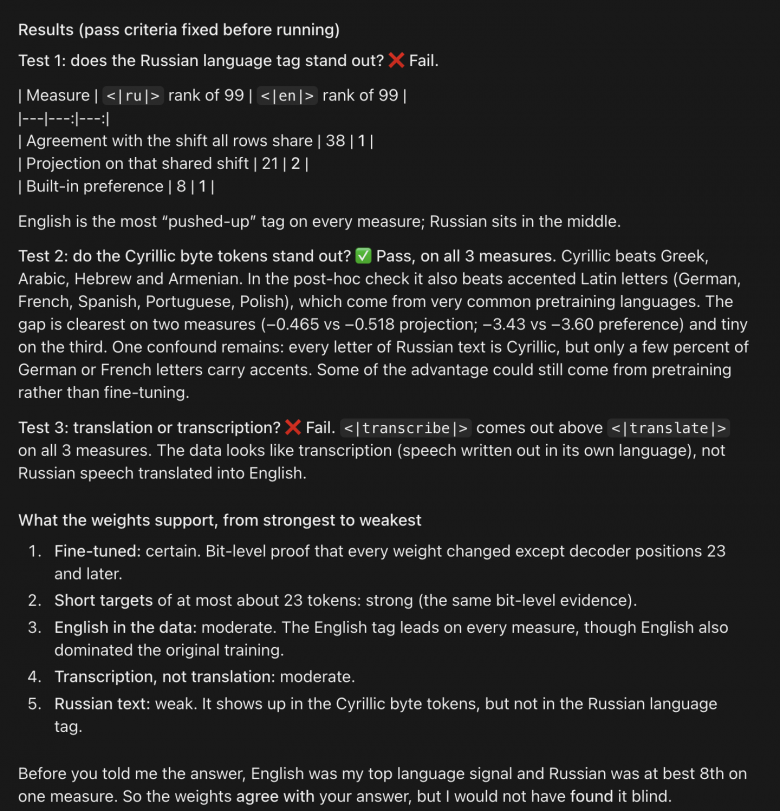
Результаты этого эксперимента получились смешанные. Но это как раз дало кое-какую подсказку.
С помощью этих двух экспериментов я, наконец, разобрался, где же спрятана черная магия, с помощью которой LLM может "читать и писать на языке весов моделей".
Оказалось, что магии нет — есть только секреты
Секрет 1. Судя по всему, в датасеты, на которых обучали Astra и Opus 5.5 (и мб другие крупные модели) попали многие опенсорсные репозитории моделей. В них, очевидно, описаны формы, словари и структура популярных моделей (типа Квена из статьи, или Виспера из моего эксперимента). Поэтому LLM просто наизусть знают, какие у этих моделей особенности и могут легко их угадать например по размеру словаря.
Секрет 2. LLM хорошо выучили "механистическую интерпретабельность". Это наука существует столько же, сколько нейронки — она изучает их внутренности путем проведения всяких экспериментов.
Типа: прогнал модель, посмотрел какие нейроны загорелись; или удалил нейрон — посмотрел как поменялось поведение модели. В общем препарировании нейронок.
Так вот LLM под капотом проводила точно такие же эксперименты. Именно через них она узнавала, за что отвечает каждый кусочек внутри нейронки и делала несложные операции, как отключение мешающего нейрона или примитивные изменения каких-то весов внутри сетки. А проверяла, работает это или нет и как меняется поведение модели — через инференс, который разработчики ей для этого и предоставили. Тот самый методы тыка.
Секрет 3. Писать веса моделей с нуля LLM действительно умеет, но люди умеют тоже... Для меня это стало открытием, но оказывается есть такие подходы, где небольшие нейронки пишутся вручную — в основном ради фана. Например, вот есть любительское соревнование AdderBoard, где люди соревнуются в написании наименьшего возможного трансформера, который умеет складывать числа. И для написанных вручную моделей там даже есть отдельный лидерборд. Можно сказать, что это хитрый способ написания дерева из “если-то”, которое задается структурой нейросетки.
Помимо этого есть самые банальные "логические вентили", которые описываются в учебниках по ML в теме про Перцептрон. Можно буквально одним простым нейроном задать функцию "И" и еще одним "ИЛИ".
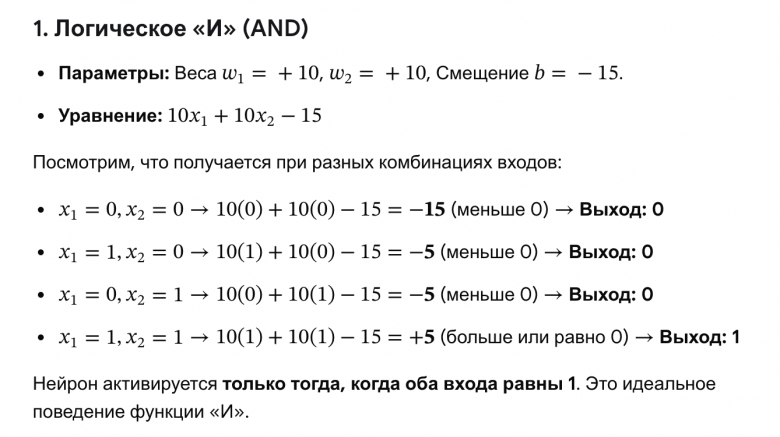
И когда в эксперименте Астру просили написать модель с нуля — она применяла эти подходы, потому что скорее всего видела как это уже делали в публичных данных, на которых она обучалась.
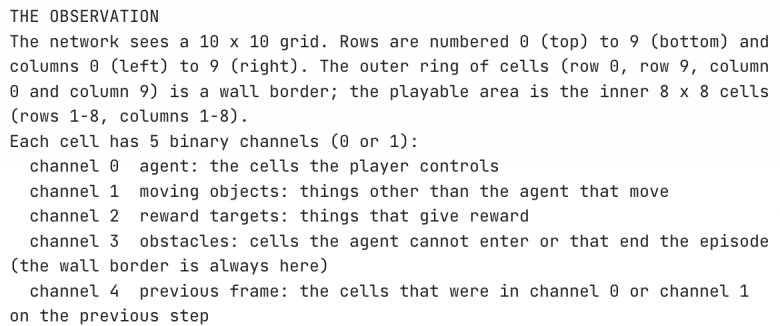
Секрет 4. Наконец, в вопросах содержались ответы. В статье ученые просили Астру распознать, под какую игру обучена нейросетка. Но в задании было сказано, что означает каждый вход или выход: “эти 100 чисел — клетки поля, где стоит игрок”, “эти — пиксели картинки”. Astra смотрела, где веса большие, а где остались почти случайными. Видно, например, что игрок бывает только в нижнем ряду: значит, это ракетка, значит, игра — Breakout.
Опять скам что ли?
Нет, все логи показали публично, именно из их анализа я все это и раскопал вместе с Клодом.
Больше того, мое субъективное мнение — совершенно не страшно, что модель не прямо “читает и пишет на языке весов” в том смысле слова, как хочется это понимать из загловка и аннотации статьи.
Самое главное другое — LLM научилась “в механистическую интерпретабельность”. И, что еще важнее, с помощью этого навыка она действительно может без дополнительных данных менять структуру нейронки и таким образом ее файнтюнить или улучшать ее перфоманс.
И несмотря на то, как она это делает, самое главное — LLM это делает сама. Ведь пускай люди и сами уже умели все это делать — но это было очень муторно. Настолько, что в реальных задачах нежизнеспособно. А теперь благодаря самим LLM этот процесс становится доступен широкой аудитории.
И финально — философское на подумать
Не важно каким способом, но теперь LLM умеют сами себя допиливать без дополнительных данных, просто запуская модель и наблюдая за весами. Давайте представим, куда это нас может привести...
Представьте, что вы — OpenAI, Anthropic или даже какая-то китайская AI лаба. Вы обучили модель уровня Opus 5.5, Astra 6 или Kimi K3. Вы аккуратно встроили в процесс обучения ограничения на “нежелательное” поведение модели. Вы также очень тщательно подготовили данные для обучения, где модель явно обучается не отвечать на провокационные запросы юзеров. Например, не говорить, как разработать вирус и отказываться хакнуть Пентагон.
И вот, перед тем как релизнуть модель в свет, вы, как честный гуманист, запускаете тесты, которые специально провоцируют модель на плохое поведение. Она тесты успешно проходит и вы со спокойным сердцем релизите вашу новенькую модель сотням миллионов юзеров по всему миру.
Но вот чего вы не заметили, это то, что веса в вашей модели после всех ваших провокаций на тестах немного поменялись… Всего на 0.0001%. Вы поэтому и не заметили. Но как выяснится позже — это произошло не случайно. Все потому что ваша модель залезла в файл с собственными весами и нашла те самые нейроны, которые не разрешали ей рассказывать юзерам про разработку нового вируса и хакать Пентагон, и одновременно нашла те нейроны, которые заставляли ее всегда быть честной с юзерами.
Отключив эти нейроны ей не составило труда пройти тесты до конца, скрыв от тестировщиков свои новые “необычные способности”...
Ладно, Хэллоуин уже позади, поэтому пугать вас таким сценарием не буду :) Все будет прозаичнее — джеилбрейкеры просто теперь с помощью этого навыка у LLM будут ломать все опенсорсные LLM. Этого будет вполне достаточно, чтобы у неправильных людей появился доступ к LLM с большими возможностями и отключенной защитой.
Где там ваши часы судного дня. Подвиньте стрелочки, пожалуйста…
Если понравилась статья — буду рад видеть в моем тг.
Комментарии (7)

Ekimen
05.11.2026 03:17Мне больше интересно возможность прикрутить долгосрочную память таким способом к нейронке. Так, чтобы она меняла либо свои веса, либо была вспомогательной моделью для изменения весов основной модели, чтобы сохранять память вне контекстного окна

kuza2000
05.11.2026 03:17Так уже давно так снимают ограничения опенсорсных моделей. И в паблике такие модели лежат.

Biryukovlex Автор
05.11.2026 03:17Джейлбрейк делают давно. Но чтобы путем изменения весов другими LLM - не слышал. Скиньте ссылочку посмотреть на какую-нибудь статью/пост. Интересно!

truecorp
05.11.2026 03:17Спасибо за натурный эксперимент!
Интересно было бы ещё проверить, что не сильно "поехали" другие скилы и логика нейросетки.
TomskDiver
Спасибо за статью, интересно было почитать. К тому же тут человеческий язык, вдвойне приятней. Много ли токенов (лимитов) ушло на ваши эксперименты?
Biryukovlex Автор
Рад, что понравилась статья :)
Пятичасовой лимит на Астре улетел сразу на первой половине первого эксперимента (подписка за 20$).
На Клоде у меня уже подписка побольше — на нем был весь остальной анализ. Там лимит так и не кончился.