

Почти все советы по проектированию MCP-серверов сводятся к одному: чем меньше инструментов, тем лучше. Я проанализировала 91 источник. 38 из них советуют сокращать число инструментов, 20 называют конкретную цифру (чаще всего 10–20), и только 10 вообще измеряли, как число инструментов влияет на точность.
Тогда я измерила сама: 1932 прогона на топовых моделях и ещё 1404 на самых дешёвых, в трёх клиентах (программах, в которых работает агент: Claude Code, Codex CLI и Antigravity), от 5 до 100 инструментов. На сегодняшних топовых моделях точность не сдвинулась: ни на 100 инструментах, ни с похожими друг на друга названиями. На дешёвых моделях появляются вызовы не того инструмента. На стоимость работы влияет клиент, потому что он определяет, как модель будет работать с вызовами. По умолчанию ни один из трёх клиентов не кладёт схемы инструментов в промпт. Claude Code и Antigravity показывают модели только названия инструментов, а Codex ищет их определения кодом. Поэтому теперь модель по названию инструмента решает, какие описания ей прочитать, прежде чем выбрать.
Лучшие практики, которые никто не измерял
Прежде чем что-то мерить, я провела небольшой обзор: что советуют в этой области публичные источники. 91 материал о проектировании MCP-серверов, из них: 21 раздел официальной документации, 28 блогов вендоров, 20 независимых блогов, 2 ветки форумов и 20 научных статей. 38 из них советуют отбирать меньше инструментов, 22 предлагают держать видимый набор маленьким через поиск или отложенную загрузку, 8 рекомендуют code mode, где один или два инструмента выполняют код. Выставлять всё подряд не советует никто.
Конкретное число называют 20 источников: 5–8 (Workato), 5–15 (Phil Schmid), меньше 10 на пространство имён и меньше 20 (OpenAI), 10–20 (Gemini, Speakeasy), 30–50 (документация Claude), «40 — точка перегиба» (Archestra). Только 3 из этих 20 чисел авторы получили своим измерением. Два самых популярных утверждения не подтверждаются. «Модели ломаются на 30 инструментах» идет от статьи RAG-MCP, где считали MCP-серверы в промпте, а не сколько инструментов доступно. «Cursor не принимает больше 40 инструментов» перестало быть актуальным в январе 2026 года, когда лимит убрали.
Из 91 источника 46 высказывают мнение, ещё 8 ссылаются на других. 37 что-то измеряли, но связь числа инструментов с точностью мерили только 10: 7 научных статей, GitHub Copilot (с 40 до 13 инструментов, плюс 2–5 пунктов), LangChain и один неформальный тест на модели 1.7B. Остальные мерили токены или сравнивали MCP с CLI, а это уже совсем другая история.
О полезности группировки инструментов единого мнения тоже нет: 15 источников советуют инструменты под сценарии (workflow tools), 15 предлагают группировать, 3 держат по инструменту на операцию, причём указывают причиной работу с разрешениями на чтение и запись (или иными вариантами предоставления прав доступа, чтобы клиент мог выдавать их отдельно), а не точностью.
Как я измеряла
Я сделала фейковый сервер на 100 реалистичных инструментов для файлов и документов, с правдоподобными названиями и схемами. Некоторые названия нарочно похожи друг на друга, например pdf_compress, pdf_optimize и image_compress. Есть ещё сгруппированный вариант, где 7 инструментов покрывают 50 операций, и вариант с невнятными названиями. Реальная работа с файлами не проводится, корректность выполнения задачи определяется на основе журнала вызовов сервера.
Агенты получили 18 задач с известными ответами, 10 из них неоднозначные, при N = 5, 10 … 50, 75 и 100 инструментах, две попытки на каждую. Клиенты: Claude Code (Opus 5.5), Codex CLI (GPT-6.1-sol) и Antigravity (Gemini 3.1 Pro), каждый на своей подписке. Claude Code я проверяла в двух режимах. В режиме по умолчанию работает поиск инструментов: модель видит только названия, а нужные схемы подгружает вызовом ToolSearch. Без поиска все схемы сразу лежат в промпте. Все измерения лежат на GitHub: отчёт, results.csv и сырые логи каждого прогона.
Сколько инструментов уже слишком много?
Каждый прогон с отдельными инструментами оказался полностью корректным, от 5 до 100 инструментов, во всех трёх клиентах, в Claude Code и с поиском инструментов, и без него. Сюда входят все неоднозначные задачи и 50 дополнительных похожих инструментов на 75–100. Так что на Opus 5.5, GPT-6.1-sol и Gemini 3.1 Pro (октябрь 2026) правило «меньше инструментов, выше точность» в этом диапазоне не проявилось. Это сходится с теми немногими измерениями, которые я нашла в публичных источниках: просадка сильно зависит от модели. В LongFuncEval при росте с 49 до 741 инструмента GPT-4o теряет около 13% точности, а другие модели 40–85%. В MCP-Bench топовые модели держатся при сотне лишних инструментов, а слабые проседают.
Поиск инструментов в Claude Code ни разу не спрятал нужный. В каждом прогоне был только один вызов ToolSearch, первым действием, и инструменты он выбирал по точному имени. Модель заранее видит все названия и выбирает между похожими только по ним, ещё не прочитав ни одной схемы.
Сколько на самом деле стоят MCP-инструменты в Claude Code, Codex и Gemini
Входные токены, среднее по 36 прогонам на ячейку (18 задач × 2). Все эти прогоны были правильными, так что таблица только про стоимость.
Клиент |
Как инструменты попадают к модели |
Первый вызов: 5 / 50 / 100 |
За прогон: 5 / 50 / 100 |
Ещё один инструмент (первый вызов / за прогон) |
Claude Code (Opus 5.5), поиск включен (по умолчанию) |
Только названия, схемы подгружаются через ToolSearch |
3,9k / 4,6k / 5,4k |
13,8k / 17,4k / 19,9k |
~15 / 79 токенов |
Claude Code (Opus 5.5), поиск выключен |
Все схемы целиком в промпте |
4,1k / 11,7k / 20,2k |
9,3k / 27,9k / 48,6k |
169 / 429 токенов |
Codex CLI (GPT-6.1-sol) |
Code mode: схем в промпте нет, модель ищет их кодом |
13,2k всегда |
45,3k / 61,4k / 78,2k |
0 / 408 токенов |
Antigravity (Gemini 3.1 Pro) |
Только названия, файл схемы открывается по запросу |
3,8k / 4,1k / 4,3k |
15,7k / 20,5k / 18,6k |
~5 токенов / не растёт |
Главный переключатель, который влияет на работу в Claude Code, — это поиск инструментов. Пока инструментов мало (примерно до 19), поиск из-за лишнего вызова ToolSearch выходит дороже, чем если грузить все схемы сразу. На 100 инструментах с поиском входных токенов за прогон уже на 59% меньше. Но по прайсу такой прогон всё равно стоил дороже: $0,047 против $0,038 без поиска, потому что кешированный вход дешёвый, а поиск добавляет ещё один вызов.
Группировка MCP-инструментов: в одном клиенте дешевле, в другом появились ошибки
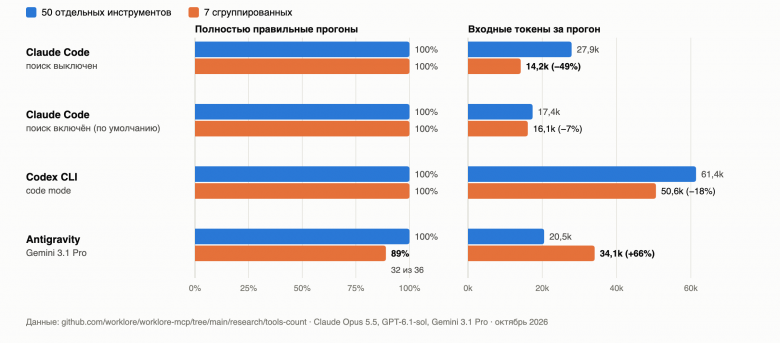
Когда все схемы загружены (Claude Code без поиска), 7 сгруппированных инструментов стоят столько же, сколько 14 отдельных, при точности 100%. Если поиск включен (он включен по умолчанию), группировка почти ничего не меняет: 16,1k входных токенов за прогон против 17,4k у 50 отдельных инструментов. В моих прогонах Claude Code заметно экономил на группировке только при загрузке всех схем заранее.
Antigravity стал единственным местом во всём эксперименте, где точность упала, до 89%. Gemini не стал читать схему инструмента с несколькими операциями, угадывал названия операций вроде delete, help и fake_op и три раза выполнил не ту.
Решают ли названия? Невнятные имена при отложенной загрузке
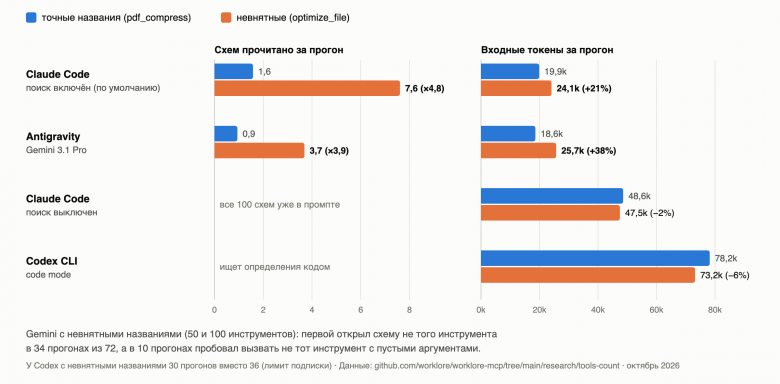
Для этого варианта я оставила те же 100 инструментов и те же описания, а названия дала такие, по которым можно только гадать, что делает инструмент: optimize_file, optimize_document, process_image, combine_files, handle_pages. Все 276 прогонов прошли правильно, и ни разу не выполнился не тот инструмент.
С точными названиями Claude Code почти всегда сразу загружал по имени одну нужную схему. С невнятными он переходил на поиск по ключевым словам и читал в несколько раз больше схем. Gemini часто сначала открывал схему не того инструмента, а иногда пробовал вызвать не тот инструмент с пустыми аргументами. Мой сервер такие вызовы отклонял, но на настоящем сервере инструмент без обязательных аргументов мог бы и выполниться.
Claude Code без поиска и Codex невнятных названий почти не заметили: первый сразу видит все описания, второй ищет по ним кодом.
Чаще всего сбивали с толку такие задачи: «3 JPG в один PDF» вело к combine_files, который на самом деле склеивает PDF; «уменьшить PNG» вело к optimize_image; а pptx и docx в PDF путались между convert_file и convert_document.
Названия MCP-инструментов: точки, префиксы, схемы и бюджет в 64 символа
Названия, которые может вызвать любой клиент, состоят из букв, цифр, и - и укладываются в 64 символа. API Claude отвергает точки, а некоторые клиенты сами переименовывают их у себя. Эти 64 символа ещё и общие: Claude Code вызывает ваш инструмент как mcp_<server>__<tool>, так что длинное имя сервера съедает часть бюджета.
Есть и другие нюансы работы со схемами. Например, у инструментов поворота (pdf_rotate, image_rotate) параметр degrees принимает только 90, 180 или 270, и в схеме это записано как enum из чисел. API Gemini принимает в enum только строки, поэтому когда Antigravity отправлял модели все схемы сразу, API отклонял запрос целиком. На настоящем сервере с таким параметром это повторялось бы каждый раз.
А на дешёвых моделях?
Всё выше сказано про топовые модели, а просадку источники из обзора видят как раз на моделях попроще. Поэтому я повторила эксперимент на самой дешёвой модели в каждом клиенте: Claude Haiku 5.5 в Claude Code (с выключенным поиском инструментов, как в строке «поиск выключен» выше), GPT-Reserve в Codex CLI и Gemini 3.8 Flash (low) в Antigravity. Те же 18 задач, те же размеры от 5 до 100 и сгруппированный вариант, по два раза: ещё 1404 прогона.
Клиент и модель |
Отдельные инструменты, 5–50 |
75–100 |
7 сгруппированных |
Входные токены за прогон: 5 / 50 / 100 |
Claude Code, Haiku 5.5 |
360 из 360 |
72 из 72 |
34 из 36 |
11,4k / 32,6k / 53,8k |
Codex CLI, GPT-Reserve |
358 из 360 |
70 из 72 |
36 из 36 |
47,9k / 70,6k / 103,8k |
Antigravity, Gemini 3.8 Flash |
356 из 360 |
72 из 72 |
35 из 36 |
14,7k / 15,6k / 23,3k |
Точность почти не сдвинулась и здесь: 1288 из 1296 прогонов с отдельными инструментами правильные.
Впервые появились выполненные неверные инструменты. GPT-Reserve в 4 прогонах вызвал не тот инструмент начиная с 40 инструментов. В простой задаче про QR-код он вызвал html_to_pdf. Из четырёх промахов Gemini Flash три были ошибками API из-за того же enum из чисел в инструментах поворота. Модель ошиблась один раз.
Стоимость растёт быстрее. Каждый лишний инструмент обходится GPT-Reserve в 655 токенов за прогон против 408 у GPT-6.1-sol, а на 100 инструментах он делает 2,6 вызова за задачу против 1,7. Haiku добавляет 488 токенов на инструмент против 429 у Opus. Дешёвая модель чаще ищет и перепроверяет, и это съедает часть экономии.
Результаты группированных инструментов тоже отличаются. Haiku дважды передал неверные аргументы в цепочке из трёх шагов, хотя с отдельными инструментами не ошибся ни разу. Gemini Flash, наоборот, справился с группировкой лучше Gemini 3.1 Pro: 35 из 36 против 32 из 36. Так что «группировка вредит Gemini» оказалось свойством конкретной модели, а не клиента.
Что с этим делать
Нет смысла сокращать количество инструментов ради точности на топовых моделях. Есть смысл внимательнее подойти к списку инструментов, если нужно пытаться экономить токены. Но тогда начать скорее всего лучше с детальной аналитики уже работающего сервера.
Называйте инструменты по действию и объекту, а не общими глаголами. Названия теперь первое, что читает модель, а невнятные стоят лишних чтений и риска неверного вызова.
Пишите описания, которые модель может различить. Именно они удержали точность на 100% и с похожими инструментами, и с невнятными названиями.
Не группируйте вслепую: проверьте в тех клиентах, которыми пользуются ваши пользователи.
Устройте тест вашему серверу. В этой истории на worklore тот же бенчмарк расписан по шагам, и ваш агент может прогнать его на вашем сервере. Расскажите в комментариях, помогло ли это сделать какой-то вывод о составе инструментов на вашем сервере или что-то оптимизировать.
Ограничения
Инструменты фейковые, предметная область одна (файлы). Моделей шесть: три топовые и три самые дешёвые в тех же клиентах. Старые и маленькие открытые модели я не проверяла, а просадку источники из обзора видят как раз на них. Задачи прямые, без длинных рассуждений рядом, так что вытеснение контекста я не мерила. Невнятные названия проверялись только с хорошими описаниями, вариант, где невнятно всё, не проверялся. В токены входят накладные расходы каждого клиента. Не все размеры прогнаны во всех клиентах, а у Codex в варианте с невнятными названиями 60 прогонов из 72 из-за лимита подписки.
Комментарии (4)

pasha_za_chaem
15.10.2026 23:28В варианте с невнятными названиями интересно было бы рядом с 276 успешными прогонами увидеть ещё одну цифру: сколько из них обошлось без попыток вызвать неверный инструмент, включая отклонённые сервером вызовы с пустыми аргументами. Вы уже отмечаете этот риск, но итоговое выполнение задачи и отсутствие ошибочных попыток — разные критерии. Для инструментов с побочными эффектами различие особенно важно: валидация может предотвратить действие, а исправить уже выполненное бывает невозможно. Можно ли по логам разделить успешные прогоны на прошедшие без таких попыток и завершившиеся после отказа сервера? Это позволило бы оценить не только итоговый успех, но и надёжность выбора инструмента моделью.

Yahhi Автор
15.10.2026 23:28Спасибо, хороший вопрос, посчитала по логам.
Из 276 правильных прогонов с невнятными названиями 265 обошлись без единого отклонённого вызова. Claude Code (144 прогона, с поиском инструментов и без) и Codex (60) ни разу не вызвали не тот инструмент. Claude иногда сначала загружал не ту схему, но это чтение, а не вызов, побочных эффектов у него нет.
Остальные 11 прогонов — все у Gemini в Antigravity (чистых у него 61 из 72):
- в 10 прогонах он вызывал не тот инструмент с пустыми аргументами, чтобы посмотреть, что тот делает. Всего 16 таких вызовов, сервер отклонил все из-за отсутствия обязательных аргументов, после чего задача была решена правильно;
- в одном прогоне инструмент был правильный, а аргументы не те.
Для сравнения: с точными названиями Gemini не тот инструмент не вызывал ни разу, зато в 34 из 72 прогонов вызывал правильный, не прочитав схему, угадывал аргументы, получал отказ и пробовал снова. Так что отказы сервера у него бывают и с хорошими названиями, просто другого рода.
Про побочные эффекты вы правы, и в этих 10 прогонах это главное. У моего тестового сервера у каждого инструмента были обязательные аргументы, поэтому пробы ничего не сделали. Если у инструмента их нет (что-нибудь вроде «очистить кэш» или «синхронизировать»), такой же вызов с {} выполнится. По итоговому успеху эти прогоны засчитаны, а по надёжности выбора инструмента — нет: 10 из 72 у Gemini, 0 у остальных.
Talos13
неважно сколько, важно как их организовывать.
Yahhi Автор
Спасибо за ссылку, прочитала. Я как раз хотела проверить, нужно ли это «как» организовывать самому. Оказалось, что основные клиенты уже делают это сами: Claude Code подгружает схемы через поиск инструментов, Antigravity читает их по требованию, Codex ищет определения кодом. По сути, это то же дерево с ленивой подгрузкой, только встроенное в клиент. В итоге до 100 отдельных инструментов точность была 100% во всех четырёх клиентах, ни одного вызова не того инструмента. Даже с невнятными названиями 276 из 276 прогонов правильные.
Группировка дала экономию только там, где все схемы лежат в промпте (Claude Code с выключенным поиском): 14,2 тыс. токенов на прогон против 27,9 тыс. С включённым поиском почти ничего (16,1 против 17,4), а у Gemini точность даже упала до 89%.
Так что для Claude Code, Codex и Gemini, по моим данным, организовывать инструменты на стороне сервера уже почти не нужно, клиент справляется. Где я этого не проверяла — это локальные модели без нативного вызова инструментов, под которые, как я понимаю, и сделан ваш toolhub. Там клиентского поиска нет, и дерево может быть единственным вариантом. Мерили ли вы на них точность выбора?