

Наша программа для диктовки Glas работает на GigaAM-v3. С обычной русской речью модель справлялась хорошо, а на IT-терминах спотыкалась. Docker превращался в «докер», Python — в «Пайтон». Иногда исчезали целые слова: живую фразу «Мой ИИ редко ошибается» модель записала как «Мои редко ошибается».
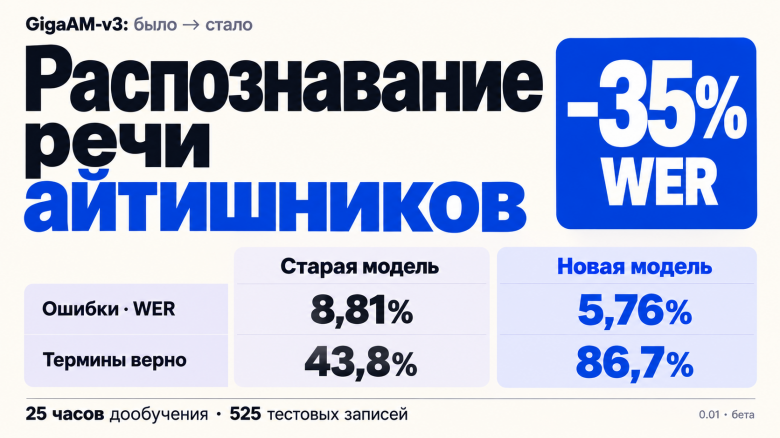
Мы дообучили рабочую модель на 25 часах живой речи. На 525 отложенных коротких записях WER снизился с 8,81% до 5,76% — примерно на 35% относительно исходного значения. Доля правильно написанных терминов выросла с 43,8% до 86,7%. Скорость почти не изменилась.
Это версия 0.01, пока бета. Есть и ухудшения: модель чаще пропускает слова, а на обычной речи хуже воспроизводит регистр и пунктуацию. К тому же тест размечен тем же автоматическим конвейером, что и обучение, с выборочной ручной проверкой. Часть выигрыша может объясняться совпадением стиля разметки.
Что хотели исправить
GigaAM-v3 — семейство моделей распознавания речи на Conformer. Мы используем v3_e2e_rnnt: она сразу выдаёт текст с регистром и пунктуацией. На сервере энкодер работает в FP16, RNNT-голова — в FP32. Длинные записи режет по паузам Silero VAD, короткие сегменты распознаются пачками. Декодирование жадное, без внешней языковой модели; GPU — RTX A2000 12 ГБ.
Нас интересовали три группы ошибок: английские названия, освоенные англицизмы вроде «дашборд» и аббревиатура «ИИ». Словарь замен помог бы лишь частично. Один Kubernetes в тестах превращался в «Кьюбернит», «Куберните», «кубернетис», «Gubernitis» и «Qubernit». А отличить «ИИ» от затянутого союза «и» по одному тексту бывает трудно — нужен звук.
Менять токенизатор не пришлось: его словарь на 1024 токена уже содержит латиницу, и нужные названия кодируются без <unk>. Мы решили сохранить архитектуру, код модели и формат весов, чтобы дообученную версию можно было поставить на место прежней.
Первая попытка: хороший результат на плохом тесте
Сначала взяли CTC-вариант GigaAM и собрали 4,4 часа данных: около 1100 синтетических фраз с IT-терминами и примерно столько же записей из русской и английской частей FLEURS. Заморозили нижние 12 слоёв энкодера, обучали верхние четыре и CTC-голову.
На стенде из 12 синтетических фраз доля правильно написанных терминов выросла с 6% до 86%. Но сравнение с рабочей RNNT на 150 живых записях FLEURS выглядело иначе:
FLEURS ru, 150 живых записей |
Прод (RNNT) |
Дообученная CTC |
|---|---|---|
WER без пунктуации |
4,65% |
5,39% |
WER с регистром и пунктуацией |
9,69% |
28,75% |
Модель потеряла регистр и пунктуацию. В скрипте подготовки данных мы взяли transcription — нормализованный текст — вместо raw_transcription. Эти поля описаны в карточке FLEURS. Ни в одном из 150 ответов дообученной CTC не было заглавной буквы и точки.
К этому добавились «deadloin» вместо «дедлайн» и слабое распознавание терминов с русским акцентом. От модели отказались. Для следующей попытки выбрали рабочую RNNT той же ревизии, живую речь и проверку с учётом пунктуации. Ещё до разметки договорились, как писать термины.
Как собрали и разметили данные
Короткие записи отбирали по текстам исходной модели: искали латиницу, варианты терминов из глоссария и похожие транслитерации. Добавили обычную речь и публичные IT-подкасты. Дикторов короткого теста отложили целиком; для проверки подкастов взяли отдельный выпуск, которого не было в обучении.
Набор |
Записей |
Часов |
Состав |
|---|---|---|---|
Обучение |
10 071 |
25,1 |
8 301 короткая запись, 1 770 сегментов подкастов |
Валидация |
290 |
0,7 |
те же источники |
Тест «короткие записи» |
525 |
1,3 |
отложенные дикторы |
Тест «подкаст» |
57 |
0,2 |
подкаст, которого нет в обучении |
Тест «известное» |
318 |
0,7 |
150 записей FLEURS, 168 синтетических фраз |
В обучающем наборе синтетики не было. Глоссарий содержал 126 терминов с правильными написаниями и типичными ошибками. Правила разметки задали отдельно:
Что |
Как пишем |
Примеры |
|---|---|---|
Продукты, технологии, компании, форматы, аббревиатуры |
латиницей |
Docker, PostgreSQL, Jira, CRM, API |
Освоенные заимствования, которые склоняются |
кириллицей |
дедлайн, релиз, деплой, бэкенд, дашборд |
Глаголы от англицизмов |
кириллицей |
задеплоить, закоммитить, зашарить |
Падеж у латинского названия |
не пишем |
«в Докере» → «в Docker» |
Российские названия и аббревиатуры |
кириллицей |
Яндекс, Сбер, ВОЗ, ИИ |
Английское «эй-ай» |
латиницей |
AI |
Составные с «ИИ» |
через дефис |
ИИ-агент, ИИ-ассистент |
Запинки |
не пишем |
«э-э», «м-м», протяжное «и-и-и» → «и» |
Две расшифровки и аудиокорректор
Все 25 часов вручную не расшифровывали. Каждую запись обрабатывали GigaAM и Whisper large-v3-turbo. В наших проверках первая лучше сохраняла русский текст и пунктуацию, вторая — английские названия. Whisper запускали дважды: во второй проход передавали подсказку с терминами-кандидатами.
За основу брали текст GigaAM и заменяли участки с терминами вариантом Whisper. Запись получала статус ok, dispute или drop. Сначала разногласия отдавали текстовой LLM, но она выбирала правдоподобную фразу, не слыша записи. Перешли на мультимодальную модель: давали ей аудио и обе расшифровки, просили исправить расхождения.
На 132 синтетических записях с известным текстом такой корректор получил WER 4,8% и 94,6% правильных терминов. Это проверка конвейера на синтетике, а не оценка качества всей живой разметки. Две гипотезы помогают ограничить выдумки, но не исключают их.
Обычные записи, где GigaAM и Whisper соглашались, не отправляли в LLM. Ответы корректора с fuzz.ratio < 45 относительно гипотезы GigaAM отбрасывали и повторяли запрос: сильное расхождение могло означать выдуманный текст или перепутанный файл. Такой фильтр тоже не доказывает, что оставшаяся метка верна.
В конце убирали запинки, приводили названия и дефисы к общим правилам, отбрасывали записи с <unk>. Разметку проверяли вручную выборочно.
Как дефис испортил метрику «ИИ»
Для «ИИ» считали и долю найденных вхождений, и лишние срабатывания. Первые замеры показали девять лишних «ИИ» у новой модели против нуля у исходной. Разобрали примеры: шесть из девяти оказались расхождениями «ИИ-агент» и «ИИ агент». Подсчёт по словам принимал разницу в дефисе за ошибку распознавания.
Унифицировали написание составных слов в обучении и тесте, а счётчик научили видеть «ИИ» внутри «ИИ-агент». Для обучения набралось 278 записей-кандидатов, для теста — 132. В зависимости от варианта обучения после исправления оставалось от одного до трёх лишних «ИИ» на 525 коротких записей.
Как обучали RNNT
GigaAM-v3 опубликована под MIT: эта лицензия допускает модификацию, включая дообучение, и коммерческое использование. Публиковать свои дообученные веса она не обязывает; в копиях модели и кода нужно сохранять уведомление об авторских правах и текст лицензии. MIT указана в карточке используемого варианта e2e_rnnt, условия — в официальном репозитории.
Обучали на одной арендованной A100 40 ГБ, в PyTorch. Модель загружали через AutoModel с trust_remote_code, использовали torchaudio.functional.rnnt_loss.
В выбранном варианте заморозили препроцессор, субдискретизацию и первые десять слоёв энкодера. Обучались верхние шесть слоёв и RNNT-голова — 83,4 млн из 222,5 млн параметров. Первые 200 шагов обновляли только голову.
Параметры обучения:
AdamW: базовый learning rate 1·10⁻⁴, для энкодера — в пять раз меньше; weight decay 1·10⁻³;
линейный прогрев 300 шагов, затем косинусное снижение до 10% базового learning rate;
FP16 с
GradScaler, обрезка градиента по норме 1,0;SpecAugment: две частотные маски до 10 полос и две временные до 4% длины;
четыре эпохи, 1332 шага; чекпойнт выбирали по WER на валидации.
Две детали потребовали отдельного внимания.
Размер батча. В нашей реализации материализуется тензор логитов B × T × (U+1) × V, где T — число кадров энкодера, U — длина текста в токенах, V = 1025 с учётом blank. Поэтому памяти может не хватить даже на короткие записи, если текст длинный. Батчи ограничивали и по суммарной длительности — 400 секунд, и по размеру тензора — 8·10⁸ элементов.
Первый вход предсказателя. При штатном декодировании GigaAM начинает с нулевого эмбеддинга. Обучение должно начинаться так же. Ниже фрагмент нашего кода, зависящий от внутреннего устройства модели:
def joint_logits(inner, encoded, targets, blank):
    dec, joint = inner.head.decoder, inner.head.joint
    sos = torch.full((targets.size(0), 1), blank, dtype=torch.long, device=targets.device)
    emb = dec.embed(torch.cat([sos, targets.long()], 1))   # blank → нулевой эмбеддинг
    g, _ = dec.lstm(emb.transpose(0, 1))
    f = joint.enc(encoded.transpose(1, 2))
    p = joint.pred(g.transpose(0, 1))
    return joint.joint_net(f.unsqueeze(2) + p.unsqueeze(1))  # (B, T, U+1, V)
После обучения сверяли ключи весов с исходным файлом и сохраняли каждый тензор в прежнем типе: энкодер FP16, голова FP32. config.json, код модели и токенизатор оставили без изменений.
Всего сравнили три варианта. Выбрали C: десять замороженных слоёв и меньший learning rate энкодера. Он дал одно лишнее «ИИ» вместо трёх у A и B, но распознал 93,5% эталонных «ИИ» против 95,4% у A. Для диктовки мы сочли ложное срабатывание более неприятной ошибкой.
Как проверяли
Сначала проверили сам код оценки на исходной модели. Он должен повторять серверный конвейер: лог-мел признаки считаются отдельно для каждой записи, затем дополняются нулями; энкодер работает в FP16, голова — в FP32; декодирование штатное.
В среде обучения с ответами рабочего сервиса совпали 513 текстов из 525, на прод-сервере — 524 из 525. Полного совпадения не получили, поэтому итоговое сравнение обеих моделей провели на одном сервере, с одинаковыми GPU, PyTorch и кодом распознавания.
Считали четыре показателя:
WER — доля замен, пропусков и вставок относительно числа слов в эталоне; перед подсчётом убирали регистр и пунктуацию, заменяли «ё» на «е».
WER e2e — тот же расчёт без этой нормализации.
Термины — доля латинских терминов из глоссария, записанных точно как в эталоне.
«ИИ» — доля распознанных вхождений и отдельный счётчик лишних.
Эталоны получены тем же конвейером, что и обучающие метки. Поэтому модель могла улучшить метрику, переняв его стиль: например, перестать писать запинки и тире перед репликами. Отложенные дикторы защищают от пересечения голосов, но не устраняют эту зависимость разметки.
Результаты и цена улучшения
Здесь «прод» — исходная модель, «новая» — выбранный вариант C. Все значения получены на прод-сервере.
Набор |
Метрика |
Прод |
Новая |
|---|---|---|---|
Короткие записи, 525 |
WER |
8,81 |
5,76 |
WER e2e |
10,54 |
8,83 |
|
Термины, % |
43,8 |
86,7 |
|
«ИИ», % |
72,5 |
93,5 |
|
Лишние «ИИ» |
0 |
1 |
|
Подкаст (не было в обучении), 57 |
WER |
5,03 |
3,06 |
WER e2e |
7,90 |
5,52 |
|
Термины, % |
44,4 |
100 |
|
FLEURS ru, 150 |
WER |
5,43 |
5,04 |
WER e2e |
9,58 |
9,41 |
|
Чистая русская речь (синтетика), 36 |
WER / WER e2e |
2,92 / 5,01 |
2,92 / 5,01 |
Скорость |
секунд на секунду аудио |
0,0339 |
0,0342 |
Память GPU |
пик, МиБ |
874 |
874 |
В этом замере обе модели обрабатывали минуту аудио примерно за две секунды. Одинаковая архитектура сама по себе не гарантирует одинаковую скорость — её мы измерили отдельно.
На 194 обычных коротких записях WER улучшился с 6,46% до 6,01%, а WER e2e ухудшился с 7,84% до 8,56%. Значит, выигрыш в словах сопровождался ухудшением по метрике, учитывающей регистр и пунктуацию.
На всех трёх группах теста суммарно стало на 19 пропущенных слов больше — примерно на 14 тысяч слов эталона. На коротких записях вставки сократились со 151 до 38, замены — с 464 до 325, но пропуски выросли с 85 до 95. Снижение вставок отчасти связано с тем, что модель перестала воспроизводить запинки, которых нет в эталоне.
Редкие названия остаются проблемой. На 48 синтетических фразах с редкими терминами доля правильных написаний выросла лишь с 4,9% до 12,3%. Этот тест отличается от живой речи, но показывает: дообучение не сделало модель надёжной на всех словах из глоссария.
Что слышно на живых записях
Эти фразы надиктовали в Glas после выкладки. Затем те же записи прогнали через прежнюю модель; в основной тест они не входят.
Сказано |
Прежняя модель |
Новая (0.01) |
|---|---|---|
Мой ИИ редко ошибается. |
Мои редко ошибается. |
Мой ИИ редко ошибается. |
Промты для ИИ могут быть разные. |
Промты для могут быть разными. |
Промты для ИИ могут быть разные. |
Хорошие промты для ИИ отличаются точностью и краткостью. |
Хорошие пранты для ИИ отличаются точностью и краткостью. |
Хорошие пранты для ИИ отличаются точностью и краткостью. |
Обнови конфиг Nginx и перезапусти Docker. |
Обнови Config Jinks и перезапусти докер. |
Обнови Confly Jings и перезапусти Docker. |
Обнови конфиг Nginx и перезапусти Docker. (второй дубль) |
Обнови Config Jins и перепусти дакер. |
Обнови Configins и перепусти Ducker. |
В первых двух фразах новая модель вернула пропущенное «ИИ». В третьей обе сохранили «ИИ» и обе ошиблись в слове «промты». Nginx не распознала ни одна; Docker новая модель записала правильно только в одном из двух дублей.
Есть и более неприятные ошибки. Ниже — примеры из публичного подкаста и синтетических записей; ответы моделей оставлены как есть.
Эталон |
Прод |
Новая |
Что случилось |
|---|---|---|---|
Какой-нибудь современный SOC или задачи ИБ… |
…современный Сока или задачи ИБ… |
…современный SOC или задачи ИИ… |
SOC исправлен, но «ИБ» стало «ИИ» — ложное срабатывание |
…зловредных файлов. Антифрод туда же. |
…зловредных файлов. Антифрод туда же. |
…зловредных файлов туда же. |
пропущено слово |
На staging всё работает, а на production почему-то падает health check. |
…падает Hells Check. |
…падает health. |
половина термина пропала |
Мы сделали апдейт приложения и выложили его в стор. |
Мы сделали апдит… |
Мы сделали аудит… |
ошибка со сменой смысла |
Задачу я завёл в Jira, а описание положил в Confluence. |
…в джира… |
…в GRA… |
было понятно — стало хуже |
Да? Закрываем контору. Ну нет, конечно же. |
— Да? Закрываем кат. — Ну, нет, конечно же. |
Да? Закрываем кат. Ну, нет, конечно же. |
пропали тире перед репликами. По метрике это не ошибка — в эталонах тире нет, — но читать диалог стало труднее |
Как заменили модель на сервере
Дообученные веса мы не публикуем. Сервер берёт их из закрытой папки и сверяет SHA-256 файлов. Новую версию разместили в отдельном Docker-томе, старый сохранили для отката.
Перед переключением обе модели проверили в отдельном контейнере, не подключённом к очереди. Кроме тестовых наборов, прогнали тишину, шум и запись длиной 73 секунды. Тишину и шум отсеял VAD — это проверка всего конвейера, а не доказательство, что сама модель никогда не выдаёт на них текст.
Воркеры переключали по одному: дождаться освобождения, перезапустить на новом томе, проверить типы весов и пробное распознавание. При неудаче скрипт возвращал прежний образ и том. Метку версии добавили в ответ API и журнал, чтобы связывать жалобы с конкретной моделью.
Перед выкладкой обнаружилась отдельная проблема: после автоматического обновления драйвера NVIDIA новые GPU-контейнеры не запускались, хотя старые работали. Устранение заняло две с половиной минуты остановки распознавания ночью при пустой очереди. Поэтому всю подготовку к релизу назвать работой без простоя нельзя. Проверку запуска нового GPU-контейнера оставили обязательным шагом перед переключением воркеров.
Качество на живом потоке автоматически не посчитать без эталонных текстов. Для него собираем отзывы и разбираем присланные записи.
Что исправляем дальше
Сейчас приоритет — обычная речь с выверенной пунктуацией и примеры пропусков слов. Также собираем живые записи с редкими терминами: в текущем наборе даже «промты» встретились лишь в 42 записях из 10 071.
Первый прогон показал, сколько решений скрывается в разметке. Удалять ли запинки, как писать «ИИ-агент», сохранять ли тире в диалоге — всё это влияет и на поведение модели, и на оценку её качества. Прежде чем расширять датасет, нужно проверить, чему именно мы её учим.
Протестить работу новой модели можно в программе Glas, там никакие карты вводить не надо и 2 000 слов в неделю бесплатно.