

Я – Мигаль Денис, руковожу командой EMM в MAGNIT TECH. Последние годы больше занимаюсь архитектурой и командой, чем сам пишу код. Здесь решил проверить, смогу ли с помощью продвинутой ИИ-модели разобраться с совершенно незнакомым Rust и довести сложный инфраструктурный компонент на 300.000 устройств до серьёзных испытаний. Причём так, чтобы за результат не было стыдно перед разработчиками.
Внутри статьи
Почему понадобился свой прокси и как план Б стал планом А
В системе управления устройствами BS (LwM2M Bootstrap), RS (LwM2M Registration Service) и DS (LwM2M Device Management Service) сейчас работают в Kubernetes в отдельных pod’ах, по одному экземпляру каждой службы. Поднять дополнительные pod’ы можно, но в используемой облачной инфраструктуре нет подходящего механизма UDP-балансировки с сохранением длительных DTLS-сессий. Без него горизонтальное масштабирование этих служб невозможно.
Прежде чем писать своё решение, я проверил готовые варианты. Обычные UDP-прокси, включая Envoy, в типовой конфигурации ориентируются на сетевые адреса и порты, а нам требовалось сохранять привязку DTLS-сессии к серверу даже при смене адреса устройства. У Scandium есть близкий механизм кластеризации, но он встроен в Java-стек и не заменяет прозрачный прокси перед существующим сервером. Проверил и управляемые балансировщики российских облаков – Yandex Cloud, Selectel, Cloud.ru и MWS. Обычная UDP-балансировка у таких провайдеров может быть, но готовой маршрутизации по DTLS Connection ID с нужным нам поведением сессий в изученной документации я не нашёл. Поэтому собственный прокси понадобился не вместо уже существующего подходящего продукта, а для задачи, которую типовая балансировка UDP не решала.
Команда оценила разработку собственного прокси и функциональные тесты примерно в четыре спринта – 12 недель работы разработчика и тестировщика. Облачное внедрение в эту оценку не входило. Свободного старшего разработчика под задачу не было, а откладывать работу над новым контуром не было возможности. У нас уже был прототип на Go, а сам язык я знал.
Мой план Б был простым: с помощью ИИ быстро подготовить прототип и передать его разработчику. После первых итераций я увидел, что могу сам разбирать ошибки, обсуждать исправления и запускать проверки. Передавать заготовку сразу стало не нужно – так план Б превратился в план А.
Почему Rust, если Go уже работал
Сама идея осталась рискованной: неизвестный мне язык, сетевой компонент и требования, по которым нельзя сделать скидку на способ написания кода. Для эксперимента я сознательно выбрал Rust, которого совсем не знал. Продолжая на Go, я опирался бы на имеющийся опыт, а мне было интересно, смогу ли с помощью ИИ исправлять ошибки и развивать инфраструктурный компонент на незнакомом языке. Сравнивать производительность Rust и Go я не пытался. При этом в команде нет Rust-разработчиков: коллеги параллельно делают Kotlin-версию на нашем основном стеке, чтобы разобраться в компоненте и снизить зависимость от отдельных специалистов. Ей ещё предстоят собственные испытания.
Что прокси должен был делать
Прокси должен сохранять привязку длительной DTLS-сессии к нужному серверу, даже когда устройство меняет сетевой адрес или разные пакеты попадают на разные экземпляры прокси. Кроме того, серверу нужен исходный адрес клиента. То есть задача была сложнее обычной пересылки UDP-пакетов.
Я сразу записал главный тест: отправляю пакеты одного устройства через разные реплики прокси – и каждый раз должен выбираться один и тот же сервер. Позже именно на этом тесте первая архитектура и сломалась.
От чата до готовности к нагрузочным испытаниям
Сначала всё делал через чат с продвинутой ИИ-моделью: описывал требования, получал код, запускал его и возвращался с ошибками. Потом подключил OpenCode и ассистента в VS Code. Вместо копирования кусков кода между чатом и редактором я мог править файлы и запускать тесты в самом проекте.
Первый локальный запуск прошёл: пакет доходил до сервера. Правда, пока работал один экземпляр прокси, было непонятно, куда попадёт тот же клиент при переключении на другую реплику.
Первый запуск ещё ничего не гарантировал
Для начала я поднял несколько независимых реплик и добавил тесты, которые гоняли через них трафик одного клиента. Затем подключил Scandium – стороннюю реализацию DTLS, чтобы не проверять прокси исключительно собственными заглушками. После этого пришлось не раз переделывать и код, и тестовый стенд. Каждый найденный баг воспроизводил, исправлял и проверял снова. Так я и дошёл до версии, готовой к нагрузочному тесту в облаке.
Со временем перестал писать модели «почини прокси». Гораздо полезнее было показать конкретную ошибку: как воспроизвести, что ожидал увидеть и что получилось в логах. Один такой разбор неожиданно привёл к решению, которое я сам тогда не нашёл.
Где ломались прокси, стенд и выпуск
Две ошибки, которых не было видно на одном прокси
Первая версия хранила информацию о выбранном сервере в памяти конкретной реплики. Пока клиент попадал на неё же, всё работало. Но стоило балансировщику отправить пакет другой реплике – и устройство могло оказаться на другом сервере. Я показал модели воспроизводимый пример. Она предложила поменять подход: все реплики должны выбирать сервер одинаково, без общего состояния. После исправления я проверил это на разных экземплярах прокси – маршрут больше не прыгал. Тут я действительно удивился: сам до такого варианта тогда не дошёл. С тех пор стал внимательнее относиться к архитектурным предложениям модели, но не считать их правильными без тестов.
Потом сервер начал принимать пакеты и отвечать, а клиент по-прежнему молчал. На этот раз Rust был ни при чём: я ошибся в настройке локального стенда на Podman, опубликовав служебный UDP-порт прокси на хосте. Из-за этого ответный трафик шёл не туда. Я убрал публикацию порта и добавил проверку, чтобы больше не наступать на те же грабли.
Когда сломался сам тестовый стенд
Отдельная история случилась с тестами на Scandium. Один клиент подключался нормально, а когда я запускал несколько одновременно, тесты начинали падать. Виноват оказался не Rust-прокси и не Scandium, а написанная для стенда UDP-прослойка: она пересылала пакеты между клиентами и сервером и путала их состояние при параллельных подключениях. Пока я гонял клиентов по одному, проблему было не видно.
Пришлось чинить эту UDP-прослойку и отдельно прогонять тесты с несколькими клиентами. Урок оказался неприятным: даже если взял независимую реализацию протокола, собственный стенд всё равно может врать. Теперь я проверяю и тестовый код, а не только код прокси.
Прокси работал, а выпуск всё равно не проходил
Сетевые тесты проходили, но при сборке релизного архива всплыли совсем другие проблемы: не хватало обязательных документов, в них ломались ссылки, а права на файлы PKCS#12 после упаковки менялись с 0600 на 0644. Прокси от этого не переставал пересылать пакеты, зато закрытые ключи оказывались доступнее, чем должны. Такой релиз я принимать не собирался.
После этого я добавил проверки уже собранного архива – не только исходников. И отдельно прописал в правилах для ИИ-агента: нельзя обходить упавшие тесты, исключать неудобные сценарии или ослаблять проверки ради зелёного отчёта.
Как я проверял результат
Проверять не только код, но и результат
Сборка, юнит-тесты и Clippy помогают находить ошибки в Rust-коде. Я добавил к ним отдельные тесты на Python, которые проверяли поведение прокси со стороны клиента. Это принципиальный момент: если тест повторяет алгоритм программы, он может вместе с ней ошибаться.
В итоге у меня получилось шесть уровней проверок:
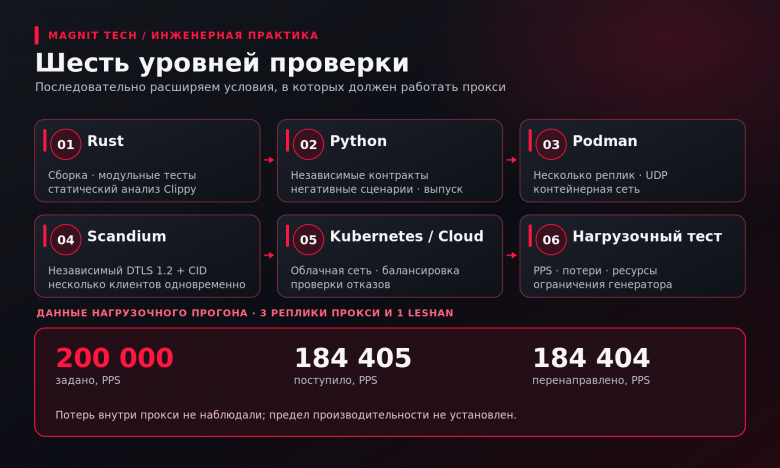
Эти проверки не заменяют, а усиливают друг друга. Успешная сборка ещё ничего не говорит о работе с настоящим DTLS-клиентом, а локальный запуск — о поведении за облачным балансировщиком. Если обязательный тест падал, дальше я не шёл.
Что означала строка «190 passed»
Одна из сводок тестов выглядела так:
190 passed
5 failed
1 skipped
5 deselected
На первый взгляд – 190 пройденных тестов. Но рядом пять упавших, один пропущенный и ещё пять не выбранных для запуска. В таком состоянии релиз не готов. Причины ошибок нужно разобрать, а не спрятать за красивой цифрой passed.
Для истории с PKCS#12 я отдельно проверял права доступа в готовом архиве. Пример ниже упрощённый – это не дословный фрагмент моего проекта:
import stat

def test_pkcs12_permissions(release_dir):
    keys = list(release_dir.rglob("*.p12"))
    assert keys, "нет PKCS#12 в проверяемом пакете"
    for path in keys:
        assert stat.S_IMODE(path.stat().st_mode) == 0o600, path
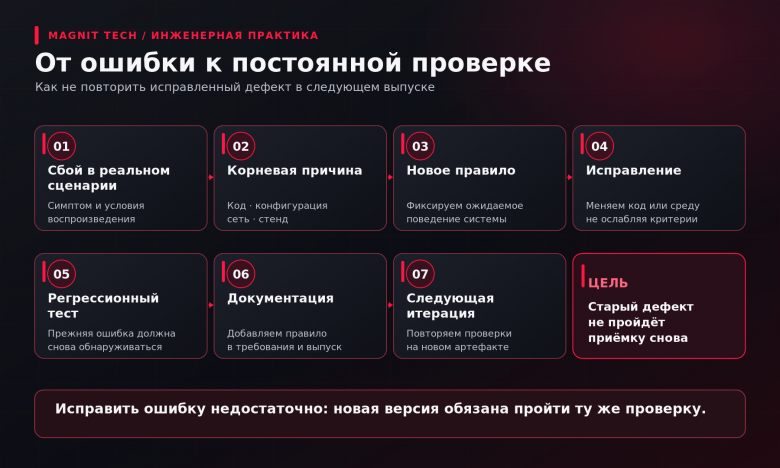
Был и ещё один полезный приём: я специально возвращал найденный баг и проверял, падает ли тест. Если нет, чинить нужно сам тест.
Что показала нагрузка
После подготовки версии к нагрузке пришлось потратить ещё два дня на прогон в Yandex Cloud, разбор результатов и отчёт. Проверялись три реплики прокси. Генератору нагрузки задали 200 тысяч UDP-пакетов в секунду (PPS), но фактически на вход пришло в среднем 184 405 пакетов/с, а дальше прокси передал 184 404 пакета/с. Потерь и ошибок ввода-вывода на стороне прокси в этом тесте не зафиксировано. При попытке увеличить нагрузку поток начал упираться в ограничения генератора, так что предельную производительность самого прокси не измерили, но полученных результатов уже достаточно для понимания возможностей масштабирования.
Как закрепить результаты перед облачным выпуском
Каждый серьёзный баг я фиксировал не только в коде, но и в тестах и базе знаний: что произошло, как воспроизвести и по чему понять, что проблема вернулась. Проверки при этом должны относиться к конкретной версии кода и собранного архива. На второй схеме – цикл, который у меня в итоге сложился.
Что я оставил за собой
Поначалу я сам прогонял тесты и разбирал отчёты. Когда проверки стали воспроизводимыми, начал запускать рутинные действия через OpenCode: внести правку, выполнить тесты, собрать логи. Это инструмент автоматизации, а не второй разработчик в команде.
Менять архитектуру или выпускать новую версию решал я. И смотрел не только на зелёный отчёт, но и на список тестов, которые действительно запускались.
Что изменилось в моей работе
Проект неожиданно вернул меня к тому, за что когда-то полюбил разработку: разбираться, почему что-то не работает и находить решение. Rust-разработчиком за несколько десятков часов я, конечно, не стал, но смог сам пройти путь от требований до независимых тестов компонента на незнакомом языке.
Если хотите повторить: четыре правила
Отделяйте результат исполнения от доказательства: важные контракты проверяйте независимо от того, кто написал код.
Рано подключайте настоящую реализацию протокола, а не только имитатор, который повторяет ваши предположения.
С первого дня записывайте, какие тесты обязательны и при каком результате нужно остановиться. Храните их вместе с версией кода и образов.
Через агента удобно запускать рутину — правку кода, тесты, сбор логов. Решать, какую архитектуру выбрать и можно ли выкатывать релиз должен человек.
В следующий раз начну не с вопроса «как это написать?», а с «как понять, что программа сломалась?». Работающий код получается довольно быстро; с проверками пришлось повозиться куда больше.
Вы бы выпустили такой прокси в прод?
Главный незакрытый вопрос остался в эксплуатации: сумеет ли команда поддерживать Rust-компонент после внедрения без постоянного участия автора эксперимента? Испытания показывают, что прокси работает в проверенных условиях; людей к сопровождению ещё предстоит подготовить. Вы бы разрешили такой релиз? Что потребовали бы до запуска: опытного Rust-разработчика, обучение команды, дополнительные тесты, план поддержки? Если сталкивались с подобным выбором, расскажите, чем всё закончилось.
Что почитать дальше
Оставлю ссылки на материалы, которые полезно почитать до второй статьи о технических деталях. В ней будет про CID, маршрутизацию и ответный UDP-трафик и больше технических подробностей.
Тема |
Первоисточник и зачем читать |
|---|---|
ИИ на реальных задачах разработки |
Jimenez et al., SWE-bench: Can Language Models Resolve Real-World GitHub Issues? — хороший ориентир на проверку моделей не по учебным задачам, а по изменениям в реальных репозиториях. |
Надёжность и выпуск |
Google, Site Reliability Engineering — главы Release Engineering и Testing for Reliability: почему воспроизводимый выпуск и проверка отказов важнее единичного зелёного прогона. |
Поставка изменений |
Jez Humble, David Farley, Continuous Delivery — про автоматизированную цепочку сборки, тестирования и выпуска, где результат можно повторить и проверить. |
Rust как проверяемая среда |
The Rust Programming Language, Cargo Book и документация Clippy — базовые инструменты, которые позволяют превратить требования к сборке, тестам и качеству кода в машинно проверяемые условия. |
Независимая реализация протокола |
Eclipse Californium / Scandium — в проекте используется как отдельная реализация DTLS 1.2 и Connection ID, чтобы не проверять собственные предположения только собственным тестовым кодом. |
Комментарии (3)

sovaz1997
20.10.2026 15:00Был и ещё один полезный приём: я специально возвращал найденный баг и проверял, падает ли тест. Если нет, чинить нужно сам тест.
Это по сути мутационное тестирование, но ручное.
Например в js мы автоматизируем через такую вещь как Stryker

Dmytri_Z
20.10.2026 15:00Надо было отладить код на языке go, а потом дать интеллекту задачу заменить это код на rust
Igor_d_sa
Зашло. Когда код пишет ИИ, слабое место быстро уезжает в постановку и приёмку: если требования дырявые -то и нейросеть просто быстрее накодит дырки! Про ревью и ответственность за результат, полностью солидарен.