Многие из нас писали асинхронный код, который помогает не блокировать потоки при ожидании ответа от процессов, сетевого соединения или устройств. Вызов с callback-функцией задействует много сущностей: и планировщик задач, и межпроцессное взаимодействие, и системные вызовы, и механизмы ядра Linux. Без асинхронных вызовов не обходятся настольные операционные системы, и их разработка требует баланса между производительностью и безопасностью. Также важно сохранить код читаемым и удобным.
Меня зовут Илья Клементьев. Я разрабатываю настольную операционную систему kvadraOS Desktop на основе ChromiumOS в YADRO. В этой статье я постараюсь найти ответ на вопрос: что же все-таки лучше для асинхронного кода — poll() или epoll()? И нужно ли это оборачивать в корутины C++20?
Спойлер: it's a trap
Опытные разработчики догадались сразу: однозначного ответа на вопрос выше нет. Что подойдет для больших проектов, совсем не нужно в проектах поменьше. Но мы разберем конкретно наш случай — с настольной операционной системой.
Тем не менее, если ваш проект отличается от нашего, не спешите закрывать статью! Те три вещи, которые интересовали нас:
какие существуют способы реализации асинхронного I/O,
как они влияют на производительность конкретной компоненты операционной системы,
какие ограничения и дополнительные сложности появляются при попытке ускорить асинхронный код,
...могут возникнуть в проектах любого масштаба и направленности.
Я разберу несколько вариантов обработки асинхронных I/O на примере архитектуры Chromium, которая является неотъемлемой частью архитектуры ChromiumOS. Дальше я расскажу, какие именно решения мы применили в своей операционной системе kvadraOS Desktop. А вы можете сопоставить свой опыт с нашим и выбрать лучший для вас вариант :)
Асинхронный вызов D-Bus
Представим, что одному процессу операционной системы нужно узнать состояние другого. Для межпроцессного взаимодействия используем D-Bus — систему, позволяющую процессам обмениваться сообщениями и вызывать методы друг друга.
Message call("tech.kvadra.Foo", "GetFooState");

proxy->CallAsync(call, [](Response* response) {
	if (!response) {
     std::cerr << "Error: No response received";
     return; }

	// Continue

});
Мы формируем запрос к методу GetFooState сервиса tech.kvadra.Foo и передаем его прокси-объекту D-Bus. При асинхронном вызове программа не ожидает мгновенного ответа: после отправки запроса она может переключиться на другие задачи. Когда ответ будет готов, вызовется callback. Если ответ не получен, функция выдаст Error.
Разбираетесь в асинхронности и любите заглядывать под капот? В YADRO есть задачи для вас. Посмотрите вакансии для разработчиков на C++.
И таково было мое представление об асинхронных вызовах пару лет назад. Но потом в моей жизни появился большой проект на основе Chromium, в котором за каждым асинхронным вызовом скрывалось гораздо больше деталей.
Особенности Chromium
Chromium обеспечивает пользовательский интерфейс в kvadraOS Desktop. Архитектура этого проекта предполагает активное использование многопоточности и асинхронных вызывов.
Посмотрим на более близкий к реальному коду Chromium пример асинхронного вызова:
dbus::MethodCall method_call("tech.kvadra.Foo", "GetFooState");

foo_proxy->CallMethod(&method_call, dbus::ObjectProxy::TIMEOUT_USE_DEFAULT, base::BindOnce(&OnGetFooStateResponse));

void OnGetFooStateResponse(dbus::Response* response) {
	if (!response) {
		LOG(ERROR) << "D-Bus call failed: No response received";
		return;
    }

    // Continue
}
Здесь создается объект dbus::MethodCall, который содержит данные D-Bus-запроса: имя сервиса и вызываемого метода. Для взаимодействия с удаленным объектом используется ObjectProxy. В вызове также указан параметр TIMEOUT_USE_DEFAULT с использованием таймаута по умолчанию.
Вместо лямбды передается base::BindOnce — механизм Chromium для создания callback-функции, которая вызывается один раз. Для callback, который вызывается неоднократно, существует base::BindRepeating.
Принцип остается прежним: создается объект с именем интерфейса и методом D-Bus для общения двух процессов. Объект передается через прокси. Когда готов ответ от запроса, к которому мы обращались, отрабатывает Response.
Откуда он берется? Заглянем внутрь CallMethod(). Он довольно большой, но выполняет всего три основных действия:
DBusMessage* request_message = method_call->raw_message();

base::OnceClosure task = base::BindOnce(
	&ObjectProxy::StartAsyncMethodCall,
	this,
	timeout_ms,
	request_message,
	std::move(callback_holder));

bus_->GetDBusTaskRunner()->PostTask(FROM_HERE, std::move(task));
Сначала из объекта method_call извлекается исходное D-Bus-сообщение, которое мы создали заранее. Затем с помощью все того же base::BindOnce создается задача task. В нее передается наш callback, причем с использованием std::move, чтобы передать владение объектом. После этого задача передается в D-Bus-поток, где она будет выполнена.
Chromium — это многопроцессная и многопоточная архитектура: таски здесь создаются постоянно и затем распределяются между потоками.
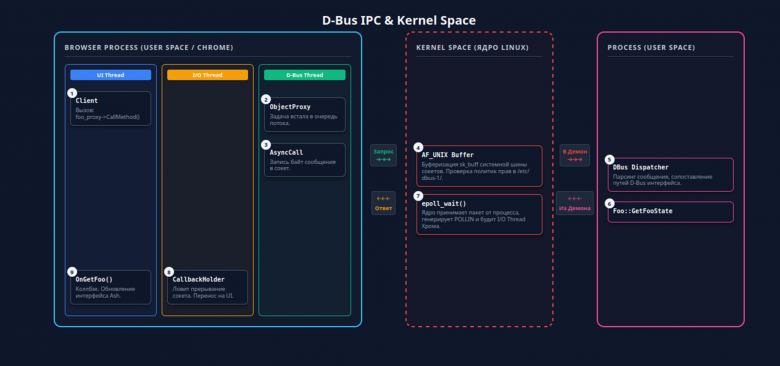
Вот например на иллюстрации три потока браузера, ядро Linux, другой процесс и ручная передача callback между всеми этими компонентами.
На самом деле все не так страшно: в Chromium на каждый чих создается таска. В браузере UI-поток инициирует взаимодействие, D-Bus-поток сериализует данные в байты и выполняет системный вызов на запись данных в UNIX-сокет. Дальше основная работа по межпроцессному взаимодействию происходит внутри ядра Linux: оно проверяет политики безопасности и права доступа, после чего данные попадают в процесс, к которому мы обращались. Тот обрабатывает запрос и возвращает ответ по тому же пути.
Архитектурный нюанс: запрос мы выполняем в D-Bus-потоке, а ответ ждем в потоке ввода-вывода. D-Bus-поток спроектирован исключительно для отправки тяжеловесных запросов библиотеки
libdbus. Поток ввода-вывода выполняет роль сетевого диспетчера всего процесса. Он мониторит системные вызовы, межпроцессное взаимодействие, сокеты и другие подсистемы Chromium. Именно в нем работаетepoll_wait. О нем пойдет речь ниже.
Если вы работали с мультиплексированием, то наверняка встречались с poll, epoll и select. Это своего рода памятники UNIX-проектирования: у них относительно простой API, но при этом большое количество параметров, которые позволяют настраивать ожидание событий — от получения одного байта до «наведения порядка из хаоса потоков», упаковав его в контролируемый и эффективный алгоритм.
epoll при этом стал де-факто стандартом для Linux-систем. Поэтому давайте немного углубимся в то, как его использует Chromium.
epoll
Chromium — это хорошая кодовая база на языке С++, потому что она оборачивает весь небезопасный и неудобный код на C в безопасный и удобный на С++.
Рассмотрим на примере MessagePump — интерфейса, который определяет набор чисто виртуальных методов. Они задают контракт: какие операции должна реализовывать каждая конкретная версия MessagePump. Отправлять задачи в MessagePump можно из других процессов и самих процессов Chromium.
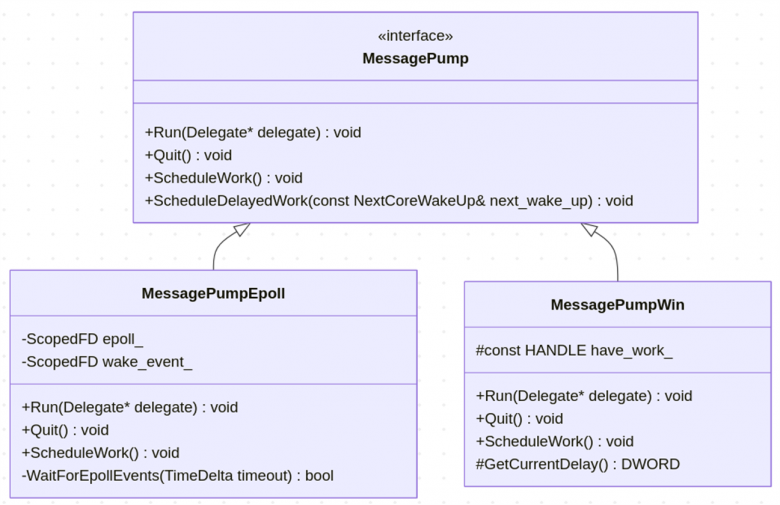
У MessagePump есть кроссплатформенный интерфейс и реализации для разных операционных систем. MessagePumpWin содержит специфичную для Windows логику. А для Linux используется MessagePumpEpoll — именно он нам и нужен.
MessagePumpEpoll:: MessagePumpEpoll() {
	// 1. Создание epoll контекста
	epoll_.reset(epoll_create1(0));

	// 2. Инициализация eventfd для прерывания ожидания
	wake event_.reset(eventfd(0, EFD NONBLOCK));
	epoll event wake{.events = EPOLLIN, .data = {.ptr = &wake event}};
	int rv = epollctl(epoll_.get(), EPOLL_CTL ADD, wake_event.get(), &wake);
}

bool MessagePumpEpoll::WaitForEpollEvents(TimeDelta timeout) {
	epoll event epoll events[16];
	int epoll timeout = timeout.is max() ? -1 : timeout.InMilliseconds();

	// 3. Системный вызов ядра Linux (Ожидание событий)
	const int epoll result = epoll wait(epoll_.get(), epollevents, std::size(epoll_events), epoll_timeout);

	return epoll result > 0;
}
При инициализации в конструкторе MessagePumpEpoll создается объект epoll на уровне ядра Linux. С помощью epoll_create1(0) мы создаем дескриптор самого объекта epoll и оборачиваем его в умный дескриптор ScopedFD. Для файловых дескрипторов такой объект удобнее std::unique_ptr, потому что дескриптор имеет семантику типа int, а не указателя. При этом ScopedFD сохраняет RAII-дисциплину и корректно освобождает ресурс.
Затем создается eventfd — специальный файловый дескриптор, с помощью которого другой поток может разбудить event loop.
Ожидание происходит в epoll_wait(). Вызвав этот метод, поток блокируется до одного из трех событий: истечения таймаута, появления активности на одном из отслеживаемых файловых дескрипторов или записи данных в wake_event_ из другого потока. epoll_wait() возвращает количество готовых событий. Если оно больше нуля, метод-обертка возвращает true, и программа переходит к обработке этих событий.
Проблема масштабируемости: select/poll vs epoll | |
Классический подход (select / poll) |
Современный подход (epoll) |
Сложность: O(N) |
Сложность: O(1) |
|
Линейный перебор. Чтобы узнать, где появились данные, ядро каждый раз сканирует весь массив дескрипторов. Копирование памяти. При каждом вызове список дескрипторов полностью копируется из пространства пользователя в пространство ядра. Ограничение по объему. |
Константное время. Скорость работы не зависит от общего количества открытых соединений. Умное оповещение. Система задействует механизмы прерываний и обрабатывает только те дескрипторы, которые реально активны. Идеально для highload. Спокойно обрабатывает десятки тысяч одновременных соединений (C10K problem). |
Почему epoll оказался эффективнее своих предшественников — select и poll? Одна из причин — как те работают с файловыми дескрипторами. select и poll при каждом ожидании событий должны обрабатывать весь переданный набор FD. Поэтому чем больше дескрипторов нужно отслеживать, тем больше времени занимает такая проверка.
epoll устроен удобнее: сначала приложение регистрирует в нем интересующие файловые дескрипторы и события, которые нужно отслеживать. После этого epoll_wait() возвращает только те дескрипторы, для которых произошло зарегистрированное событие. Благодаря этому не приходится каждый раз просматривать весь набор FD.
Дополнительное преимущество epoll — внутренние структуры данных, которые позволяют эффективно хранить зарегистрированные дескрипторы и готовые события. За эту эффективность приходится платить большей сложностью реализации, но при большом количестве FD она окупается.
У select есть и практическое ограничение: в типичной Linux-реализации размер fd_set ограничен FD_SETSIZE, который обычно равен 1024. Для современной системы этого может быть мало. Например, в kvadraOS количество файловых дескрипторов около 7500.
При этом epoll полезен не только в системах с экстремально высокой нагрузкой. Его главное преимущество — когда одному процессу приходится одновременно отслеживать большое количество файловых дескрипторов — например, сетевых соединений, IPC-каналов или других источников событий.
Минусы у epoll тоже есть:
Каждый вызов
epoll_wait(), а затемread()илиwrite(), требует перехода из пользовательского пространства в пространство ядра. При большом количестве таких операций эти переходы становятся дополнительными накладными расходами.epollсообщает только о том, что данные готовы к обработке. Чтобы получить сами данные, приложению все равно приходится вызыватьread(), который переносит их из буфера ядра в буфер приложения. Для больших объемов данных, например сетевого трафика, это создает дополнительную нагрузку.
Есть и менее очевидная особенность, связанная с Android: при пробуждении epoll теряет флаг sync, что влияет на планировщик. Из-за этого ядро не может передать CPU целенаправленно тому потоку, который ждет данные, что увеличивает задержку.
Действительно ли epoll лучше poll? Проведем эксперимент: гипотетически перепишем MessagePumpEpoll на poll, назовем такой класс MessagePumpPoll и посмотрим, что из этого получится. В Chromium этого класса нет — это чисто наш «учебный экзерсис», позволяющий на сравнении обоих подходов почувствовать разницу.
bool MessagePumpPoll::WaitForPollEvents(TimeDelta timeout) {
	poll_fds_.clear();

	// Self-Pipe Trick
	poll_fds_.push_back({.fd = wake_event_.get(), .events = POLLIN});

	for (const auto& watcher : watched_fds_) {
		poll_fds_.push_back({.fd = watcher.fd, .events = watcher.events});
	}

	int poll_timeout = timeout.is_max() ? -1 : timeout.InMillisecondsRoundedUp();

	// Копирование всего массива в ядро
	int result = poll(poll_fds_.data(), poll_fds_.size(), poll_timeout);

	if (result <= 0) return false;

	// Линейный обход O(N) для поиска сработавшего дескриптора
	for (size_t i = 0; i < poll_fds_.size(); ++i) {
		if (poll_fds_[i].revents & poll_fds_[i].events) {
			if (poll_fds_[i].fd == wake_event_.get()) {
				uint64_t val;
				read(wake_event_.get(), &val, sizeof(val));
			}
			break;
		}
	}

	return true;
}
Для простоты эксперимента мы отбросили тонкость реального MessagePumpEpoll, где pollfds_ поддерживается параллельно с epoll-состоянием. Мы пересобираем плоский массив std::vector<pollfd> заново на каждый вызов. Это упрощает реализацию, но меняет характеристики работы с большим количеством дескрипторов.
С одной стороны, нам не нужен дополнительный вызов epoll_ctl(): при каждом ожидании мы просто передаем для poll() актуальный массив дескрипторов. Сохраняется и флаг sync, что лучше для планировщика на Android. Кроме того, кода становится меньше, поэтому реализацию проще отлаживать.
С другой стороны, за простоту приходится платить производительностью. При каждом вызове poll() ядро копирует и проверяет весь массив дескрипторов. При большом количестве FD такой подход крайне медленный.
Что имеем?
pollпроще устроен и требует меньше служебной логики, но хуже масштабируется с ростом числа дескрипторов. Для небольшого количества FDpoll— приемлемая плата за простоту, а при тысячах дескрипторов преимущество уже оказывается на сторонеepoll.
MessagePumpEpoll
А что если не выбирать что-то одно, а использовать оба механизма? Именно так устроен современный MessagePumpEpoll в Chromium. Внутри WaitForEpollEvents() он проверяет, включен ли соответствующий флаг и сколько файловых дескрипторов сейчас отслеживается:
bool use_poll = feature_enabled && entries_.size() < 500;
Если включен флаг kUsePollForMessagePumpEpoll и дескрипторов меньше 500, используется poll(). Во всех остальных случаях — epoll().
Порог в 500 FD выбран эмпирически: при небольшом количестве дескрипторов poll() еще не тормозит, а преимущества такого подхода для планировщика на Android уже заметны.
При этом оба варианта работают с одним и тем же состоянием. При изменении набора отслеживаемых дескрипторов обновляются и pollfds_, и epoll_. Благодаря этому независимо от выбранного механизма на выходе получается единый набор событий, который дальше обрабатывается одинаково.
Таким образом, выбор зависит от нагрузки:
Десктопы с тысячей сокетов —
epoll(), который лучше масштабируется.Android и небольшое количество FD —
poll(), который проще и позволяет сохранить нужное поведение планировщика.
Новый игрок — io_uring
В 2019 году в ядре Linux появился новый механизм — io_uring. Основная идея — использовать два кольцевых буфера в общей памяти, доступных приложению и ядру:
Submission Queue (SQ) — в этот буфер приложение записывает запросы на I/O.
Completion Queue (CQ) — ядро помещает в этот буфер результаты выполненных операций.
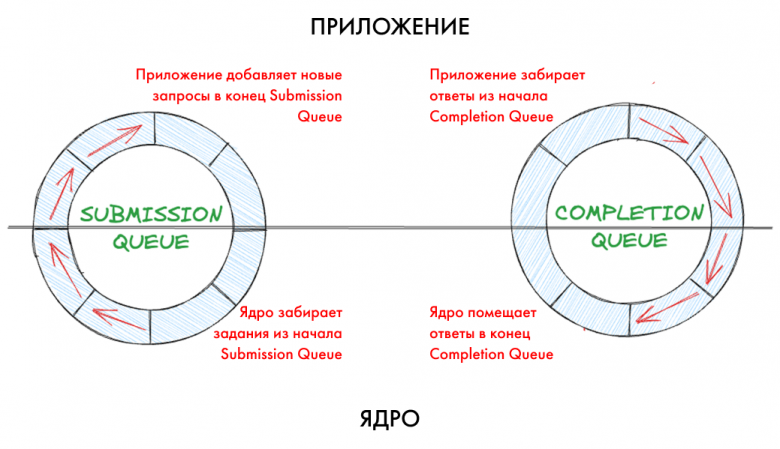
Для передачи запросов и результатов не нужно каждый раз делать отдельный системный вызов: приложение и ядро обмениваются данными через общие кольцевые буферы. Syscall требуется только в тех случаях, когда нужно сообщить ядру о новых запросах или дождаться завершения операций. Так io_uring позволяет сократить количество переходов между пользовательским пространством и ядром и уменьшить накладные расходы на обработку большого числа I/O-операций.
А главное — сама модель «зарегистрируй дескриптор один раз и жди» очень похожа на то, что уже делает MessagePumpEpoll. Отсюда идея эксперимента: попробовать заменить у MessagePump средство ожидания готовности FD на io_uring. Ниже по тексту мы рассмотрим реальную экспериментальную реализацию такого пампа — MessagePumpIoUring. Как и в случае с гипотетическим MessagePumpPoll из примера выше — это наш «учебный экзерсис»: по умолчанию он выключен feature-флагом и подключается через тот же механизм выбора, что и epoll.
Архитектура и структура
Взаимодействие с io_uring реализовано не через liburing, а напрямую через системные вызовы io_uring_setup, io_uring_enter и io_uring_register (обертки IoUringSetup, IoUringEnter и IoUringRegister соответственно). liburing намеренно не использован: для наблюдения за готовностью FD достаточно нескольких маленьких оберток, что позволяет не тащить в дерево дополнительную зависимость.
Класс MessagePumpIoUring наследуется от MessagePumpPosixIOPump — базового класса, который вынесли из MessagePumpEpoll. В нем сосредоточена вся общая логика: хранение интересов к дескрипторам, цикл Run(), пробуждение через eventfd. Конкретные реализации epoll и io_uring отличаются только тем, как они «ждут» готовность FD. MessagePumpIoUring определяет четыре точки расширения: WaitForReadyEvents(), AddFdEvent(), UpdateFdEvent() и StopFdEvent().
Главный объект класса — ring_ типа Ring. Он инкапсулирует кольца io_uring_sq (Submission Queue) и io_uring_cq (Completion Queue), их mmap-отображение и системный дескриптор ring_fd. Кольцо создается в конструкторе:
MessagePumpIoUring::MessagePumpIoUring() {
	// Кольцо должно быть достаточно большим, чтобы в него вошли SQE
	// для всех одновременно отслеживаемых FD (плюс отложенные cancel).
	ring_ = std::make_unique<Ring>(64);
	ring_->RegisterEventfd(wake_event_.get());
}

Ring::Ring(unsigned entries) {
	memset(&ms_, 0, sizeof(params_));
	ring_fd_.reset(IoUringSetup(entries, &ms_));
	CHECK(ring_fd_.is_valid());
	// ...
	// После io_uring_setup() кольца SQ и CQ отображаются в память
	// процесса через mmap() (IORING_OFF_SQ_RING / IORING_OFF_CQ_RING),
	// а массив SQE — через IORING_OFF_SQES.
	// ...
}
Для пробуждения цикла из других потоков используется wake_event_ — дескриптор типа ScopedFD, который создается в базовом классе MessagePumpPosixIOPump:
wake_event_.reset(eventfd(0, EFD_NONBLOCK));
PCHECK(wake_event_.is_valid());
Это тот же «будильник», что и в MessagePumpEpoll: при вызове ScheduleWork() другой поток записывает значение в eventfd. Дополнительно wake_event_ регистрируется в кольце через IORING_REGISTER_EVENTFD — это значит, что любое завершение операции в CQ само разбудит eventfd.
Как работает WaitForReadyEvents()
Метод готовит запросы к ожиданию, а затем паркует цикл. Сначала подписываются все операции наблюдения, отложенные вызовами AddFdEvent()/UpdateFdEvent()/StopFdEvent():
ring_->Submit();
В отличие от полноценного асинхронного I/O, этот pump использует io_uring не для чтения и записи, а как readiness-wait примитив — по аналогии с epoll_wait(). Для каждого активного дескриптора в кольцо один раз отправляется одноразовый (single-shot) запрос IORING_OP_POLL_ADD, который уведомляет о готовности FD:
void Ring::AddPoll(int fd, uint32_t poll_events, void* user_data) {
	Enqueue([&](struct io_uring_sqe* sqe) {
		sqe->opcode = IORING_OP_POLL_ADD;
		sqe->fd = fd;
		sqe->poll_events = static_cast<uint16_t>(poll_events);
		sqe->user_data = reinterpret_cast<uint64_t>(user_data);
		// Single-shot (без IORING_POLL_ADD_MULTI): poll автоматически
		// снимается после срабатывания, а цикл перевооружает его,
		// эмулируя level-triggered поведение.
	});
}
Запросы не отправляются по одному. Метод Enqueue() только копит их во внутреннем векторе pending_sqes_, а реальная передача ядру происходит при Submit(), который записывает их в SQ-кольцо и вызывает io_uring_enter. Это позволяет отправлять несколько операций за один вызов, не обращаясь к ядру отдельно для каждой из них.
Затем метод паркует поток на самом wake_event_ с заданным таймаутом:
int pr = poll(&event_pollfd, 1, timeout_ms);
Здесь по-прежнему используется обычный poll() по одному дескриптору — eventfd. Поток засыпает до одного из двух событий: истечения таймаута или срабатывания eventfd. При этом eventfd «звонит» в двух случаях: когда другой поток вызвал ScheduleWork(), что значит «появилась новая задача», или когда ядро завершило операцию в CQ — через IORING_REGISTER_EVENTFD. Именно так два разных повода сходятся в единый механизм пробуждения.
После пробуждения всегда выполняется Drain() — вычитка готовых завершений из кольца:
ring_->Drain([&](void* user_data, uint32_t events) {
	auto* entry = static_cast<FdEntry*>(user_data);
	// Одноразовый poll сработал и снял сам себя.
	entry->registered_events = 0;
	epoll_event e{.events = events, .data = {.ptr = entry}};
	ready_events->push_back(e);
});
Drain() вызывает io_uring_enter с флагом IORING_ENTER_GETEVENTS, проходит по CQ и собирает готовые события. Завершения для операций вызова ASYNC_CANCEL (пометка kCancelTag) и любые завершения с отрицательным результатом, например cancelled/некорректные полы, отфильтровываются — это не события готовности.
Дальше, если сработал сам eventfd, в набор готовых событий добавляется и «пробуждение», чтобы базовый класс успел вычитать счетчик перед следующим ожиданием:
if (eventfd_signaled) {
	epoll_event wake{.events = POLLIN, .data = {.ptr = &wake_event_}};
	ready_events->push_back(wake);
}
Поскольку IORING_OP_POLL_ADD одноразовый, перед следующим ожиданием цикл перевооружает все активные дескрипторы, у которых нет висящего poll:
for (auto& [fd, entry] : entries_) {
	if (entry.stopped || entry.registered_events != 0) {
		continue;
	}
	const uint32_t rw = entry.ComputeActiveReadWriteEvents();
	if (rw != 0) {
		ring_->AddPoll(fd, rw, &entry);
		entry.registered_events = rw;
	}
}

ring_->Submit();
В конце метода события дедуплицируются: если один FD попал в batch дважды, его флаги объединяются, поскольку ProcessReadyEvents() в базовом классе не ожидает повторения одного дескриптора.
Обновление и снятие наблюдения
Когда набор интересов к дескриптору меняется, UpdateFdEvent() сравнивает текущий набор событий с уже зарегистрированным. Если события те же — ничего не делаем. Если изменились — атомарно заменяем poll: сначала ставим ASYNC_CANCEL, а новый POLL_ADD связываем с ним через флаг IOSQE_IO_LINK, чтобы новый poll встал только после снятия старого, без гонки.
void Ring::UpdatePoll(int fd, uint32_t poll_events, void* user_data) {
	Enqueue([&](struct io_uring_sqe* sqe) {
		sqe->opcode = IORING_OP_ASYNC_CANCEL;
		sqe->fd = fd;
		sqe->cancel_flags = IORING_ASYNC_CANCEL_FD;
		sqe->user_data = kCancelTag;
		sqe->flags = IOSQE_IO_LINK;
	});
	Enqueue([&](struct io_uring_sqe* sqe) {
		sqe->opcode = IORING_OP_POLL_ADD;
		sqe->fd = fd;
		sqe->poll_events = static_cast<uint16_t>(poll_events);
		sqe->user_data = reinterpret_cast<uint64_t>(user_data);
	});
}
Особого внимания заслуживает StopFdEvent(). Когда наблюдение за дескриптором прекращается, FdEntry может быть удален, а в кольце при этом может оставаться висящий POLL_ADD с user_data, указывающим на этот entry. Оставлять такой «висячий» указатель нельзя — ядро может сослаться на уже удаленный объект.
Поэтому Ring::CancelPollAndQuiesce() синхронно отменяет poll и ждет, пока его завершение не появится в CQ. Завершения для других, еще живых entry, найденные по пути, сохраняются в deferred_events_ и будут обработаны в следующем вызове WaitForReadyEvents().
Как подключить io_ring
Решение о том, какой pump использовать, принимается на этапе создания IO-цикла. Чтобы реализацию можно было безопасно включать и выключать, она спрятана за feature-флагом kUseIoUringForMessagePump (по умолчанию выключен) и рантайм-проверкой доступности:
static bool IsAvailable() {
	struct io_uring_params params;
	memset(&ms, 0, sizeof(params));
	ScopedFD fd(IoUringSetup(/*entries=*/1, &ms));
	// Любая ошибка (ENOSYS на старых ядрах, EPERM на seccomp-системах
	// или при отключенном io_uring) означает недоступность; проверка
	// не должна падать.
	return fd.is_valid();
}
IsAvailable() пробует создать кольцо с одним элементом. Любой из двух случаев — старые ядра, где syscall вернет ENOSYS, или окружения, где io_uring заблокирован seccomp-политикой (EPERM), — означает, что io_uring недоступен, и проверка возвращает false, не роняя процесс. Только если и флаг включен, и проба успешна, фабрика MessagePump::Create() вернет MessagePumpIoUring; в противном случае вернется привычный MessagePumpEpoll.
Главное преимущество такого подхода — операции наблюдения за дескрипторами объединяются в пакеты: несколько POLL_ADD отправляются ядру одним вызовом io_uring_enter. При этом не требуется постоянно вызывать epoll_ctl() или заново передавать ядру весь массив дескрипторов, как в случае с poll().
Обратная сторона производительности
Высокая производительность сама по себе не означает, что механизм подходит для любого сценария. У io_uring есть и обратная сторона — вопросы безопасности и стабильности.
Интерфейс оказался непростым с точки зрения безопасности. В середине 2023 года Google отмечала, что около 60% эксплойтов, обходивших защиту Chrome, использовали
io_uring. Сам механизм не был причиной всех этих уязвимостей, но он встречался в цепочках атак.Архитектура
io_uringменяет привычную модель наблюдения за I/O. Значительная часть работы может выполняться через общие кольцевые буферы, без отдельного системного вызова для каждой операции. Поэтому инструменты, которые отслеживают действия процесса преимущественно на уровне syscalls, могут получать меньше информации о происходящем. Атакующие могут незаметно устанавливать соединения, читать файлы, модифицировать систему.Наконец, вопрос стабильности. В кодовой базе ChromiumOS встречались изменения, связанные с отключением
io_uringиз-за проблем в новых версиях ядра и возможныхdeadlock. В crosvm — виртуализации Chromium — механизм также отключали на старых ядрах из-за известных проблем.
В результате в некоторых компонентах ChromeOS от io_uring отказались в пользу более предсказуемых механизмов. В частности, для нашего Linux-контейнера требования безопасности привели к тому, что одного ограничения интерфейса через seccomp оказалось недостаточно. Его отключили на уровне конфигурации ядра.
У нашего эксперимента есть ограничение: эксплуатация io_uring наиболее выгодна при больших объемах асинхронного I/O. Мы же используем его лишь как readiness-wait примитив — то есть по сути вместо epoll_wait(). Полный выигрыш, ради которого создавался io_uring, здесь не достигается: чтение и запись данных по-прежнему выполняются отдельными read()/write() с переходом в ядро. Поэтому экспериментальный MessagePumpIoUring — это скорее проверка модели, чем реальный прирост производительности.
Что выбрать?
И здесь мы возвращаемся к вопросу, который поставили в начале статьи: как найти баланс между производительностью и удобством разработки?
poll()прост и хорошо подходит для небольшого количества файловых дескрипторов, но хуже масштабируется.epoll()сложнее, зато хорошо работает с большим количеством FD и давно используется в Linux-системах.io_uringпредлагает еще более современную модель и потенциально меньшие накладные расходы, но добавляет новые сложности — в том числе с точки зрения безопасности и предсказуемости.
Наша экспериментальная реализация подтверждает, что переход достижим: pump на io_uring вовсе не выдумка, он собирается и проходит тесты. Но за это приходится платить заметным усложнением кода — синхронной отменой poll при снятии наблюдения, эмуляцией level-triggered поведения, дедупликацией событий.
В итоге для своей операционной системы мы выбрали MessagePumpEpoll с адаптивным бэкендом. Мы не стремимся получить максимальный результат в синтетическом бенчмарке, если для этого приходится принимать дополнительные риски в системном коде. Экспериментальный MessagePumpIoUring мы оставили выключенным за feature-флагом как то, с чем можно продолжить работать в будущем.
Реально (!) новый игрок — корутины С++20
C++20 добавил корутины — механизм, который позволяет писать асинхронный код в последовательном стиле. Например, вызов D-Bus можно записать так:
CoTask<bool> IsAutoUpdateEnabled() override {
	dbus::MethodCall method_call(dbus::kDBusPropertiesInterface, dbus::kDBusPropertiesGet);
	dbus::MessageWriter writer(&method_call);
	writer.AppendString(dbus_constants::kOtaUpdateServiceInterface);
	writer.AppendString(dbus_constants::kIsAutoUpdateEnabledProperty);

	DbusAwaiter awaiter(ota_update_service_proxy_.get(), std::move(method_call));
	dbus::Response* response = co_await awaiter;
	if (!response) {
    	LOG(ERROR) << "[DBus] Method call timeout";
    	co_return false;
	}
	// ...разбираем ответ через dbus::MessageReader...
	co_return is_auto_update_enabled;
}
Здесь co_await обозначает точку, в которой выполнение корутины может приостановиться. В нашем случае функция ждет ответа на асинхронный D-Bus-вызов, не блокируя поток. co_return, завершающий выполнение корутины, по смыслу похож на обычный return.
Этот код выглядит как обычная последовательная функция: вызвали метод, дождались результата, проверили его. Но под капотом корутина может приостановить выполнение и продолжить его позже, когда ответ будет готов.
Как это интегрируется с Chromium
Стандарт C++20 предоставляет механизм корутин, но не готовый универсальный тип вроде std::task, который можно было бы сразу использовать в production-коде. В Chromium для корутин нужны собственные типы-обертки, например dbus_utils::CoTask<T>. Они позволяют встроить корутины в существующую инфраструктуру планировщика и учитывать особенности управления временем жизни объектов, в том числе WeakPtr.
А может ли компилятор сам превратить такой последовательный код в нужную последовательность состояний и переходов, вместо того чтобы вручную писать base::BindOnce и callback?
Awaiter: как подружить корутины с Chromium
Корутины C++20 позволяют компилятору преобразовать последовательный код в стейт-машину (coroutine frame), которая сохраняет состояние при приостановке и продолжает выполнение с нужного места после возобновления. Однако для взаимодействия с асинхронной инфраструктурой Chromium все равно нужен связующий механизм.
Эту роль выполняет Awaiter: он определяет, как корутина приостанавливается в ожидании результата и как возобновляется, когда результат становится доступен. Также Awaiter позволяет связать стейт-машину корутины с существующей callback-инфраструктурой Chromium.
Для этого создается DbusAwaiter:
class DbusAwaiter {
  public:
  DbusAwaiter(dbus::ObjectProxy* proxy, dbus::MethodCall method_call) : proxy_(proxy), method_call_(std::move(method_call)) {}
  bool await_ready() noexcept { return false; }

  void await_suspend(std::coroutine_handle<> handle) {
    handle_ = handle;
    proxy_->CallMethod(&method_call_, dbus::ObjectProxy::TIMEOUT_USE_DEFAULT, base::BindOnce(&DbusAwaiter::OnResponse, base::Unretained(this)));
  }

  dbus::Response* await_resume() { return response_; }

 private:
  void OnResponse(dbus::Response* response) {
    response_ = response;
    auto handle = handle_;
    handle_ = nullptr;
    if (handle) handle.resume();
  }

  raw_ptr<dbus::ObjectProxy> proxy_ = nullptr;
  dbus::MethodCall method_call_;
  std::coroutine_handle<> handle_ = nullptr;
  raw_ptr<dbus::Response> response_ = nullptr;
};
У Awaiter есть три основных метода, которые вызываются на разных этапах работы корутины.
await_ready() проверяет, можно ли продолжить выполнение без приостановки. В нашем случае метод всегда возвращает false: результат D-Bus-вызова еще не готов, поэтому корутина должна приостановиться. Этим занимается await_suspend(). Метод получает std::coroutine_handle<> — объект, с помощью которого можно управлять состоянием корутины, в том числе возобновлять ее выполнение. Мы сохраняем этот handle в callback через base::BindOnce() и запускаем асинхронный D-Bus-вызов с помощью proxy->CallMethod().
Когда приходит ответ от D-Bus, вызывается OnResponse(). Callback сохраняет указатель на ответ и вызывает handle.resume(), возобновляя корутину с места приостановки — после co_await.
В этом примере используется base::Unretained(this). Такой подход требует внимания к времени жизни объекта: callback не должен обратиться к уже уничтоженному DbusAwaiter. В данном случае Awaiter хранится в стейт-машине, поэтому, пока корутина приостановлена и ожидает ответа, ее фрейм остается живым. Это позволяет избежать уничтожения Awaiter до вызова callback.
Наконец, вызывается await_resume(). Он возвращает результат, который становится результатом выражения co_await:
dbus::Response* response = co_await ...;
То есть вся последовательность выглядит так:
co_await → await_ready() → await_suspend() → обычный Chromium callback → OnResponse() → handle.resume() → await_resume() → продолжение корутины.
Что происходит внутри Task
initial_suspend() возвращает std::suspend_never. Корутина запускается до того, как вызывающий код применит к ней co_await. Поэтому D-Bus-запрос запускается непосредственно при создании корутины.
На co_await DbusAwaiter корутина приостанавливается. Она ждет ответа D-Bus, а поток в это время может выполнять другие задачи. Когда приходит ответ от D-Bus, OnResponse() вызывает handle.resume(). Корутина возобновляет выполнение с места приостановки и продолжает работу с полученным результатом.
При co_return value вызывается return_value(value). Метод сохраняет результат в result_, чтобы его могла получить ожидающая сторона. В этот момент final_suspend() через FinalAwaiter вызывает ResumeContinuation(): он будит корутину, которая ожидает завершения текущего CoTask, и передает ей управление.
struct FinalAwaiter {
  bool await_ready() const noexcept { return false; }
  void await_suspend(std::coroutine_handle<CoTaskPromise<T>> done) noexcept {
    done.promise().ResumeContinuation();
  }
  void await_resume() noexcept {}
};

void ResumeContinuation() noexcept {
  if (continuation_) {
    auto cont = continuation_;
    continuation_ = nullptr;
    cont.resume();
  }
}
Callbacks vs coroutines
Сравним два варианта одной и той же последовательности: сначала получить состояние сети, затем громкость аудио.
В callback-подходе каждый следующий шаг приходится передавать в отдельный обработчик:
void Service::InitializeSystem() {
	dbus::MethodCall method_call("org.chromium.Network", "GetStatus");
	network_proxy_->CallMethod(&method_call, dbus::ObjectProxy::TIMEOUT_USE_DEFAULT, base::BindOnce(&KvadraService::OnGetNetworkStatus, base::Unretained(this)));
}

void Service::OnGetNetworkStatus(dbus::Response* response) {
	if (!response) return;

	dbus::MethodCall method_call("org.chromium.Audio", "GetVolume");

	audio_proxy_->CallMethod(&method_call, dbus::ObjectProxy::TIMEOUT_USE_DEFAULT, base::BindOnce(&Service::OnGetAudioVolume, base::Unretained(this)));
}

void Service::OnGetAudioVolume(dbus::Response* response) {
	...
}
Сама асинхронная модель здесь вполне рабочая. Но последовательность действий оказывается разбросана по нескольким функциям, и при добавлении новых асинхронных операций появляется все больше callback-методов, а разработчику приходится держать в голове переходы между ними.
Вот как выглядит та же логика с корутинами:
dbus_utils::CoTask<void> Service::InitializeSystemCoro() {
	dbus::MethodCall net_call("org.chromium.Network", "GetStatus");
	DbusAwaiter net_awaiter(network_proxy_.get(), std::move(net_call));
	dbus::Response* net_resp = co_await net_awaiter;

	if (!net_resp) co_return;

	dbus::MethodCall audio_call("org.chromium.Audio", "GetVolume");
	DbusAwaiter audio_awaiter(audio_proxy_.get(), std::move(audio_call));
	dbus::Response* audio_resp = co_await audio_awaiter;

	// Продолжаем логику в том же SequencedTaskRunner.
}
Для краткости здесь опущены разбор ответов через dbus::MessageReader и обработка ошибок формата. В реальном коде каждая такая последовательность строится через DbusAwaiter точно так же, как в примере в начале главы.
При этом сама асинхронная инфраструктура Chromium не меняется. await_suspend() получает std::coroutine_handle, передает его в обычный base::BindOnce, а тот — в существующий proxy->CallMethod(). SequencedTaskRunner и MessagePumpEpoll по-прежнему работают с обычными задачами и callback.
Сокращение кода само по себе не главное преимущество. Важнее то, что при каждой новой асинхронной операции разработчику не приходится вручную строить очередную цепочку callback. Если таких операций десятки или сотни, разница становится заметной. Меньше вспомогательных функций — меньше переходов между ними и меньше приходится удерживать в голове при чтении и изменении кода.
Это не означает, что корутины автоматически лучше. У них есть свои ограничения, особенно при интеграции с существующей моделью управления временем жизни объектов и строгой привязкой к
Sequence. Поэтому такой подход имеет смысл применять там, где выигрыш в читаемости действительно оправдывает дополнительную инфраструктуру.Для слоя системных сервисов kvadraOS мы применяем такой подход. А какой ваш? Делитесь в комментариях!