Представим неидеальный, но знакомый многим администраторам сценарий. Ещё вчера сайт спокойно работал, а сегодня график запросов стал почти вертикальным, время ответа растёт, загрузка CPU достигла 100% и часть пользователей уже видит ошибки. Началась DDoS‑атака. Настроить защиту хотелось бы заранее, а не когда уже всё горит. Но до неё руки не доходят, да это и не бесплатно.
В такой момент последнее, чем хочется заниматься, — разбираться, какой балансировщик создать, как подключить фильтрацию трафика, где выпустить сертификат и какие сетевые правила не забыть. Хочется указать адрес сайта, переключить DNS и получить защиту.
Yandex Smart Web Security (SWS) — сервис для защиты сайтов и веб‑приложений от DDoS‑атак на сетевом, транспортном и прикладном уровнях (L3, L4 и L7), от вредоносных ботов и эксплуатации уязвимостей. Долгое время подключить Yandex Smart Web Security было проще всего для приложений, уже размещённых в Yandex Cloud и принимающих трафик через Application Load Balancer. Если бэкенд находился в собственном дата‑центре, у другого облачного провайдера или на обычном хостинге, пользователю приходилось самостоятельно собирать промежуточную инфраструктуру.
Мы решили спрятать эту сложность внутри Smart Web Security и сделали «Защиту доменов» — функцию, которая позволяет защищать сайты и веб‑приложения от DDoS‑атак и роботов, даже если они размещены в собственной инфраструктуре или у другого провайдера. Пользователь указывает домен и адрес бэкенда, а сервис создаёт перед ним управляемый обратный прокси, который направляет входящий трафик на проверку в Smart Web Security и пропускает разрешённые запросы к бэкенду.
Я Иван Тямгин, разработчик и техлид сервиса Yandex Smart Web Security. Расскажу, как мы превратили ручную настройку балансировщика и связанных облачных ресурсов в управляемый сервис. Разберёмся, зачем для этого понадобился Temporal, почему отменённая операция всё ещё может создавать побочные эффекты, какие архитектурные ошибки мы допустили при проектировании распределённой системы и как их исправили.
Как защитить сайт во внешней инфраструктуре
Как Smart Web Security защищал ресурсы раньше
Yandex Smart Web Security защищает сайты и веб‑приложения от угроз на прикладном уровне L7: DDoS‑атак, вредоносных ботов и веб‑атак. Администратор настраивает, как проверять входящие запросы: какие из них блокировать, когда включать дополнительную проверку и как ограничивать нагрузку на приложение.
В интерфейсе такой набор настроек называется «Профиль безопасности». Он может включать Anti‑DDoS, Web Application Firewall (WAF) и ограничение нагрузки с помощью Advanced Rate Limiter. Дальше я буду использовать термин «профиль безопасности» именно в таком смысле.
О том, как внутри устроена защита от автоматизированного трафика, уже рассказывал мой коллега Руслан Сабиргалиев в статье «Под капотом одного ползунка: как устроена защита от ботов в Яндексе». Здесь я сосредоточусь на другом слое системы: как доставить трафик внешнего сайта до этой защиты и затем безопасно вернуть его в инфраструктуру пользователя.
Упрощённо прежний сценарий выглядел так: входящий HTTP‑трафик попадал на поддерживаемый ресурс в Yandex Cloud, к нему подключалась настроенная защита, а Smart Web Security решал, какие запросы пропустить, заблокировать или отправить на дополнительную проверку.
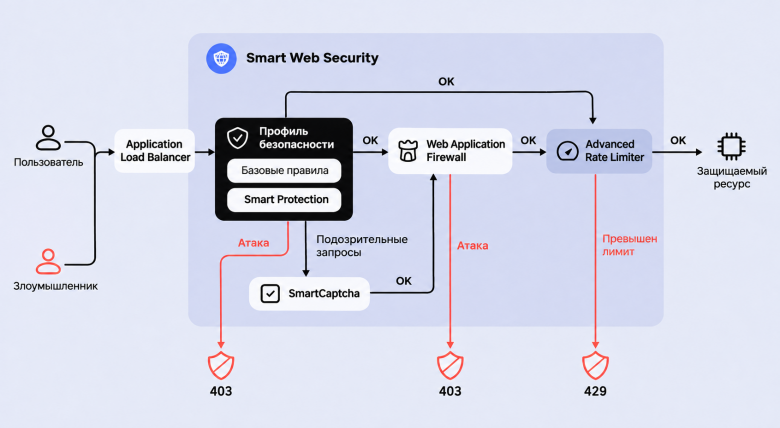
Это особенно просто, когда защищаемое приложение уже находится в облачной инфраструктуре. Но реальный IT‑ландшафт редко бывает настолько однородным. У компании может быть собственный дата‑центр, несколько облачных провайдеров, обычный хостинг или большая система, которую переносят в облако постепенно.
Само приложение переносить было необязательно, но подключить защиту к внешнему бэкенду напрямую было нельзя. Пользователю приходилось разворачивать и сопровождать в Yandex Cloud отдельный контур доставки трафика. Мы хотели дать ему возможность создавать этот контур «в пару кликов».
Ручной вариант: ALB перед внешним бэкендом
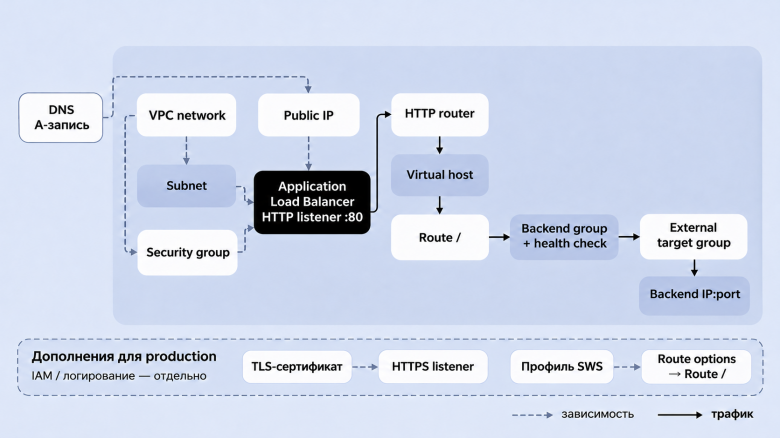
Технически внешний бэкенд можно было защитить и раньше. Например, для бэкенда с публичным IP‑адресом пользователю нужно было самостоятельно создать сеть VPC (Virtual Private Cloud), настроить security groups и сервисные аккаунты. Затем — развернуть ALB (Yandex Application Load Balancer), завести внешний target, настроить backend group, HTTP router и virtual host, получить публичный IP‑адрес, добавить TLS‑сертификат и связать конфигурацию с профилем Smart Web Security. После этого оставалось направить A‑запись домена на балансировщик. Даже звучит слишком сложно.
Каждый из этих компонентов решает понятную задачу. Сложность появляется из‑за их количества. Порог входа в эту инфраструктуру довольно высокий: нужно разобраться в принципах работы VPC и ALB, правильно связать все компоненты, а при ошибке — выяснить, на каком шаге что‑то пошло не так. А ещё можно забыть развернуть всё это в нескольких зонах доступности. В общем, без опыта работы с облаком настроить такую защиту может быть сложно.
Вот упрощённая схема без сертификатов, которую приходится «слепить» пользователю, впервые зашедшему в облако:
От ручной настройки к сервису
Ручной вариант в Terraform
Объём ручной настройки хорошо виден на примере конфигурации Terraform, хотя большинство пользователей работает через интерфейс. Ниже — только ресурсы, которые обеспечивают доставку трафика от публичного адреса до внешнего бэкенда.
Даже в упрощённом варианте без сертификата нужно описать 11 блоков resource для VPC и ALB, причём один из них создаёт три подсети. Пользователю приходится явно задавать сеть, маршрутизацию, правила доступа, публичный адрес, балансировщик, target group, backend group, health check, HTTP router и virtual host.
Terraform‑код ручного варианта
resource "yandex_vpc_network" "alb" {
  folder_id = var.folder_id
  name      = "alb-network"
}

resource "yandex_vpc_gateway" "alb_egress" {
  folder_id = var.folder_id
  name      = "alb-egress-gateway"

  shared_egress_gateway {}
}

resource "yandex_vpc_route_table" "alb_egress" {
  folder_id  = var.folder_id
  name       = "alb-egress-routes"
  network_id = yandex_vpc_network.alb.id

  static_route {
    destination_prefix = "0.0.0.0/0"
    gateway_id         = yandex_vpc_gateway.alb_egress.id
  }
}

resource "yandex_vpc_subnet" "alb" {
  for_each = {
    ru-central1-a = {
      name = "alb-subnet-a"
      cidr = "10.10.1.0/24"
    }
    ru-central1-b = {
      name = "alb-subnet-b"
      cidr = "10.10.2.0/24"
    }
    ru-central1-d = {
      name = "alb-subnet-d"
      cidr = "10.10.0.0/24"
    }
  }

  folder_id      = var.folder_id
  name           = each.value.name
  zone           = each.key
  network_id     = yandex_vpc_network.alb.id
  v4_cidr_blocks = [each.value.cidr]
  route_table_id = yandex_vpc_route_table.alb_egress.id
}

resource "yandex_vpc_security_group" "alb" {
  folder_id  = var.folder_id
  name       = "alb-security-group"
  network_id = yandex_vpc_network.alb.id

  ingress {
    protocol       = "ANY"
    v4_cidr_blocks = ["0.0.0.0/0"]
  }

  egress {
    protocol       = "ANY"
    v4_cidr_blocks = ["0.0.0.0/0"]
  }
}

resource "yandex_vpc_address" "alb_public" {
  folder_id = var.folder_id
  name      = "alb-public-ip"

  external_ipv4_address {
    zone_id = "ru-central1-d"
  }
}

resource "yandex_alb_load_balancer" "this" {
  folder_id          = var.folder_id
  name               = "external-backend-proxy"
  network_id         = yandex_vpc_network.alb.id
  security_group_ids = [yandex_vpc_security_group.alb.id]

  allocation_policy {
    dynamic "location" {
      for_each = yandex_vpc_subnet.alb

      content {
        zone_id   = location.key
        subnet_id = location.value.id
      }
    }
  }

  listener {
    name = "http"

    endpoint {
      address {
        external_ipv4_address {
          address = yandex_vpc_address.alb_public.external_ipv4_address[0].address
        }
      }

      ports = [80]
    }

    http {
      handler {
        http_router_id = yandex_alb_http_router.this.id
      }
    }
  }

  depends_on = [yandex_alb_virtual_host.this]
}

resource "yandex_alb_target_group" "backend" {
  folder_id = var.folder_id
  name      = "external-backend-targets"

  target {
    ip_address       = var.backend_ip
    external_address = true
  }
}

resource "yandex_alb_backend_group" "this" {
  folder_id = var.folder_id
  name      = "external-backend-group"

  http_backend {
    name             = "external-http-backend"
    port             = var.backend_port
    weight           = 1
    target_group_ids = [yandex_alb_target_group.backend.id]

    load_balancing_config {
      panic_threshold = 0
    }

    healthcheck {
      healthcheck_port    = var.backend_port
      timeout             = "3s"
      interval            = "10s"
      healthy_threshold   = 2
      unhealthy_threshold = 3

      http_healthcheck {
        host              = var.domain
        path              = "/"
        expected_statuses = [200]
      }
    }
  }
}

resource "yandex_alb_http_router" "this" {
  folder_id = var.folder_id
  name      = "external-backend-router"
}

resource "yandex_alb_virtual_host" "this" {
  name           = "external-backend-virtual-host"
  http_router_id = yandex_alb_http_router.this.id
  authority      = [var.domain]

  route_options {
    security_profile_id = var.security_profile_id
  }

  route {
    name = "all-paths"

    http_route {
      http_match {
        path {
          prefix = "/"
        }
      }

      http_route_action {
        backend_group_id = yandex_alb_backend_group.this.id
        timeout          = "60s"
      }
    }
  }
}
Managed‑вариант в Terraform
В managed‑варианте для описания того же пути трафика достаточно двух ресурсов: прокси и домена. Пользователю больше не нужно описывать ресурсы — yandex_alb_* или yandex_vpc_*:
resource "yandex_sws_load_balancer" "this" {
  folder_id          = var.folder_id
  name               = "managed-external-backend-proxy"
  region_id          = "ru-central1"
  service_account_id = yandex_iam_service_account.sws_proxy.id

  depends_on = [yandex_resourcemanager_folder_iam_member.sws_proxy]
}

resource "yandex_sws_domain" "this" {
  load_balancer_id    = yandex_sws_load_balancer.this.id
  name                = "protected-domain"
  server_name         = var.domain
  security_profile_id = var.security_profile_id

  http_listener = {
    enabled = true
    port    = 80
  }

  http_backend = {
    target = [
      {
        ip_address = var.backend_ip
        port       = var.backend_port
      }
    ]
  }
}
Прокси также нужен сервисный аккаунт с необходимыми ролями. Это служебная IAM‑настройка, а не описание трафикового контура, поэтому вынесем её отдельно:
resource "yandex_iam_service_account" "sws_proxy" {
  folder_id   = var.folder_id
  name        = "sws-domain-proxy"
  description = "Service account for the managed SWS proxy"
}

resource "yandex_resourcemanager_folder_iam_member" "sws_proxy" {
  for_each = toset([
    "certificate-manager.admin",
    "logging.writer",
    "monitoring.editor",
    "smart-web-security.admin",
  ])

  folder_id = var.folder_id
  role      = each.value
  member    = "serviceAccount:${yandex_iam_service_account.sws_proxy.id}"
}
Вместо топологии инфраструктуры конфигурация Terraform теперь описывает намерение: «Защищать этот домен этим профилем и отправлять разрешённые запросы на этот бэкенд». Сеть, балансировщик, маршруты и остальные внутренние зависимости создаёт и сопровождает сервис. Для production‑конфигурации вам понадобятся сертификат и блок tls_listener.
Профиль безопасности
Профиль безопасности описывает правила фильтрации трафика. Для обоих вариантов он одинаков.
Включаем Smart Protection на всех путях, а запросы к /block-me блокируем для теста. Smart Protection использует машинное обучение, чтобы выявлять подозрительные запросы и блокировать их или отправлять пользователей на проверку с помощью капчи.
resource "yandex_sws_security_profile" "this" {
  folder_id                = var.folder_id
  name                     = "alb-abd-security-profile"
  default_action           = "ALLOW"
  disallow_data_processing = false

  security_rule {
    name     = "block-path"
    priority = 1000

    rule_condition {
      action = "DENY"

      condition {
        request_uri {
          path {
            exact_match = "/block-me"
          }
        }
      }
    }
  }

  security_rule {
    name     = "smart-protection"
    priority = 999900

    smart_protection {
      mode = "FULL"
    }
  }
}
Что мы хотели дать пользователю
Собственно, нашу цель можно сформулировать одной фразой: из готовых облачных компонентов собрать один простой для пользователя сервис.
В новой схеме пользователь выполняет несколько шагов:
Создаёт прокси‑сервер и домен, задаёт адреса и протоколы целевых ресурсов.
Меняет A‑запись у своего DNS‑провайдера: указывает новый IP‑адрес вместо старого.
В фаерволе своих бэкендов устанавливает правило: принимать трафик только с доверенных подсетей Smart Web Security.
Готово: сайт под защитой
Снаружи это выглядит как несколько полей в интерфейсе и одна смена DNS‑записи. Внутри создание прокси‑сервера и домена запускает продолжительную распределённую операцию.
Как выполняются изменения
Целевое и фактическое состояние
Создать защищающий прокси — значит согласованно создать и связать множество ресурсов ALB и VPC. Одни облачные операции завершаются быстро, другие занимают заметное время. Внешний вызов может вернуть временную ошибку, потерять ответ или зависнуть, а процесс‑исполнитель — перезапуститься.
При этом жизненный цикл не заканчивается на создании. Прокси можно обновить, остановить, снова запустить или удалить. Более того, пользователь может отправить новый запрос на изменение (Update), не дожидаясь завершения предыдущего: заставлять его ждать применения конфигурации перед каждым следующим изменением было бы неудобно.
Так появились два состояния, которые нельзя смешивать:
Целевое — конфигурация, которую сервис уже принял от пользователя.
Фактическое — ресурсы и связи, которые к этому моменту успели появиться в контуре обработки трафика.
Задача управляющей системы — после сбоев, повторов и отмен всё равно привести фактическое состояние к последней принятой конфигурации.
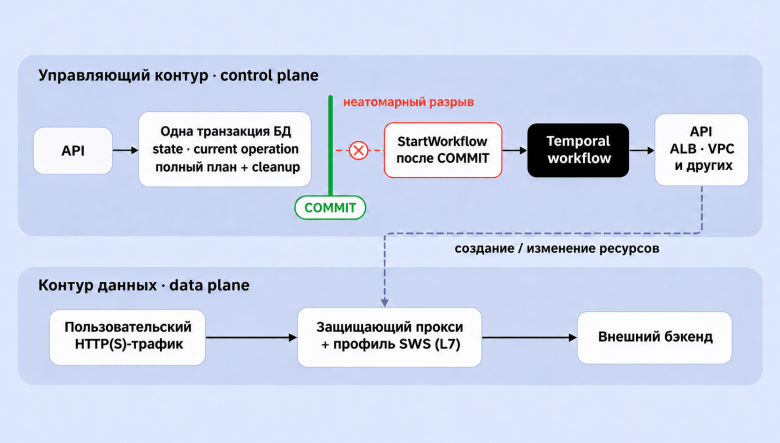
В первой версии мы решили, что новая команда на изменение ресурса отменяет предыдущую пользовательскую операцию. Начнём с этой схемы, а дальше разберём, почему её пришлось изменить.
Что такое Temporal
Коротко разберёмся, что такое Temporal и зачем он нужен. Представьте, что нам надо перевести деньги с одного банковского счёта на другой.
Если оба счёта обслуживает одна система и их состояния хранятся в одной базе, списание и зачисление можно выполнить в одной транзакции: либо применятся оба изменения, либо не применится ни одно. Но пусть счета находятся в разных банках. Тогда перевод превращается в последовательность вызовов двух независимых систем. Общей базы и транзакции, которая атомарно охватит оба внешних API, у них нет.
После успешного списания запрос на зачисление может завершиться ошибкой, зависнуть или потерять ответ. При этом принимающая система могла уже зачислить деньги. Значит, запрос нужно уметь безопасно повторить, не допустив двойного зачисления. А если после проверок оказалось, что зачисление не проведено, недостаточно просто завершить функцию с ошибкой: нужно выполнить компенсирующее действие и вернуть деньги на исходный счёт.
Такой возврат — не автоматический откат транзакции, а ещё одна внешняя операция. Она тоже может завершиться ошибкой и потребовать повторного выполнения. Это упрощённый пример паттерна Saga: каждый шаг изменяет состояние только своей системы, а уже выполненные шаги при необходимости компенсируются отдельными действиями.
В Temporal такой длительный процесс описывается как workflow, а обращения к внешним системам выполняются в activity. Temporal сохраняет историю выполнения, повторяет неуспешные шаги по заданной политике и продолжает работу после перезапуска воркера. Но он не объединяет внешние системы в одну транзакцию и не придумывает компенсации: порядок действий, правила безопасных повторов и логику компенсации по‑прежнему проектирует разработчик.
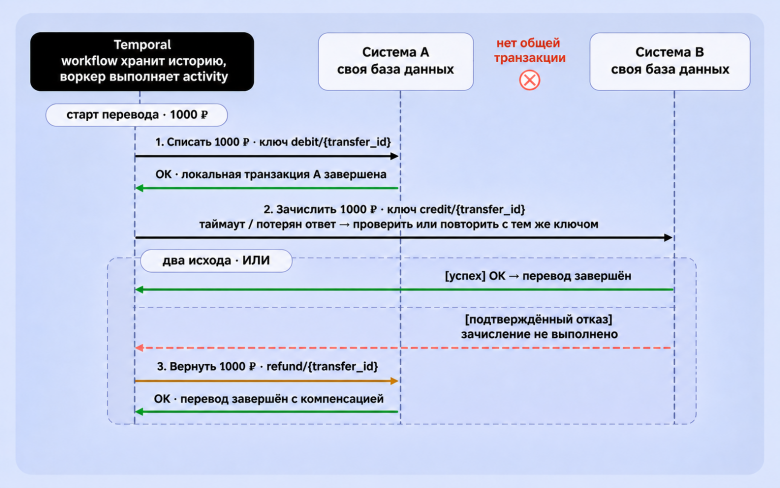
Другие примеры с визуализацией и вариантами кода можно посмотреть на сайте Temporal.
Также о практических нюансах работы с Temporal коллега из команды Яндекс Еды рассказал в статье «Не наступайте на наши грабли, если собираетесь использовать Temporal».
Пользовательская операция и workflow
Вернёмся к нашей задаче.
Пользователь видит стандартную облачную операцию. Её статус показывает, выполняется ли изменение, завершено оно или отменено.
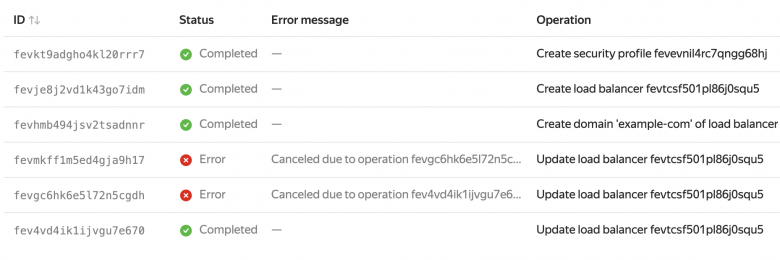
Update подряд, из которых два были отменены и только последний дошёл до концаРеальную работу с инфраструктурой выполняет workflow в Temporal. Одной пользовательской операции соответствует один workflow, состоящий из небольших шагов — activity: создать адрес, настроить роутер, обновить балансировщик, дождаться завершения внешней операции.
Уже успешно завершённые activity при воспроизведении истории заново не выполняются: workflow получает их сохранённые результаты и идёт дальше. Так он продолжает выполнять сохранённый план после перезапуска воркера.
Однако очередь запусков не гарантирует, что workflow начнут работу в порядке пользовательских команд. Запуск может потребовать нескольких попыток, поэтому старый workflow способен стартовать с задержкой — даже после отмены своей пользовательской операции.
Сначала сохраняем план
Для асинхронных операций, которым предстоит изменить контур данных, последовательность начинается не с вызова API ALB или VPC, а с одной транзакции в базе сервиса. В ней мы:
Проверяем, допустима ли команда в текущем состоянии ресурса.
Фиксируем новое целевое состояние и создаём операцию.
Отменяем предыдущую операцию, если она ещё не завершена, и назначаем новую текущей.
Составляем и сохраняем план, который должен привести контур данных к целевому состоянию.
План — это не название следующего шага, а полный набор действий: что создать и удалить, что связать и отвязать. Он сразу учитывает удаление ресурсов, которые могла оставить отменённая операция.
Только после фиксации транзакции начинается исполнение. Если управляющий процесс перезапустится, намерение пользователя и план не исчезнут вместе с ним. А когда план выполнен, ещё одна транзакция завершает пользовательскую операцию и переводит ресурс в соответствующее итоговое состояние.
Так в каждый момент у прокси есть только одна текущая пользовательская операция.
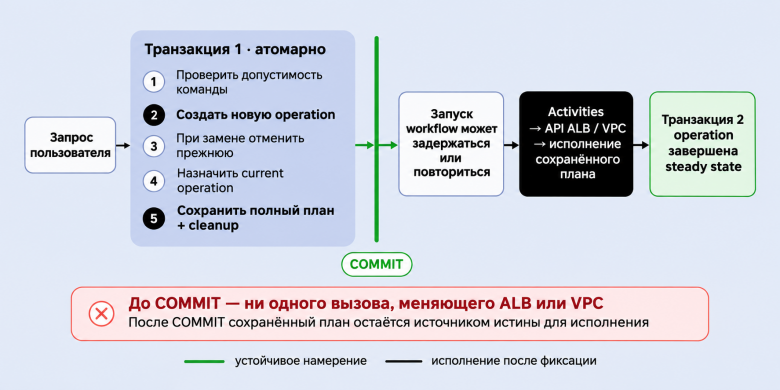
Запись в базу данных и запуск Temporal workflow нельзя выполнить одной атомарной операцией: запись может завершиться успешно, а запуск — не произойти. Тогда пользовательская операция зависнет навсегда. Чтобы этого избежать, в той же транзакции БД команда попадает в отдельную устойчивую очередь запусков (outbox). Асинхронный процесс читает её и запускает workflow после COMMIT. Он может повторно отправить ту же команду, поэтому запуск дедуплицируется по стабильному идентификатору workflow.
Что усложняет отмена
Workflow могут стартовать не по порядку
Если просто запускать workflow по мере их появления, запоздавший старый процесс может начать менять инфраструктуру одновременно с новым.
Представим ситуацию: пользователь отправил новую команду, и созданная для неё operation2 отменила предыдущую operation1. Для каждой операции асинхронно запускается свой workflow: workflow1 и workflow2. Но порядок их фактического запуска не гарантирован:
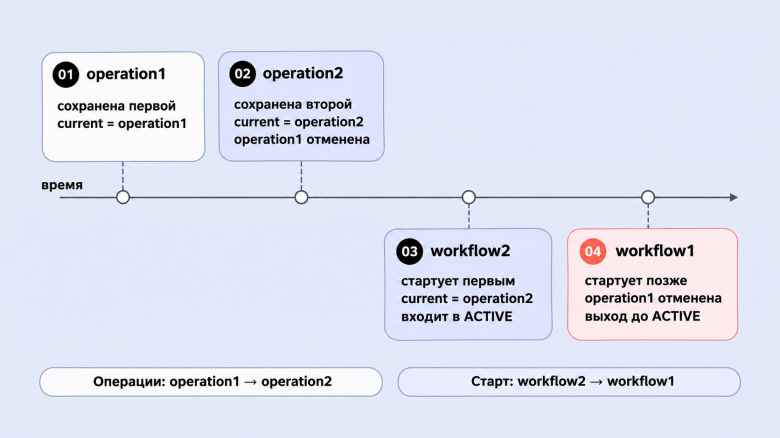
workflow может отличаться от порядка создания пользовательских операцийПоэтому workflow2 должен знать всю цепочку незавершённых предшественников, а не только workflow1: к моменту отмены тот мог ещё не успеть остановить workflow0. Перед изменением инфраструктуры workflow2 дожидается появления каждого предыдущего workflow, запрашивает его отмену и ждёт, пока вся цепочка завершится.
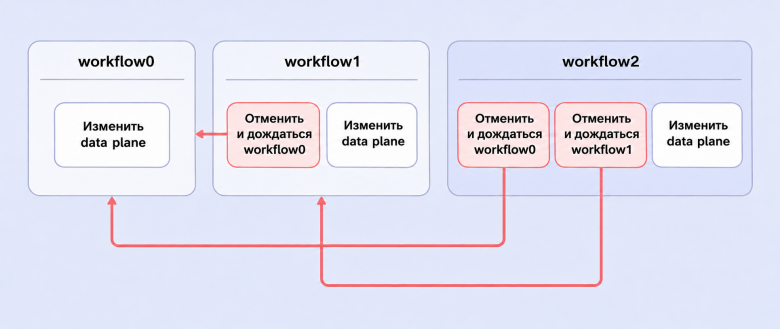
Workflow2 начинает менять инфраструктуру, только когда workflow0 и workflow1 больше не выполняютсяИтого в каждый момент времени инфраструктуру меняет только один workflow (но есть нюанс, о котором поговорим ниже).
Остатки отменённой операции
Осталась нерешённой другая проблема: старая операция могла уже выполнить часть плана. Рассмотрим прокси, который находится в рабочем состоянии. Пользователь запускает обновление и добавляет домен 1.example.com. А workflow1 успевает создать для домена ресурсы HTTP router и virtual host, но ещё не успевает применить эту конфигурацию к балансировщику. Затем пользователь отправляет новый Update и меняет домен на 2.example.com.
В транзакции второго обновления первая операция отменяется, а новая становится текущей. Одновременно сервис сохраняет новый план. Он должен не только создать конфигурацию для 2.example.com, но и удалить то, что успел оставить незавершённый план для 1.example.com.
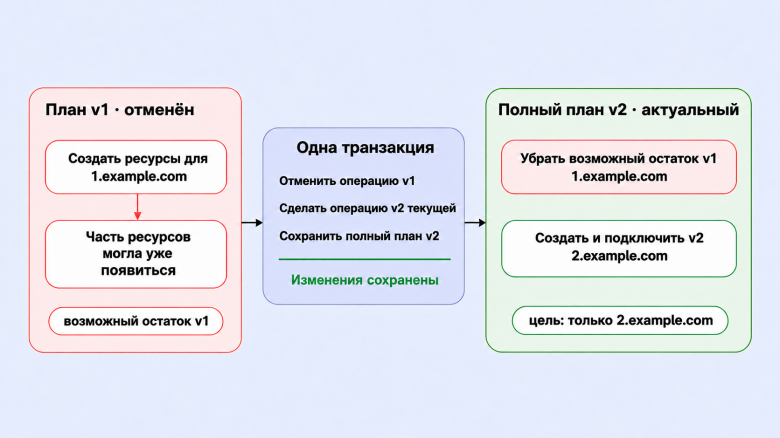
Мы не знаем наверняка, успел ли workflow1 создать эти ресурсы. Но у нас есть план, которого мы придерживаемся, operation2: в нём записано, какие ресурсы могли создаться и какие из них нужно удалить.
Почему мы отказались от отмен
Повторы activity должны быть идемпотентными
Мы защитились от конкуренции разных пользовательских операций. Но внешние вызовы внутри одного плана тоже должны безопасно переживать повторное выполнение.
Один из шагов нашего workflow — обратиться к API VPC и создать IPv4-адрес. Вот фрагмент первой наивной реализации этой activity:
func (worker *Worker) CreateVpcAddressActivity(ctx context.Context, details pb.CreateOperationDetails) (*pb.CreateVpcAddressResult, error) {
  createOp, err := worker.VpcServiceClient.Address.Create(ctx, &vpcrpc.CreateAddressRequest{
    FolderId:           worker.Args.AntirobotDataFolderID,
    Name:               "balancer-" + details.LoadBalancer.Profile.Id,
    AddressSpec: &vpcrpc.CreateAddressRequest_ExternalIpv4AddressSpec{
      ...
    },
  })
  if err != nil {
    return nil, err
  }
  return &pb.CreateVpcAddressResult{
    CreateVpcAddressOperationId: createOp.Id,
    OperationResult:             getOperationMetadata(createOp),
  }, nil
}
Что может пойти не так? Много чего:
Createотвалится по сети, запрос не дойдёт до сервиса. Temporal повторитactivityпо заданной политике, и она снова попробует создать адрес.Createотвалится по сети после того, как сервис принял запрос. Адрес реально начал создаваться, мы просто не получилиgRPC response. Когдаactivityперезапустится, запрос упадёт с ошибкойaddress with name 'balancer-xxx' already exists. Первое, что приходит в голову, — добавить вызовGetпередCreateи проверить, нет ли уже такого адреса с таким именем.Где‑то в районе директивы
returnсервер отключается по питанию. Ничего страшного, функция запустится на другом воркере, и мы приходим в пункт 2.Более сложный и самый неприятный сценарий. Функция зависла где‑то в начале: виртуалка перегружена и процессу не хватает процессорного времени или зависло обращение к API. Шедулер Temporal видит, что
activityне отправлялаheartbeat, и запускает его заново. Эту операцию уже могли отменить и рассчитывали, что она отменена. И вдруг внезапно воркер через час оживает и начинает выполнять деструктивные действия.
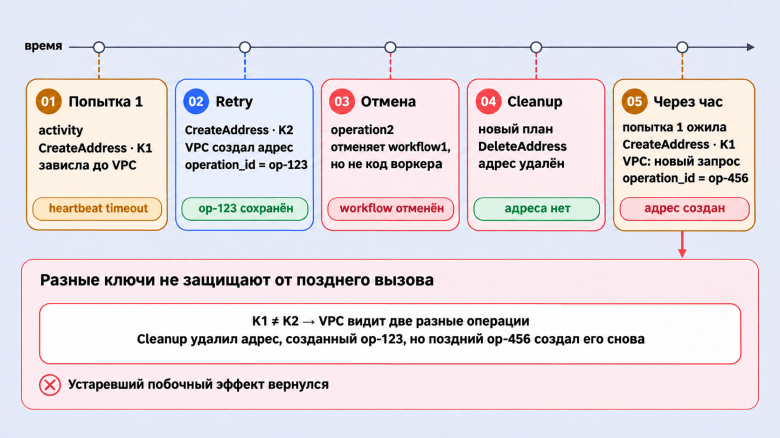
cleanup выглядит для VPC как новый Create и снова создаёт адресИменно поэтому все activity должны быть идемпотентными. Другими словами, повторный запуск activity через час с теми же параметрами должен вернуть тот же результат, даже если в коде написано «создай адрес», а адрес давно создали и уже успели удалить.
API Yandex Cloud поддерживает механизм идемпотентности. Передаём Idempotency-Key: <UUID> в Create‑запрос и гарантируем, что реальное создание ресурса выполнится только один раз. Все последующие вызовы будут возвращать существующий operation_id.
Idempotency-Key должен быть сгенерирован на стадии плана.
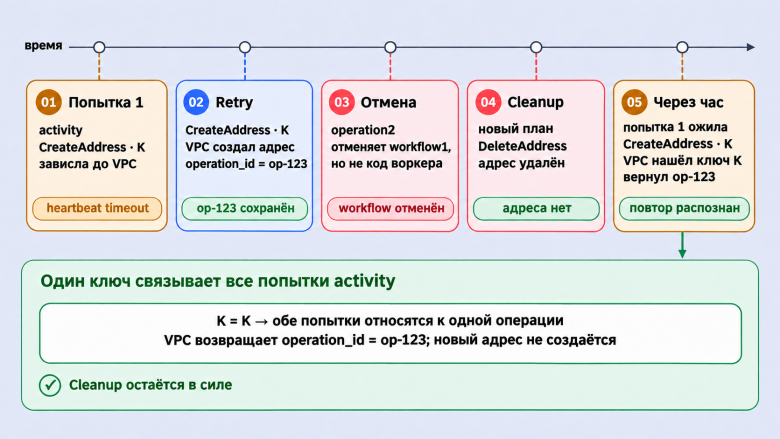
operation_id без нового побочного эффектаИтого отмена старого workflow не гарантирует, что уже начатые им вызовы не приведут к побочным эффектам. Подробнее этот механизм описан в документации Temporal.
Идемпотентности недостаточно
Краевые случаи на этом не закончились. Представим ситуацию, когда первая попытка зависла ещё до первого обращения к API. По новому плану этот ресурс — в нашем примере адрес — уже не нужен. Старая попытка просыпается через час и создаёт уже ненужный ресурс. Для API это первое обращение с таким ключом, поэтому механизм идемпотентности не предотвратит создание.
Вывод: небезопасно просто отменять уже выполняющийся workflow.
Получается, архитектура с отменами не учитывала этот сценарий, хотя успешно работала в проде: на практике таких случаев ещё не возникало.
Если workflow успел выполнить внешние действия с побочными эффектами, нужно либо предусмотреть компенсирующие действия при отмене workflow (как в примере с переводом денег), либо дать ему завершиться.
Очередь вместо отмен
Давайте минимально изменим архитектуру и пойдём по второму пути: текущий workflow всегда выполняется до конца, а следующие операции попадают в отдельную очередь операций ресурса. Это не outbox запусков, описанный выше.
В этой очереди достаточно хранить только последний элемент, так как задача операции — довести ресурс до конечного состояния. Изменения current_operation и operations_queue выполняются в одной транзакции и сериализуются по ресурсу, поэтому одноэлементная очередь остаётся консистентной.
Таким образом, операции над ресурсом делятся на те, для которых workflow выполняется до конца, и те, которые «схлопнулись» в очереди.
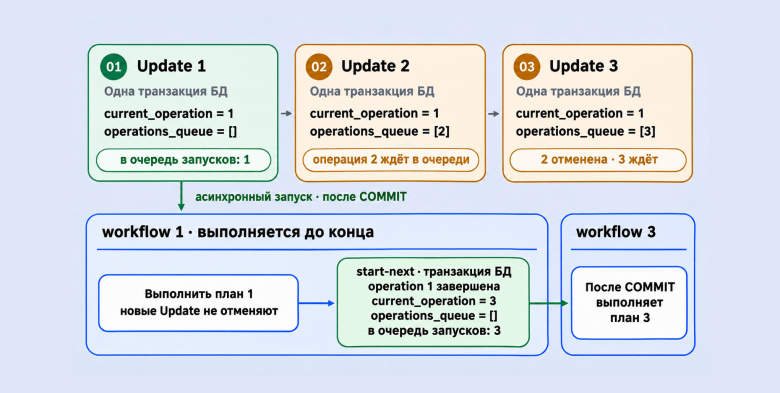
workflow доходит до конца, а одноэлементная очередь схлопывает промежуточные операции до последней целиНа практике из‑за различных багов иногда всё же приходится отменять workflow. Это делают только вручную и под контролем.
Что остаётся пользователю
Для пользователя граф облачных компонентов превратился в несколько понятных сущностей: прокси‑сервер, домен, целевые ресурсы, сертификат и профиль безопасности. Ему больше не нужно разбираться в устройстве VPC и ALB, вручную собирать промежуточную инфраструктуру.
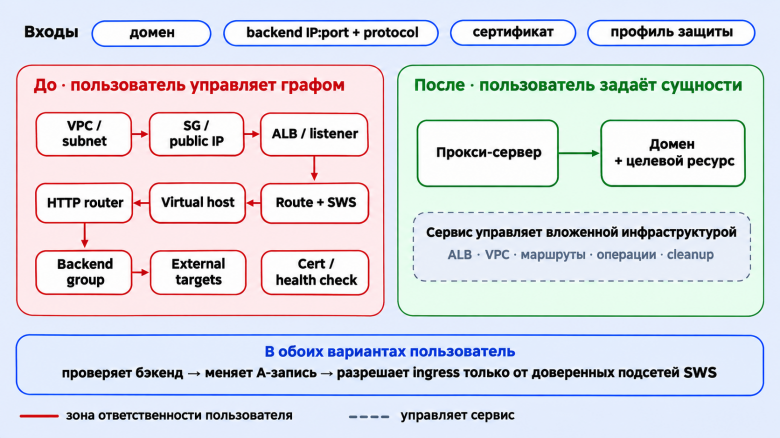
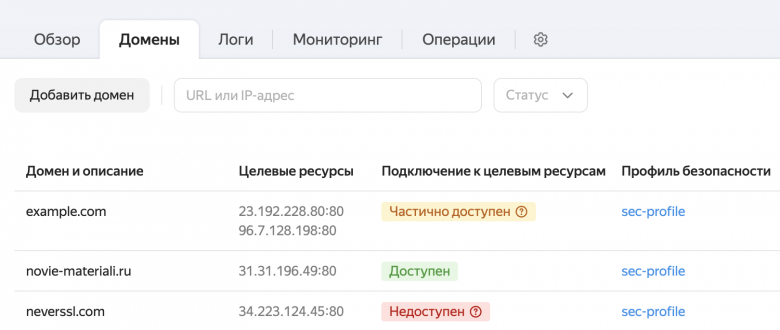
После создания прокси‑сервера и домена остаётся переключить A‑запись и настроить фаервол на бэкендах.
Закрываем прямой доступ к бэкенду
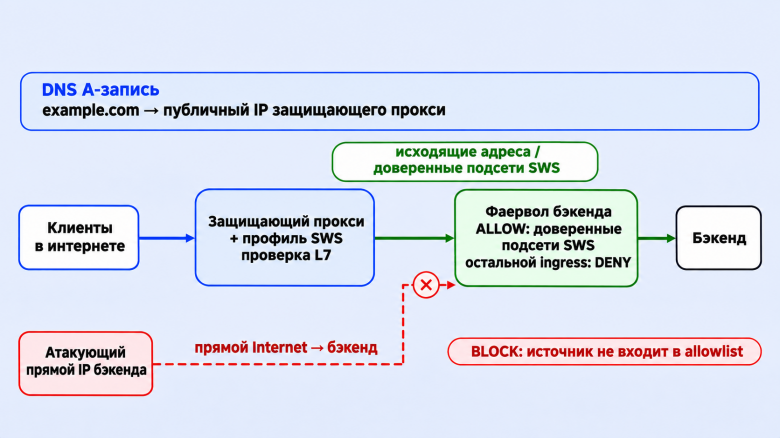
Переключить DNS недостаточно. Если публичный IP‑адрес бэкенда остаётся доступен всему интернету, атакующий может обратиться к нему напрямую и обойти Smart Web Security.
Поэтому после проверки новой схемы на стороне бэкенда нужно запретить произвольные входящие соединения и разрешить трафик только с адресов Smart Web Security.
Интеграция с SolidWall WAF
На конференции Scale 2026 в сентябре Yandex Cloud анонсировала новое продуктовое направление Yandex Security, которое объединило ИБ‑решения команд безопасности Yandex Cloud и SolidLab. Объединённая команда развивает защиту для облачных, мультиоблачных, гибридных и локальных сред.
Одно из этих решений — SolidWall WAF, модуль защиты веб‑приложений и API. Он полезен, когда нужна защита с учётом бизнес‑логики конкретного приложения: среди его возможностей — анализ ответов сервера и последовательности действий пользователя для выявления сложных атак.
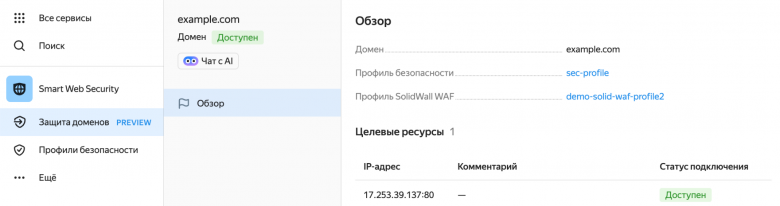
Ранее пользователи самостоятельно разворачивали виртуальные машины из образа SolidWall WAF. Теперь мы добавили нативную интеграцию с SolidWall WAF в рамках «Защиты доменов» в Smart Web Security. Пользователю больше не нужно администрировать кластер фильтрующих узлов — достаточно создать профиль SolidWall WAF и подключить его к домену.
Для управления инфраструктурой интеграции мы использовали тот же механизм, который описали выше. Теперь не нужно самостоятельно администрировать кластер фильтрующих узлов — достаточно создать профиль и подключить его к домену. Функция уже доступна в Public Preview через консоль управления Yandex Cloud.
Что я вынес из этой работы
Мы хотели упростить подключение защиты для сайтов, которые работают в собственной инфраструктуре или у другого провайдера. Теперь пользователю не нужно вручную собирать и сопровождать промежуточную инфраструктуру из ресурсов VPC и ALB: он задаёт домен и бэкенд, подключает профиль безопасности, переключает DNS и настраивает доступ к бэкенду. Создание и сопровождение прокси берёт на себя сервис.
Задача изначально выглядела очень простой, и я всерьёз подумывал: «Может, не тащить этот Temporal в проект? Может, сделать на коленке state‑машину?»
Сделать сценарий, который один раз успешно создаёт инфраструктуру, сравнительно просто. Гораздо сложнее добиться, чтобы он предсказуемо переживал потерянные ответы, поздний запуск процессов, повторы, отмены и новые действия пользователя.
Главный вывод для меня звучит так: надёжный оркестратор помогает сохранить ход выполнения и продолжить процесс после сбоя, но не делает распределённую систему корректной автоматически. В каком порядке выполнять внешние действия, что должна означать отмена и как удалять ресурсы, оставшиеся после незавершённых операций, — всё это нужно спроектировать самим.