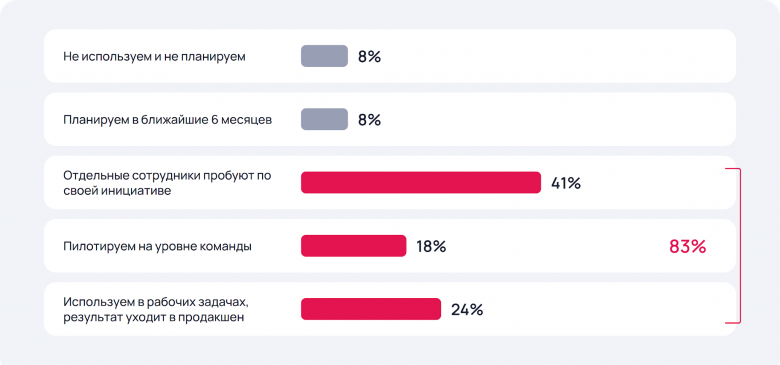
Код с помощью ИИ генерируется за считаные минуты, а обещанного ускорения команда может так и не увидеть. После генерации остаются проверка, исправления, тестирование и выпуск, на которые разработчики тратят часы. По исследованию SimpleOne, искусственный интеллект уже применяют 83% команд, однако только 24% сообщили, что выпускают созданные с его помощью изменения в рабочие системы.
Разберем, что мешает доводить ИИ‑код до релиза, какие вопросы возникают у руководителя разработки и как выглядит задача, в которой агенты работают от подготовки требований до установки на тестовый стенд.
Код генерируют, а выпускать не выпускают
В исследовании SimpleOne ответили 71 специалист: 46% руководителей разработки, 24% разработчиков, 15% аналитиков и 15% других ролей. Из компаний больше 1 000 человек пришли 71% респондентов, из компаний больше 5 000 — 36%.
По результатам опроса у 41% респондентов отдельные сотрудники экспериментируют с ИИ по собственной инициативе, еще 18% проводят командные пилоты. О регулярном использовании в рабочих задачах, когда результаты уходят в продакшен, сообщили 24%.
Еще 23% опрошенных затруднились ответить, какая доля кода и конфигураций, созданных с ИИ, доходит до продакшена. Возможно, изменения выпускают, но отдельно их никто не отслеживает. Тогда руководителю сложно оценить пользу инструмента по завершенным задачам.
Есть еще один показательный момент. Сейчас 60% опрошенных используют ИИ для написания кода и конфигураций. Генерация уже ускорилась, но остальные этапы разработки во многих командах остались прежними.
Генерируете код — с вас спросят
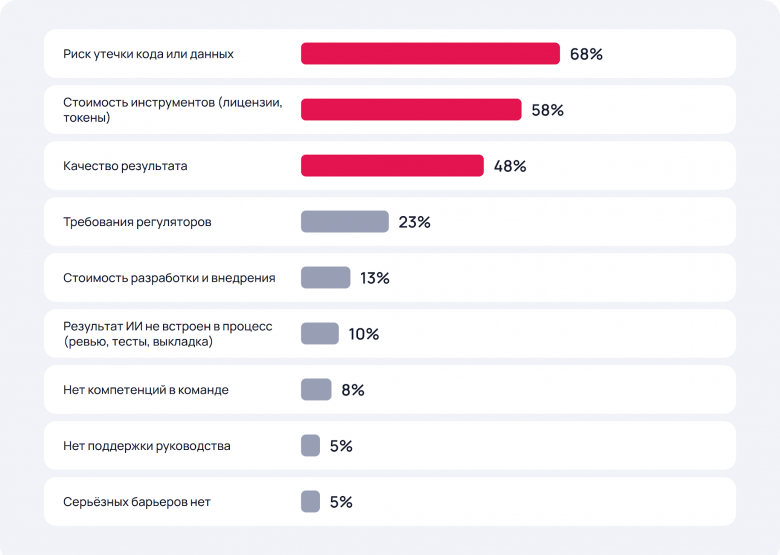
Руководителю разработки мало увидеть работающий прототип. Перед выпуском ему придется оценить трудозатраты, убедиться в соблюдении правил безопасности и проверить, что изменение решает исходную задачу. Эти три вопроса напрямую связаны с барьерами, которые назвали участники исследования.
Экономит ли это время?
Почти половина участников исследования (48%) ожидают ускорения разработки минимум в полтора раза. Еще 31% не могут оценить эффект. Если сравнивать только скорость написания кода, выигрыш может выглядеть внушительно, но подготовка контекста и исправление результата тоже занимают рабочее время.
Предположим, обычная доработка занимала 16 часов. С ИИ на описание задачи ушло два часа, на генерацию — полчаса, на ревью — четыре часа и еще пять часов на исправления. Суммарно получилось 11,5 часов: экономия составила 4,5 часа, или около 28% трудозатрат.
А если агент неверно поймет требования? Повторные исправления займут девять часов, итог вырастет до 15,5 часов. Генерация по‑прежнему длилась полчаса, а вот выигрыш практически исчез. Поэтому эффект стоит считать по принятой доработке целиком, добавляя к трудозатратам расходы на модель.
С какими данными работал агент?
Для небольшого фрагмента кода агенту может хватить нескольких предложений. При работе с существующим корпоративным приложением ему понадобится контекст: структура репозитория, правила проекта, конфигурация стенда, сведения о таблицах и зависимостях.
Например, разработчик просит исправить ошибку авторизации и передает агенту журналы приложения. Если отправить их целиком, вместе с техническими записями в модель могут попасть пользовательские идентификаторы, токены и другие персональные данные. Риск утечки кода или данных назвали главным препятствием 68% участников, еще 23% указали на требования регуляторов.
До подключения агента команде нужно определить, какие репозитории и стенды ему доступны, какие данные разрешено передавать и с какими моделями можно работать. Полезно сохранять историю запросов и изменений: при разборе инцидента она поможет установить, какие сведения использовал агент и кто подтвердил отправку результата на стенд.
Как понять, что получилось качественно?
Качество результата беспокоит 48% участников опроса. При этом 61% готовы поручить агентам тестирование. Здесь возникает риск: агент может написать реализацию и тесты по одному описанию задачи, одинаково ошибившись в трактовке требований.
Допустим, руководитель поддержки просит показать долю задач, решенных в срок. В системе несколько статусов закрытия, включая отмененные и отклоненные обращения. Агент учитывает все закрытые задачи, пишет тест под этот расчет и успешно его проходит. На экране появляется цифра, которая не соответствует правилам работы службы поддержки.
Поэтому критерии приемки нужно согласовать до генерации. Владелец процесса определяет, какие статусы относятся к решенным задачам, а инженер сверяет расчет с эталонным набором записей. Другие агенты могут проверить реализацию по спецификации и запустить сценарии, но спорные бизнес‑правила и решение о приемке остаются за ответственным специалистом.
Посмотрим на доработку с агентами: дашборд за 17 часов
На вебинаре SimpleGen владелец продукта показал задачу, которую команда провела от постановки до работающей функциональности на тестовом стенде. В эфире разбирали историю сессий разработки, возникавшие ошибки и итоговый результат. Саму многочасовую генерацию выполняли заранее.
Нужно было создать дашборд для руководителя службы поддержки: один экран с фильтрами по периоду, группе и типу задач. На нем отображаются поток обращений, скорость обработки, узкие места и показатели качества. Руководитель может задавать целевые значения, при их нарушении соответствующий показатель подсвечивается.
Задача требовала вычисляемых показателей, нескольких источников данных, отдельного справочника целей и правил доступа. Поэтому команда использовала SimpleGen, который помогает разрабатывать решения на платформе SimpleOne с участием ИИ‑агентов.
Сначала агент занялся требованиями. Он задал автору 28 уточняющих вопросов: какие статусы считать решенными, как рассчитывать медианное время реакции и учитывать ли отрицательный баланс потока. Нашлись и расхождения со стендом. В постановке упоминались три таблицы задач, а на стенде оказалось десять таблиц‑наследников, которые тоже нужно было учитывать.
Спецификацию проверял второй агент, после чего автор исправлял спорные места. Всего потребовалось 11 итераций; на подготовку и согласование требований ушло 5,5 часов. Затем агенты разделили работу на 11 фаз и 42 задачи с зависимостями. Планирование заняло еще полтора часа.
Дальше началась генерация по фазам. Один агент писал код, другой сверял изменения с требованиями и планом. Затем команда отправляла их на стенд. Уже при отправке первой фазы стенд дважды вернул ошибку: причиной оказалась, в частности, длинная русскоязычная подсказка. Агент предложил изменить текст, согласовал правку и повторил отправку.
Позже возник конфликт с формой, которую платформа автоматически создала вместе с таблицей. При очередном обновлении агент попытался создать ее повторно. Команда синхронизировала состояние стенда с репозиторием и продолжила работу с существующей формой. Код‑ревью выявило и другие расхождения: неверное значение по умолчанию, недостаточные права доступа к отчету и ошибочную подпись.
Проверку готового дашборда тоже поручили агентам. Они подготовили сценарий показа и демонстрационные данные, а затем запустили сценарий в браузере. Из 28 шагов агент выполнил 25 за семь минут; еще три требовали действий, связанных с авторизацией, которые по внутренним правилам он не выполняет. Во время прогона обнаружились пустой блок и невидимые подсказки к полям целей. После согласования агент обновил спецификацию, план, код и конфигурацию.
После дополнительного редизайна команда пересобрала пакет изменений и установила его на чистый тестовый стенд. Установка прошла без конфликтов, ошибок и предупреждений.
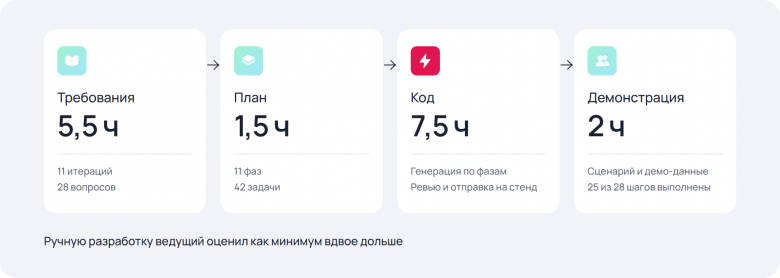
В общей сложности доработка заняла около 17 часов, включая подготовку требований, планирование, генерацию кода и проверку результата. За это время команда прошла 11 итераций согласования спецификации, реализовала 42 задачи и проверила дашборд по 28 шагам демонстрационного сценария. После исправлений пакет изменений установили на чистый тестовый стенд без конфликтов, ошибок и предупреждений.
За время воркшопа в Claude Code израсходовали 786 330 токенов. Весь объем работы уложился в месячную подписку за $20 с моделью Opus 5, без превышения лимитов и дополнительных платежей.
Для корпоративного использования с повышенными требованиями к безопасности компании могут рассматривать работу через API. По расчетам команды, тот же объем исходящих токенов обошелся бы в $19,66. К этой сумме добавилась бы стоимость входящих токенов, поэтому итоговые расходы зависели бы от объема передаваемого контекста.
Какие задачи команды отдали бы ИИ‑агентам
По исследованию SimpleOne, на всех этапах жизненного цикла разработки ИИ используют только 23% опрошенных. Потребность в автоматизации за пределами генерации уже есть, хотя на практике к этим задачам ИИ подключают существенно реже.
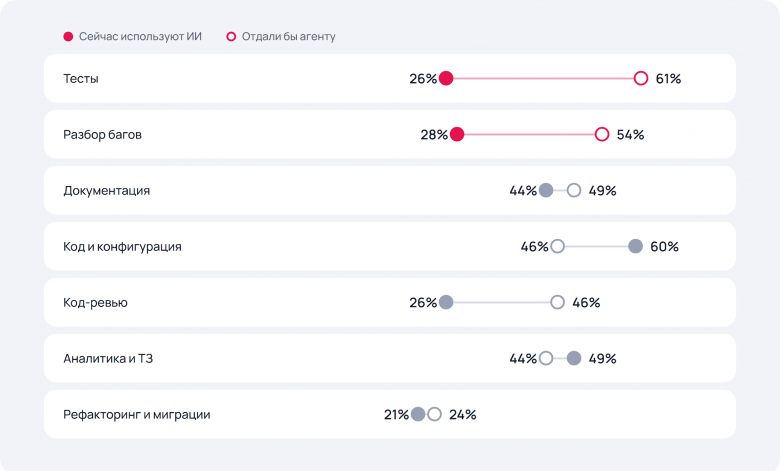
Разрыв заметнее всего в тестах: сейчас ИИ помогает 26% участников, а агентам их доверили бы 61%. В разборе багов показатели составляют 28% и 54%, в код‑ревью — 26% и 46%. С кодом обратная картина: ИИ пишет его у 60% участников, а агенту его отдали бы 46%.
История с дашбордом показывает, где может появиться дополнительный эффект. Агенты помогали уточнять бизнес‑логику, сопоставлять требования с реальным стендом, проверять изменения и находить дефекты при демонстрации. На каждом этапе у человека оставалась возможность согласовать спорное решение и проверить результат.
Если команда уже генерирует код с ИИ, полезно взять последнюю завершенную доработку и записать, сколько времени ушло на постановку, генерацию, ревью, исправления и выпуск. Возможно, код появился за полчаса, а несколько дней потратили на уточнения или проверку. Тогда следующий этап для подключения агента станет очевиден из собственных цифр.
Полные результаты исследования опубликованы на сайте SimpleOne. А на каком этапе последняя доработка с ИИ задержалась у вашей команды?
InsiderCrush
Найс! Теперь учитываем что в прод такой код выпускаю только после проверки сеньором или очень компетентным мидлом. И считаем 17 часов их работы. У меня вышло примерно час работы от 2500 до 3500. Умножаем на 17 и получаем 42500-59500 руб.
SimpleOne_it Автор
Полностью согласны с вашим наблюдением. Если ревьюить каждую строку сгенерированного кода вручную, скорость потока действительно упрется в человека, и экономия на разработке на этапе проверки будет минимальной
Но здесь есть и важный нюанс: когда ИИ генерирует код по спецификации и СОП, основная ценность специалиста смещается с написания кода на архитектурный контроль и ответственность за продакшен. В enterprise-проектах цена ошибки в безопасности, интеграциях или утечке данных несоизмеримо выше стоимости часа сеньора.
Поэтому, как вы справедливо заметили, оптимальный путь это оптимизировать процесс и делить ревью на уровни. Мы как раз двигаемся в этом направлении и поставляем пул готовых команд для ревью вместе с пайплайнами, а модуль тестирования выйдет в релиз уже ближайшее время
Рутину, соответствие ДСЛ, базовые тесты и покрытие спецификации должны забирать на себя такие автоматизированные пайпы и ИИ-ревьюеры. А человек подключается точечно, проверяет бизнес-логику, критичные узлы и архитектурную целостность. Тогда и скорость потока сохраняется, и контроль остается.