Если упростить, в Databricks с таблицами Unity Catalog работают двумя принципиально разными способами.
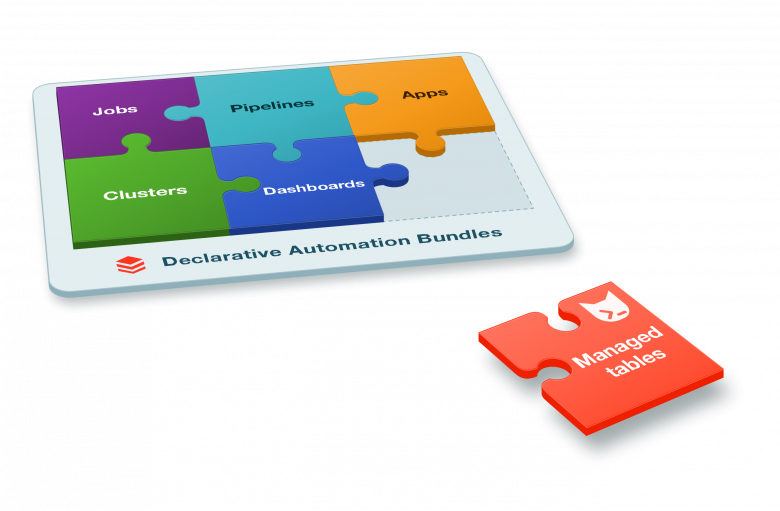
Streaming Tables и Materialized Views - принадлежат пайплайну. Схема таблицы наследуется из SQL запроса, а создаёт и обновляет её сам пайплайн. Для такой жизни у Databricks есть всё: SDP (до недавнего времени DLT), сам пайплайн лежит в git, выкатывается через Declarative Automation Bundles (бывшие Databrick Asset Bundles) на нужную среду, попутно проходя ревью и CI/CD.
Второе большое множество - это обычные таблицы, managed и external. У такой таблицы есть собственное определение: колонки, типы, комментарии, кластеризация. Ее создают отдельно через DDL-скрипт. Писать в неё может кто угодно - джобы, пайплайны, ноутбуки - да хоть просто в SQL-редакторе выполни INSERT (не является рекомендацией). В списке ресурсов DAB такой таблицы нет (и скорее всего не предвидится в ближайшее время, так как весь мир ииб*улся занят ИИ-гонкой и релизит связаные с этим фичи). Поэтому на каждом проекте команде для них приходится придумывать что-то своё.
Каждый решает по-своему
Каждый решает задачу управления и деплоя этих таблиц как он может, учитывая специфику текущего ИТ-ландшафтра, зоопарка фреймворков, прошлого опыта и предпочтений команды. Я наблюдаю это не только по своему опыту. Спрашивал бывших коллег. Спрашивал у посетителей на конференциях и представителей на спонскорских будках. Спросил даже на Reddit. Ответ был один: все решают задачу по-разному, с разной степенью велосипедности и костыльности.
Если заглянуть на Medium, можно встретить довольно распространённый подход (особенно среди молодых инженеров): писать CREATE TABLE IF NOT EXISTS прямо в пайплайнах, называя это schema management. Сам по себе такой подход не обязательно плох, но у него есть неприятное свойство: он работает ровно до тех пор, пока:
кто-то не добавит колонку вне пайплайна;
в одну таблицу не начнёт писать больше одного процесса;
не понадобится добавить колонку в существующую таблицу (
IF NOT EXISTSеё просто пропустит);не придётся переименовать колонку или таблицу, а «миграция» это отдельный ноутбук, который никто не ревьюил;
пайплайн перепишут, и определение таблицы уедет вместе с ним.
Окончательно меня добило другое. Я сменил работу и возглавил команду дата-инженеров в крупной компании. И увидел в джобах всё те же CREATE TABLE IF NOT EXISTS, написанные Сеньором с 7-летним опытом. И меня бомбануло.
Какие решения есть сейчас
Если пытаться собрать, какие решения есть сейчас, то ландшафт получается очень пёстрым: ноутбуки и DDL-скрипты, запускаемые кастомными добами, Terraform с провайдером Databricks, кто-то использует dbt, не забываем и про более специализированные Liquibase и Flyway. У каждого варианта своя цена: state-файл у Terraform, таблица истории и императивные шаги у Liquibase, неконтролируемый Wild West у ноутбуков и ручных скриптов...
А хочется простого: небольшую простую «пришлёпку» к Bundles, чтобы всё жило в одной экосистеме по унифицированным с DAB правилам. Описал/изменил, провалидировал, посмотрел plan, применил из CI.
Я аккуратно поднял этот вопрос на созвоне с нашим Solution Architect на стороне Databricks, отвественным за наш эккаунт, - благо как раз подвернулся повод (обсужлали их планы на релиз одной очень нужно нам фичи). Меня выслушали, честно признались, что такого решения сейчас нет и пообещали поведать нашу боль продуктовой команде. Я понимаю, как такие обращения живут в большой компании - это и подтолкнуло меня начать собственный Open Source проект - так родилась утилита ucat (читать "ю-кэт" - от Unity Catalog)
ucat: коротко о концепте
ucat хранит определения managed-таблиц Unity Catalog в git как YAML, сравнивает их с тем, что на самом деле есть в Unity Catalog, показывает, что изменится, и применяет это. ucat закрывает имеющийся гап в DAB - привносит функционал по управлению managed-таблицами. Определение таблицы - это просто файл, который вы ревьюите, и эта таблица описана в декларативном стиле, изменение схемы проходит через pull request с понятным diff, как любое другое.
Определение таблицы выглядит так:
name: orders
schema: shop
comment: "Orders placed in the shop"
columns:
  - name: id
    type: BIGINT
    nullable: false
    comment: "Unique order id"
  - name: customer_id
    type: BIGINT
    nullable: false
  - name: status
    type: STRING
    comment: "new, paid or shipped"
  - name: amount
    type: DECIMAL(18,2)
  - name: created_at
    type: TIMESTAMP
clustering:
  columns: [id]
То есть вы описывает желаемое состояние таблицы в YAML, ucat читает потом live state Unity Catalog (один REST-запрос на одну схему), определяет diff и генерит DDL-скрипт по приведению таблицы в нужное состояние, а потом выполняет его на SQL Warehouse.
┌────────────┐      ┌────────────┐      ┌──────────────────────┐
│ YAML files │ ───▶ │ ucat plan  │ ◀─── │ Unity Catalog (live) │
└────────────┘      └─────┬──────┘      └──────────────────────┘
                          │
                          ▼
                  ┌───────────────┐
                  │ changes (SQL) │
                  └───────┬───────┘
                          │
                          ▼
                  ┌───────────────┐
                  │  ucat apply   │
                  └───────────────┘
Основные команды:
ucat validate            # локальные проверки
ucat validate -t dev     # + проверки на живом Unity Catalog
ucat plan -t dev         # читает живой Unity Catalog и показывает, что изменится
ucat apply -t dev        # выполняет изменения по одному на SQL warehouse
А вот как это работает в короткой GIF-анимации:

UX ucat намеренно сделан максимально близок к тому, к чему привык дата-инженер работающий с Databricks:
Окружение выбирается флагом
-t, как вdatabricks bundle deploy -t devЦикл «проверить, посмотреть изменения, применить» это
validate, plan, apply, как в Terraform и тех же DAB.
Вот сравнительная таблица основных команд:
Bundles |
Terraform |
ucat |
databricks bundle validate |
terraform validate |
ucat validate |
databricks bundle plan -t dev |
terraform plan |
ucat plan -t dev |
databricks bundle deploy -t dev |
terraform apply |
ucat apply -t dev |
databricks bundle destroy |
terraform destroy |
ucat drop |
–auto-approve |
–auto-approve |
–auto-approve |
ucat не пытается заменить Terraform и не является полноценным аналогом Infrastructure as Code-платформы. Его задача гораздо уже: управление определениями managed-таблиц Unity Catalog в декларативном стиле.
Для авторизации использутеся Databricks CLI и официальный SDK - никаких велосипедов и кастомных авторизаций. Стиль вывода плана тоже будет знаком каждому, кто работал с DAB или Terraform (~ для изменения, итог в виде «to add, to change, to destroy»).
Остальное коротко:
Нет state-файла. ucat каждый раз сравнивает YAML с живым Unity Catalog, поэтому видит и ручные правки.
Одни и те же определения идут в dev, test и prod, по одному target за раз.
Переименования явные: поле
rename_from. Деструктивные изменения (drop table, drop column) просят ввестиyes.Проверки до выполнения: например, неподдерживаемая/несовместимая смена типа колонки, дубликаты таблиц/колонок, взаимоисключающие опции (например кластеризация и партиционирование) ловятся в
validate, так же останавливается на этапе планирования, до любого DDL.Коды выхода и JSON для CI.
Имена схем и каталогов могут быть переопределены на уровне таргета (
-t), что позволяет гибко деплоить в зависимости от ваших нужд: например TEST и PROD - это отдельные изолированные каталоги (в терминах Unity Catalog), а на DEV у каждого разработчика может быть свой собственный каталог вида DEV_USERNAME + shared-песочница DEV_SANDBOX
Установить ucat можно как: brew install ninilich/ucat/ucat, либо бинарник с GitHub Releases, либо go install github.com/ninilich/ucat@lates . Лицензия Apache 2.0 выбрана специально, чтобы не отпугивать корпоративных юристов и legal team: во многих компаниях согласовать добавление чего-то нового в ИТ-ландшафт может быть тем еще челенжем :-)
Чего ucat пока не умеет
Честно: v1 управляет только managed-таблицами. Я сознательно ограничил первую версию только ими - это позволяет сосредоточиться на наиболее распространённом сценарии. External tables, создание схем, volumes и теги это планы v2. Смену типа колонки ucat почти не поддерживает (кроме varchar(n) и char(n) в STRING). На Windows живой прогон с реальным workspace я пока не делал, и мне нужна помощь (см. ниже).
Так же уже есть первый фидбэк - просят добавить поддержку Iceberg (Датабрикс с недавних пор поддерживает и его).
Первые гости
Небольшое отступление, которое меня до сих пор веселит. Я опубликовал первую задачу для новичков с меткой good first issue: при пустом файле таблицы ucat validate выдаёт три сообщения об ошибке вместо одного. Через 25 минут пришёл pull request. Примерно через час пришёл второй. Оба закрывали именно эту задачу. Один автор заполнил чек-лист из шаблона целиком, второй расписал причину, исправление и тесты по пунктам.
Я не знаю, были ли это люди с очень быстрыми руками или чьи-то агенты, которые прочёсывают GitHub в поисках задач с нужной меткой. Если агенты, то у ucat уже есть коллеги-контрибьюторы :-) Мне как автору досталась неожиданная роль ревьюера на двоих. Я хотел писать инструмент, а оказался на конвейере код-ревью. Принять можно только один PR, поэтому второму пришлось объяснять, что он не опоздал, а просто пришёл вторым.
UPD: пока писал статью, отревьюил PR, нашел недостатки, запросил изменения. Ответ пришел через 14 минут(!), при этом комментарий автора заканчивался скрытой строкой:
<!-- oss-bugfix-bot -->
То есть догадка на счет бота оказалась верной. Ну что ж, пусть так :-) Задача то закрыта. Но если серьёзно, то люди тоже приветствуются, и работы хватит на всех. Так что welcome!
Вопросы и приглашение
Мне очень важно ваше мнение, поэтому вопросы:
Как вы управляете определениями обычных таблиц в Unity Catalog? Где живёт определение и как изменение доезжает до prod?
Что из ограничений выше для вас критично: external tables, теги, создание схем, смена типов?
Есть ли у вас какие-нибудь наболевшие кейсы, которые ucat мог бы помочь вам решить?
Если захотите попробовать, вот ссылки:
сайт: https://ucat.dev
репозиторий: https://github.com/ninilich/ucat
быстрый старт: https://github.com/ninilich/ucat/blob/main/docs/getting-started.md
Проект открытый, и я буду рад контрибьюторам, от опечатки до новой возможности. Есть как задачи для развития, так и просто, например, просьба к тем, у кого Windows и workspace Databricks - прогнать ucat от начала до конца на Windows машине (#6), так как у меня, к сожалению, вообще нет ни одного устройства на ней (а в корпоративной среде она очень даже распространена).
Буду благодарен за любую обратную связь: комментарий здесь, issue на GitHub или личное сообщение.