В момент запуска ваш сервер может обслуживать совсем немного пользователей — вас или несколько десятков. Но если вы работаете над своим проектом долго, то постепенно растёт нагрузка: через месяц — 100 человек, через полгода — уже сто тысяч. А потом может случиться вирусный рост, и ваш сервер просто перестанет справляться с нагрузкой из-за миллионов запросов. Именно на этом переломном моменте обычный план по самому обычному деплою сервера уже перестаёт работать. База данных может начать захлёбываться, пользователи видят бесконечные экраны загрузки или, чего похуже, сообщения об ошибках, и проблемы в логике.
Проблема здесь может состоять не только в качестве кода, но и в архитектуре, рассчитанной на один сервер, которая физически не может масштабироваться для миллионов пользователей. И увы, апгрейд характеристик сервера не всегда помогает. В этой статье я расскажу о первых азах System Design — проектировании систем — для начинающих и продвинутых разработчиков, которые хотят перейти на новый уровень профессионализма. Мы пройдём путь от одного сервера до отказоустойчивой инфраструктуры, обслуживающей миллионы пользователей, с опорой на современные подходы и реальные кейсы. Вперёд!
Масштабирование — вещь куда более сложная, чем «улучшить сервер» или «добавить серверов». Конечно, если предельно упростить, может показаться, что это и есть, но дьявол кроется в деталях. Есть два типа масштабирования, о которых мы поговорим в статье, — вертикальное масштабирование (Scale Up) и горизонтальное масштабирование (Scale Out). Масштабирование ходит рука об руку вместе с проектированием под сетевые задержки между сервисами, согласованности реплик или на случай внезапного падения какого-нибудь узла.
Масштабирование может быть сложнее и запутаннее в разы, да и даже при простейших схемах с отдельной базой данных, несколькими экземплярами приложения и балансировщиком round-robin нужно знать некоторые основы. Мы разберём каждый компонент — от выделения базы данных на отдельный сервер до шардинга и репликации — с акцентом на то, когда и почему его стоит внедрять.
❯ Один сервер, чтобы править всеми
Даже Саурон применял масштабирование: три кольца — эльфам, семь — гномам, девять — людям, по факту шардирование и разделение ответственности, разные кольца под разные домены. Но увы, он совершил ужасную ошибку — кольцо всевластия было единой точкой ответственности и единой точкой отказа. Вроде бы распределённая система, много колец, но стоило кольцо уничтожить — и вся система рухнула. Поэтому давайте разберём его опыт как точку отсчёта — поговорим про один сервер и его физический предел.
❯ Вертикальное масштабирование
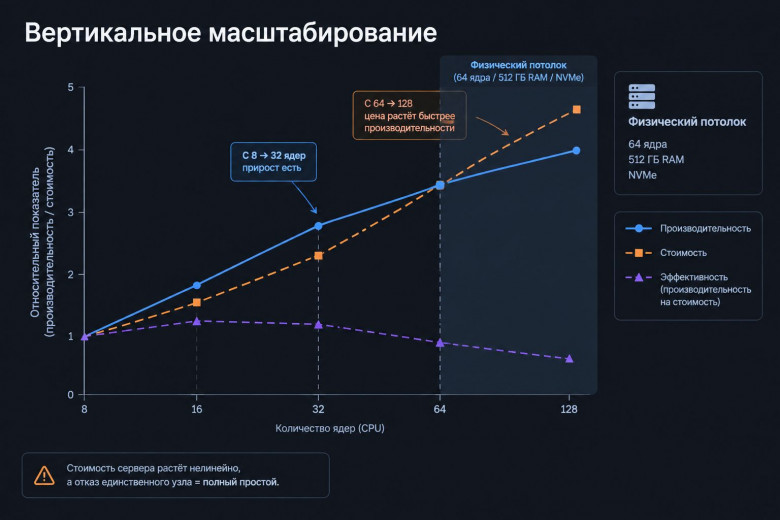
Если вы используете один сервер и улучшаете его характеристики, это называется вертикальным масштабированием. Да, оно означает наращивание ресурсов одной машины, будь то CPU, RAM или более быстрый NVMe. Такой шаг довольно естественный для развития приложения, ибо он не требует изменять архитектуру приложения или настраивать связь между несколькими серверами. И база данных, и кэш, и само приложение остаются работать на одном сервере.
Очевидно, что это самое первое решение, которое приходит в голову, а также оно крайне простое. А что думать-то? Написал нужную цифру в панели хостера, перезагрузил — и вот тебе дополнительно гигабайты, без сетевых задержек и необходимости балансировать или синхронизировать состояния. И это реально часто рациональное решение, ведь условному малому бизнесу не требуется балансировщик и S3 с CDN.
Но, конечно, есть физический потолок. Он постепенно растёт, ибо закон Мура (а если не он, то просто прогресс и логика рынка), но ограничен. Средний типовой мощный сервер — это 64 vCPU и 512 ГБ RAM, стоит, если верить новостям, больше 2,5 миллиона рублей без НДС. Да и ныне вы могли прочувствовать дефицит памяти, который сказался не только на потребителях, но и на компаниях, колоссальный рост в десятки раз. Причина всем известна — переориентация на нужды ИИ. А для нас ещё эффект дефицита усиливается зависимостью от импортных процессоров, памяти, контроллеров, которые иногда тяжело достать через прямые закупки. Вот так и получается, что достигнуть потолка дорого, а перепрыгнуть его — ещё тяжелее.
А ещё есть закон убывающей отдачи: чем больше рост мощности, тем меньше бенефиты ощущаются. Удвоение ядер совсем не равнозначно удвоению производительности, а если учесть нелинейный рост стоимости, то часто ещё и не совсем выгодно.
Но как понять, нужно ли масштабировать вам, будь то горизонтально или вертикально?
❯ Как распознать узкое место?
Я уже говорил, что для небольших сайтов или интернет-магазинов не стоит сразу вываливать план на балансировщик, несколько серверов и S3 с CDN. Надо сначала понять функциональные и нефункциональные требования. Функциональные означают, ЧТО система должна делать (условно «Пользователь может войти в систему, используя email и пароль»), а нефункциональные затрагивают качество и ограничения, то есть как делать, например «Система должна обрабатывать 10 000 RPS» или «Новый пользователь должен совершить покупку за 3 клика».
И потом можно плясать от требований. Сайт интернет-магазина цветов не требует распределённой сети серверов, но имеет пиковые нагрузки (8 Марта, 1 сентября и так далее), которые стоит учитывать при проектировании.
Давайте разберём, как распознать узкое место в уже готовом проекте.
Узким местом может быть CPU. К примеру, когда load average стабильно выше числа логических ядер, top показывает высокий процент us (user space) или sy (kernel space), латентность запросов растёт при неизменном RPS. Причём нужно понимать, что высокий L/A при низкой утилизации CPU может означать, что процессы стоят в очереди на диск или сеть, поэтому top нужно читать вместе с vmstat — колонка r (run queue) показывает, сколько процессов ждут CPU. Если r стабильно больше числа ядер, процессор перегружен.
Если узкое место — память, то симптомы — это OOM-killer в dmesg, активность swap (si/so в vmstat отличны от нуля. Но и тут важнее устойчивая активность swap в сочетании с задержками и давлением на память.), падение hit rate in-process кэша, рост времени сборки мусора в managed-рантаймах. А вот критический сигнал — это если vmstat показывает постоянный swap-in/swap-out, в данном случае получается, что система тратит время на перемещение данных между RAM и диском вместо полезной работы.
А если дисковый IO, то тут проще распознать. Например, высокий %iowait в top, большие очереди (avgqu-sz в iostat -x), высокий await (среднее время ожидания I/O). Если %util в iostat -x близок к 100%, диск насыщен — он не может обработать больше операций, и любые запросы, требующие диска, будут ждать.
И куда без сети. Симптомы тут — это растущее число retransmit’ов, деградация латентности между сервисами, упор в пропускную способность NIC. Можно использовать sar -n DEV для пропускной способности, sar -n TCP,ETCP для ошибок и ретрансмиссий, iftop для разбивки по соединениям.
Для быстрой диагностики можно использовать методику, называемую «правилом 60 секунд Брендана Грегга». Это набор команд, которые за минуту дают срез по всем ресурсам — dmesg | tail, vmstat 1, mpstat -P ALL 1, iostat -xz 1, sar -n DEV 1, sar -n TCP,ETCP 1, top. Альтернативный подход — USE-метод (Utilization, Saturation, Errors) для каждого ресурса или RED-метод (Rate, Errors, Duration) для сервисов. Ну и стоит смотреть и сравнивать за разное время, в разных условиях.
❯ Разделение приложения и базы данных
Первый архитектурный шаг, который возможен, — разделение приложения и базы данных (надеюсь, вы же не решили внести System Design только ради System Design, а следуя из требований?). Такой шаг исходит из того, что коли БД и приложение на одной машине, они конкурируют за одни и те же ресурсы, и при падении крушится весь «Титаник».
На ранней стадии это более чем нормально, но стоит вырасти нагрузкам — уже пора разделять на две машины. Во-первых, база данных и приложение получат независимые ресурсы. Во-вторых, можно масштабировать их по отдельности. И в-третьих — изоляция отказов: падение одного сервера не ломает всё. Приложение или база продолжат работать, тут, конечно, желательно иметь в архитектуре graceful degradation, но всё равно это позволит сделать данные обоих элементов системы независимыми.
Цена такого решения — сетевой хоп и нужда в надёжном соединении. Запросы теперь будут идти по сети, что добавляет латентность и создаёт новый класс проблем в виде таймаутов, retry-логики, пулов подключений и прочего. Увы, мы идём на компромисс ради шага в распределённую архитектуру. Все последующие шаги, такие как репликация, кэширование, шардинг, уже строятся поверх нашего фундамента.
На некоторых платформах разделение может быть автоматическим, то есть аренда базы как отдельный сервер. А если нет — то просто вторую виртуальную машину настроить. Конечно, в идеале это отдельный механизм клонирования и консистентности серверов, но это уже системное программирование, а Адам Смит завещал нам разделять труд, чтобы продуктивность была выше.
А теперь перейдём к базе данных.
❯ База данных
Как я уже говорил, первый шаг к распределённой системе — это база данных. А теперь поговорим о самой базе данных, поймём, что происходит с ней, когда она перестаёт справляться, ибо иногда просто переместить базу данных на отдельный сервер — не совсем достаточно.
Возможно, я надоел, но хочу повторить, что стоит понимать, когда нужно усложнять структуру, а когда нет, исходя из требований и рамок, а не бежать делать всё по канонам System Design.
❯ Что есть репликация?
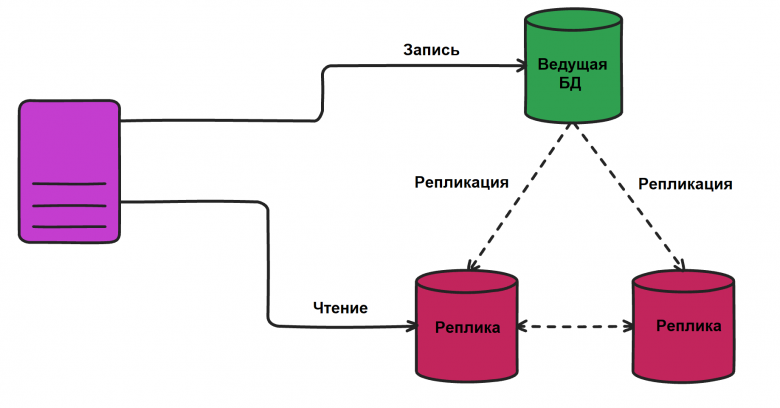
Репликация — это когда одни и те же данные лежат на нескольких узлах, создаются так называемые реплики. Есть три подхода к правам реплики и механизмам синхронизации.
Первый подход — single-leader (ведущий-ведомый). Один узел принимает записи, а реплики уже только для чтения. Ведущий рассылает изменения ведомым, и те применяют их у себя. Просто, предсказуемо и красиво, так что такое решение распространено.
Но увы, есть и проблемы. Репликация асинхронная, и между моментом, когда вы записали что-то на ведущем, и моментом, когда это появилось на ведомом, есть окно. И соответственно, пользователь мог записать данные, но из-за задержки не увидеть их. А ещё падение ведущего узла может тянуть за собой реплики, но лучше проектировать так, чтобы реплики были доступны для чтения.
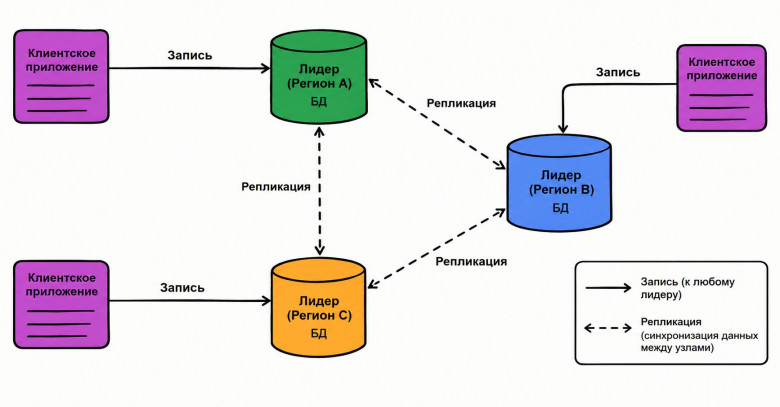
А вот схема multi-leader (мульти-ведущий) позволяет содержать равноценные реплики, принимающие записи и синхронизирующие между собой. Запись доступна в нескольких регионах, отказ одного ведущего не останавливает систему.
Взамен появляется конфликт изменений: два узла могут принять разные изменения одного и того же объекта, и тут приходится выбирать, кому мы предпочтение отдаём. Может, записываем последние данные, а может, первый запрос, или вообще кастомная логика. Для геораспределённых систем такой подход полезен, но в иных случаях чаще всего это уже избыточная сложность.
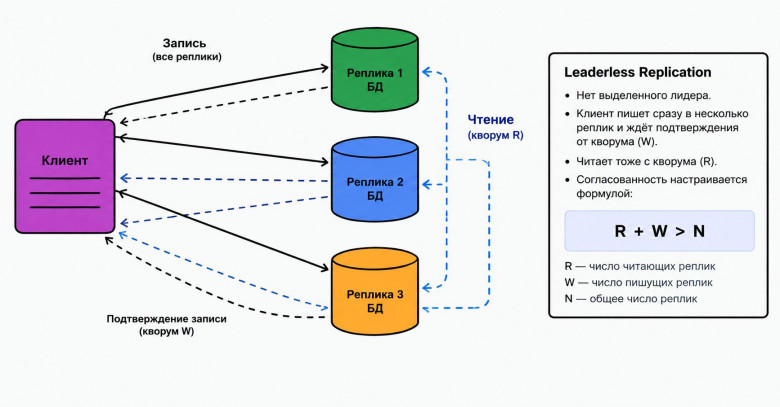
И наконец — leaderless (без ведущего). Вместо отдельного главного узла клиент пишет сразу в несколько реплик и ждёт подтверждения от кворума. Согласованность настраивается формулой R + W > N, где R — число читающих реплик, W — пишущих, N — общее число реплик. Правда, пересечение кворумов всё равно не гарантирует строгую согласованность при любой модели отказов и любых механизмах чтения и записи. Гарантии зависят от семантики системы, обработки конфликтов и протокола согласованности.
Но зато нет единой точки отказа, и масштабирование записи происходит линейно. Правда, есть проблемы: eventual consistency по умолчанию, и вам придётся разбираться с vector clocks, read repair и hinted handoff.
Выбирать схему репликации стоит исходя из ваших потребностей: если нагрузка преимущественно на чтение — берите single-leader. Если нужна запись в нескольких регионах с низкой задержкой — multi-leader. А если важнее доступность и горизонтальная запись — leaderless. А теперь перейдём к шардированию.
❯ Шардирование: когда данные не влезают
Репликация занимается копированием узлов с данными, а вот шардирование — это разделение хранилища на несколько независимых частей — шардов, в отличие от репликации, где выделенные экземпляры базы данных являются не составными частями общего хранилища, а копиями друг друга.
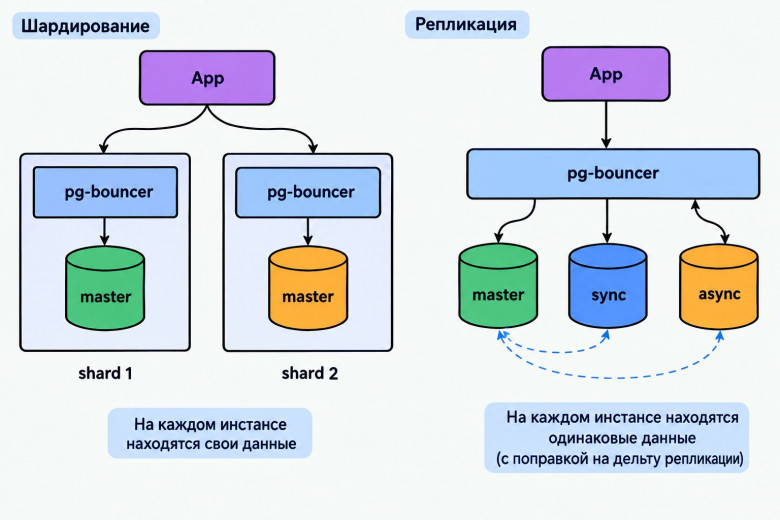
Так вот, шардирование нужно, когда данные физически не влезают на один узел или когда запись упирается в потолок одного ведущего. Пока ни то, ни другое не наступило — шардирование может добавить сложности.
Осуществить шардирование можно как средствами БД (MongoDB, Elasticsearch, ClickHouse (сил и здоровья Яндексу!)), которые умеют самостоятельно распределять данные между своими экземплярами; так и надстройками к БД через Vitess/Citus, но может упасть производительность, а то и произойти потеря данных; и клиентскими средствами, когда экземпляры БД не подозревают о существовании друг друга, а шардированием управляет стороннее приложение, со всеми рисками. А вообще, если хотите почитать подробнее — есть классная статья.
То бишь шардирование — горизонтальное разбиение данных. Причём интеграция шардирования как решение капитальное и необратимое, оно требует переписать логику доступа к данным. То есть запросы должны знать, куда идти, транзакции перестают быть атомарными на уровне всей базы, а джойны между шардами превращаются в ручную сборку данных на стороне приложения. Так что иногда лучше предпочесть всё-таки репликацию.
А если вы выбрали шардирование, стоит понимать, что у него есть стратегии.
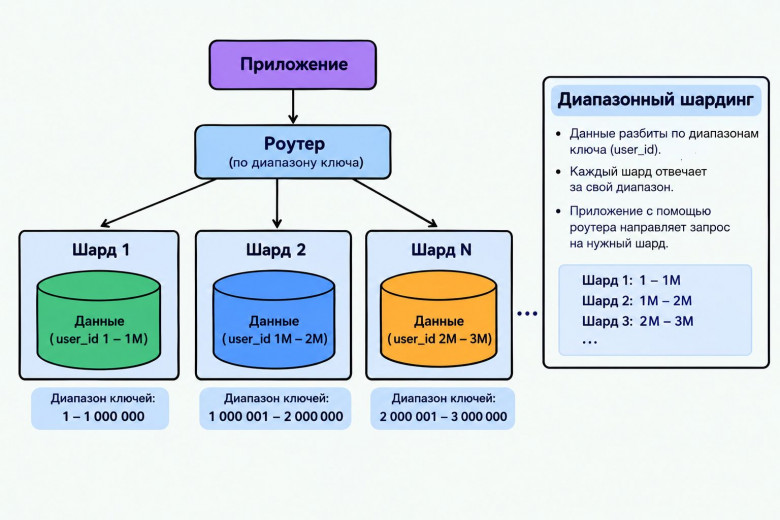
Первая стратегия — это диапазонный шардинг. Данные разбиты по диапазонам ключа: user_id 1–1M на первом шарде, 1M–2M на втором, и так далее. Эффективные запросы по диапазонам, ну то есть если нужно выбрать всех пользователей, зарегистрированных в январе, и ключ включает дату, запрос уйдёт на один шард. Но горячие диапазоны уже слабы: если ключ монотонно растёт (автоинкрементный ID, timestamp), все новые записи идут в последний диапазон, и один шард захлёбывается, пока остальные простаивают.
CockroachDB решает эту проблему хеш-шардированными индексами: последовательные ключи хешируются в бакеты, и запись распределяется равномерно, но есть небольшая просадка на чтение диапазонов.
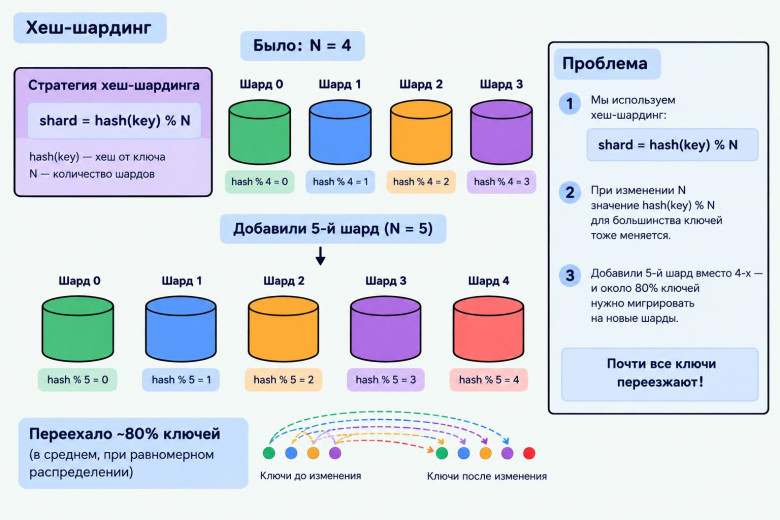
Развивая тему хеша, существует стратегия хеш-шардинга. По факту это формула shard = hash(key) % N. Проблема одна, но зато какая — при изменении N почти все ключи переезжают. Добавили пятый шард к четырём — и вот 80% данных мигрировать нужно.
Но что если согласовать хеширование? Об этом как раз и будет следующая стратегия — согласованное хеширование. Тут ключи и узлы отображаются на кольцо, при добавлении или удалении узла переезжает только часть данных (в идеале примерно 1/N ключей). Часто используют виртуальные узлы, когда одна физическая машина представляется несколькими точками на кольце, дабы сгладить неравномерность.
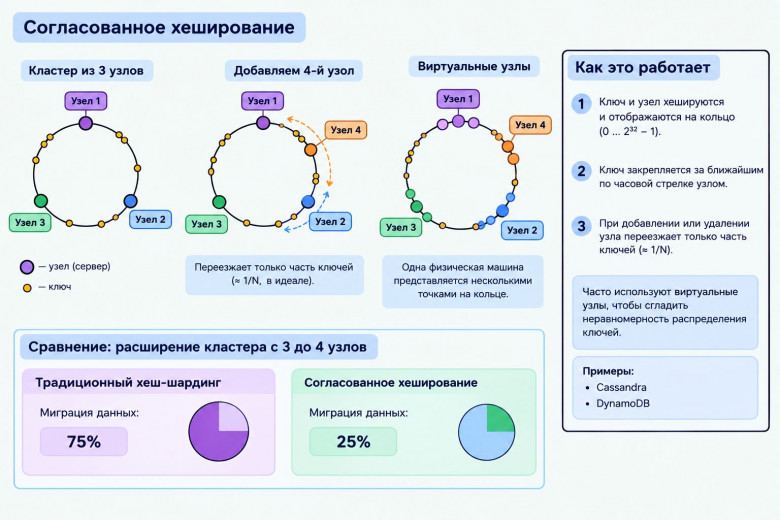
Такую стратегию предпочитают, к примеру, Cassandra и DynamoDB. Условно, при расширении кластера с трёх узлов до четырёх традиционный хеш-шардинг требует миграции 75% данных, согласованное хеширование — 25%.
Ну и под конец — каталог шардов. Отдельная таблица или сервис знает, какой ключ на каком шарде. Гибкость неимоверная, можно менять стратегию на лету, жонглировать данными между шардами. Но цена этого удобства — каталог становится критической точкой и узким местом.
Но, собственно, шардинг не всегда нужен. Например, OpenAI обслуживает 800 миллионов пользователей на одном PostgreSQL, с примерно 50 репликами на чтение, и без шардинга. Главный узел принимает все записи, а реплики разбросаны по регионам.
Как они поясняют, большая часть нагрузки — чтение, а чтение масштабируется репликами. Запросы хорошо кэшируются, индексы оптимизируются — и всё это даёт больше, чем мог бы дать шардинг. OpenAI описывают свой подход как «строгие оптимизации и надёжную инженерию». То бишь они масштабировали конкретную нагрузку PostgreSQL до миллионов запросов в секунду без шардирования этого развёртывания — не отказавшись от шардирования для всех остальных задач.
Но давайте затронем теперь тему кэша. Ведь самый быстрый запрос — это тот, которого не было.
❯ Кэш
База данных — безусловно место очень важное, ибо там живут данные. Но каждый раз слать миллион миллионов одинаковых запросов на неё не стоит, ведь это съедает ресурсы впустую. Для большого количества одинаковых запросов нужно иметь хранилище кэша.
Кэширование — вещь важная, её нужно проектировать на самых первых этапах разработки проекта. Подключил какой-нибудь Redis — и вот часть нагрузки уже отпала. Но, кстати, кэш — это не только Redis, это несколько слоёв, которые отсекают свои типы запросов.
Наверняка вы слышали о CDN — это и есть самый близкий слой кэширования к пользователю. Статика, публичный контент или даже ответы API на периферии — тут кэш вам поможет, ибо сюда попадает то, что одинаково для всех (ну или почти для всех). Очень быстрый, но кастомные сложные ответы будет сложно закэшировать. Обратный прокси (nginx, Varnish, Envoy) уже является кэшем на входе в инфраструктуру, кэширует ответы целиком, ещё до попадания в приложение. Наш старый добрый Redis (а также Memcached и прочие) — это уже распределённый кэш, общий для всех инстансов приложения. Хранит объекты, результаты запросов, сессии. И наконец — внутрипроцессный кэш (Caffeine, Guava, встроенные map) внутри самого приложения. Наносекунды вместо миллисекунд, но не разделяется между инстансами и умирает вместе с процессом.
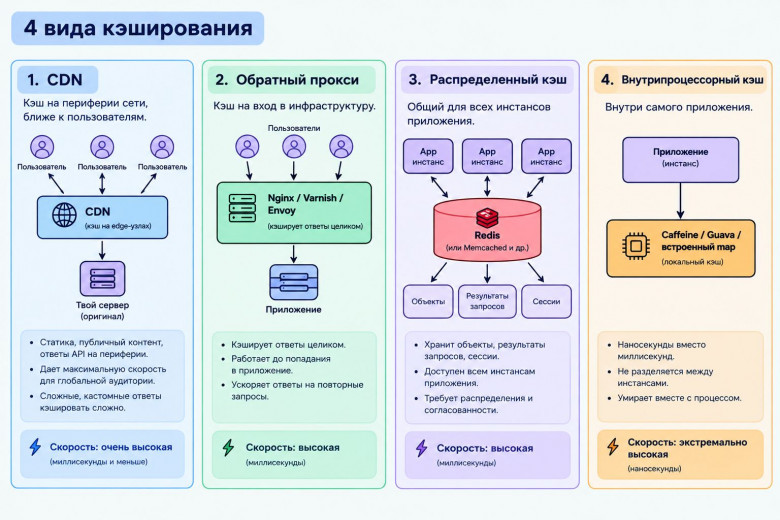
Конечно, важно, чтобы они вместе дополняли друг друга. Но не стоит забывать старый добрый завет — keep it simple, stupid. Коли у вас система не под огромной нагрузкой, не стоит городить себе систему, как будто вы YouTube. Ибо каждый слой добавляет проблему согласованности. Чем ближе к клиенту, тем дольше данные могут быть устаревшими. Баланс пользователя в CDN кэшировать нельзя. А вот его аватарку — можно и нужно.
❯ Что убивает кэш?
Кэш не вечный, он имеет TTL. И иногда в эти моменты может политься лавина запросов, допустим началась распродажа, а у карточки товара только-только истёк TTL. Распознать просто, а решения — это блокировка на пересчёт (мьютекс: только один запрос идёт в базу, остальные ждут результат), вероятностное раннее обновление (XFetch — обновляем чуть раньше истечения, с вероятностью, растущей по мере приближения дедлайна) или фоновое обновление до истечения.
Бывает ещё перекос горячих ключей — один ключ или несколько получают непропорционально много запросов. Профиль знаменитости, конфиг фичи, который читают все, и прочие популярные страницы. Один Redis упирается в потолок по сети или CPU, пока остальные ресурсы простаивают. Распознавать можно через метрики по ключам, а решение — локальный внутрипроцессный кэш поверх Redis, репликация горячего ключа на несколько узлов или шардирование по ключу с суффиксом.
Ну и я говорил о согласованности, и, конечно, её обрывы также могут убить кэш. Когда данные в кэше и в базе расходятся, могут создаваться неприятные ситуации: пользователь видит старый список транзакций, хотя недавно сделал несколько операций, или товар показан в наличии, а его нет. Такие баги дороговато чинить, а распознавать тяжелее — через жалобы, тесты, инциденты. Решать можно через инвалидацию, версионирование ключей, отказ от кэширования критичных данных.
❯ Стратегии инвалидации
Главный вопрос кэша — это как обновлять и удалять. Грубо говоря, тут можно выделить 4 подхода.
Первый мы уже упоминали, и это — TTL. Данные живут фиксированное время и потом исчезают. Но увы, данные устаревают больше, чем хотелось бы, и тут может TTL быть слишком коротким, и кэш неэффективен. Неплохое решение, когда допустима некоторая устарелость и нет требований к свежести, а-ля лента новостей, каталог товаров или счётчики просмотров.
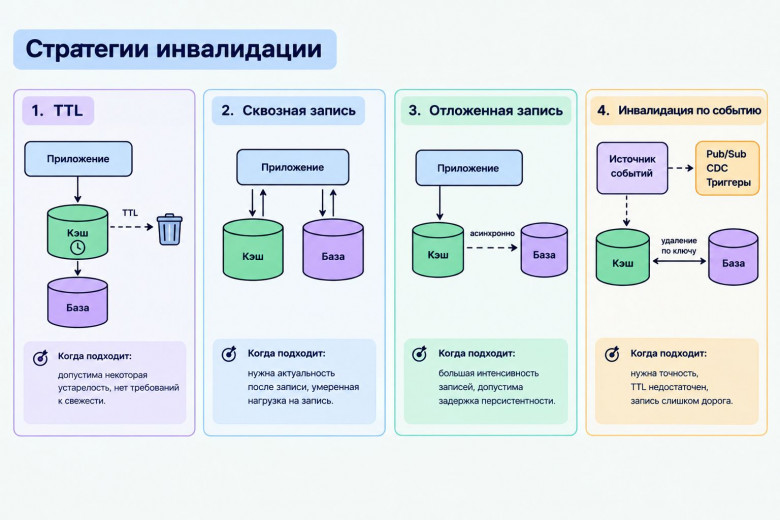
Можно также делать сквозную запись — одновременно в кэш и в базу. Кэш всегда актуален после записи, но сама запись становится дороже, а редко читаемые данные всё равно кэшируются. Если чтение после записи критично, а нагрузка на запись умеренна, весьма подходит, к примеру для профиля пользователя или настроек. Но можно посылать запрос сначала в кэш, а затем асинхронно в базу — это называется отложенная запись. Быстрый подход, позволяющий сглаживать пики, ценой риска потери данных при падении кэша, и согласованность гарантировать сложнее. Неплохо подходит для сценариев с большой интенсивностью записи, где допустима задержка персистентности. А если TTL недостаточно, а запись слишком дорога — есть инвалидация по событию, через ключ. Pub/sub, change-data-capture, триггеры — это всё сложнее, но зато точнее.
Хочется отдельно поболтать насчёт Redis. Как вы прекрасно знаете и без меня, Redis стал де-факто стандартом распределённого кэша, если не синонимом. У него есть Redis Cluster, который масштабируется горизонтально через шардирование по хеш-слотам (16384). Стоит помнить, что клиент должен поддерживать такой режим (cluster mode), иначе маршрутизация не работает, и вы получите ошибки на мультиключевых операциях, а они-то требуют, чтобы ключи были в одном слоте, и нужны hash tags.
Ну и эластичное масштабирование, когда уже идёт автоматическое добавление и удаление узлов в зависимости от нагрузки. Звучит хорошо и светло, но есть небольшой нюансик — решардинг слотов — дорогая операция, которая сама создаёт нагрузку. Масштабирование под пиком может ухудшить ситуацию. Поэтому масштабировать лучше предиктивно или с запасом, а не реактивно в момент пика.
❯ Как измерять эффективность кэша
Самая распространённая метрика — hit rate, доля попаданий. А ещё она может быть самой бесполезной.
Условные 95% попаданий звучат просто отлично. Но если оставшиеся 5% — это самые дорогие и важные запросы (тяжёлые джойны, агрегации, полные сканы), база всё равно страдает. Hit rate говорит, сколько раз вы не пошли в базу. А сколько это стоило бы, если бы пошли, — вопрос открытый.
Так что нужно измерять и стоимость промаха, которая покажет, сколько ресурсов базы стоит один промах, и если умножить на частоту промахов, можно получить реальную нагрузку на базу, уж извините за тавтологию. 5% пролётов могут создавать 80% нагрузки, а hit rate оставаться 95%. Также фиксировать снижение дорогой работы — сколько в итоге тяжёлых запросов не дошло до базы благодаря кэшу. Или измерять латентность p99 (кстати, я как-то писал статью про интересный алгоритм TDigest для точного высчитывания перцентилей) с кэшем и без, так как можно увидеть, спасает ли кэш хвосты или только средние значения. Ну и конечно же корректность: кэш не должен противоречить ожиданиям бизнес-логики.
❯ CDN и edge computing
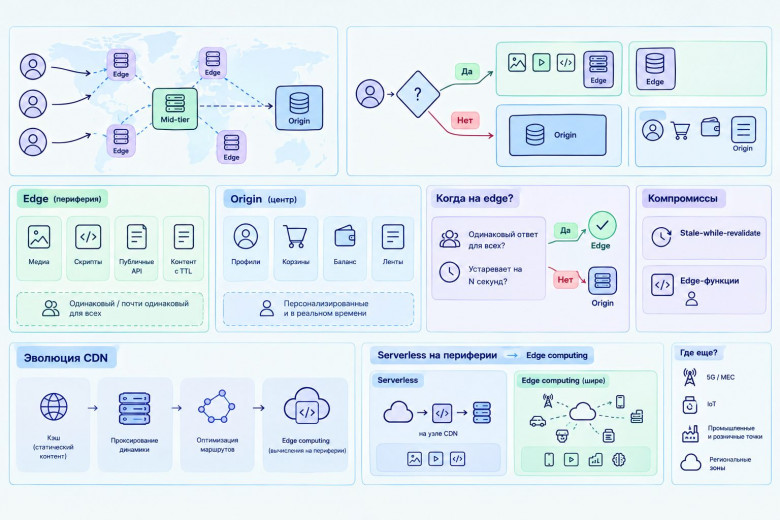
Мы уже затрагивали в разделе про кэш выше CDN/edge computing, и эта тема заслуживает отдельного блока. CDN — сеть доставки контента, включающая и edge, и mid-tier, и управляющую инфраструктуру. Близким к пользователю является именно edge-слой внутри CDN. Полезен, если ваши юзеры разбросаны географически и задержка до вашего ДЦ становится проблемной, или когда статика съедает трафик, который мог бы не доходить до origin вообще.
Граница между кэшированием на периферии и тем, что остаётся на origin, проходит по тому, был ли ответ одинаковым для разных юзеров и устаревшим на N секунд. На периферию уходит всё, что одинаково для всех или почти для всех, по типу медиафайлов, скриптов, публичных ответов API (по типу каталогов, документации) или контент с длинным TTL и слабой зависимостью от пользователя. А вот origin уже располагает персонализированными данными. Всевозможные виды и подвиды профилей, корзины, балансы и всякие ленты, к примеру. То бишь данные, требующие согласованности в реальном времени и которые имеют хоть малейшую, да кастомизацию.
Можно свести эту всю махину к вопросу про то, допустимо ли то, чтобы ответ был одинаковым для разных пользователей и устаревшим на N секунд. Коли да — то флаг в руки и вперёд, но если нет — уже стоит задуматься.
Конечно, это всё в теории. На практике, очевидно, бывают компромиссы, по типу stale-while-revalidate, когда отдаём устаревшее, но фоново обновляем. Есть edge-функции, которые персонализируют ответ прямо на периферии (edge).
❯ От статики до serverless на периферии
CDN за время существования знатно эволюционировал: от банального кэша для картинок и видео до целой отдельной распределённой вычислительной платформы! Сначала было всё просто: контент ближе к пользователю, все дела. А потом научились проксировать динамику, оптимизировать маршруты и держать соединение с origin. И наконец, не так давно по историческим меркам, появился edge computing — когда на периферии выполняются вычисления; этим занимаются Cloudflare Workers, Lambda@Edge, Deno Deploy и прочие, вы могли уже слышать эти названия. Быстрый холодный старт в разы быстрее традиционного serverless.
Serverless — это когда вместо простой отдачи кэшированного контента запускается serverless-функция прямо на узле CDN. А edge computing serverless — шире: включает телеком-периферию (5G MEC), IoT-шлюзы, промышленные/розничные точки, региональные облачные зоны. Может обрабатывать не только HTTP, но и события с устройств, телеметрию, видеоаналитику, ML-инференс.
❯ Один CDN — одна точка отказа
Вспомню метафору о Сауроне: он тоже имел только одно кольцо всевластия, стоило ему упасть в вулкан — так вся система посыпалась. Также и здесь, даже если у вас Cloudflare. Вы сами могли видеть многочисленные новости о падении Cloudflare или Fastly, периодически бывает. Как рассказывал знакомый DevOps, когда упал AWS us-east-1, был тяжёлый день, мягко говоря, ещё и объяснять, что ты не можешь починить это.
Можно подключить Multi-CDN, когда требования к доступности, независимости от провайдера или производительности оправдывают дополнительные расходы и сложность; это когда несколько провайдеров с маршрутизацией, и они автоматически переключаются при деградации. Кроме устойчивости даёт ещё и производительность, но увы, увеличивает сложность: нужна оркестрация, система инвалидации, мониторинг каждого провайдера. Иногда это вообще оверинжиниринг, но знать полезно, не забывая думать про точки отказа. Но стоит помнить, что CDN уже представляет собой геораспределённую инфраструктуру.
Ну и как же без наших любимых перцентилей!
Есть такая вещь, как PoP (point of presence) — физическая точка присутствия CDN; это когда чем ближе PoP к пользователю, тем меньше латентность. Но на латентность влияет не только расстояние, но и заполненность кэша PoP, а также маршрутизация между PoP и origin не всегда оптимальна.
Как я уже говорил, тут опять нам помогут перцентили и хвосты, p95 и p99. Хвост разваливаться может по причинам разным, хоть cache misses или revalidation storms, хоть regional hot-object skew.
А, ну и ещё стоит смотреть латентность по регионам, а не только глобальная средняя или медиана.
❯ Балансировщик нагрузки
Ещё не устали? Надеюсь, что нет, ибо впереди одна из главных тем — балансировщики. Кэш, CDN, репликации и шардинги — вся эта мешанина из серверов, баз данных и кэшей — безусловно полезна, но как она вообще узнаёт, куда направить конкретный запрос? Кто решает, что вот этот пользователь идёт на третий сервер, а не на седьмой? А кроме исходящих запросов есть и входящие. Тут как раз на помощь приходит замечательная технология — балансировщик нагрузки, который решает, какой запрос откуда и куда должен идти.
Самый простой и известный балансировщик — это round-robin (наверняка вы видели много «yet another round robin load balancer written in Go»), один из простейших алгоритмов балансировки. По факту — это просто счётчик по кругу, то бишь раздаём запросы по кругу. Работает, но у него есть нюансы, вытекающие из своей простоты. И вообще, балансировщик — это не только раздача запросов, а ещё и про здоровье серверов, иногда мониторинг, про отказоустойчивость и деградации серверов.
Балансировщик появляется, когда у вас больше одного сервера приложений и вам нужно использовать их эффективно.
##❯ L4 vs L7: что и где балансировать
Балансировщики в основе своей имеют такой термин, как уровни, и первое, что нужно понять про балансировщики, — это и есть эти самые уровни. Тут есть два основных варианта — L4 (транспортный уровень) и L7 (прикладной уровень). Если вы знакомы с транспортной моделью OSI, вам они знакомы.
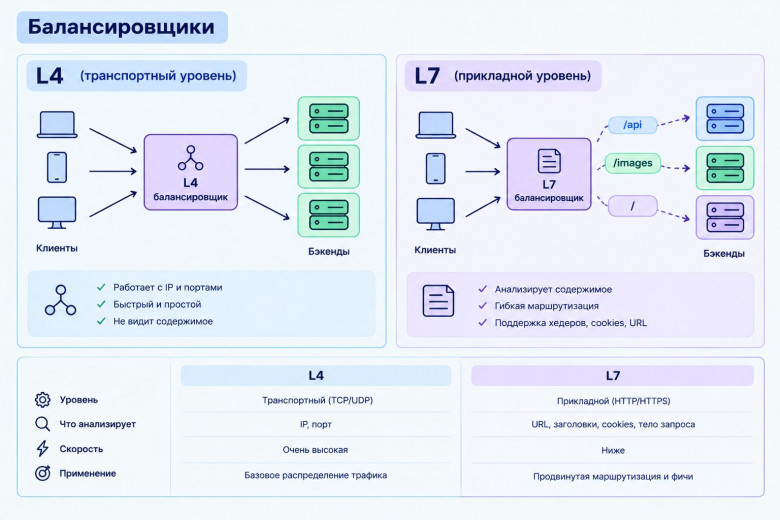
L4-балансировщик работает с IP-адресами и портами, транспортными протоколами, не читает внутренности запроса, а просто перенаправляет его на один из серверов. Простой и очень быстрый, с минимальной нагрузкой на процессор, с минимальными задержками, а некоторые L4-балансировщики могут обрабатывать и миллионы запросов в секунду. Но да, он не понимает, что внутри, так что обычно нет маршрутизации по URL, терминирования TLS, работы с сессиями — всё это остаётся в зоне ответственности бэкендов. Но многое зависит от реализации балансировщика и режима работы.
А вот L7-балансировщик работает уже на уровне приложения. Он способен читать HTTP-заголовки и распознавать URL и может маршрутизировать запросы на основе пути, хоста или cookie. Ну то есть всё, что не может L4. Очень гибкий, так как запросы на /api могут уходить на один сервис, /static — на другой, а /admin — на третий, и можно делать A/B-тесты на уровне балансировщика. Но, как вы могли догадаться, ресурсов ест больше, так как парсит каждый запрос. Задержка выше, нагрузка на процессор выше, а ещё поверхность атаки больше, так что придётся ещё поработать с ИБ-шниками.
И тут не обязательно выбирать «пан или пропал», можно сразу оба балансировщика затащить. Часто стоит L4-балансировщик на входе, дабы быстро распределить трафик, и L7 за ним. Или наоборот, зависит от ваших потребностей.
❯ Проблема традиционных алгоритмов
Round-robin, как я уже говорил, это просто. Least Connections — уже чуть умнее: отправляем запрос на сервер с наименьшим числом активных соединений. Оба работают хорошо, когда нагрузка стабильная и предсказуемая.
Но реальный трафик, увы, не подчиняется законам наших желаний, бывают всплески и пики, которые несут с собой проблемы. Например, сотни или тысячи запросов приходят на один и тот же сервер или пробуют получить один и тот же ресурс, потому что round-robin не знает о состоянии бэкендов, и если сервер перегружен, но очередь на круге подошла — получит запрос. Алгоритм Least Connections чуть лучше, но он тоже реактивен, так как смотрит на текущее состояние, а не на то, что будет потом.
В условиях большого трафика классические алгоритмы могут демонстрировать критическую инерцию, проще говоря, трафик на насыщенные узлы продолжает течь, усугубляя и приводя к каскадным отказам, а в этом мало приятного.
Даже реактивные механизмы автоскейлинга (типа Kubernetes HPA) тоже не спасают. Они работают с задержкой, так что метрики агрегируются, решение принимается, поды запускаются. А к этому моменту очереди на бэкендах уже насыщены, и новые поды не успевают помочь.
Вообще существует множество других алгоритмов, которые вы можете найти сами, эта статья не про алгоритмы (хотя планирую написать отдельную статью о балансировщиках).
❯ Health checks, circuit breaking, graceful degradation
Ну и классика, я думаю, вы наверняка слышали данные термины. Балансировщик-то отвечает ещё за задачи, связанные с отсутствием ответа от бэкенда.
Про health checks вы наверняка слышали. Активная проверка — балансировщик сам периодически пингует бэкенды, пассивная — наблюдает за реальным трафиком и делает выводы на основе ответов. Бэкенд не отвечает на запрос — исключается из ротации. Правда, если проверка слишком агрессивная, статус может скакать, и сервер в ротации может то исключаться, то возвращаться.
Circuit breaking — менее известный термин, который означает паттерн предотвращения каскадных отказов. Если бэкенд начал заваливать нас ошибками, circuit breaker размыкает цепь, запросы к нему временно не идут. Через некоторое время пропускает пробный запрос, если успешен — замыкает обратно, а коли нет — то остаётся разомкнутым.
Ну и graceful degradation, который, кстати, стоит учитывать и при разработке, а не только при деплое. Суть такого механизма в том, что система продолжает работать, но с ограниченной функциональностью. Если один сервис недоступен, то не ложим всё приложение, а отключаем второстепенные связанные с сервисом функции. К примеру, если сервис рекомендаций упал, то страница товара всё равно открывается, просто без блока «вам могут понравиться».
В общем, я считаю, что это святая святых, и важны даже если у вас нет балансировщика, и система простая.
❯ Ошибки и антипаттерны
Надеюсь, вы ещё не устали, мы прошли долгий путь от одного сервера до распределённой системы, и вот тут нужно поговорить о том, в чём мы с вами можем ошибиться.
Собственно, я ещё собрал здесь все опасения, что говорил в тексте.
И ещё раз напомню, оверинжиниринг — не круто. Да, вы безусловно очень умный, не зря носите гордое звание инженера ПО, но, пожалуйста, иногда думайте о поддержке и о целесообразности. Вы же не организуете логистическую компанию, когда вам нужно шкаф перевести, также и тут. Думайте, и будет вам счастье. А может, и не будет, программирование оно такое.
В общем, первая ошибка — преждевременный шардинг. Ваш сервис растёт, думаете, через год будут миллионы пользователей, и нужно сразу сделать шардинг, чтобы не переделывать потом. Ага, как бы не так, на деле это может быть катастрофой. Шардинг по пользователю до того, как продукт сместился в сторону командной работы, мог вызвать технические боли. Сложная маршрутизация, отсутствие ACID-транзакций между шардами и так далее — всё это очень невкусно и больно будет в будущем, если проект небольшой.
Вторая ошибка — игнорировать write amplification при репликации или другом механизме хранения данных. Это отношение реального объёма записанных данных к объёму полезных данных, если говорить просто. Внутри одна логическая запись может приводить к большему объёму физических записей из-за устройства индексов, журналирования и других механизмов.
Тут стоит учесть репликацию, которая, безусловно, замечательная вещь, ведь данные копируются на несколько узлов, чтение масштабируется, отказоустойчивость растёт. Но многие забывают, что она увеличивает объём записи. Собственно, одна запись в базу — это не изменение одной строки, а часто смещение индексов и прочее, прочее, прочее.
Третья ошибка — кэширование без стратегии инвалидации. Это уже целый паттерн — No Caching Strategy. Кэш — это вам не просто спойлер для машины, помимо добавления нужно ещё и настроить его. А то вы обновили цену с 3600 до 5600, а потом клиент спрашивает, с какой стати 5600 стало в корзине. Нужна просто явная стратегия инвалидации.
Четвёртая ошибка, о которой мы не говорили, — это отсутствие нагрузочного тестирования на реальных профилях трафика. Именно на реальных, а не на фиксированных симуляциях с единой константой под линеечку. Так что тестирование должно быть с разных IP-адресов и похожим на реальный трафик.
Некоторые из этих ошибок я уже говорил, но если вы забыли — не забывайте, делайте хорошо, а плохо не делайте. А если серьёзно — то работа системного архитектора состоит не только в том, чтобы говорить умные слова на дейликах, а в том, чтобы проектировать исходя из условий.
❯ Заключение
Наконец-то мы дошли до конца. Точнее, до конца только этой статьи, потому что в масштабировании конца не бывает. Буквально, никогда не будет финальной архитектуры, которая и правильная, и расширять не надо, и будут ей пользоваться наши дети и внуки, и будет стоять покуда мы живём. Архитектура постоянно растёт и изменяется. Я считаю, что системный дизайн должен быть монолитный как гранит и гибкий как пластилин.
Тут нужно мыслить на шаг вперёд, на то, какая будет нагрузка при пике, а не какая сейчас.
В общем, если вы проектируете систему, то можно следовать такому плану:
Один сервер — всё на одной машине.
Разделение приложения и базы данных — чтение стало проблемой, так что разделяем базу данных. Теперь падение сервера не означает падение всей инфраструктуры.
Репликация, возможно, шардинг на этом или на следующих этапах.
Кэширование. Redis, CDN и прочие механизмы кэширования — всё это позволит отбить часть одинаковых или похожих запросов.
CDN или Multi-CDN, если проект очень крупный.
Балансировка. L4 для скорости, L7 для гибкости или и то и то. А ещё health checks, circuit breaking, graceful degradation. Считайте, достигли эталона базового System Design.
Ну и дальше уже следующие, более сложные уровни, но база уже есть. Главное — уметь управлять рисками и требованиями.
И не забывайте проверять, нужен ли вам следующий шаг действительно. И помните, что системный дизайн — система компромиссов. Удачи с масштабированием!
Новости, обзоры продуктов и конкурсы от команды Timeweb.Cloud — в нашем Telegram-канале ↩
