

Вы когда‑нибудь читали такое сообщение от кодинг‑агента? Мне не приходилось, а жаль.
Каждый раз, когда я довожу код, сгенерированный AI по моему ТЗ, я прогоняю его через ревью несколькими агентами с разными ролями и точками зрения — что‑то вроде взгляда нескольких людей с разным опытом. И почти всегда получаю пачку разнокалиберных замечаний, от мелких до критических. Казалось бы, что сложного: открой новую сессию, скорми ей замечания, дай исправить, прогони ревью снова.
У этой замечательной стратегии, однако, есть одно слабое место: а мы уверены, что такой процесс сходится?
Приведу пример из близкой мне вычислительной газовой динамики. Моделируя обтекание тела в стационарной постановке (условия на границах модели не меняются), компьютер итеративно решает уравнения Навье‑Стокса в расчёте на то, что раз граничные условия неизменны, то и поля скоростей, давлений и температур после некоторого числа шагов внутри расчётной области устаканятся (рис. 1). На практике бывает иначе. Если CAE‑инженер поставил задачу неидеально, решение разваливается и физические величины уходят за границы разумного (рис. 2). А бывает, что процесс нестационарен по своей природе — какой‑нибудь турбулентный вихрь — и стационарного решения просто нет: поля флуктуируют от шага к шагу (рис. 3).
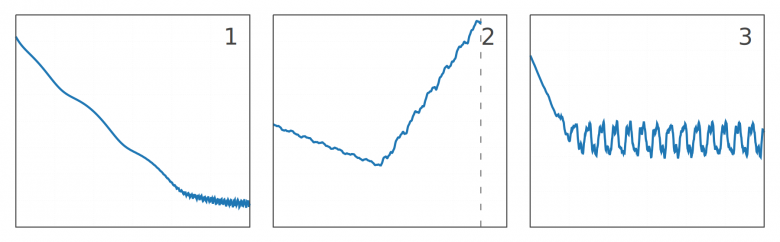
В агентной разработке меня терзает ровно тот же вопрос. Иногда я ставлю эксперимент и иду по циклу «замечания → исправления → ревью» до конца. Случай, когда агент на очередном круге не находит ничего нового, крайне редок. Обычно он зацикливается на нескольких проблемах средней критичности — это аналог рис. 3. Либо код обрастает такой системой костылей и подпорок, что он хоть и работает, но поддерживать его дальше будет адски сложно — как в случае рис. 2.
Казалось бы — смирись и отправляй в QA. Однако есть и другой эксперимент: ревью патча, уже закоммиченного в Postgres и пережившего мажорный релиз, те же агенты часто проходят без замечаний. То есть замечания — не обязательный шум, который AI‑агент выдаёт на любой код, и стационарное состояние существует. Просто итерациями по исправлениям к нему не прийти.
Поэтому с некоторого момента я собираю замечания агента и иду на пересмотр дизайна фичи, даже если патч был довольно местечковым. Собирая систему заново, с учётом знания о возможных проблемах, я заранее прописываю набор компромиссов и контрактов. Да, система получается не идеальной, и некоторые места выглядят не очень в смысле перформанса, зато ты знаешь чем жертвуешь: пойдёшь улучшать вот этот корнер‑кейс — столкнёшься с тем‑то и тем‑то. Обидно, но зато система стабильна и работоспособна, а в мире реляционных СУБД это для разработчика критический фактор.
А теперь о том, что, собственно, триггернуло этот пост. Делая ревью чьей‑то работы, я по умолчанию запускаю Claude review и вижу характерный набор замечаний. Как будто коллега сам не мог набрать одну фразу в чате и увидеть ровно то же самое!
Проблема в том, что AI‑агент никогда не скажет, что дизайн ошибочен, — он мыслит в терминах исправлений. Поэтому, чтобы ответить на ревью что‑то содержательное, мне приходится придумывать вариант дизайна, который исключает подобные проблемы в принципе. И что бы вы думали — следующую версию патча я получаю уже через час‑два. Естественно предположить, что коллега использовал мои замечания как ТЗ и сгенерировал код.
Замечательно, но тогда ревьюер превращается в архитектора, разве не так? Придумать новый дизайн — процедура затратная, и по времени, и по силам, а сгенерировать код — быстро. Значит, такой ревьюер быстро становится узким местом; пока у меня так оно и выходит. И по всему выходит, что нам всем теперь надо становиться архитекторами, оставив роль разработчика AI‑агенту.
С другой стороны, агент пишет код неидеально и часто спотыкается на ровном месте — просто потому, что сам принимает решение о каком‑то непрописанном нюансе — а это может быть важно для пользователя. Мы же не можем поместить в ограниченный контекст 20+ лет опыта каждого из членов команды? Так что спускаться на нижний уровень и выверять код построчно всё равно приходится. А это значит скакать между уровнями абстракции, и это работа ещё тяжелее.
В сухом остатке имеем дилемму агентной разработки, для которой я никак не могу найти подходящего решения: как перестроить процесс и заново распределить роли, чтобы каждый удерживал уровень абстракции, соответствующий его роли? Ну или как научить AI‑агента смело критиковать твой подход и самому пересматривать дизайн?
А что делаете вы?
THE END.
Мадрид, Испания. 27 октября 2026 г.
Комментарии (3)

benjik
27.10.2026 21:47Кажется стоит ревьюить дизайн (до кодирования) на соответствие задаче и текущим ограничениям, а потом ревьють имплементацию на соответствие дизайну и логические/перфоманс/сесурити ошибки.
Можно и "общего" реьюера натравить, но к его выхлопу относиться как ко мнению чувака из соседнего филиала, который хоть и грамотный, но не в контексте.
danolivo Автор
27.10.2026 21:47Ага, идея фонового фрондёра, который будет проверять на прочность адекватность продукта в целом мне тоже приходила в голову.
Но в основном-то проблема с набором знаний/умений/навыков, который характеризует понятия "опыт" и "надёжность" обычного, углеродного, разработчика. Как их уместить в by-design ограниченный контекст AI-агента?
hzhdlrp
Как же жизненно. Хуже, когда в ходе ревью ИИ пишет комментарии для ИИ, такая система однозначно не придет ни к какому стационарному состоянию)
Если качество кода очень важно, автор патча в любом случае должен его прочитать целиком, никуда от этого не деться. Если в среднем важнее фича, чем код, а изменения слишком большие, чтобы вчитываться в каждую строчку, стоит начинать реализацию с высокоуровневого проектирования: проанализировать контекст, окружающий код, составить план, дать агенту порисовать схемки и диаграммы. Тут не надо писать код, тут надо представлять связи с другими системами, флоу новых процессов, чертить стрелочки между квадратиками в общем.
Для реализации достаточно определить общие ограничения (тут хорошо подходят скиллы, например, разделять сервисный и бизнес-слои в коде, не писать бесполезных тестов, фактчекать ридми и не раздувать его и тд и тп).
Тогда при проверке теми же агентами скорее всего будут найдены только мелкие правки по коду, решить которые не составит труда. Большие проблемы скорее всего будут фундаментальными, и потребуют возвращения к начальному этапу, на котором кода, опять же, нет.
Стоит принять, что есть предел в экономии времени ИИ-агентами, и этот предел примерно там же, где предел допустимого качества нового кода, и прощупывается только на практике.