

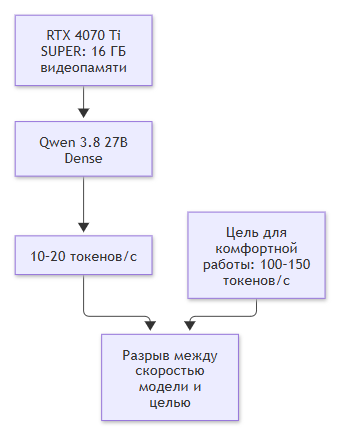
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.
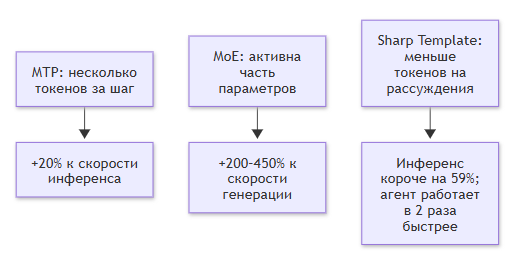
Но недавно я наткнулся на 2 модели: Tiel-Coder-35B-A3B-GGUF-MTP (заточена на кодинг) и Cyber-Tiel-Coder-35B-A3B-GGUF-MTP (abliterated-модель без цензуры, которая не отказывается писать эксплойты и проводить активные взломы всего, что ни попросишь). И вот чем они ещё примечательны? Во-первых, в них используется технология MTP (Multi-Token Prediction), позволяющая LLM предсказывать сразу несколько следующих токенов вместо одного, что даёт прирост скорости инференса на 20%. Во-вторых, используется архитектура MoE (Mixture of Experts), которая позволяет получить качество большой модели, выполняя для каждого токена вычисления только с частью её параметров. Прирост скорости генерации токенов составляет +200-450%. В-третьих, это Sharp Template, то есть оптимизированный Chat Template (Jinja) с системным промптом, который заставляет LLM тратить меньше токенов на рассуждения и ответы, не теряя при этом необходимой информации. Он сокращает инференс на 59%, что в итоге ускоряет работу кодинг-агента в 2 раза.
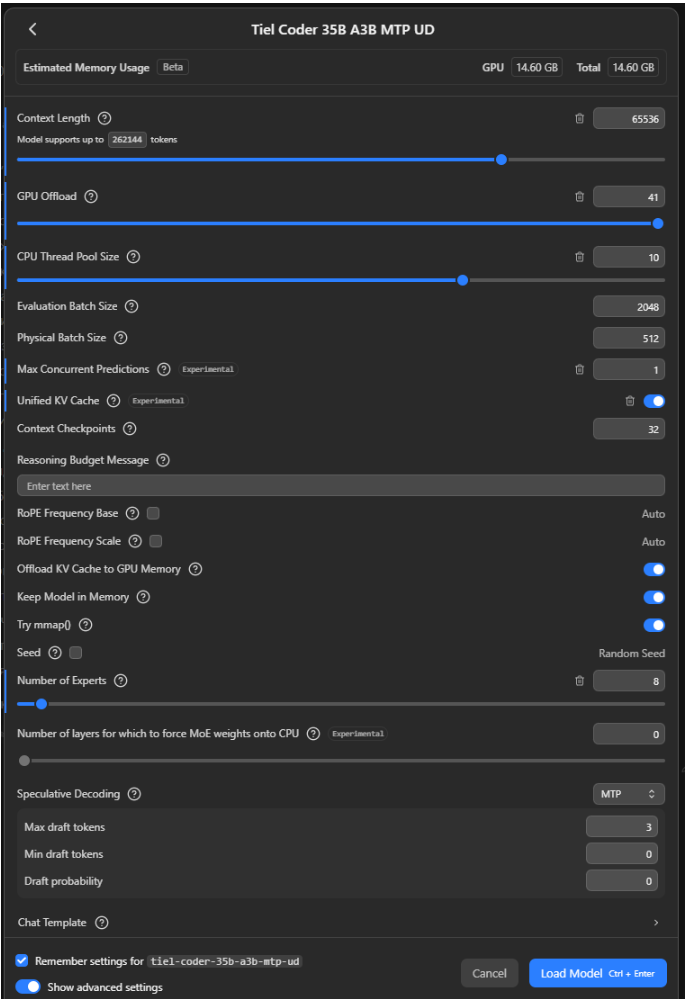
По итогу я на своей видеокарте запускаю следующие версии этих моделей: Cyber-Tiel-Coder-35B-A3B-MTP-UD-Q2_K_XL.gguf и Tiel-Coder-35B-A3B-MTP-UD-Q2_K_XL.gguf, а параметры запуска выглядят вот так:
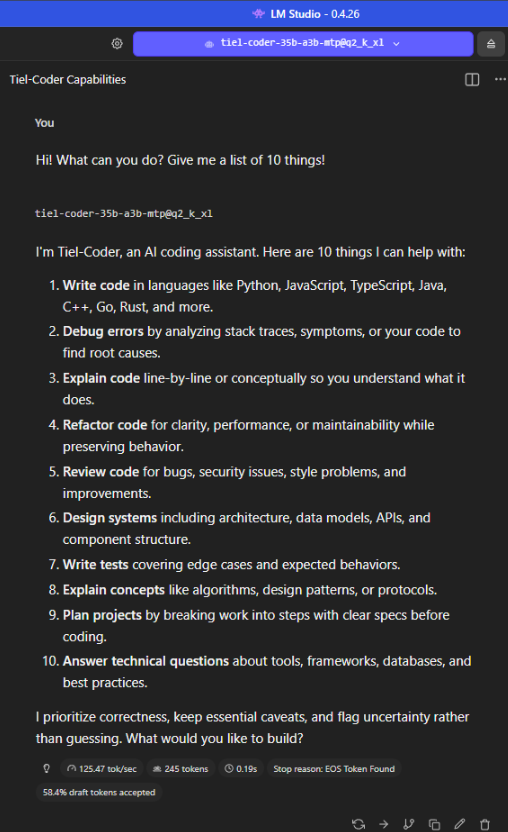
В итоге получаю скорость 125 токенов в секунду!
Это очень хорошее начало, но если вы заметили, то контекстное окно всего 65535 токенов, и для агентной работы при кодинге этого маловато. По этой причине я использую 3 подхода.
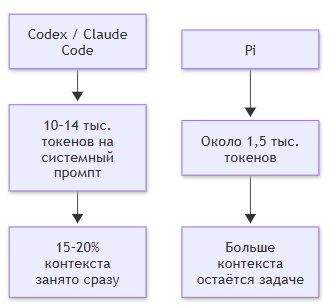
Во-первых, я не использую тяжёлые кодинг-агенты, такие как Codex или Claude Code, потому что они сразу из коробки при минимальном обращении съедают от 10 до 14 тыс. токенов на системный промпт и т. д. То есть 15-20% контекста отъедается сразу, и притом локальные модели легче теряют контекст, а такие большие системные инструкции ещё сильнее отвлекают их от задачи, которую формулирует пользователь. Я использую кодинг-агента Pi, для его работы требуется 1,5 тыс. токенов, и это в 10 раз меньше, чем у Codex или Claude Code, что ощутимо влияет на возможности и качество работы на локальной видеокарте пользователя. Вот конфигурационный файл от Pi, чтобы добавить эти 2 модели, которые будут крутиться у вас на видеокарте: ~/.pi/agent/models.json
{
  "providers": {
    "lmstudio": {
      "baseUrl": "http://ВАШ_ЛОКАЛЬНЫЙ_IP:1234/v1",
      "api": "openai-completions",
      "apiKey": "lmstudio",
      "models": [
        { "id": "peculiar-ragdoll/tiel-coder-35b-a3b-mtp@q2_k_xl" ,
          "contextWindow": 65536,
          "maxTokens": 32768,
          "input": ["text", "image"]
       },
        { "id": "peculiar-ragdoll/cyber-tiel-coder-35b-a3b-mtp" ,
          "contextWindow": 65536,
          "maxTokens": 32768,
          "input": ["text", "image"]
       }
     ]
   }
  }
}
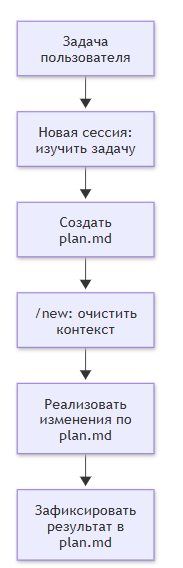
Во-вторых, я никогда не прошу кодинг-агента пытаться сделать крупное изменение в коде напрямую. Я начинаю новую сессию командой '/new' и прошу кодинг-агента написать файл plan.md, который будет описывать, что надо изменить в коде, чтобы реализовать поставленную мной задачу. Таким образом, мне хватает контекстного окна в 65535 токенов, так как, по сути, я задачу разбиваю на две фазы: планирование и реализацию. В итоге, если задача не слишком крупная, после создания plan.md я очищаю контекстное окно кодинг-агента командой '/new' и прошу его внести правки в код на основе plan.md и по завершении работы в plan.md зафиксировать результаты.
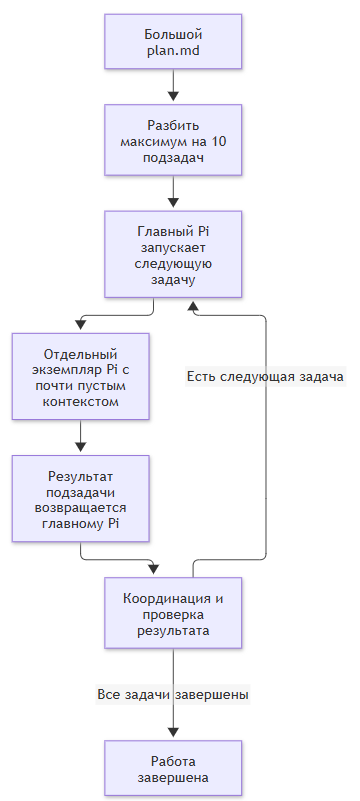
В-третьих, для очень больших plan.md я использую свой SKILL под названием subtask4llm-pi, который разбивает задачу не более чем на 10 подзадач и выполняет их последовательно. При этом каждая подзадача запускается в отдельном экземпляре кодинг-агента, куда передаётся только то, что относится к подзадаче, а его контекстное окно размером 65535 токенов будет почти пустым. Результаты работы подзадач стекаются в главный экземпляр Pi и не переполняют его главное контекстное окно, которое занимается координацией, планированием и проверкой. Скилл вы можете установить командой "npx skills add https://github.com/evgenyigumnov/subtask4llm --skill subtask4llm-pi". Также есть версия для Codex - subtask4llm-codex. Кстати, если у кого есть желание добавить поддержку Claude или чем-то ещё помочь, то шлите пул-реквесты https://github.com/evgenyigumnov/subtask4llm
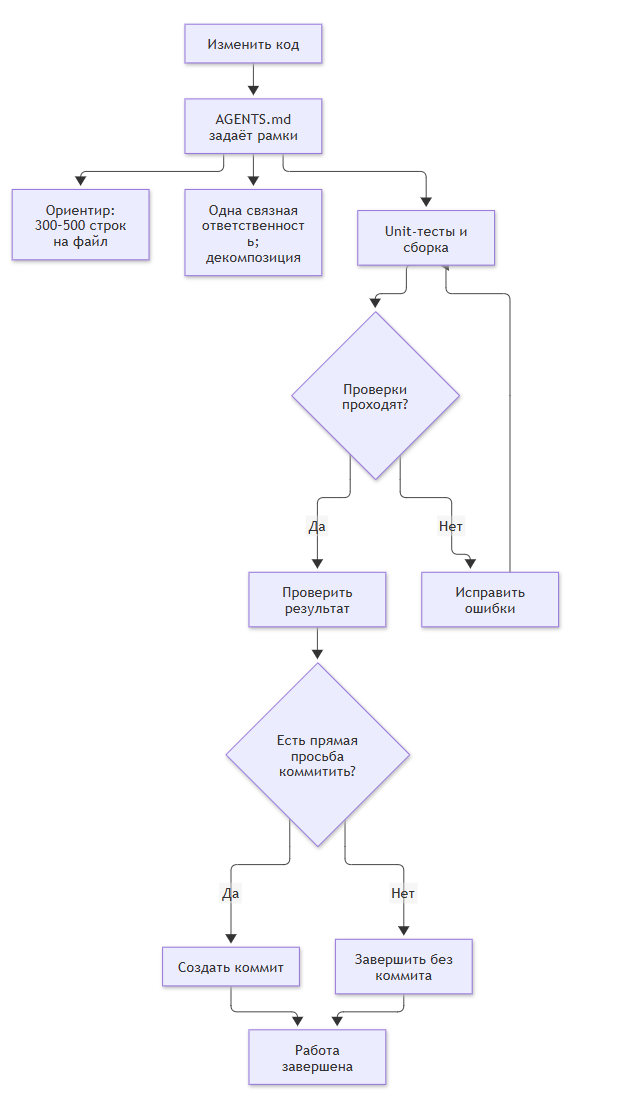
В-четвертых, я использую подход Роберта Мартина, автора книги "Чистый код", который недавно заявил, что перестал читать код, который генерируют кодинг-агенты. И этого он добился, загнав LLM в жесткие рамки. Используя эти рамки, можно нивелировать то, что используемые модели сильно ужаты до уровня UD-Q2_K_XL. То есть они допускают больше ошибок, чем 4-, 6- или 8-битные модели. И чтобы создать эти рамки, я предлагаю использовать AGENTS.md, который контролирует размер каждого создаваемого файла, заставляет писать юнит-тесты, четко формулирует декомпозицию и ответственность в коде, ну и в итоге требует прогона тестов. Так как на локальной видюхе мы не платим за каждый токен, то мы безболезненно переживем пару лишних итераций, когда модель увидит свои ошибки и исправит их. Вот базовый пример файла AGENTS.md для этого:
# AGENTS.md

## Правила написания кода

- Максимальный размер одного файла с кодом - 300-500 строк. Если файл становится больше, выполняй декомпозицию.
- Главный принцип - одна связная ответственность на модуль.
- Не жертвуй логической связностью или читаемостью кода ради соблюдения произвольных ограничений на количество строк.
- Разделяй файлы исходя из их функционального назначения, а не только по количеству строк.
- Все функции должны быть покрыты unit-тестами.
- При добавлении или изменении функциональности, а также при исправлении ошибок обязательно добавляй соответствующие unit-тесты.

## Проверка перед сдачей

- Все тесты и сборка должны проходить без ошибок и предупреждений.
- Не ослабляй проверки и не удаляй тесты ради успешного прохождения тестирования.

## Главное правило

**Никогда не коммить изменения без прямой просьбы пользователя.**
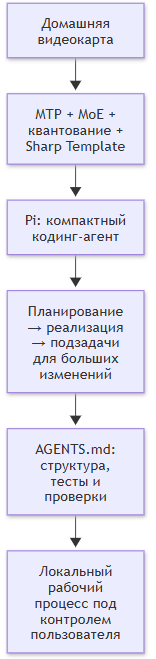
В итоге у нас произошёл синергетический эффект, или, можно сказать, даже эмерджентность. MTP + Квантование + MoE + AGENTS.md (Чистый код) + Sharp Template + Pi agent + subtask4llm skill + plan.md = рабочий процесс с кодинг-агентом, запущенный на вашей домашней видеокарте. Теперь ваши исходники под вашим контролем, и на них не наложат свои грязные лапы крупные корпорации! И ещё можно запустить abliterated-модель для White Hat-хакинга и не мучиться постоянными отказами от проприетарных моделей, когда пытаешься что-то там взломать.
Комментарии (81)

SergeyPerm
27.10.2026 09:28попробуйте формат nvfp4 на vllm, он дает ощутимый прирост, но условия спартанские
до этого был на llamcpptensorrt не осилил :)

NeoCode2
27.10.2026 09:28Вообще как думаете (я уже наверное всех достал этим вопросом), имеет смысл сейчас покупать RTX 5060 Ti 16Gb или просто тупо подождать несколько лет когда все нормализуется и возможно за ту же цену можно будет купить карту с большим количеством памяти или отдельное APU устройство, чтобы уже без танцев с бубнами? При условии что ни для каких целей кроме "поиграться" мне это не нужно, да и "поиграться" вполне можно используя бесплатный дипсик?
Преимущества - автономность, чувство причастности к "настоящим айтишникам" (забавно), возможность делать на карте то, что на онлайн моделях делать запрещено; недостатки - цена самой карты и необходимость танцев с бубнами из-за ограничений объема памяти, на 16 гигах модель наверное (?) будет в среднем глупее чем на бесплатном чатботе.
И еще отдельная мысль про агентов. Собственно я никогда не пробовал ими пользоваться, но представил что я хочу, как лично мне было бы удобнее - и понял, что это должна быть некая среда разработки, где ИИ сначала предлагает аннотированные изменения, я вижу их в неком диффе (буквально старый код слева, новый справа, с комментариями ИИ что это и зачем), и там я могу попробовать скомпилировать новое без удаления старого, что-то принять, что-то отклонить, по чему-то попросить точечно откорректировать, и только когда мне всё понравится - принять измененную версию за основную. Преимущества - я буду знать что происходит в коде:)

Vlad_06
27.10.2026 09:28Чтобы "поиграться" можно взять карты AMD AI или Intel ARC
NeoCode2
27.10.2026 09:28А они по цене почти такие же.
Vlad_06
27.10.2026 09:28AMD на 32 Гб примерно 60% от NVidia такого же объема. Про 16 я не подумал, да, там разница не такая уж чтобы большая

Void-Cowboy
27.10.2026 09:28AMD AI дадут вам 128 гб видеопамяти (пусть и не такой быстрой как в видеокартах) когда сборка из видеокарт за те же деньги максимум 32гб
NeoCode2
27.10.2026 09:28Эта штука стоит около 350т.р. Да, я думал о такой, но для "поиграться" дороговато:(

MountainGoat
27.10.2026 09:28А толку? Если все эти 128 заполнить, то там скорость будет 0.8 токена в секунду.
Void-Cowboy
27.10.2026 09:28в реальности все не так плохо
по цифрам разрыв может достигать х8 в сравнении с топовыми видеокартами, но на практике я максимум х4 замечал в процессе работы
как по мне это допустимая цена учитывая что места достаточно что бы запустить реально серьезную модель для работы и еще осталось место под кеш который действительно проводит черту между разовыми запусками и полноценными кодовыми агентами
20-50 т/с хватает с головой для работы, размер контекста гораздо сильнее чувствуется на реальных задачах чем более медленная работа (к слову с видеокартами kv-кеш зачастую в ОЗУ из-за чего фактическая скорость работы все же ниже при запуске реальных кодовых агентов с субагентами и тд)
MountainGoat
27.10.2026 09:288х от 0.8 будет 6.4 а не 64. Никто не спорит, что на 30-50 жить можно, вот только этот AMD AI столько не выдаст с полной утилизацией 128Гб, даже близко.
Void-Cowboy
27.10.2026 09:28меньше слушайте тех кто даже не держал такое железо в руках
я владелец AMD RYSEN AI на 128гб и цифры выше это реальность причем на топовых локальных моделях под 90гб, всякие коротыши на 10-16гб разгоняют до 120 т/с с квантом q6

MrDetrox
27.10.2026 09:28На strix halo 128гб можно запускать qwen3.8-flash-next. С префилом 1.8к т/с и декодом до 60-90 т/с в зависимости от задачи. При этом возможно разместить в памяти 524тыс. токенов под контекст, что хватает на 2-4 параллельных сессий. Очень хороший движок под это дело https://github.com/peonist-ai/halogen-flash-server

igumnov Автор
27.10.2026 09:28Про модель не скажу, но выбирайте по пропускной свободности VRAM, чем она выше тем инференс быстрее будет. Не смотрите на TFLOPS метрику… И если денег не жалко берите 32GB это позволяет более крупные, а значит более умные модели запускать, а если не по средствам, то 16GB.

dmchmk
27.10.2026 09:28Не смотрите на TFLOPS метрику
ну не совсем правда. Терафлопсы нужны чтобы префил был. А вот скорость генерации - это пропускная способность памяти, да

mosinnik
27.10.2026 09:285060 16gb - это хорошо, но всеравно мало и любая адекватная модель хочет больше. Мой вариант две 5060 уже сильно лучше - Q4 кванты того же qwen3.8 27b уже с нормальным контекстом 200к+ и скоростью под 50-60тпс. Любая одна на 32гб - уже шикарно, но цена неадекватна.
Но все это разбивается об экономику - 5060 16гб сейчас это 65к+ даже на авито и это год опенкодовской сорокабаксовой подписки с нормальными моделями, которые можно просто использовать и не думать а с какими параметрами запустить чтобы сегодня то оно еще лучше отработало, а попробовать ли новый ниференс который вон там на гитхабе вроде как под конкретно мою карточку сделали, а не взять ли вот этот вариант модели один из сотен, но этот вроде говорят лучше - все это дикая срань для тех у кого просто дико большой вагон времени.
Для себя вывел, что это имеет смиысл если у вас либо задача, когда надо молотить чтото несложное без остановки дома и вам никаких лимитов подписак не хватит (было у меня такое), либо вы занимаетесь кишками инференса и ллмками дома (мой текущий вариант) и вам надо иметь доступ к железу прямо здесь и сейчас. Вариант что человек отбитый и занимается неправоправной деятельснотью с помощью расцензуренных моделек опустим.
А про агентов и ваша хотелка видеть код слева и спрва - это называется ветка в гите и диф между ветками

PeeWeee
27.10.2026 09:28…это год опенкодовской сорокабаксовой подписки с нормальными моделями, которые можно просто использовать и не думать…
Даже немного завидую такому непоколебимо-незамутненному
оптимизмуумению игнорировать нарастающий гавноворот.mosinnik
27.10.2026 09:28расшифруйте, что именно я игнорирую, а то под "гавноворот" у меня сейчас многовато кандидатов и лишь малая часть из них както связана с ИИ

cheshircat
27.10.2026 09:28В целом вы правы, но порой я задумываюсь что сейчас оно доступно, а что будет в будущем не очень понятно. Может и цена начать подниматься и доступ станет меньше, да и какая-нибудь регуляция может начать палки в колеса вставлять. Хз конечно что будет. Возможно перспективнее иметь свою модель.
mosinnik
27.10.2026 09:28Если сейчас ваша работа с ллм позволяет получать достаточный профит, чтобы купить свое железо, то почему бы и не прикупить? Но тут вот что подумалось, в связи с увольнениями в IT может статься так что через условный год пользоваться ллмкой может и не получится ввиду смены сферы деятельности или профит от ее использования в локальном исполнении будет ничтожен, надо ли оно будет?
Сейчас собирать хороший сетап под локальный агентный ллм на квен3.8 или брать подписки на топ модели это как выбирать брать ли свою машину или ездить на такси - одно другое не отменяет, и у каждого свои плюсы и минусы. Считайте бюджет и оценивайте профит

Ka463
27.10.2026 09:28Да подписка это хорошо, но есть нюанс, так у вас остается видеокарта, а подписка дает тыкву и кучку не кому не нужного кода, просто поиграться че-то дороговато выходит.
mosinnik
27.10.2026 09:28если подписка дает тыкву, то и локальная карточка не нужна, так как тут будет тыква, но только за кратно больше денег)
Подписка сейчас как раз позволяет с помощью хорошей модели за относительно дешево реализовать чтото, что принесет деньги и позволит уже купить карточку "чтоб была". А то будет как у автора этого поста - получил какието трехзначные тпс на каличной переквантованной модели, но не сделано ни одного реального проекта который бы принес денег на этом сетапе

rPman
27.10.2026 09:28@NeoCode2, имеет смысл сейчас покупать RTX 5060 Ti 16Gb
16гб не имеет смысла покупать от слова совсем.
минимум 32gb vram лучше 48
Адекватная производительность и функционал для агентских задач минимум требует суммарно 32гб хотя бы 2 gpu лучше 1 но это дороже в разы (и это с оговорками, например контекст будет ограничен примерно 190к, терпимо). Любые решения, работающие на меньшем объеме vram - не подходят для агентских задач. Агрессивная квантизация ломает модели, все что меньше 4bit не рекомендую (будут проблемы именно в агентских задачах), помню игрался с какой то моделью с ternary bit (хитрая квантизацияqwen3.6-35b-a3b) так вот она держалась какое то время в агентском окне но все равно ушла в повторы и глюки. это беда всех файнтюнов, они фиксируют модель на простые задачи вопрос-ответ но не на длинные сессии в 100к токенов (а это обязательное требование агентских задач)
Еще, работа агента на cpu не имеет смысла, так как даже если с помощью слабой gpu можно ускорить генерацию (незначительно), prefil (анализ входных токенов) будет неадекватно медленным, в сотню раз медленнее gpu, а это десятки минут и даже часы на то что бы модель просто начала работать по вашей задаче, собрав информацию.
p.s. даже на gpu (потребительских) обычная фаза размышлений qwen3.8-27b - лучшей модели для таких объемов vram, длится 5-8 минут, т.е. вы пишете вопрос, оно думает, получает агент новую информацию - думает и так в любой момент, задачи решаются десятки минут, а сложные - часы).
Если думать только о деньгах - свой gpu сервер для этой модели имеет смысл либо если у вас очень уж личные данные или странные задачи, либо работает этот агент часами в сутки ежедневно.
Если ваши задачи - считанные сотни миллионов в сутки токенов, то лучше купите подписку или api и пользуйтесь условной glm 5.3 flash (или deepseek flash или что хотите, вроде новая kimi flash должна быть дешевой и лучшей), только советую надежных посредников а не мутных со своим эндпоинтом (подсадят трояна незаметно, украдут все что плохо лежит), вроде бы в наших реалиях openrouter наилучший вариант, а если подписка то топайте к opencode zen (они вроде тоже криптовалютой позволяют оплатить и даже vpn не понадобится).

RTFM13
27.10.2026 09:28Для агентского программирования -
от 24 (Qwen3.8-27B-UD-Q4_K_XL) например та же 3090 за сравнимые деньги будет сильно лучше.
лучше 32(Q6_K_M),
48 совсем хорошо (Q6_K_XL).
Память добиваем контекстом.
Для чатика любая MoE и карта от 8GB

max-daniels
27.10.2026 09:28Никто не знает будущего, но говорят дальше будет только хуже. Следующее поколение надо ждать минимум года через полтора. По слухам, готовят выпуск RTX 5080 Super с 24Гб VRAM, но цена будет конской, скорее всего.
Как вариант, посмотри на Tesla V100 с 32Гб - дешево и сердито. А так люди вполне нормально запускают LLM на 16Гб VRAM(есть всякие хитрые GCQ-RCO с 3.5 битным квантованием). Если есть много обычной RAM(32, а лучше 64Гб ОЗУ и больше), то можно использовать Strata + Qwen 3.8 flash next 125b. Он будет намного умнее чем Qwen 3.8-27b и моделя из статьи(все-таки 125 миллиардов параметров). Яндекс(Алиса) говорит на 5060Ti выдает около 70 токенов/с.
это должна быть некая среда разработки, где ИИ сначала предлагает аннотированные изменения, я вижу их в неком диффе
Просто ставишь GIT и всё. И там смотришь диффы и прочее.
там я могу попробовать скомпилировать новое без удаления старого, что-то принять, что-то отклонить, по чему-то попросить точечно откорректировать, и только когда мне всё понравится - принять измененную версию за основную.
Это уже прошлый век, сейчас агенты стали настолько продвинутыми, что стали умнее обычных программистов. Просто даешь задачу и идешь гулять, не надо ничего сравнивать. Можно отменить изменения через Git reverse. Главное написать задачу грамотно.
Скачай бесплатный Opencode и можешь вдоволь поиграться с агентами бесплатно, не надо никаких видеокарт. Сейчас там есть бесплатный дипсик.

Vindicar
27.10.2026 09:28Просто даешь задачу и идешь гулять, не надо ничего сравнивать. Главное написать задачу грамотно.
Нужно просто не совершать ошибок!


Orderon
27.10.2026 09:28Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf у меня на такой же карте выдает 70t/s на пустом контексте. Запускаю в llama.cpp с контекстом 131072.
Это достаточно комфортно и Qwen3.8-27B на мой взгляд значительно превосходят любые модели для локального запуска.
Если что - вот моя конфигурация:
llama-server.exe -m Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf --n-gpu-layers all --spec-type draft-mtp --spec-draft-n-max 2 --gpu-layers-draft all -c 131072 -ctk q4_0 -ctv q4_0 -ctkd q4_0 -ctvd q4_0 --parallel 1 --flash-attn on --temp 0.6 --top-k 20 --top-p 0.95 --host 0.0.0.0 --port 8080 --reasoning on --fit off --load-mode none --cont-batching --chat-template-kwargs “{“reasoning_effort”:“medium”}”Orderon
27.10.2026 09:28уточнение: мониторы подключены к встроенной видеокарте, поэтому RTX4070TI SUPER всю память может отдать для llm.

longfreakingname
27.10.2026 09:28а prefiller модель не пробовали? там у исты есть qwen 3.8 27b prefiller, как будто бв идея что он стримится с ссд только для префилла.

teraferma_io
27.10.2026 09:28Интересно, сколько из этих 125 t/s потом съедают лишние круги с тестами: даже в динамическом кванте на Q2 модель чаще путает имена и синтаксис. При ~3B активных можно попробовать Q4 (или хотя бы Q3) и вынести часть экспертов в оперативку. В llama.cpp это --n-cpu-moe, в LM Studio есть опция выгрузки весов экспертов на CPU, но она грубее и уносит всех экспертов сразу. Скорость просядет, но для агента это может окупиться. Было бы любопытно увидеть Q2 и Q4 на одной задаче: сколько прогонов тестов уходит в каждом случае.
igumnov Автор
27.10.2026 09:28Когда как. Иногда лишнего круга нет на багфикс. А так бывает 1-2 круга лишних. Но инференс, то быстрый и за каждый токен платить не надо )

stas_makarov
27.10.2026 09:28А какова была цель этого упражнения:
- Экономия?
- Безопасность?Если вы не сидите в закрытом контуре, работая с закрытой информацией, зачем все это?
Фронтирные модели все равно будут впереди.

Foggy4
27.10.2026 09:28А разве экономия и безопасность это мало? В локальную модель можно кидать все что угодно, вплоть до персональных данных, как по мне это уже само по себе весомый довод в их пользу. Понятно, что фронтирные модели впереди - это очевидно, но локальные модели уже могут ОЧЕНЬ многое и если они справляются с моими задачами, то почему бы их не использовать?
igumnov Автор
27.10.2026 09:28Ну да, пароли, токены и исходники никуда не уйдут. Плюс Cyber Abliterated версия позволяет заниматься взломом, ни одна проприетарная фронтирная модель вам такого не позволит. Просто будет отказываться выполнять ваши страшные приказы.


aboba123321b
27.10.2026 09:28Запускаю Qwen flash next 170b ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF iq3_s (это не тоже самое что iq3, а намного лучше) 90 токенов в секунду на 5080 16 gb vram через Strata(Стриминг с использованием vram + ram + ssd памяти)

Agubigubaga
27.10.2026 09:28Смысла использовать на данный момент что то кроме страты нет. Qwen3.8-FN намного лучше и быстрее и 27b квенов и moe 35b версий.

Breathe_the_pressure
27.10.2026 09:28А оперативки сколько? 64?
aboba123321b
27.10.2026 09:28да, но челы запускают это и с меньшим кол-вом озу
rPman
27.10.2026 09:28запустит то можно, толку то? если она задачи решать не сможет
а так, лучшая из слабых у LiquidAI, у них модельки от 0.45b c vision (примерно 1gb ram), даже может давать какие то ответы, но ни одна их модель даже 24b не подходит для задач терминальных и агентских, даже опасно, они вам снесут фотки по ошибке и скажут ой извините.
aboba123321b
27.10.2026 09:28Сможет конечно. Я каждый день использую Flash Next для своей работы (бэкенд на Python). А вот как раз модели от каких-то ноунеймов, которые вы советуете, я бы не рекомендовал использовать. Я бы понял и принял ваш тейк, если бы он прозвучал полгода назад - до выхода Qwen3.6 27B(Или qwen fn), - но сейчас он неактуален
Agubigubaga
27.10.2026 09:28Вы серьёзно сравниваете какую то ноунейм микромодель на 0.45b параметров с огромной MOE на 177b (125b + 52b ngram - это доп параметры, которые лежат на ssd)? У меня этот квен в квантовании Q3_XXS GSQ-RCO решал весьма сложные задачи, и не только в написании кода. Например, он делает мне вордовские отчеты по лабам с ГОСТовым форматированием для института, это сложнее кода. Он решил проблему с драйверами АМД на моём компе, которые постоянно вылетали в ошибку. Как и предыдущий комментатор писал, ваше утверждение очень плохо устарело примерно на полгода.

Foggy4
27.10.2026 09:28Cyber-Tiel-Coder и Tiel-Coder это хорошие модели, но далеко не лучшие. Мне кажется вы вполне могли бы запускать MOE модельки с контекстом в 200+ если его квантизировать в q8 и возможно уменьшить размер батча. Kак по мне пусть скорость будет ниже, но модель поумнее (квантизация Q2 это совсем грустно, почему не Q4 для 16Gb VRAM?). Ну и искренне советую попробовать Qwen Flash Next на Strata, если у вас есть 64Гб RAM, она точно будет сильно лучше того, что вы сейчас используете.
igumnov Автор
27.10.2026 09:28Охотно верю, но арендовать на vast.ai 64GB GPU за пару баксов в час мне смысла нет.
Agubigubaga
27.10.2026 09:28Так вам 64гб ОЗУ нужно для strata, видеопамяти хватит и 16гб.
igumnov Автор
27.10.2026 09:28У меня обычной RAM 96 GB и 16GB VRAM. Надо попробовать, но если запустить Q2 версию модели у меня, то сколько токенов в секунду будет выдавать? Просто модель очень крупная и квантование до Q2 ее меньше деградирует. Я просто скорость люблю - ждать решение задачи по 30-60 минут не мое. Я привык ждать 1-2 минуты ну максимум 10.

gotch
27.10.2026 09:28На таком железе порядка 50t/s, более чем комфортно и в чате, и в коде.
Strata
Model qwen3.8-flash-next-iq3_s
Context 262,144 tokens
KV cache 8-bit, streamed: 32,768 positions per layer in VRAM, the rest in RAM
GPU NVIDIA RTX A2000 12GB + NVIDIA RTX A2000 12GB, 24 GB
CPU AMD Ryzen 7 5700G with Radeon Graphics, 16 threads
RAM 63 GBigumnov Автор
27.10.2026 09:28Проверил! Ребят это бомба
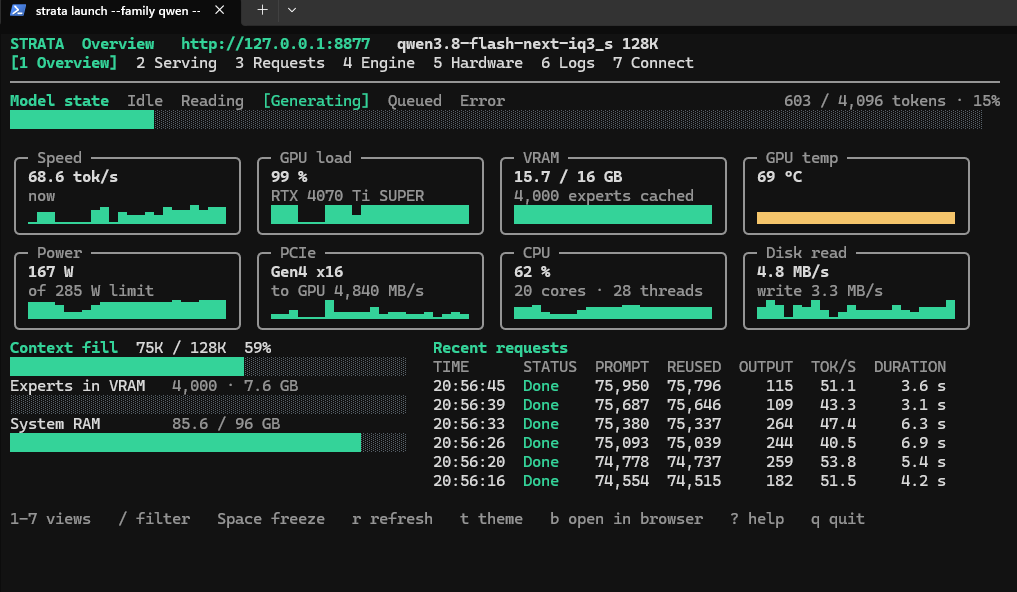
Я в своем сетапе заменю на эту модель и на этот способ запуска - она реально умная модель как OpenAI Luna 6 Max. Это бомба!
Agubigubaga
27.10.2026 09:28До 200к контекст можете поднять в принципе, я разницы в скорости с 128к контекстом не заметил. У меня amd rx7800xt 16gb vram + 64gb ddr4. Скоростя decode примерно такие же, только префил 500t/s вместо 1200+ t/s на нвидии. Если вам не лень, можно статью запилить про страту. А то очень много людей у нас про эту штуку не знают и продолжают плодить статьи про то как они запустили какой нибудь старый qwen3.5 9b на своём компе, и что он почему то кодит хуже чем фронтирная гпт Астра, в итоге называя локальные модели неспособным говном.

vpman
27.10.2026 09:28Еще одна статья-"Какъя" где автор собрал из вторсырья картинг, а потом из коментов узнал про Strata и что можно гонять на спорткаре даром.
А ей уже месяца полтора как...igumnov Автор
27.10.2026 09:28Согласен. Каждый варится в своем соку. Поэтому я и пишу - получаю фитбек и на нем развиваюсь. Разве это плохо?
vpman
27.10.2026 09:28Если цель засветиться на широком ресурсе, то да хорошо. Если принести реальную пользу людям, то хорошо бы сделать ресёч в области самоварения, чтобы не подавать свой компот холодным и прокисшим.
Хотя может из коментов еще кто-то про актуальные супер-движки типа Strata узнает, тоже неплохо...

Re1ter
27.10.2026 09:28Если внимательнее взглянуть на статистику Steam, можно увидеть, что видеокарты с 16 и более Гб памяти имеют ~32% пользователей, тогда как 8 Гб и менее ~55%
И цены на 16+ сейчас, прямо скажем, пугающие...
BarazuK
27.10.2026 09:28А что, прям все "рядовые пользователи настольных компов" непременно геймеры и имеют учетки в Стиме? Если смотреть не среди геймеров, а в среднем по палате, то там будет несколько другая картина. 16ГБ бояр будет по моим ощущениям меньше 10%.

spiteman
27.10.2026 09:28А на Gemma-4-e2b и контексте 8192 вышло бы больше :) А по факту, вы какое то недоразумение сделали, зато скорость токенов большая, прям как в анекдоте про женщину, которая машинисткой на работу устраивалась и говорили, что умеет печатать 300 слов в минуту.

Dushnoy
27.10.2026 09:28Насколько я понял, для хорошего кодинга нужна максимально доступная модель. Q4 это минимум. У вас есть 96Гб оперативки. Было бы интересно увидеть сравнение Qwen3.8-27B в оперативной памяти с 5 т/с и что угодно быстрое. Что бы понять, насколько выгоднее брать процессор и много памяти, что бы потом не выискивать ошибки в коде. Ну и вообще ревью на код в этих двух вариантах. Спасибо.

Goodronix
27.10.2026 09:28Не пробовали модель Ornith 1.5 35B? Ещё лучше - посмотрите её народные apex-оптимизации. У меня на ноутбуке выдает 50 ток/с

KapasMordorov
27.10.2026 09:28Странные комментарии в то время, как на реддите обсуждают и сравнивают движки Strata, Basalt, Infernix и запускают Qwen 3.8 FN 122B на 16Гб Vram и 32 RAM.

ponikrf
27.10.2026 09:28Да я тоже откровенно говоря в шоке с таких статей. Думаешь - ну вот хоть что то может быть интересное. А тут чел МОЕ модель на 3б активных параметров запускает. Это так же скучно как колупать собачий кал в песочнице.
BarazuK
27.10.2026 09:28По статистике, большинство домашних пользователей использует комп как печатную машинку с браузером, и не тратит 1000 бакинских на отдельную видяху, обходясь встроенной. Вы сильно путаете понятия "домашний пользователь" и "геймер".

Mintavrus
27.10.2026 09:28По началу из названия статьи я думал что она о чем то интересном (типа Strata оптимизировали для 4070TiS). А оказалось тут банальный запуск 35B-A3B в самых шакальных квантизациях :(((
shovdmi
и какие задачи или проекты вы реализовали на таком сетапе?
igumnov Автор
Пет проекты с нуля на раз два делает и быстро. Например Rust сервер который по REST API предоставляет доступ к Key-Value Кешу в RAM
mosinnik
Апи над квкешем - это поделка даже не уровня джуна а лабы студента. Какие проекты, которые приносят пользу и решают реальную задачу/проблему или может даже деньги приносят вы таким образом сделали?
igumnov Автор
Это мой стандартный smoke тест для ИИ агента на локальном GPU )
mosinnik
ну ок, а что реального то сделано? смок тест както не про реальную проблему
igumnov Автор
Какие-то публичные тексты я не запускал. Проверял на нескольких своих разных скилах, проекта, идеях. Работает более мене. Раньше (предыдущие попытки в течении нескольких месяцев) вообще не работало ничего, либо сильно медленно - либо вообще в бесконечные циклы входило.
YuryZakharov
Вы так и не ответили на вопрос. Речь не о публичности тестов, а о реальном выхлопе.
Ну, показали вы, что модель работает шустро, а что именно создано?
igumnov Автор
Пока что не создавал. Просто запустил Proof of concept. Из моих ответов это вроде видно.