

Привет, Хабр! Меня зовут Егор Шлюпиков, и я работаю старшим бизнес-аналитиком в YADRO в большой команде, которая менеджерит IT-оборудование. Мы следим за парком готовой техники и комплектующих, нужных для работы сотрудников. Сколько нужно купить, что залежалось, что в ремонте и утилизации и так далее — плюс финансовая аналитика.
В статье расскажу, как мы собрали сервис, который снял с нас немалую часть рутины: каждое утро он без участия человека выпускает более десятка отчетов с выводами от нейросети. При этом ни одно число в отчете не проходит через модель — все считает код, а она только пишет текст. Раскрою, как мы к этому пришли, зачем понадобился Trino и что делать, когда нужных данных в учетной системе просто нет.
Основной инструмент нашей команды — Apache Superset. Я заведую в нем инстансом нашего департамента: пишу SQL-запросы, собираю дашборды, веду сетку отчетов, готовлю их для себя и других отделов. Частично аналитика опирается и на Excel, в котором мы тоже представляем данные в некоторых аналитических разрезах. В общем, стандартная бизнес-аналитика.
Перемены начались с одной апрельской задачи. Нужно было посмотреть и оценить остатки на одном из складов. Тогда все старались активно работать с метрикой aged: какая доля активов лежит на складе уже слишком давно, больше года-двух. Так что после анализа нужно было еще и предложить, как разобрать залежавшиеся остатки.
Задача по аналитике была понятной. Эксперимента ради я взял выгрузку из Naumen.ITAM, вырезал все чувствительные данные — юрлица, названия складов и прочее — и скормил это нейросети с промптом сделать HTML-отчет. Получилось интересно, со множеством разрезов данных: ценность каждого из них была невысока, но в сумме они закрывали много вопросов.
Я подумал: в рамках отдельных задач это гораздо эффективней, чем каждый раз строить новые дашборды в Superset или ковыряться в Excel. Показал наброски руководителю и получил добро на развитие такого аналитического сервиса с помощью моделей в контуре компании.
Сервис внутри Dify
Для создания AI-сервисов у нас в контуре развернута lowcode-платформа Dify. Постепенно от простых запросов в ней мы перешли к более сложным пайплайнам, подключили бизнес-контекст как базу знаний: описание процессов, справочники, пояснения к метрикам. Перебрали доступные в контуре модели. Начали сталкиваться с ограничениями по контексту и поэтому стали отдавать Dify сводку данных — предварительно обработанный python-скриптом набор метрик.
Но и со сводкой модель иногда ошибалась: переносила числа в текст сама, по правилам промпта. Однажды в комментариях нейросети стали всплывать одни и те же цифры, часто даже не к месту. Оказалось, что это были цифры из среза активов в тот день, когда мы подключили базу знаний. А должны были — актуальные данные по отчетам на нужный момент. Это натолкнуло нас на жесткое разграничение: графики HTML-отчета собирает линейный алгоритм, а нейросеть генерирует только комментарии к отчету без цифр.
За пределы Dify нам пришлось вылезти, когда потребовалось разделение доступов. Иначе разные группы потребителей могли видеть отчеты друг друга. Кроме того, в Dify приходилось хранить параметры подключения к базе в настройках пайплайна, чего тоже бы не хотелось. Расписание обновлений, статистика и уведомления — все это Dify тоже предоставить не может, поэтому нужно было выходить за ее пределы.
Генератор отчетов отдельно от нейросети
Мы изолировали работу по составлению отчетов и от работы AI по ним, опять же, с помощью скрипта. Получив все показатели, он готовит два набора данных: полный — для составления шаблона отчета, со всеми рядами и срезами, и сжатый — для модели. В нем показатели объединяются в несколько десятков ключевых чисел, весь же массив строк модель не видит никогда.
Модель анализирует сжатый массив и возвращает по нему текст: наблюдения, интерпретации, красные флаги. Вместо конкретных чисел в этих комментариях стоят метки, на место которых значения подставляются уже при сборке отчета — по тем же правилам, что в шаблоне. Модель физически не может исказить показатель: числа через нее не проходят.
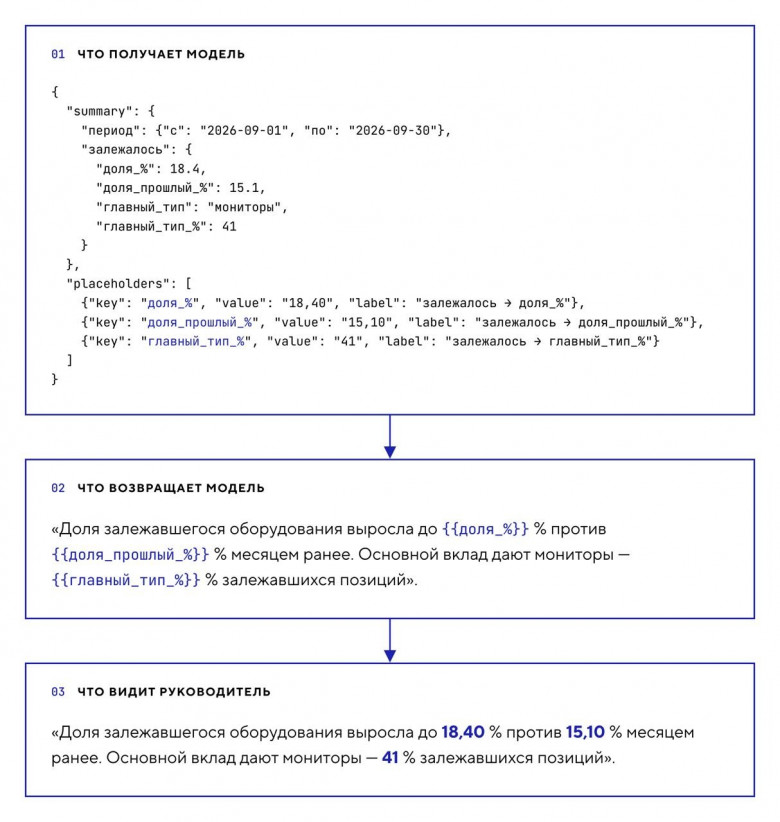
Вызов модели мы вынесли в отдельный клиент, так что ее можно заменить, не трогая остальной конвейер. Позже мы также вынесли в отдельные шаблоны внешний вид отчета: его можно быстро пересобрать, не трогая скрипт генератора.
К сервису уже было несложно прикрутить корпоративный keycloak, чтобы каждая команда видела только свои отчеты. Опыта промышленной разработки у меня не было — я аналитик. Первые полтора месяца код я писал сам и разбирался по ходу, а потом передал разработку коллеге Егору и сосредоточился на архитектуре и концептуальном развитии сервиса.
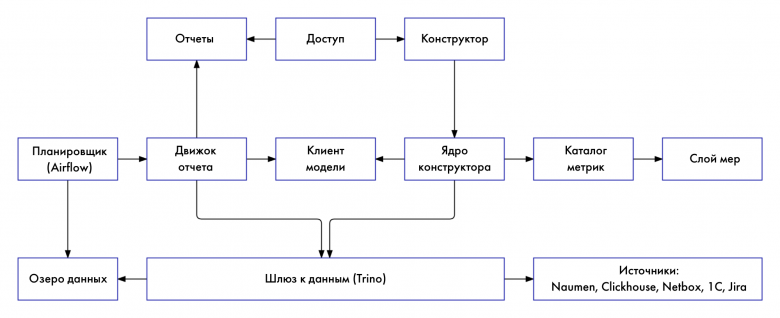
Мы вывели взаимодействие с БД из Dify в саму виртуалку, чтобы она общалась с источником данных напрямую. Тогда он был еще один — Naumen.ITAM. Тестовые отчеты отработали хорошо. Мы поняли, что для части задач у нас, по сути, получилась альтернатива Superset, причем с несколькими сравнительными преимуществами:
Отчеты дополняются комментариями от нейросети. Помогает не упустить важное, и быстрее принять решение. Выглядит интереснее и ближе к пользователю.
Отчеты более гибкие, поскольку представляют собой HTML-страницы, содержимое которых легко менять.
Модель помогает быстрее собирать черновики новых отчетов по запросам заказчиков. С основным полным отчетом, который обновляется ежедневно, модель дела не имеет.
Если сравнить затраты по времени, то отчеты с новым сервисом для тех же запросов получались в несколько раз быстрее, чем по старинке со сборкой дашбордов. При сохранении качества.
Расширяем поддержку источников
Мы могли бы наделать миллион разрезов одних и тех же данных по железу из Naumen.ITAM. Но для полноценной аналитики этого недостаточно. Чтобы нашим сервисом могли также пользоваться руководители для принятия решений, критически важно было увеличить перечень источников. Например, чтобы решить, сколько ноутбуков купить для новых сотрудников, нужно знать не только количество ноутбуков на складах, но и число новых сотрудников, а также оставшийся бюджет — это данные приходят из 1C и BI/CPM-платформы. Кроме того, не помешает оценить и заявки пользователей на оборудование — а это уже Jira. Также источником данных о размещении оборудования выступает NetBox.
Данных получалось все больше, и мы вынесли весь слой работы с данными на отдельную виртуалку, поставили туда Trino — распределенный SQL-движок для аналитики больших данных. На тот момент это было чересчур, но мы решили заложить запас прочности, чтобы консолидировать на этой виртуалке все данные и отдавать их уже дальше в точку, которая раздает отчеты. Отделив таким образом аналитический контур, мы повысили отказоустойчивость. Если вдруг база не отвечает на запрос, то доступность самих отчетов вообще не снизится.
Вообще, Trino оказался в итоге ключевым архитектурным решением сервиса. Он закрывает сразу две задачи, которые иначе пришлось бы решать отдельными выгрузками и склейкой в скриптах.
Первая задача: Trino делает склейки по времени. В Naumen.ITAM у нас два источника с разной «правдой»: текущее состояние — в реплике боевой базы, история — в ClickHouse, куда раз в сутки добавляется полный слепок. Я решил не выбирать между ними, а объединить: через Trino один федеративный запрос берет сегодняшнюю точку из реплики, а вчерашний день и всю историю — из ClickHouse. Для отчета это выглядит как одна таблица с полной историей до текущего момента.
Ограничение при этом остается: история идет с шагом в сутки, и статусы, что менялись в течение дня, в нее не попадают. Это определяет, какие метрики по времени можно считать честно, — например, скорость процессов по такой истории мы считаем крайне осторожно.
Вторая задача Trino — склейка между системами. Например, из Naumen.ITAM мы знаем, за какой командой числится сервер, а из NetBox — в какой стойке ЦОДа он стоит и что есть рядом с ним. Федеративный запрос соединяет данные, и мы видим, по каким командам распределяются расходы на конкретную стойку. Ни одна система сама по себе этого не показывает. А поскольку генераторы отчетов не знают, откуда пришли данные, переписывать отчеты при подключении нового источника не нужно.
Что получилось на сегодня
На этом мы подходим к боевой эксплуатации сервиса. Если обобщить, сервис аналитики работает так:
Airflow запускает DAG — на Airflow мы в итоге перешли с cron.
Данные читаются через Trino.
Python-скрипт считает показатели, отдает данные модели и шаблону.
Модель пишет выводы, шаблон собирает отчет в HTML.
Отчет публикуется.
Сервер показывает HTML по конкретной ссылке.
Если более подробно и отталкиваясь от компонентов, порядок таков:
Naumen.ITAM является источником истины по IT-активам: состав когорт, справочники, история статусов. ClickHouse DWH — корпоративная витрина с суточными снимками парка. Оба источника опрашиваются через Trino: прямых подключений у генераторов нет.
Airflow по расписанию запускает DAG отчета. Данные читаются через слой доступа Trino: состав когорты из Naumen.ITAM, история состояний из витрины ClickHouse. Далее проходит расчет показателей, запрос комментариев от нейросетей у Dify и рендер HTML. Для всех отчетов используется общий движок.
Отчет сохраняется с меткой времени, сервис переставляет ссылку на последнюю версию и публикует отчет через защищенный веб-контур.
Пользователи открывают отчет в браузере после аутентификации через корпоративный keycloak и проверки прав в validator. Реализованы роли владельцев, администраторов, пользователей и суперпользователей.
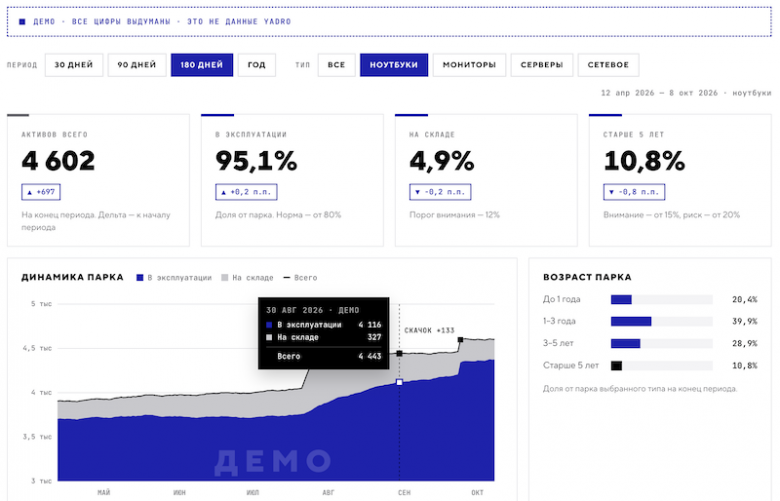
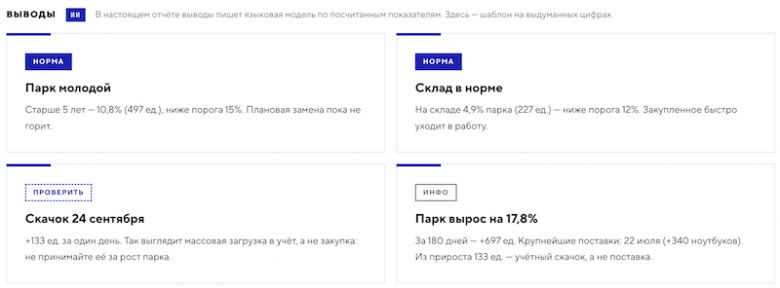
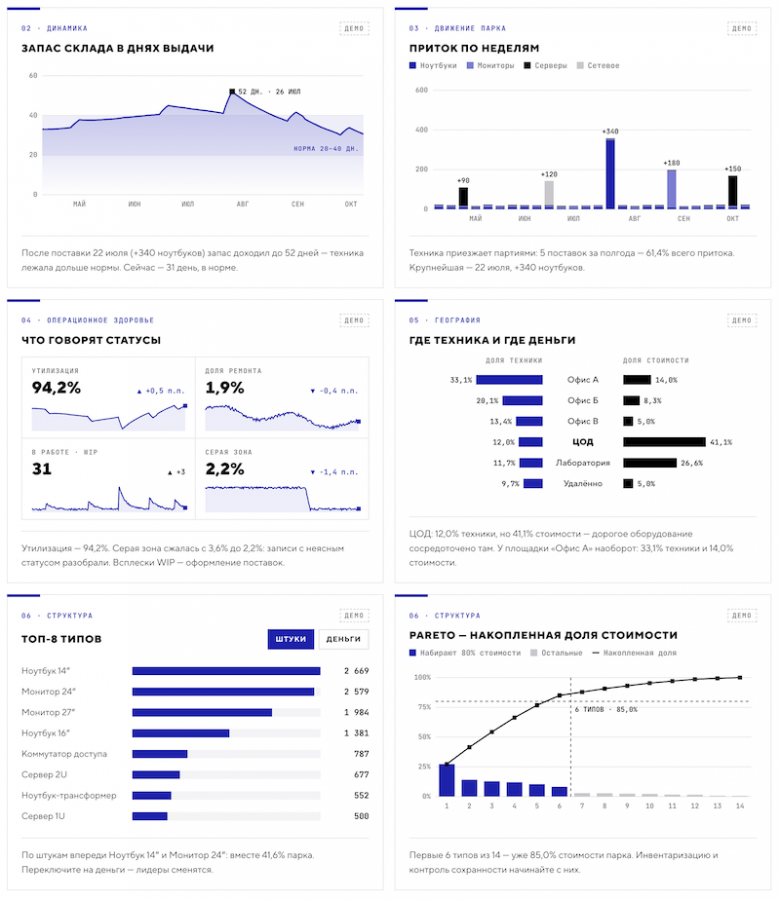
За пределами деморежима доступно много других графиков: история выбранного типа оборудования по неделям, крупнейшие однодневные скачки, залежавшаяся техника, качество данных и не только.
Для более дружелюбного пользовательского опыта мы добавили интеграцию с корпоративным Mattermost. При запросе доступа к отчетам уведомления приходят в чате владельцу отчета, и он там же может выдать доступ. Также через Mattermost можно посмотреть и обновить все доступные отчеты, оценить статистику посещений и оставить комментарии для нас, разработчиков сервиса.
Ошибаются не только нейросети
Профессиональных разработчиков среди нас, команды GRID, не было. Поэтому разработку с самого начала построили так, чтобы ошибка стоила дешево. Код находится в корпоративном гитлабе, изменения принимаются только через merge request, причем обязательно не автором изменения. Каждое обновление сначала сутки работает на отдельном стенде и только потом выкатывается. Если приемка не прошла, происходит автоматический откат.
Мы с самого начала заложили управляемую деградацию: если модель недоступна или ответила некорректно, отчет все равно выходит вовремя и с верными числами — просто без текстовых выводов. Технические работы на стороне платформы или недоступность модели не останавливают выпуск отчетов. LLM имеет дело лишь с несколькими десятками сводных чисел, на основе которых возвращает текстовые выводы.
Справедливости ради признаю: модель мы ограничили, но качество исходных данных осталось важным фактором успеха. С появлением сервиса разрезов стало больше, и вместе с этим всплыли пустоты, которых раньше никто не замечал.
Хороший пример — совокупная стоимость складских остатков по данным оперативного учета. Раньше такую метрику никто не считал: хватало данных бухгалтерии. Но когда появился сервис, пришел запрос на оперативный доступ к стоимости остатков, для управления ликвидностью. Проблема оказалась в том, что цена в Naumen.ITAM заполнена далеко не у всех позиций.
Мы решили это импутацией по когортам. Разбили оборудование на группы минимального размера, внутри которых железки предположительно однородны: один тип техники, одна модель, один производитель, один год выпуска. Внутри каждой когорты посчитали среднюю цену по позициям, где она есть, и распространили ее на остальные. В отчете это всегда разделено: отдельно стоимость по фактическим ценам, отдельно — оценка через импутацию.
Если в когорте цены нет ни у одной позиции, решение зависит от требуемой точности: где-то можно укрупнить когорту, где-то лучше оставить ее без оценки — с явной пометкой в отчете. Результаты мы сверяли с данными бухгалтерии и вышли на сопоставимые цифры. Так у руководителей появилась оперативная оценка стоимости остатков там, где исходных данных просто не было.
Качество данных в каждом новом отчете мы проверяем вместе с заказчиком. Быстро собираем первый драфт в виде файла, вносим комментарии заказчика, затем он подтверждает цифры, и отчет идет в работу. Готовый отчет мы подключаем к источникам и ставим расписание, по которому сервис забирает новые данные из источников и отчет пересобирается на актуальных данных. Перед первым выходом отчет сутки работает на отдельном стенде.
Итоги и планы по сервису IT-аналитики
Создание сервиса заняло около трех месяцев — это был один из проектов у меня и моего коллеги Егора Катаева (спасибо, Егор!). Сейчас каждое утро больше десятка отчетов для пяти департаментов выходят без участия человека.
К нам стали приходить с задачами, которые в BI-инструменте не решаются вовсе, — сведение данных из нескольких систем, разбор свободных комментариев в опросах. Мы смогли сделать свои отчеты более удобными, а значит, и привлекательными для пользователей. Закрывать каждый запрос через BI — дорого и неэффективно.
Мы продолжаем развивать сервис, для чего сейчас разрабатываем конструктор отчетов. Пользователь описывает нужный разрез словами. Модель собирает из этого запроса описание того, что нужно посчитать. SQL собирает семантический слой на Cube по заранее описанным мерам. Здесь модель также не трогает ни запрос, ни числа — это прямое продолжение главной идеи. Сейчас конструктор доступен администраторам, Cube работает на тестовом стенде.
Пробуем новый для себя формат — разбор внутренних опросов о качестве поддержки. Здесь модель впервые работает не с числами, а со своей сильной стороной — смыслами словесных комментариев. BI-инструмент работает с полями, агрегатами и, очевидно, разбирать смысл текста не умеет, поэтому задача и пришла к нам. Собрали первый драфт, теперь после положительной обратной связи доводим его с заказчиком до регулярного отчета. Принцип тот же: модель относит комментарий к теме, а цифры считает код. Качество разметки пока проверяем выборочной ручной сверкой: проекту неделя, и мы еще не разобрались, как делать такую проверку надежной и масштабируемой.
Наконец, мы создаем и свой слой хранения — озеро данных. Прогоны пишут туда рассчитанные показатели, ежедневные срезы парка оборудования копятся — и в итоге открывают динамику, которой нет в источниках.
Ключевой вывод
Главное, что мы вынесли из этих трех месяцев: нейросеть в отчетности полезна ровно настолько, насколько четко очерчена ее роль. Код считает, а модель работает со смыслами: пишет выводы к отчетам и, например, относит к темам комментарии из опросов. Это разделение оказалось важнее выбора конкретной модели или платформы. Благодаря ему отчеты выходят вовремя, даже когда модель недоступна, а саму модель можно заменить, не трогая конвейер.
Второй вывод менее очевидный: самым сложным оказалась не нейросеть, а данные. Сервис подсветил пустоты, которых раньше никто не замечал, и значительная часть работы ушла на то, чтобы честно их закрыть или хотя бы честно пометить.
Впереди — конструктор отчетов, где пользователь описывает задачу словами, а новый отчет собирается уже без нашего ручного участия. Если тема интересна, расскажем, как это устроено, когда доведем до прода!
Если вам интересна работа с данными, обратите внимание на наши вакансии:
Zenitchik
Погодите, а зачем в отчёте что-то кроме цифр? Где точка приложения ИИ?