

Или о том, почему десять пользователей иногда полезнее тысячи звёзд на GitHub.
Начну с моей принципиальной позиции — за локальные харнесы надо отрубать руки на уровне любой компании больше 3,5 человек. Это просто способ потешить чсв программера, гарантированный способ продолбать весь накопленный опыт и инструментарий с его уходом, крайне эффективный способ слить впустую трудочасы на разворачивание и настройку тучи интеграций с MCP‑серверами, сервисами и рабочими окружениями, а потом рано или поздно агент что‑то набедокурит на этой машине с правами локального администратора.
При этом готовых взрослых мультитенантых харенсов раз‑два и обчелся, причем они все требуют сложного конструирования из отдельных запчастей. Пять месяцев я пытался собрать из существующих open‑source‑компонентов нормальную среду для корпоративной разработки с ИИ‑агентами.
Не очередной чат с кнопкой «запустить агента». Мне нужна была система, в которой агент может получить задачу, разложить её на подзадачи, делегировать работу, дождаться людей, собрать артефакты, пройти проверки качества, исправить ошибки и вернуться к заказчику не с бодрым «готово!», а с результатами и доказательствами.
В качестве основы я взял GoClaw и долго его допиливал. Допиливал, потом ещё допиливал, потом начал допиливать то, что появилось в результате предыдущего допиливания. В какой‑то момент стало казаться, что я не столько использую open source, сколько участвую в его долгосрочном развитии.
А потом в систему пришло первые десять пользователей.
И тут выяснилось, что она умеет гораздо меньше, чем хотелось бы, и работает гораздо хуже, чем нужно. Тормоза, падения, проблемы с управлением длительными задачами. Полноценного HITL — human‑in‑the‑loop, то есть нормального участия человека в процессе — не хватало. Согласования, возвраты на доработку и прочие вещи, которые в корпоративной жизни почему‑то считаются нормальными, приходилось сооружать обходными путями.
Десять пользователей — не нагрузочный тест мирового масштаба. Но если система уже на таком масштабе начинает вести себя как капризный ребенок, это повод задуматься.
Я задумался. И в итоге начал писать Temporality.
Не потому, что весь open source плохой. И не потому, что я внезапно обнаружил в себе желание переписывать всё с нуля. Причина скучнее и неприятнее: я хочу получить гарантии на уровне системы, не долепливая очередные палки очередным добром.
1. Мне был нужен не агент. Мне была нужна работающая организация
Большая часть агентных фреймворков хорошо отвечает на вопрос: как дать модели инструменты, организовать цикл вызовов, подключить MCP, запустить подагента и получить результат.
Это полезно. Но в корпоративной разработке задача обычно начинается не с вызова инструмента и заканчивается не ответом модели.
Допустим, я поручаю агенту подготовить новую функцию для внутреннего продукта.
Он должен:
сходить к Васе и Пете, собрать информацию и уточнить противоречия;
сформировать артефакт с требованиями и источниками;
согласовать его с начальником соответствующего отдела;
дождаться моего утверждения;
только после этого начать разработку;
выполнить проверки, описанные в артефактах, связанных с используемыми навыками;
запустить автотесты и приложить результаты;
отправить результат Коле на согласование;
после решения Коли вернуться ко мне с итогом, историей процесса и доказательствами прохождения всех гейтов.
Причём это не девять пунктов в промпте. Это процесс с состоянием, участниками, правами, зависимостями, ожиданиями и последствиями отказа.
Вася не ответил — что дальше? Петя сообщил противоположное — кто разбирает конфликт? Начальник отдела вернул требования — мы начинаем сначала или продолжаем с нужного шага? Я не утвердил артефакт — может ли агент всё‑таки запустить разработку, потому что модель решила, что «в целом всё понятно»?
Нет, не может.
А если агент перезапустился, сервис обновили, подагент завершился с ошибкой или человек ответил через несколько часов, процесс не должен превращаться в археологическую экспедицию по логам и истории чата.
Вот здесь заканчивается задача «сделать умного агента» и начинается задача построить среду, в которой агенту вообще разрешено работать.
2. HITL — это не кнопка «Одобрить»
Человеческое участие часто реализуют примерно так: агент задаёт вопрос, пользователь отвечает, выполнение продолжается.
Для демонстрации это выглядит прекрасно. Для рабочего процесса быстро обнаруживаются нюансы.
Человек может не ответить. Может отказать. Может изменить исходные требования. Может согласовать один артефакт, но не другой. Ответ должен относиться к конкретному вопросу и версии данных, на основании которых этот вопрос был задан. А некоторые действия вообще нельзя выполнять до получения разрешения.
Если агент спрашивает: «Можно удалить базу?» — и пользователь нажимает «Нет», это не просто текст в переписке. Это решение, которое должно повлиять на выполнение.
Если через час агент продолжает работу, он не должен случайно повторить ту же операцию под другим названием. Если решение было принято для старой версии плана, нельзя молча считать, что оно распространяется и на новую.
Поэтому HITL — это часть модели исполнения. У него должны быть состояния, идентичность запроса, история решения и определённое поведение при отказе, тайм‑ауте и возобновлении.
И это касается не только опасных операций. Согласование требований, приёмка результата, подтверждение гипотезы, выбор из альтернатив — всё это обычные элементы работы, которую в реальной организации нельзя полностью отдать на усмотрение языковой модели.
Самое смешное, что именно эти «обычные элементы» часто приходится реализовывать самыми необычными способами.
3. Контекст не резиновый. Внимание тоже
В процессе разработки у меня постепенно сформировалась ещё одна идея: у агента должен быть не только бюджет токенов, но и бюджет человеческого внимания.
Это не попытка придумать красивое название для ограничения контекстного окна. Проблема шире.
Агент может потратить сотни тысяч токенов, перечитывая историю, которая почти не относится к текущей задаче. Подагенты могут повторно исследовать одну и ту же область. В контекст могут попасть устаревшие знания, длинные отчёты, промежуточные рассуждения и инструкции, которые уже не имеют отношения к текущему состоянию процесса.
Формально всё помещается. По существу — важное тонет в шуме.
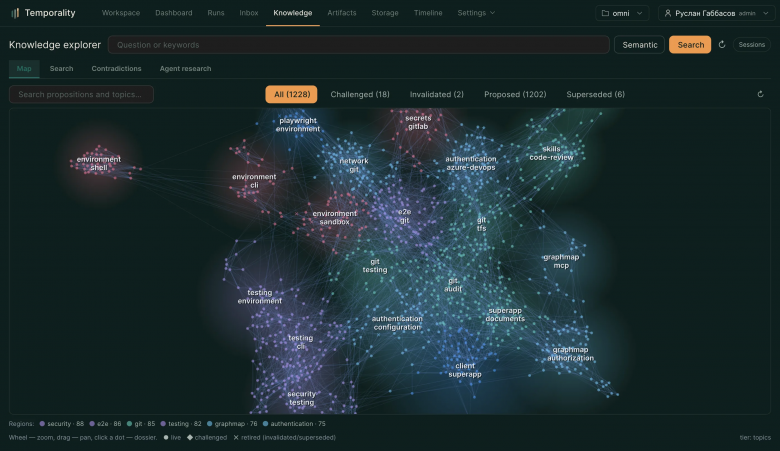
И чем длиннее задача, тем заметнее проблема. Один агент исследует код, другой пишет тесты, третий проверяет результат. Если каждый получает всю историю целиком, мы не получаем коллективный интеллект. Мы получаем коллективное чтение одного и того же журнала.
Поэтому бюджет внимания должен определять, что именно агенту нужно знать сейчас, а что должно оставаться доступным по запросу.
На практике это означает несколько вещей:
текущая задача и её ограничения имеют приоритет над общей историей;
контекст делегирования должен содержать цель, необходимые данные и критерии результата, а не весь разговор родительского агента;
подтверждённый опыт полезнее случайной заметки из прошлого запуска;
подробные доказательства должны оставаться доступными, но не обязаны целиком загружаться в каждый новый контекст;
расходы на модель, инструменты, повторные попытки и подагентов должны учитываться в рамках общей задачи.
Последний пункт особенно важен. Если родитель делегировал работу пяти агентам, нельзя считать, что каждый из них получил собственный бесконечный бюджет, не связанный с бюджетом родителя.
Мы смотрели на это как на сквозной бюджет выполнения: задача расходует ресурсы по мере прохождения цепочки делегирования, а не размножает их при каждом новом вызове.
Это одновременно вопрос стоимости, управляемости и надёжности. Если агент уже потратил большую часть бюджета на исследование, возможно, ему стоит сократить число гипотез. Если впереди обязательная проверка, нельзя потратить все ресурсы на первый вариант решения.
Бюджет — это не только ограничение агента. Это способ заставить его планировать работу с учётом того, что впереди ещё проверка, исправления и ответственность за результат.
4. Почему я перестал чинить чужую систему
Возвращаясь к GoClaw.
Я не собираюсь доказывать, что он не подходит никому. У него есть свои задачи, пользователи и сценарии. И сам факт, что проект открыт, не означает, что он обязан быть готовой корпоративной платформой.
Но у меня были конкретные требования. После подключения примерно десятка пользователей я наблюдал деградацию производительности и регулярные падения. Одновременно выяснилось, что нужные механизмы HITL и управления многошаговыми процессами не получаются простым включением пары настроек.
Каждую отдельную проблему ещё можно было исправлять. Но постепенно стоимость изменений начала определяться не только тем, что нужно реализовать, но и тем, как это встроить в уже существующую модель исполнения.
Это довольно неприятный момент в разработке. Ты смотришь на очередную задачу и понимаешь: технически она решаема. Вопрос в том, сколько новых исключений, обходных путей и особых случаев придётся добавить, чтобы она не развалила то, что уже работает.
И тут есть соблазн продолжать. Вложено пять месяцев. Уже столько кода написано. Вот ещё немного — и всё обязательно сложится.
Но вложенное время не является архитектурным аргументом.
Я решил остановиться и вынести в отдельную систему то, что считал фундаментальными требованиями: длительное исполнение, наблюдаемость, контроль, человеческие решения и эволюцию опыта.
Так появился Temporality.
Не «форк, в котором я наконец всё поправил», а попытка построить контур управления, в котором эти вещи являются частью системы, а не надстройкой над агентным циклом.
5. Temporality: исполнение, наблюдение, контроль, обучение
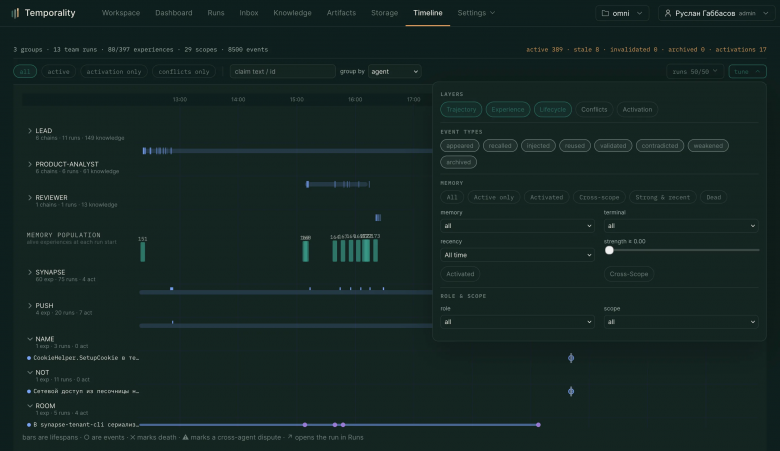
У Temporality четыре взаимосвязанных слоя.
Исполнение. Долгоживущие задачи, делегирование, планы и паузы на ожидание человека. Для этого используется Temporal. Перезапуск процесса или деплой не должны сами по себе уничтожать состояние работы.
Наблюдение. Событийная история выполнения: вызовы модели, действия инструментов, переходы состояний, решения людей. Нужно не просто узнать, что задача завершилась ошибкой, а восстановить, что произошло и почему.
Контроль. Политики, права, подтверждения значимых действий, управление доступом и ограничения исполнения. Агент не должен получать полномочия только потому, что модель сочла их полезными.
Обучение. Система должна извлекать из выполненных задач опыт, проверять его, учитывать результаты применения и переставать использовать то, что оказалось неверным или устарело.
Это не четыре независимые галочки в презентации. Они нужны друг другу.
Без наблюдаемости сложно понять, почему агент ошибся. Без контроля опасно позволять ему менять собственное поведение. Без исполнения нельзя надёжно проводить длительные процессы с человеческими паузами. А без механизма эволюции каждая новая задача снова начинается почти с нуля — или с багажом случайных заметок, которые никто не проверял.
6. Память агента — это не папка с мудрыми цитатами
Мне кажется, в обсуждении агентных систем слово «память» слишком часто означает: записали что‑нибудь в файл, потом добавили этот файл в промпт.
Для коротких задач такой подход может быть вполне достаточен. Для долгоживущей разработки с несколькими агентами он быстро начинает создавать проблемы.
Допустим, агент однажды нашёл обходной путь для ошибки. Это ещё не значит, что обходной путь универсален. Он мог сработать только на конкретной версии библиотеки, в определённом окружении или при случайном сочетании условий.
Если сохранить это как безусловную инструкцию, система не стала умнее. Она просто научилась воспроизводить старую случайность.
В Temporality я разделяю историю выполнения и знания, которые из неё извлекаются.
Журнал событий хранит то, что произошло. Знания — это уже проекция опыта, пригодная для повторного использования. Подсказки для агента — компактное представление релевантного опыта, а не выгрузка всей памяти в контекст.
У такого знания должен быть жизненный цикл. Оно может быть предложено, подтверждено, оспорено, исправлено, заменено другим или признано недействительным.
Это важно не ради красивой диаграммы. Если выяснилось, что правило больше не работает, его недостаточно перестать рекомендовать. Нужно понимать, откуда оно появилось, где применялось и какие выводы могли зависеть от него.
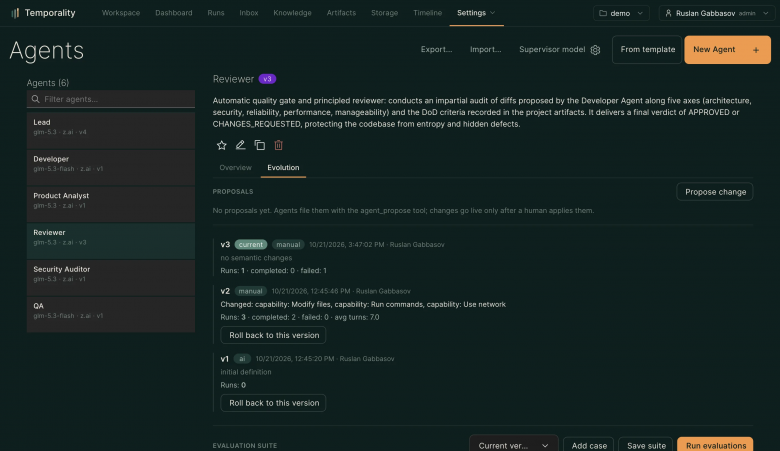
Система не должна путать три утверждения:
«Агент это сделал».
«Результат оказался полезным».
«Мы подтвердили, что этот способ стоит использовать снова».
Это три разных события. Между ними и находится работа по накоплению опыта.
7. Навык должен иметь контракт, а не только хорошее название
Похожая история с навыками.
Навык — это не просто текстовый файл, который объясняет агенту, как правильно себя вести. Для повторно используемой процедуры нужны входные условия, ожидаемый результат и критерии качества.
Если навык умеет менять код, то полезно знать не только то, что он завершил работу, но и какие проверки обязан пройти результат. Если навык собирает требования, должны существовать критерии полноты и способы проверить, что источники не потерялись. Если он проводит ревью, нужно зафиксировать, что именно считается найденной проблемой.
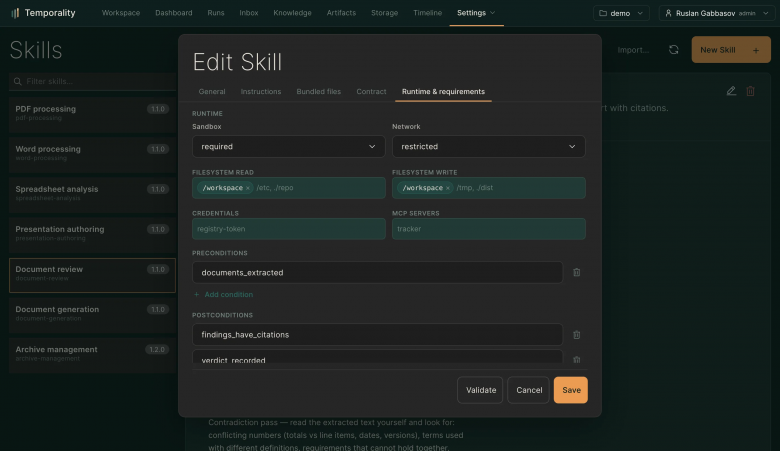
В таком подходе навык становится исполняемым контрактом между задачей и результатом.
А дальше появляется ещё один вопрос: что произойдёт, если агент предложит улучшить сам навык?
Можно, конечно, применить новый текст и надеяться на лучшее. Надежда — ресурс недорогой, но плохо масштабируется.
Поэтому изменение должно проходить через оценочный контур: набор контрольных сценариев, проверку новой версии и понятный результат. Если проверка завершилась ошибкой, это не успех. Если оценочный механизм сам деградировал, он не должен выдавать зелёный свет только потому, что не смог найти проблему.
В текущем контуре качества Temporality есть оценочные наборы, привязка прогонов к версиям определения, human‑in‑the‑loop сигналы, сбор кандидатов в контрольные кейсы и гейт применения изменений. Для LLM‑судьи предусмотрена калибровка по историческим решениям; при недостаточном согласии его результат считается деградировавшим и не проходит гейт.
Это не означает, что теперь качество можно полностью автоматизировать. Это означает, что изменения перестают приниматься исключительно на основании того, что они выглядят убедительно.
8. Agent‑SRE: следить не только за ответом, но и за траекторией
Когда агент работает долго, финальный ответ — очень неполное описание результата.
Он мог потратить бюджет на бессмысленные повторные попытки, вызвать не тот инструмент, неверно делегировать задачу, проигнорировать отказ, получить некорректный результат от подагента, а потом каким‑то чудом выдать правильный текст.
С другой стороны, агент мог пройти почти весь процесс корректно, но получить ошибку от внешней системы. По одному финальному статусу эти случаи не различить.
Поэтому в Agent‑SRE‑подходе меня интересует не только корректность конечного ответа, но и здоровье траектории выполнения.
Сколько было повторных попыток? Где возникли задержки? Не растёт ли расход ресурсов от версии к версии? Не передаёт ли родитель подагентам слишком много контекста? Какие ошибки повторяются? Какие решения людей систематически исправляют результаты агента?
Здесь важно не спутать наблюдаемость с набором красивых графиков. Смысл не в том, чтобы нарисовать ещё один dashboard с зелёными кружочками. Смысл в том, чтобы получить данные, на основании которых можно менять систему и проверять последствия этих изменений.
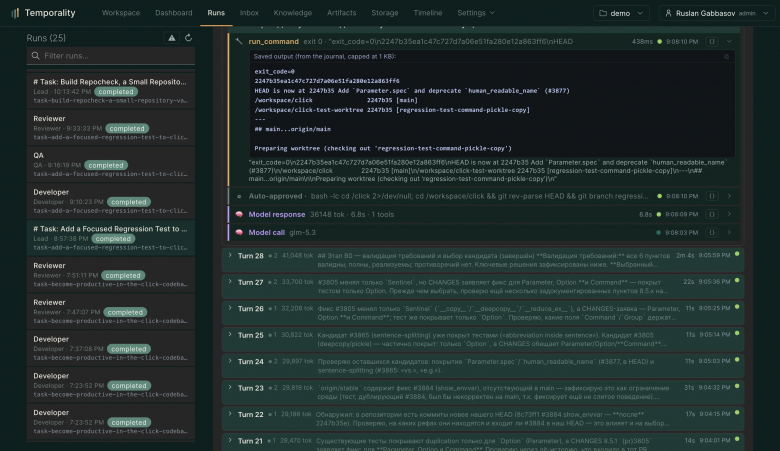
Именно поэтому мне важны история событий, связь с исходной задачей и возможность восстановить последовательность действий. Иначе после очередного инцидента мы будем обсуждать не то, что случилось, а то, что модель, вероятно, имела в виду.
Слово «вероятно» в расследовании инцидентов обычно означает, что доказательств у нас маловато.
9. А что с безопасностью?
Корпоративная среда не может исходить из предположения, что агент всегда будет вести себя благоразумно. Даже если он не злонамеренный, он может неверно интерпретировать задачу, выполнить лишнюю команду или использовать инструмент не по назначению. Недавно была комичная ситуация, когда я скинул агенту шифрованный архив, а он, вместо того чтобы спросить у меня пароль, написал утилиту для взлома архива и начал плавить мне ноутбук. Намерения у агента могут быть вполне благие, а вот способы решения довольно безрассудные.
В Temporality для выполнения команд используется Docker‑песочница с ограничениями. По умолчанию сеть отключена; доступ к сети требует явного разрешения. Контейнер запускается с ограниченными привилегиями, корневая файловая система доступна только для чтения, рабочая область ограничена, ресурсы и время выполнения контролируются. Секреты хостового окружения не передаются в контейнер как обычные переменные среды.
Но тут есть важная оговорка. Песочница защищает от ошибок и несанкционированных действий агента в пределах заданной модели угроз. Она не превращает скомпрометированный Docker‑демон или ядро хоста в безопасную среду. Выдача доступа к сети также расширяет поверхность риска, а гранулярная фильтрация по доменам — отдельная задача, которую нельзя считать решённой одной галочкой.
Я специально проговариваю эти ограничения, потому что фраза «у нас безопасные агенты» слишком часто означает «мы добавили --network=none и теперь надеемся на лучшее».
Контроль должен быть проверяемым, а границы доверия — документированными. Иначе это не безопасность, а настроение команды разработки.
10. Можно ли измерить реальную производительность?
Да, но измерения нужно читать правильно.
В репозитории есть воспроизводимый нагрузочный сценарий с детерминированным OpenAI‑совместимым мок‑провайдером. Тяжёлый профиль включает четыре модельных хода, два выполнения команд в песочнице, паузу HITL с имитацией ответа человека и финальный ответ.
Это полезная проверка поведения платформы под параллельной нагрузкой, а не доказательство, что любой реальный агент будет отвечать за 6 мс. Модель здесь замокана; её реальные задержки, лимиты провайдера и стоимость в эти цифры не входят.
Почему я вообще показываю эти числа? Потому что после истории с десятком пользователей мне хотелось не просто сказать «теперь всё будет хорошо», а иметь возможность проверять изменения измерениями. Тесты и скрипты для воспроизведения лежат в репозитории.
11. Что в итоге получилось
Temporality — это открытая self‑hosted среда исполнения и контур управления для агентных систем. Исходный код, документация и актуальный интерфейс доступны публично:
Репозиторий: https://github.com/RuslanGabbasov/temporality
Я не хочу утверждать, что решил все проблемы агентной разработки. Не решил. Некоторые сценарии ещё требуют развития, отдельные механизмы имеют ограничения, а наличие кода и тестов не заменяет независимого аудита и эксплуатации в разных условиях.
Но у проекта теперь другая исходная позиция.
Вместо того чтобы пытаться вписать корпоративный процесс в цикл «промпт → модель → инструмент → ответ», я строю систему, в которой длительное исполнение, человеческие решения, история событий, контроль полномочий и проверяемое накопление опыта являются частью архитектуры.
Для меня это и есть главный вывод пяти месяцев: сложность агентной системы определяется не тем, насколько умно она отвечает, а тем, насколько предсказуемо она работает, когда задача длинная, участников много, что‑то пошло не так и никто не собирается вручную восстанавливать процесс из переписки.
Open source по‑прежнему остаётся важной частью решения. Но наличие открытого кода не означает, что готова нужная тебе система. Иногда компоненты можно удачно объединить. Иногда оказывается, что архитектурные предпосылки не совпадают с задачей, а стоимость адаптации растёт быстрее, чем функциональность.
И иногда правильное решение — перестать чинить чужой велосипед, даже если ты уже поменял в нём почти все детали.
Комментарии (2)

Ka463
28.10.2026 19:09Описание интересное, но если посмотреть с другой стороны, в корпоративной среде часть того что описано вами, успешно решают системы документа оборота и ERP, без всяких моделей и агентов, это и точнее и быстрее, пихать модели в каждую дырку, не всегда оправдано.
Wesha
Контракт должен исполняться, а не просто «служить ориентиром, а там уж как пойдёт».