

Недавно нашей команде необходимо было ответить на вопрос: «Такое фото у нас уже есть?». Не просто «тот же файл» — его можно было бы легко проверить по SHA-256, — а именно идентичное изображение: пережатое, уменьшенное, с чужим логотипом поперёк кадра или подрезанное по краям.
Про перцептивные хеши на Хабре много материалов, и почти везде разбирают устройство алгоритмов. Мне же хотелось проверить, насколько они устойчивы к реальным изменениям. Для этого я взял 20 фотографий и изменил каждую 26 способами из тех, что реально случаются при перезаливе, и посчитал расстояния.
Это первая из двух частей. Здесь я расскажу, что умеют хеши и где ошибаются: влияние водяных знаков, геометрии кадра, выбор метода, длина хеша и порог. Во второй части — о том, как на основе этих данных построить работающую систему: предобработка, зеркало и поиск в PostgreSQL с бенчмарком на 10 млн записей.
Верлинский Максим
Бэкенд-разработчик в Домклик
Задача
У нас есть хранилище фотографий, и при каждой новой загрузке нужно проверить, не дублируется ли изображение. Одна и та же фотография может храниться в десятках вариантов: её пересылали через мессенджеры, где она ужалась до 1280 по длинной стороне, либо её сохранили из браузера в WebP, а потом переконвертировали обратно в JPEG. Её кто-то мог уменьшить для предпросмотра, а кто-то — увеличить обратно, наложить на неё логотип в углу или плашку с телефоном внизу, а также подрезать края на 10%, чтобы убрать чужой водяной знак.
Побайтово все эти файлы не совпадают ни в одном бите, так что криптографические хеши отвечают на другой вопрос.
Что про это уже писали на Хабре
Перед тем, как начать что-то изобретать, я изучил существующие материалы, так как тема была для меня новой:
«Выглядит похоже». Как работает перцептивный хэш (2011 г., перевод Нила Кравеца) — канонический разбор aHash и pHash по шагам (если хочется понять сам алгоритм, начинать надо отсюда)
Алгоритм быстрого нахождения похожих изображений (2011 г., автор AntiDupl) — вообще без хешей, среднеквадратичная разность на кадрах 32×32 плюс многомерная индексация по яркости и по половинкам кадра
Как бороться с репостами или пара слов о перцептивных хешах (2014 г.) — обзор четырёх алгоритмов, включая Radial Variance и Marr-Hildreth, которых в популярных библиотеках обычно нет
Поиск кропнутых дубликатов изображений с помощью перцептуальных хешей (2013 г.) — методы работы с обрезанными фото: SURF-точки, кластеризация и около 200 хешей на одно изображение
Найти за полсекунды: сравниваем похожие фотографии (2022 г., Badoo) — та же задача на 150 млн изображений (ключевые точки AKAZE, бинарные дескрипторы и префиксное дерево вместо B-дерева)
Все эти статьи рассказывают о том, как устроен алгоритм. Но с проверкой утверждений дела обстоят хуже: «устойчив к сжатию», «переживает водяные знаки и обрезанные края», «порог 0,2» — цифры кочуют из статьи в статью, при этом их происхождение обычно не объясняется.
Чем вообще можно сравнивать
Криптографические хеши, такие как SHA-256 и MD5, ловят идентичные файлы только побайтово. Их стоит использовать как первый этап — они вычисляются почти бесплатно, а точные дубли в потоке могут быть. На этом их полезность заканчивается.
Перцептивные хеши — aHash, dHash, pHash и wHash — создают «отпечаток» внешнего вида изображения в виде последовательности битов (чаще всего 64 бита). Похожесть измеряется расстоянием Хэмминга, то есть количеством отличающихся битов. Эти методы дёшевы в вычислении, хранении и поиске. Именно о них пойдёт речь в обеих частях моей статьи.
Далее идут нейросетевые эмбеддинги и локальные признаки вроде SURF и AKAZE. Они устойчивы к кадрированию и способны выявлять смысловое сходство, но требуют значительных ресурсов: инференса, векторов с сотнями чисел и отдельной подсистемы поиска ближайших соседей. Где именно начинается их область, станет понятно в конце второй части.
Я остановился на перцептивных хешах: по времени они с большим запасом укладывались в наши требования, а инфраструктура сводится к одной колонке в таблице.
Как из фотографии получаются 64 бита
Разберём на примере pHash — самого популярного метода. Подробное описание шагов есть в той самой статье 2011 г., здесь кратко, чтобы было понятно, откуда взялись числа.
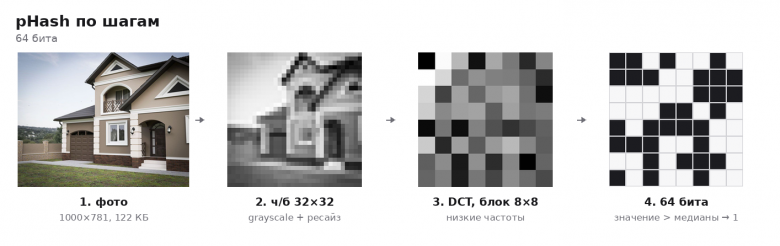
Уменьшаем изображение до 32×32 и переводим в градации серого. Цвет и мелкие детали на этом этапе отбрасываются
Считаем DCT — дискретное косинусное преобразование, которое используется внутри JPEG
Берём левый верхний блок размером 8×8 — низкие частоты, «скелет» кадра: где светлее, где темнее, как распределены крупные массы
Сравниваем каждое значение с медианой: если больше — ставим 1, если меньше — 0. В итоге получаем 64 бита
Есть важный нюанс: в классическом описании на четвёртом шаге сравнивают со средним значением (без учёта первого коэффициента), а в библиотеке imagehash, которую мы используем, — с медианой. Хеши получаются разные, и сравнивать таблицы из разных источников бессмысленно, пока не выяснишь, что там считали. На практике же всё сводится к одной строке:
import imagehash
from PIL import Image

a = imagehash.phash(Image.open("original.jpg"))   # 64 бита
b = imagehash.phash(Image.open("reupload.jpg"))

print(a - b)              # расстояние Хэмминга, 0..64
print(int(str(a), 16))    # то же значение числом — его и кладём в базу
Остальные три метода — вариации на ту же тему:
Метод |
Что делает |
Чем платит |
|---|---|---|
aHash |
Сравнивает каждый пиксель со средней яркостью |
Самый грубый, много ложных срабатываний |
dHash |
Сравнивает соседние пиксели по горизонтали |
Более устойчив к яркости, чем aHash |
pHash |
Применяет DCT, сравнивает низкие частоты с медианой |
Чуть дороже, но лучший запас до ложных срабатываний |
wHash |
То же на вейвлетах |
Работает более чем в 6 раз медленнее остальных |
На четвёртом шаге от исходного изображения остаётся уже очень мало. Фактически, хеш видит крупную структуру кадра, а не детали.
Датасет: 20 фотографий, 26 вариантов изменений
Я взял 20 снимков в форматах JPG, PNG, WebP с разными размерами и для каждого сгенерировал 26 модификаций. В итоге получилось 520 пар «дубликатов» и 10,26 тыс. пар «разных фотографий». Модификации не придумывал — брал то, что обычно происходит при перезаливе:
Перезалив (13 вариантов): ресайз ×0.5 и ×2, JPEG q80/q50/q20, WebP q75, пересылка через мессенджер (1280 пикселей и q62), скриншот экрана (ресайз, шарп, q88), чёрно-белый, яркость ±25%, контраст ±30%
Водяные знаки (пять вариантов): логотип в углу, непрозрачная плашка с телефоном внизу, крупная полупрозрачная надпись по диагонали, плитка из надписей по всему кадру, большой логотип в центре
Мелкие правки (восемь вариантов): обрезка 5, 10 и 20%, белая рамка 6%, добавление полей до квадрата, наклон на 1 и 3°, зеркальное отражение
В качестве порога для начала взял классическое значение — 12 бит из 64, что соответствует уровню похожести около 80%. Из метрик смотрим recall (доля найденных копий) и precision (доля действительно найденных копий).
Водяные знаки не влияют на хеш
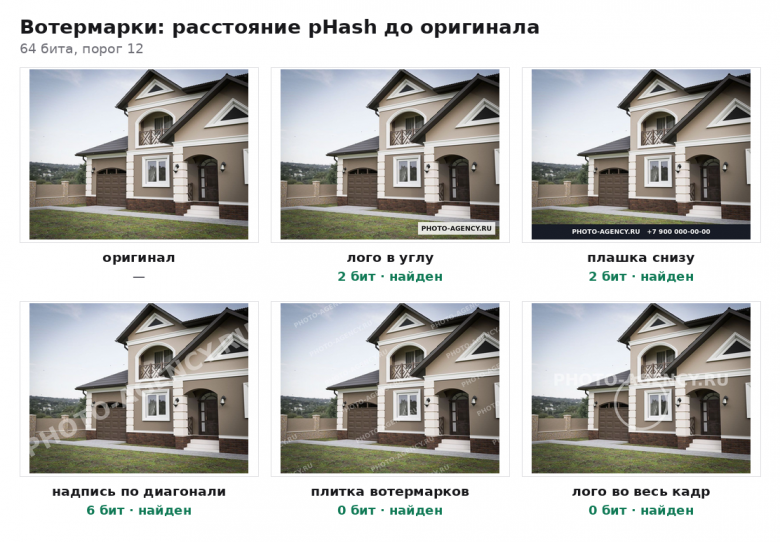
На изображении показаны пять вариантов водяных знаков — от скромного логотипа до плитки, покрывающей весь кадр. Медиана расстояния pHash варьируется от 0 до 6 бит при пороге 12, а recall по всей группе для pHash и dHash достигает 100%. Это объясняется принципом работы DCT-хеша: он анализирует крупные области яркости, и полупрозрачная надпись практически не влияет на распределение света. Даже плитка из логотипов, покрывающая весь кадр, даёт медиану 0 бит — она равномерно осветляет изображение, не меняя относительное распределение яркости.
Заметное влияние оказывает только непрозрачная плашка внизу, занимающая около 9% высоты кадра, — медиана здесь достигает 6 бит, максимум — 12. Это связано с тем, что она закрывает девятую часть кадра. При этом aHash ошибается в 5% случаев, а wHash — в 20%.
Кроме того, можно поставить число под старое утверждение. В обзоре 2014 г. говорится, что перцептивные хеши способны находить дубликаты «даже при наличии водяных знаков или обрезанных краёв», а в статье 2011 г. отмечается, что pHash устойчив к изменениям до четверти площади изображения. Наши измерения показывают, что эти два случая ведут себя по-разному: поверх кадра можно наложить сколько угодно закрашенных областей, а вот обрезать края — почти нельзя. Следующая глава посвящена именно этому.
Зато геометрия убивает
Теперь рассмотрим те же 20 фотографий, но вместо изменения содержимого кадра затронем его границы.
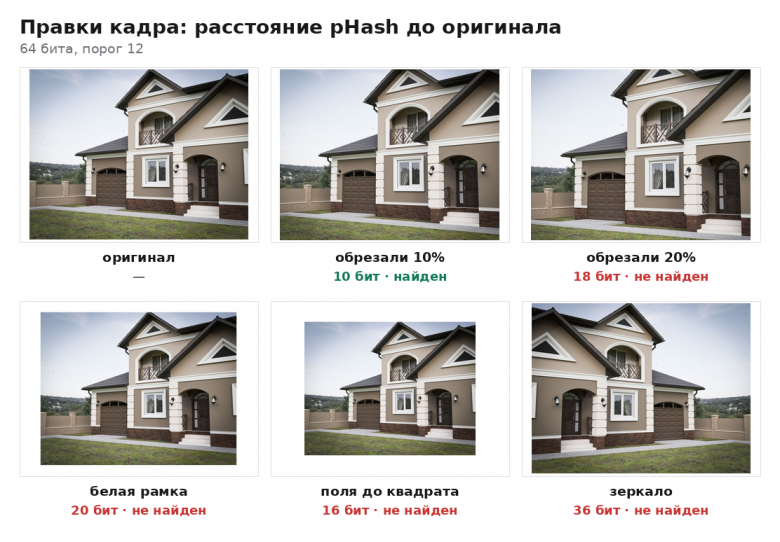
На изображении показаны 26 различных модификаций, отсортированных по степени сдвига хеша. Верхняя треть — это изменения, из-за которых копия теряется.
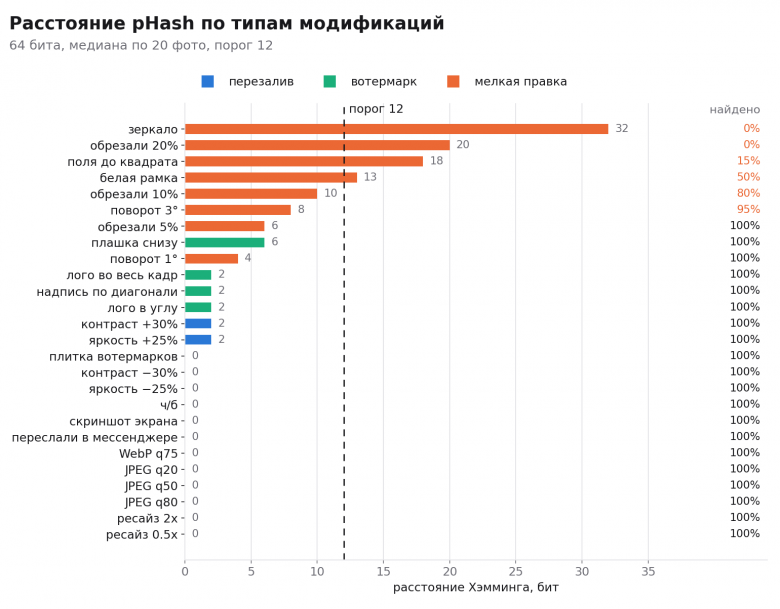
Что сделали |
Медиана, бит |
Найдено при пороге 12 |
|---|---|---|
Пережали, уменьшили, переслали, обесцветили |
0 |
100% |
Любой водяной знак |
0—6 |
100% |
Обрезали 5% |
6 |
100% |
Наклонили на 3° |
8 |
95% |
Обрезали 10% |
10 |
80% |
Белая рамка 6% |
13 |
50% |
Добавили поля до квадрата |
18 |
15% |
Обрезали 20% |
20 |
0% |
Зеркальное отражение |
32 |
0% |
Отдельно стоит рассказать про зеркальное отражение. Визуально это тот же самый снимок — человек едва заметит разницу. Однако хеш выдаёт 32 бита из 64 — столько же, сколько между двумя случайными картинками. Низкие частоты после отражения перекладываются зеркально, и совпадений уже не остаётся.
С белой рамкой ситуация проще: кто-то добавил 6% полей, чтобы фото аккуратно вписалось в вёрстку, в результате половина копий перестала обнаруживаться. Никто ничего не ломал намеренно — просто подогнали под макет.
Часть таких проблем можно исправить — об этом расскажу во второй части.
Какой метод брать
Обычно методы сравнивают по скорости и устойчивости к пережатию. На наших данных эти параметры оказались несущественными: при пережатии, изменении размера и смене формата все четыре метода дают 0—2 бита, разницы практически нет. Главное отличие — насколько далеко держатся чужие фотографии:
Метод |
мс/хеш |
Минимальное расстояние до чужого фото |
Precision @12 |
Recall @12 |
|---|---|---|---|---|
aHash |
13,0 |
9 |
0,902 |
0,885 |
dHash |
12,2 |
12 |
0,998 |
0,856 |
pHash |
15,5 |
18 |
1,000 |
0,862 |
wHash |
100,3 |
12 |
0,987 |
0,875 |
У aHash минимальное расстояние между двумя разными фотографиями всего 9 бит — меньше рабочего порога. При пороге 12 это приводит к ложным дубликатам: каждая десятая найденная копия оказывается ошибочной.
Возьмём эту пару фотографий.
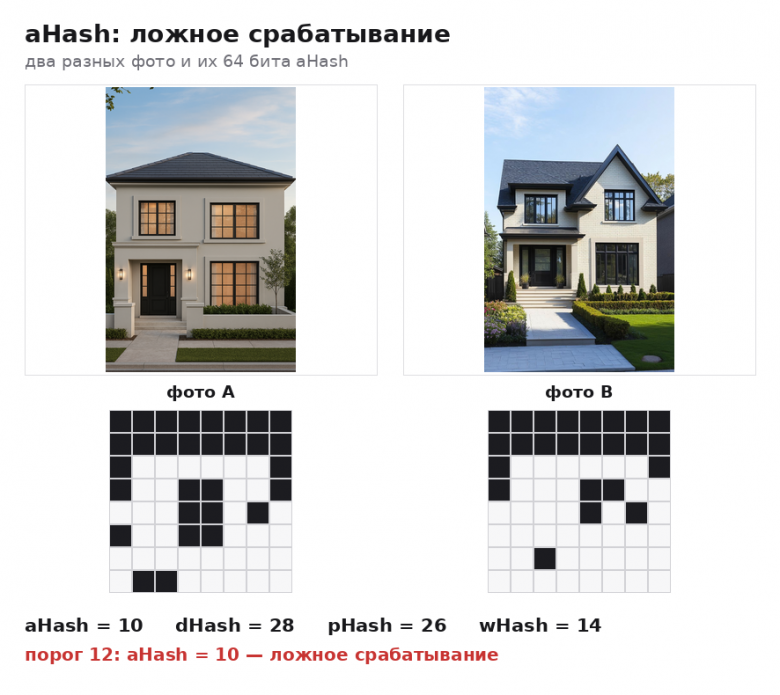
Внизу показано, как эти дома выглядят в 64 битах aHash. Два светлых фасада на светлом фоне, карты бит расходятся в десяти клетках из 64. pHash в этой же паре показывает 26 бит, поскольку анализирует частоты, а не просто сравнивает яркость относительно среднего значения.
Автор статьи про кропнутые дубликаты ещё в 2013 г. кратко охарактеризовал aHash как «неработоспособный, с множеством ложных срабатываний». Сейчас за этим утверждением стоят конкретные цифры — precision 0,902 и зазор в 9 бит.
Поэтому я выбрал pHash. Он обнаруживает копии примерно так же, как и другие методы, но при этом обеспечивает наибольший зазор между похожими и чужими фотографиями, что снижает количество ложноположительных срабатываний. При этом wHash работает в 6 раз медленнее остальных и не даёт заметных преимуществ.
Длина хеша
Выбираем длину хеша. Провели тестирование pHash на пяти длинах.
Бит |
Минимальное расстояние до чужого фото |
Порог 0,2 |
Recall / Precision |
Безопасный порог |
Recall |
|---|---|---|---|---|---|
16 |
0 |
3 |
0,881 / 0,740 |
Отсутствует |
— |
36 |
6 |
7 |
0,885 / 0,998 |
5 (0,14) |
0,829 |
64 |
18 |
12 |
0,862 / 1,000 |
17 (0,27) |
0,898 |
144 |
50 |
27 |
0,808 / 1,000 |
49 (0,34) |
0,896 |
256 |
100 |
48 |
0,790 / 1,000 |
99 (0,39) |
0,894 |
Колонка «Безопасный порог» показывает максимальное расстояние, при котором на нашем наборе данных не было ни одного ложного срабатывания. Это наиболее информативная метрика для сравнения разных длин — она отражает, сколько копий метод сможет обнаружить до появления ложных срабатываний.
16 бит — слишком мало. Минимальное расстояние между разными фотографиями равно нулю: найдена пара снимков с полностью совпадающими 16-битными хешами. Безопасного порога здесь нет вообще, а при пропорциональном пороге каждое четвёртое срабатывание оказывается ложным. Если коллизии возникают уже на 20 фотографиях, то для базы в сотни тысяч записей 16 бит использовать нельзя.
Больше 64 бит ничего не добавляет. При безопасном пороге 144 и 256 бит вытаскивают примерно столько же копий (около 89%), сколько и 64-битный. При этом время вычисления практически не меняется — основное время уходит не на DCT, а на декодирование и изменение размера изображения. Зато в базе вместо одного bigint придётся хранить два или четыре, и это усложняет поиск.
Выяснилось, что привычный порог 0,2 нельзя просто перенести на хеш другой длины. Безопасный порог в долях от длины хеша растёт с увеличением длины: 0,14 для 36 бит, 0,27 для 64, 0,39 для 256. Если взять 256 бит и применить к ним привычный порог 0,2, recall упадёт до 79% вместо 89%, и вы решите, что длинный хеш хуже ловит. Но это не совсем так: он не хуже, просто у него другой масштаб расстояний, а рекомендацию к нему скопировали от другого размера.
Где ставить порог
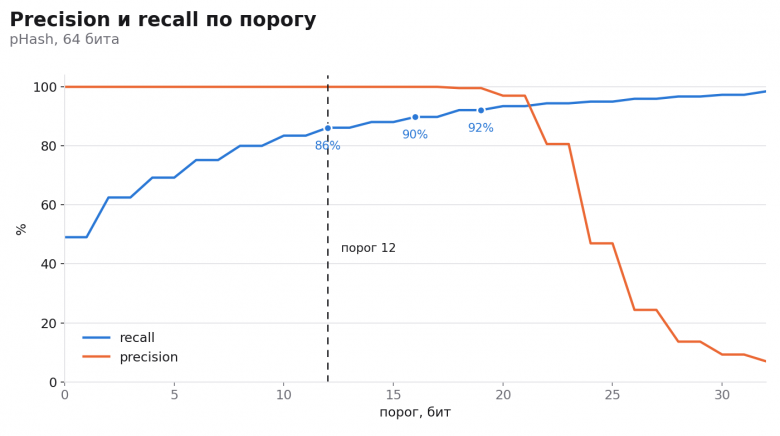
Классические 12 бит — не единственный разумный вариант. В нашем наборе минимальное расстояние между разными фотографиями у pHash составило 18 бит, то есть ложных срабатываний при пороге 17 включительно нет вообще. Значит, порог 12 оставляет неиспользованный запас в 6 бит. Если поднять порог до 16, мы получим recall 90% вместо 86% при той же precision 1,000. Лучший F1 достигается при пороге 19 бит.
Однако эти результаты справедливы только для нашего набора из 20 достаточно разных фотографий. Чем больше база и чем однообразнее снимки — например, когда все объекты сняты с одного ракурса на одинаковом фоне — чужие хеши будут располагаться ближе друг к другу. В таком случае порог придётся снижать. Поэтому порог нужно настраивать под конкретный набор данных, учитывая, что важнее: минимизировать ложноположительные или ложноотрицательные срабатывания.
Что дальше
Итог первой части: pHash, 64 бита, порог 12—16, recall 86% при precision 100%. Перезаливы и водяные знаки ловятся полностью, а вот изменения геометрии кадра приводят к потере совпадений.
Во второй части я расскажу, как повысить эти 86% до 95% с помощью двух функций по десять строк, почему автообрезка полей однажды съела пятую часть фотографии, где заканчиваются хеши и начинаются ключевые точки, а также как всё это хранится и ищется в PostgreSQL: bigint, bit_count, GIN по блокам и бенчмарк на 100 тыс., 1 млн и 10 млн записей.