Листая одну старую книжку по древнему языку программирования Форт [1], я наткнулся на такой фрагмент, в котором меня заинтересовало слово LAST1:
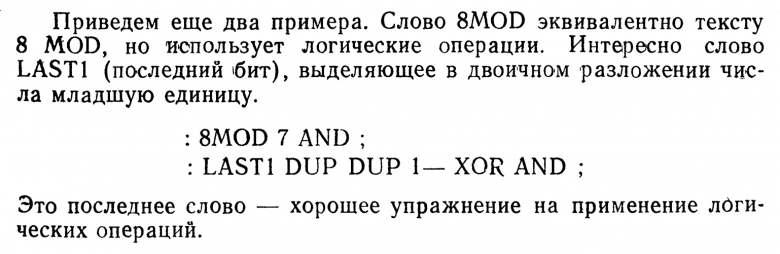
Ну и в соответствии с философией Forth — отсекай всё лишнее, делай систему настолько простой, чтобы ты мог понять её до последнего транзистора и бита, я решил разобраться и сам, и поделиться своим разбором с вами.
КМБ‑Forth, который «деды» могут пропустить
Если вы не имели дел с языком программирования Forth, то я для вас поясню, что значит
: LAST1 DUP DUP 1- XOR AND ;
Вся эта вышеприведённая строка — одно «слово». А «словом» в Форте называется что‑то вроде вызываемой функции или подпрограммы. Начинается определение «слова» с двоеточия, а заканчивается точкой с запятой. Первый после двоеточия элемент — «имя функции/подпрограммы» (в нашем случае это
LAST1). Хотя в Форте такое «имя» как раз и принято называть «словом».Все элементы языка должны быть отделены друг от друга пробелами.
Слово (операция)
DUPдублирует самый верхний элемент стека. В нашем случае — число. Две операцииDUPобеспечивают целых три копии исходного числа, лежащих на стеке (зачем нам три копии одного и того же числа — расскажу далее).Слово «
1-» — быстрый вариант вычитания единицы. Почти как «--» в Си. Здесь нам нужно лишь понимать, что для своей работы (вычитания единицы) слово «1-» берёт из стекапервое попавшеесясамое верхнее число, а потом кладёт туда же, на верхушку стека, результат.XORиAND— одноимённые логические операции. И они для своей работы берут числа из стека. И они нахлобучивают результаты своей жизнедеятельности на его макушку.Вообще, все промежуточные результаты сохраняются в стеке. Через него же передаются и все параметры «функций» («слов»).
Как видите, всё просто.
Погнали разбираться!
Итак, представьте, что у нас есть число (допустим, 12), которое, конечно же, можно записать в двоичной системе счисления при помощи нулей и единиц:
1 1 0 0
Наша задача — найти в нём самую правую единичку и оставить только её, а всё остальное стереть («обнулить»). «Всё остальное», это, конечно же, только левая (старшая) часть числа. Правая и так заполнена нулями до самой искомой единицы. Тут уже, как говорится, «лишь бы не испортить».
В нашем числе 12 самая правая единичка — третья слева (или вторая справа). В десятичной системе счисления «вес» её разряда равен четырём (4), поэтому и ожидаемый ответ должен быть равен 4 (в двоичном виде это 0 1 0 0).
Зачем это вообще нужно? (Практический смысл)
В программировании это очень полезный трюк. Вот пара причин, для чего это может понадобиться:
1. Быстрый подсчет единиц (алгоритм Брайана Кернигана): Если вам нужно посчитать, сколько единиц в числе (в нашем примере их две), вы можете в цикле находить крайнюю правую единицу, а потом вычитать получившееся число из исходного:
1.1. 12 — 4 = 8 (в двоичном представлении 1 0 0 0).\
1.2. Находим крайнюю правую единицу у восьми (8), получаем 8.
Вычитаем: 8 — 8 = 0. Цикл можно заканчивать. В цикле мы «крутились» 2 раза — значит, в числе 12 — две единицы. Обычно данный метод работает быстрее, нежели проверка каждого бита по очереди.
2. Работа с битовыми масками (например, дерево Фенвика): В сложных алгоритмах (например, в структурах данных для быстрого поиска сумм) нужно знать, какой длины «блок» данных соответствует текущему числу. «Поиск крайней единицы» мгновенно дает эту информацию, потому что в двоичном дереве вес младшего бита равен размеру блока. Позиция самой правой единицы в индексе строго определяет шаг алгоритма: её десятичное значение (например, 4 для 0100 или 2 для 0110) в точности совпадает с количеством элементов, за которые отвечает текущая ячейка. Битовая операция X & ‑X изолирует этот бит буквально за один такт процессора, позволяя мгновенно определять границы блоков без циклов и лишней памяти.
Итак, чтобы найти крайнюю справа единицу, нужно выполнить три шага.
Шаг 1. Ищем богатого спонсора, или Поиск первой значимой единицы при помощи вычитания
Итак, вычитание единицы, это как будто бы поиск самой первой единицы справа.
Но с какого перепугу?!
Смотрите. Нам нужно как‑то «пометить» место, где находится наша искомая единичка. Но как это сделать? Как процессору объяснить, что нам нужно? Для его электронных схем, откровенно говоря, особой разницы нет — единица в ячейке памяти, или ноль. Ячейка памяти ведь физически не меняется. В ней лишь может храниться электрический заряд, а может и не храниться. Ну или её простая транзисторная схема может находиться в одном из двух стабильных состояний. Но ни одно из них не лучше и не хуже другого. Это мы, люди, наделяем эти состояния нужным нам смыслом.
Так вот, отыскать первое вхождение единицы мы можем с помощью банальной арифметики — вычитанием самого маленького значимого числа из исходного числа. Если хорошенько подумать и вспомнить правила вычитания, то вы поймёте, что по сути, эта операция — не что иное, как способ пройтись по уменьшаемому справа налево, дойти до первой встречной единицы и оставить после себя определённый (а точнее, инверсионный) след. Система счисления при этом, не имеет никакого значения. И кстати, этот след мы потом превратим в шаблон‑маску, но не будем забегать вперёд и пока просто посмотрим, как работает этот своеобразный «битовый поиск»:
Возьмём наше число 12 (1 1 0 0), вычтем из него 1 и получим 11 (1 0 1 1). Нули справа стали единицами, а та самая, первая с правого края единица стала нулём. Как мы дошли до жизни такой?
Да также, как и всегда (ну, то есть, в других системах счисления). Представьте, что мы идём по исходному числу 12 (1 1 0 0) справа налево и упорно пытаемся вычесть одну единственную единичку — самое маленькое из значимых чисел:
Сначала мы стучимся в самую маленькую дверцу крайнего правого и самого младшего из разрядов искомого числа, и говорим ему: «А займи‑ка нам, братец, одну ма‑а‑ленькую единичку?» — а он говорит: «Я бы и рад, да пуст совсем!».
Тогда мы идём дальше влево, ко второму более весомому разряду, стучимся в его дверцу размером побольше и тоже спрашиваем: «А не займёшь ли ты нам, братец, одну самую малую единичку?» А он отвечает: «Я бы и рад, так ведь и у меня пусто!».
Тогда мы идём к ещё более могучему третьему разряду, стучим в его массивную дверь и тоже просим: «Братец, займи единичку! Вижу, она есть у тебя!» И третий разряд охотно отвечает: «Да бери конечно! Правда, эта единичка — это всё, что у меня есть. Но зато смотри какая она весомая и жирная!.. И тебе хватит, и всем нашим братьям помладше!».
И вот тут и происходит самое интересное: единица из третьего разряда — такая большая и весомая, что её хватает и «попрошайке‑вычитаемому», и двум младшим разрядам, благодаря чему те самые два крайних правых нуля наполняются единицами. Однако сам третий разряд, растративший свою единицу на остальных, остался ни с чем. То есть, совсем потерял свой вес и стал нулём.
Вот так это выглядит схематично: 12: (1 1 0 0) —1→ (1 0 1 1):11
А вот самый старший четвёртый разряд остался со своей единицей — что называется, «при своих». До него попрошайка‑вычитаемое просто не дошёл. И это тоже очень важный элемент понимания принципа работы «поиска первой значимой единицы вычитанием».
Вот как образовался инверсионный след: Всё, что было правее искомой единицы, и она сама, изменило свои значения на противоположные. А левее искомой единицы — ничего не изменилось.
Простыми словами я бы смысл всей вышеназванной операции описал так:
вычитание единицы из искомого числа находит первый встречный ненулевой разряд и «успокаивается». Образовавшееся при этом число представляет из себя некий гибрид из инвертированной левой и неизменной правой частей.
Шаг 2. Позиционное разделение исходного числа
На этом этапе мы будем использовать логическую операцию XOR (исключающее ИЛИ), которую можно охарактеризовать как «детектор изменений».
Правило у неё очень простое: ставить единицу там, где биты разные, и ноль — где одинаковые
«Было» |
«Стало» |
Результат XOR |
|---|---|---|
0 |
0 |
0 (нет изменений) |
0 |
1 |
1 (есть изменения) |
1 |
0 |
1 (есть изменения) |
1 |
1 |
0 (нет изменений) |
Мы же будем использовать XOR‑логику в качестве позиционного разделителя исходного числа, потому что помимо этого самого числа, предусмотрительно продублированного и лежащего до поры до времени в стеке, у нас есть и «волшебное гибридное число», содержащее как не изменённую старшую часть, так и инвертированную (то есть, изменённую донельзя) — младшую. Благодаря этому числу, XOR пометит нулями всё, что было ДО искомой единицы, ибо будет сравнивать исходные разряды с теми, которые не изменялось вычитанием (левая часть числа), а позицию самой искомой единицы и всё что правее неё, XOR отметит единицами (то есть маскирует), потому что по этой части числа «прошлось» вычитание.
Где «отметит»?
В новом числе, называемом маскою.
Теперь давайте смотреть на работу XOR, что называется, «в прямом эфире»:
Двоичное |
Десятичное |
|
Исходное |
1 1 0 0 |
12 |
«Гибридное» |
1 0 1 1 |
11 |
Маска (XOR) |
0 1 1 1 |
7 |
Итог операции — маска, являющаяся картой изменённых разрядов.
Ноль слева — «здесь мы ничего не трогали».
Единицы справа и в позиции искомого разряда с единицей — здесь «наследило вычитание».
Маска как будто бы провела линию ровно по нашей искомой единичке: всё, что левее, закрыто нулями, всё, что на ней и правее — открыто единицами.
Шаг 3. «Выдавливаем» искомый разряд
К настоящему моменту на дне стека у нас самое‑самое первое и самое‑самое оригинальное (а не какие‑то там «дубликаты») искомое число, а поверх него, на вершине — «хитрая» маска‑разделитель, на конструирование которой и были потрачены все дубликаты исходного числа. И чтобы понять, что и как нам теперь с этими двумя числами делать, давай посмотрим на них:
Двоичное |
Десятичное |
|
Маска |
0 1 1 1 |
7 |
Исходное число |
1 1 0 0 |
12 |
Ну вот! Теперь же всё очевидно! Задача нашей маски — пропустить всю младшую часть исходного числа строго по «линии» искомого разряда (первого справа, содержащего значимую единицу) и не пропустить ничего левее искомого разряда. И, как мы видим, маска прекрасно справится с этой задачей: справа можно всё пропускать, потому что там сплошные нули до самого искомого разряда, включая его. А для правой части уже в разрядах самой маски «блокирующие нули».
Всё чего нам не хватает, это подходящей логической операции. Очень строгой — которая бы отсеивала любое несовпадение в параллельных разрядах, а также ноль в разряде. Логическая операция, которая воспринимала бы только две единицы в обоих сравниваемых разрядах!
И такая логическая операция есть у нас. Имя ей — AND.
AND выдаёт единицу только тогда, когда в одних и тех же разрядах И исходного числа, И маски, стоят единицы. Во всех остальных случаях AND будет выдавать ноль.
Вот её таблица истинности:
Бит числа |
Бит маски |
Результат AND |
|---|---|---|
0 |
0 |
0 |
0 |
1 |
0 |
1 |
0 |
0 |
1 |
1 |
1 |
Теперь схема работы AND над исходным числом и маской:
Двоичное |
Десятичное |
|
Исходное число |
1 1 0 0 |
12 |
Маска |
0 1 1 1 |
7 |
Результат |
0 1 0 0 |
4 |
Как видите, логика работы AND проста и незамысловата: используя нули маски, AND обнуляет старшую часть числа — перед искомой единицей. Потому что она нам не нужна. При помощи «младших единиц» маски она «выдавливает» из всей правой части числа искомую единицу. Тут уже нули правой‑младшей части числа как будто бы работают на нас, не позволяя единицам маски «пролезть» в итоговый результат. Вот и получается, что единственный, кто может пройти через строгое сито логической‑И, это искомая единица.
Впрочем, я, кажется, уже повторяюсь.
Итак, мы получили число, содержащее исключительно одну единственную единицу, в самом первом по счёту справа разряде: 0 1 0 0 (4), а большего нам и не нужно.
Коротко, в три строчки
Вычитание единицы, чтобы найти самый первый разряд, содержащий единицу и пометить путь к этому разряду.
XOR, чтобы сравнить «было» и «стало», и нарисовать карту изменений: «нули» — там, где ничего не трогали (левее единицы), «единицы» — там, где трогали (крайняя правая единица и правее неё. И всё это, чтобы превратить след от вычитания (он же — путь к искомой единице) в маску‑разделитель.AND— накладывает карту изменений (маску) на исходное число и оставляет только ту единственную единицу, которая совпала с «открытой» зоной — для того чтобы вырезать из числа ровно то, что мы искали — самую первую с правой стороны числа единицу.
Вот так, тремя простыми шагами, слово LAST1 находит самую правую единичку в любом числе.
В качестве домашнего задания
Напишите более оптимальную версию слова LAST1 для Forth‑системы, в которой есть слово NEGATE, меняющее знак числа на противоположный. Подсказку о том, как можно было бы это сделать, внимательный читатель найдёт в тексте данной главы.
Вместо ЗАКЛЮЧЕНИЯ, или Отложенное ВВЕДЕНИЕ
Зачем Forth и кому он нынче сдался?
Мне почему‑то кажется, что если спросить современного разработчика о Форте, то в лучшем случае мы услышим от него, что мол, был такой древний язык программирования (ЯП), на котором когда‑то программировали компьютеры обсерваторий, но теперь это один из забытых и мёртвых ЯП. Действительно, Чак Мур создавал Форт, в том числе, и для управления телескопами, но область применения придуманного им языка быстро вышла далеко за рамки астрономии. Довольно часто автономные системы управления советских атомных ледоколов, бортовые компьютеры космических аппаратов (вроде зонда Rosetta) и глубоководных исследовательских станций, годами работали на Форте. В условиях, где отказ цифровой автоматики означал катастрофу, Форт ценили за предельную надёжность и компактность: его «компилирующий интерпретатор» можно было разместить в нескольких килобайтах памяти, и он не зависал.
Не потому что был каким‑то особенным, а потому что был просто и однозначно задуман. А ещё — потому что позволял писать и отлаживать ПО прямо на том же железе, на котором ему потом было суждено работать десятилетиями.
А ещё, потому что именно с Forth возможен голливудский сценарий, когда бородатый борт‑инженер влазит в ПО компьютера полуживой космической станции и перенаправляет информационные и энергетически потоки с уцелевших второстепенных систем на жизненно важные. А с прошивкой, скомпилированной и намертво защитой в память бортового компьютера в стенах лаборатории — нет.
В наши дни, когда гигабайты вполне годного кода генерятся нейросетями буквально за считанные минуты, использование труда программиста, да ещё и на Форт, может показаться лютым анахронизмом. Но только не в сфере критически важной инфраструктуры вроде ПО атомных станций или систем жизнеобеспечения. В этих сферах, слава Богу, слепо доверяться искусственному интеллекту пока никто не готов. Не мне вам рассказывать о том, как ИИ может галлюцинировать. Не мне вам рассказывать, сколько слоёв абстракции, виртуальных машин и чужих библиотек скрывает под собой код современных языков высокого уровня. В критически важных системах нужна абсолютная предсказуемость: программист должен точно знать, сколько тактов или микросекунд будет исполняться тот или иной фрагмент программы. Форт даёт этот контроль, поскольку он прозрачен чуть ли не до уровня транзисторов.
Сегодня Forth, как мне кажется, переживает определённый ренессанс, и связано это с лавинообразным распространением микроконтроллеров. На дешёвых чипах с жестко ограниченной памятью и скромными вычислительными ресурсами Форт способен в одиночку заменить и операционную систему, и среду выполнения, не погружая пользователя в пучину Ассемблера.
При этом он даёт разработчику уникальное преимущество — интерактивность. В отличие от классического цикла разработки на C (написал код — скомпилировал — прошил чип — проверил), Форт позволяет общаться с железом напрямую через терминал в реальном времени: вы можете прямо «на лету» протестировать работу конкретного датчика или изменить логику функции. И в отличие от операционных систем (даже реального времени) эта интерактивность почти ничего не стоит. По уровню удобства и интерактивности для современных микроконтроллеров Форт сравним с MicroPython, но при этом он работает в разы быстрее, обходится без тяжелой виртуальной машины и оставляет программисту полный контроль над аппаратной частью.
Ради чего было весь этот «огород городить»?
В современных высокоуровневых языках программирования вышеописанные фокусы на уровне отдельных битов требуются редко — компиляторы отлично справляются с этим сами. Более того, у некоторых CISC‑процессоров команда поиска крайней единицы реализована аппаратно.
Тем не менее, подобные низкоуровневые примеры полезны для понимания базовой архитектуры любых вычислительных систем. Они наглядно показывают, что логика работы процессора — это не абстракция, а физический процесс переноса разрядов, который подчиняется строгим математическим правилам. И понимание того, как именно вычитание единицы меняет структуру числа, что на практике делают две из трёх базовых логических операций, помогает лучше ориентироваться в том, как компьютер обрабатывает данные на самом деле.
Если у вас есть свои варианты оптимизации этой операции или интересные примеры использования подобных битовых масок в современных задачах, делитесь ими в комментариях. Я заранее благодарен всем за конструктивные комментарии.
Литература
1. Бураго А. Ю., Кириллин В. А., Романовский И. В. Форт — язык для микропроцессоров. Л.: Знание, 1989. 36 с.
Комментарии (21)

eugenk
06.11.2026 08:04Сам в своё время был фанатом форта. Увы, его беда что он абсолютно не защищен. В нём всё что есть, это ячейка памяти. Как на ассемблере. Что приводит к ошибкам, выявляемым только во время исполнения. Простейший пример - сложить два числа. Если одно из них целое другое с плавающей точкой, компилятор может и не догадаться, что целое нужно привести к формату с плавающей точкой и только потом складывать. Да, всё это можно предусмотреть в компиляторе. Но такой компилятор вряд ли уже поместится в нескольких килобайтах ROM. В нескольких килобайтах будет уже целевая программа, а не форт-система. Была у меня мысль прикрутить к нему статическую типизацию, но увы, руки так и не дошли.

Oangai
06.11.2026 08:04Форт со статической типизацией это постскрипт, и лучше бы его обратно развидеть.
Главная беда форта что он придумывался для очень маленьких систем определённой архитектуры - мир вырос и архитектура эта больше не используется, его модель системы теперь даже для микроконтроллеров не подходит. Но как разминка для мозгов вполне полезен.
eugenk
06.11.2026 08:04Про постскрипт честно говоря только слышал. Подробно что это такое не смотрел. Ну и есть несколько файлов в формате ps. Так что про типизацию в нём не знаю. Моя идея была сделать ОБЯЗАТЕЛЬНОЙ стековую диаграмму при определении каждого слова. Сейчас это просто необязательный (хотя и желательный) комментарий. Тогда компилятор на каждом шаге определения сможет отслеживать состояние стека, предотвращая ошибки типизации. Плюс появляются интересные плюшки. Например сложить любые два числа теперь можно одним единственным словом + , а нужный вариант (add, dadd, fadd и т.д.), компилятор найдёт сам. И можно реализовать поддержу на уровне IDE. Из недостатков - некоторые распространенные слова окажутся запрещёнными. Например ?DUP (если не равно нулю, то DUP иначе пропустить), т.к. состояние стека во время компиляции после него неизвестно.
Главная беда форта что он придумывался для очень маленьких систем определённой архитектуры - мир вырос и архитектура эта больше не используется, его модель системы теперь даже для микроконтроллеров не подходит.
Да я бы так не сказал. В конце концов всё упирается в компилятор, который необязательно должен быть простым и умещаться в несколько килобайт. Форт часто упрекают в излишней "косвенности". Он предпочитает короткие определения и вызывает множество подпрограмм, прежде чем доберется до делающего что-то кода. Но простые и распространенные слова( DUP, SWAP, + и т.п.) можно просто инлайнить. Хитрые манипуляции со стеком выкидывать, перекладывая всё на регистры. Данные при этом крутятся воуруг стека, а значит по-идее неплохо должны дружить с кешами. Думается код в итоге должен получаться не хуже чем на оптимизированном С. Высокоуровневую часть компилятор можно писать на чем угодно. А бекенд к конкретному микроконтроллеру прикручивать уже отдельно (хотя бы через тот же форт в конце концов). Получится что-то типа LLVM, но только для форта. Если кому-то из фортеров идея интересна, можем совместными усилиями попытаться реализовать.
Oangai
06.11.2026 08:04я делал именно такой оптимизирующий компилятор в 96м году, под 80286 архитектуру, то что тогда было доступно. Собственно на этом и остыл - компилятор удался вполне, производительности программ я добился, с примерами на C посравнивал, но при этом понял что реальные и интересные задачи для меня лежат в другой области, а это получился хоть и навороченный но всётаки велосипед без особого будущего. Код к сожалению не сохранился, давно уж дело было.
Про идею сделать стековую диаграмму обязательной тоже думал, правда уже после, но так и не добрался чтобы попробовать. Но это была бы всетаки еще не типизация, скорее подобие контракта. Для типизации нужно было бы класть к каждому значению в стек еще и идентификатор типа и часто проверять в рантайме, а это убило бы производительность более чем полностью. Почему и вспоминаю постскрипт каждый раз - там именно так и сделали, и получилось невероятно тормознутое нечто. А на этапе компиляции отследить все типы для стека оставаясь в форте наверное невозможно, или же ограничим гибкость и придем либо к java, или к регистровой VM вместо стековой. Sun собственно этим путём и прошел со своим OpenBoot - в 80х у них там форт хорошо поработал в драйверах карточек, опыта они хорошо набрались, и когда возникла идея универсального кроссплатформенного языка для всей экосистемы, форт был на обсуждении, кое-каие материалы по проектам того времени попадались в сети. Ну вот, начали его профессионально улучшать и доулучшались до того что имеем :)
eugenk
06.11.2026 08:04Для типизации нужно было бы класть к каждому значению в стек еще и идентификатор типа и часто проверять в рантайме, а это убило бы производительность более чем полностью.
Да, именно таким я стек себе и представлял. Содержащий пары (тип, значение). На производительность это никак не повлияет, ибо работает это только в форт-системе разработчика. Для целевой платформы компилируется программа либо без форт-системы (из которой стек данных возможно вообще будет выкинут при оптимизации), либо с простой форт-системой, с обычным стеком.
А на этапе компиляции отследить все типы для стека оставаясь в форте наверное невозможно, или же ограничим гибкость и придем либо к java, или к регистровой VM вместо стековой.
Ну стек исполнения с парами (тип, значение) в системе разработчика я представлял себе скорее как вспомогательное средство для отладки, трассировки и т.п. Для компиляции определения, создается отдельный стек компиляции, содержащий только типы, и инициализируемый левой частью стековой диаграммы. И по мере компиляции меняющий своё состояние. В конце состояние этого стека должно совпадать с правой частью диаграммы. Таким образом состояние стека постоянно отслеживается во время компиляции. Из ограничений я сейчас вижу только одно. Слово всегда должно начинаться в одном начальном и заканчиваться в одном конечном состоянии стека (глубина и типы). Например слово ?DUP запрещено, т.к. глубина стека может быть разной, в зависимости от того, нуль или не нуль лежит на стеке в начале исполнения. На самом деле всё немного сложнее. Например такие слова как DUP SWAP + и т.п. явно будут полиморфны и зависеть от типов лежащих на стеке (левая часть стековой диаграммы). Сейчас это делается разными словами для разных типов (например DUP для целого, DDUP для двойного, FDUP для плавающей точки и т.п.). Но т.к. типизация за одно бесплатно даёт нам и полиморфизм, логичнее иметь одно единственное слово DUP для всех типов, для которых эта операция осмысленна, а какая из реализаций будет выбрана, разбирается уже компилятор.

rrrrt7
06.11.2026 08:04Это очевидное решение. Правда я не совсем понимаю чем ?DUP мешает? Ну надо чуть усложнить описание слов, добавить в него еще указание на возможное отсутствие изменения стека.
Можно предположить и возражение со стороны фортеров - добавление обязательного описания работы со стеком в каждое слово увеличит размер программы. Причем подозреваю значительно.
Oangai
06.11.2026 08:04Да, можно начать с того что класс это DICTIONARY со всеми операторами данного типа, а идентификатор типа это указатель на словарь класса. Быстро приходим к парадигме "всё есть объект", потому что для целочисленных нужен свой словарь а для плавающих свой, с одинаковыми операторами. Продумываем систему выведения и приведения типов, хотим ли мы вообще неявное приведение (рисково и семантически сложно), или оставляем только явное. Далее, для большего удобства предпочитаем работать с переменными, всё равно компилятор их эффективно в VM разворачивает. Подправляем синтаксис, получаем на этом этапе вот: https://github.com/evincarofautumn/kitten/blob/master/examples/fibonacci.ktn
или как минимум вот: https://docs.factorcode.org/content/article-inference.html
Пробуем дальше и понимаем что без явного обращения к стеку можно и совсем обойтись, а заодно уж и от польской нотации отказаться, большинству пользователей всетаки инфиксная привычнее. Да и кривые скобки им визуально как-то понятнее, добавляем их тоже... И вуаля, благодаря Сану нашему ясному солнышку имеем сегодня прямую наследницу ForthVM в каждом смартфоне, но бегут на ней Java, Scala и Kotlin, плюс ещё сколько-то экспериментальных, тот же Factor на ней начинался.

CorwinH
06.11.2026 08:04Да, именно таким я стек себе и представлял. Содержащий пары (тип, значение).
У меня вопрос. Можно ли (теоретически) написать такой компилятор, который вычисляет тип каждого значения на стеке и следит за правильным использованием типов?
rrrrt7
06.11.2026 08:04Такой компилятор был написан, если я правильно понял - StrongForth.
p.s. И да, действительно ?DUP нельзя в таком компиляторе использовать.

fsv141 Автор
06.11.2026 08:04Мне когда-то попадалась то ли книга, то ли сайт с развёрнутой документацией по применению PostScript и если я правильно помню, то там автор какие-то чудеса творил на этом, казалось бы, "языке разметки". Помню, что орнул, но углубляться не стал - отложил на бесконечное "потом". Видимо, нужно опять находить тот источник. Интересно стало.
Oangai
06.11.2026 08:04да, штука интересная, медленная только и синтаксис вырвиглазный. Самое главное в нём, это то что все что автоматические генераторы и драйверы печати на нём создают, все сгенерированные .ps документы, их дидактически нельзя рассматривать для знакомства в качестве примеров языка, там обычно столько всего наворочено, и обьём в сотни раз больше чем для содержащейся информации требуется. Нужно искать именно человеческие примеры и руководства, они лаконичнее

GospodinKolhoznik
06.11.2026 08:04Какое-то время назад готовил статью для Хабра о функциональном программировании на Forth )) ну что то из разряда ненормальное программирование just for fun о том, как я сделал на Forth стандартный набор функций для обработки списков - инверсия, конкатенация, фильтр, маппинг, свёртка, все это с функциями первого класса, которые можно передавать как аргументы (по сути ссылки на функции) и все такое. Но без тайпчекинга, хотя к некоторым функциям прикрутил своего рода примитивный тайпчекинг.
Там было материала даже не на одну статью а на небольшую серию, но что то потом руки опустились. Ведь теперь каждый может за пять минут себе такой набор функций навайбкодить.
rrrrt7
06.11.2026 08:04Форт ценили за предельную надёжность
S" ABC" LAST1
и вся "предельная надежность" испарилась.fsv141 Автор
06.11.2026 08:04Это скорее пример плохой "дуракоустойчивоcти". И тут с вами не поспоришь - она у Forth на нуле.
eugenk
06.11.2026 08:04И это приводит к ошибкам. Причем очень неочевидным, и появляющимся только в рантайме. Так что ныне существующую версию форта, для продакшена я бы никому не рекомендовал. Если интересно, написал выше, как это можно подлечить.
fsv141 Автор
06.11.2026 08:04Я думаю, ваше утверждение по большей части справедливо относительно парадигмы мэйнстим-программирования: пишешь код, эпизодически тестируешь, когда дописал его до компилируемого состания. Но к программированию в Forth-среде оно менее применимо.
И ещё. Приведу цитату Трэвиса Бимана (разработчика zeptoforth): "Forth by its very nature is not meant to be a fool-proof language but rather is meant to be a language that allows a great amount of freedom to the user overall, and yes, that includes freedom to shoot yourself in the foot."
Так что все мои "возражения" не опровергают ваш главный тезис - "ныне существующую версию форта, для продакшена я бы никому не рекомендовал", а скорее подкрепляют его.
rrrrt7
06.11.2026 08:04В контексте языков программирования "дуракоустойчивость" это первое что важно для надежности. Но есть конечно и другие особенности языков, которые влияют на надежность и там тоже у Forth все очень плохо.
Например мы обычно ожидаем от языка программирования, что он будет снижать когнитивную нагрузку на программиста. Что программист будет тратить свое время и внимание на то что действительно важно для решаемой задачи. И тут у ассемблеров, в том числе и у Forth, как макроассемблера виртуального стекового процессора, есть значительный недостаток. Они многословны, и заставляют программиста заниматься тем, что прекрасно умеет делать компилятор. Для обычных процессоров это распределение регистров, для стековых - манипуляции со стеком. DUP DUP в LAST1 как пример.

CorwinH
Читали "Алгоритмические трюки для программистов" (Hacker’s Delight) Генри Уоррена-младшего? Там описан и этот "трюк", и многие другие. Например, как заменить целочисленное деление умножением и сдвигом. В те времена подобные "трюки" давали неплохую прибавку производительности.
fsv141 Автор
Пока не читал. Но большое спасибо за наводку - обязательно разыщу эту книгу. Про замену целочисленного деления умножением и сдвигом много где читал. Ещё раз спасибо.