Привет! Меня зовут Илья Грошев, я продуктовый инженер в KTS и последние полгода отвечаю за систему планирования производства для типографии: сотня машин, полторы сотни людей с допусками и графиком смен, у каждого заказа свой маршрут операций. Каждый заказ нужно закончить к обещанному сроку, а для каждой операции найти свободную машину и человека с допуском в одну и ту же смену.
Планировщик берёт заказы один за другим, расставляет операции каждого по правилам типографии и к уже поставленным заказам не возвращается. План строился быстро, но заказы в нём опаздывали даже при свободных машинах, и мы не знали, можно ли лучше. На тестовом наборе он укладывал в срок 8 заказов из 15, а точная модель на тех же данных показала, что можно все 15.
В статье расскажу, как мы строили этот алгоритм и почему точная модель осталась у нас инструментом отладки и в прод не попала. Разберу задачу, три слоя планировщика с гипотезами, которые сработали и которые провалились, три способа проверить план и то, что проверка изменила в алгоритме. Опыт пригодится тем, кто составляет расписания или распределяет ограниченные ресурсы и выбирает между эвристикой и точной моделью.
Оглавление
Что нужно распланировать
Маршрут заказа состоит из активных операций вроде печати или резки и пассивных вроде сушки, которая длится по двенадцать часов и не занимает ни машин, ни людей. Для активной операции подходит несколько машин, а машине нужен человек с допуском. Смен две, дневная и ночная, и в каждой есть час на обед.
Подходом называется часть операции, которую один исполнитель выполняет на одной машине за одну смену. Короткая операция умещается в один подход, длинная делится на несколько, и весь план состоит из подходов.
Пока не готов макет (согласованные с клиентом файлы для печати), заказ нельзя запускать в производство. Закончить его надо к дате выдачи, которую клиенту обещали при приёме. Между этими двумя датами должен уместиться весь маршрут.
Заказов сотни, план строится на недели вперёд и пересчитывается каждые пятнадцать минут, потому что входные данные постоянно меняются. Учётная система типографии планирует только машины, а людей к ним подбирают вручную накануне. Наша система планирования производства (по сути APS-модуль, который дополняет MES) назначает и машину, и человека, иначе срок в плане ничем не подкреплён.
Почему задача трудная и когда помогает эвристика
Почему задача NP-трудная
В исследовании операций такую задачу называют flexible job shop с двойным ресурсом: маршруты у заказов разные, машину для операции можно выбирать, и кроме машины нужен человек.
Даже упрощённая версия без людей, смен и сушки NP-трудна. М. Гэри, Д. Джонсон и Р. Сети доказали это ещё в 1976 году для трёх машин, через которые все заказы проходят в одном и том же порядке. На практике это значит, что известные алгоритмы не гарантируют лучший план за разумное время.
Возьмём маленький пример: печатная машина, резак и три заказа, каждый сначала печатается, потом режется. У заказа A четыре часа печати, час резки и срок шесть часов от старта, у B час печати, три часа резки и срок семь, у C два часа печати, час резки и срок двенадцать.
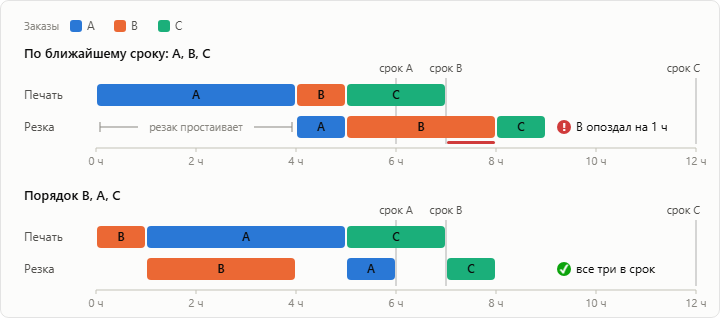
Другие простые правила тоже не находят этот порядок. Правило «сначала короткая работа» ставит заказы в порядке C, B, A, и заказ A опаздывает на два часа, а «сначала меньший запас времени» повторяет порядок по сроку.
На трёх заказах нужный порядок находится перебором шести вариантов. На ста заказах порядков уже 100 факториал, то есть число из 158 цифр. К порядку ещё добавляются выбор машины, деление на подходы и подбор человека на каждый подход.
Что такое эвристика и когда она оправдана
Эвристикой в планировании называют способ построить решение по правилам и за предсказуемое время. Решение получается хорошим, но не обязательно лучшим. Правило «сначала ближайший срок» из примера выше уже эвристика: оно строит план за один проход и не гарантирует его качество.
Точные методы перебирают пространство решений с отсечениями (отбрасыванием вариантов, которые заведомо не приведут к лучшему решению) и могут доказать, что лучше найденного плана нет, зато время такого перебора растёт непредсказуемо.
Эвристики делятся на несколько видов:
Конструктивная строит план с нуля шаг за шагом: берёт следующий заказ по правилу приоритета и ставит его операции на первые подходящие места.
Улучшающая берёт готовый план и меняет его: переставляет пару заказов в очереди или переносит операцию на другую машину и оставляет изменение, если стало лучше.
Метаэвристика делает то же самое, но иногда соглашается и на ухудшение, чтобы выбраться из тупика.
Гибрид отдаёт небольшую часть задачи точному методу, а всё остальное оставляет за эвристикой.
Эвристика оправдана, когда задача велика, ответ нужен быстро, а входные данные и правила всё время меняются. В нашем случае сошлись все эти условия.
В точной модели переменная заводится на каждую тройку «подход, работник, смена», и на нашем масштабе такая модель не успевает найти решение между двумя пересчётами плана. Правила типографии вроде «остаток операции до часа на другую смену не переносить» или «обед с любого края смены» появляются и меняются по ходу внедрения, а поправить условие в коде проще, чем перестроить модель.
У эвристики есть цена: гарантии оптимальности нет, и жадный порядок застревает в локальном оптимуме (состоянии, где любое изменение ухудшает план, но до лучшего плана всё равно далеко) так же, как в примере с тремя заказами.
В правилах появляются константы вроде минимальной длины подхода или глубины поиска свободного окна. У нас их набралось полтора десятка, все подобраны на наших данных, и на другом производстве их придётся подбирать заново.
Правила влияют друг на друга: два улучшения по отдельности дают плюс, а вместе могут дать минус. И каждый новый слой правил увеличивает время расчёта.
Готовую библиотеку планирования мы не взяли, потому что правила типографии слишком специфичны, хотя сами приёмы в планировщике большей частью известные.
Как сравнивали планы
Когда планировщик заработал, больше всего мешали две проблемы. Заказы со сроком в будущем опаздывали в плане, хотя по загрузке машин мощности хватало. И план между двумя пересчётами менялся сильнее, чем входные данные: подходы переходили с машины на машину. Почти каждая гипотеза была направлена на одну из этих проблем.
Опозданием здесь и дальше называется случай, когда заказ по плану заканчивается позже даты выдачи. Речь об опоздании в плане: цех ещё ничего не сорвал, но план уже показывает, что к сроку заказ не успеет.
Сравнивать два плана нужно по одной метрике, иначе не кончается спор о том, какой из них лучше. Наша метрика состоит из двух чисел:
Сколько заказов со сроком в будущем не уложилось в срок.
На сколько часов эти заказы опоздали в сумме. Второе число сравнивается, только если первое у двух планов одинаково.
Заказы с уже прошедшим сроком в метрику не входят, потому что их опоздание растёт с каждым часом независимо от плана и скрыло бы эффект любой правки.
Эта метрика относится к первой проблеме. Вторую мы измеряли долей подходов, которые меняют место между двумя запусками. Кроме того, мы следили за числом подходов, часами работы без исполнителя и временем расчёта.
Цифры в статье получены на копиях прода и на тестовом наборе. Копия прода повторяет рабочую базу на определённый день, а тестовый набор состоит из пятнадцати однотипных заказов на трое суток с заданным списком людей и смен. Копии сняты в разные дни, поэтому числа из разных сравнений нельзя сопоставлять между собой.
Мы проверяем правки сразу на нескольких наборах данных. В них входят копия прода как есть, три её изменённых варианта (сроки на сутки раньше, сроки на двое суток позже, без каждого шестого заказа) и тестовый набор. Если правка выигрывает на одном наборе и проигрывает на двух, мы её не берём, даже если на исходной копии выигрыш большой.
Строим план: три слоя
Планировщик строит план в три слоя, и каждый слой отвечает на свой вопрос: кого из очереди брать первым, когда ставить операции заказа, на какой машине и с каким человеком выполнять каждую операцию.
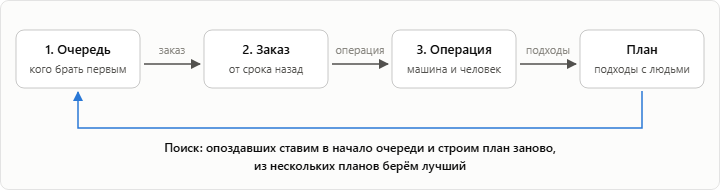
Слой 1. Очередь: кого брать первым
Планировщик берёт заказы по одному, и свободное время загруженных машин и редких специалистов достаётся тем, кто стоит в начале очереди. Поэтому порядок очереди определяет, кто опоздает.
Сначала очередь строилась по весу: у типографии есть балльная система, которая оценивает важность каждого заказа. Срок в вес не входит, поэтому заказ с большим весом и выдачей через месяц забирал резак у заказа, который нужно отдать завтра.
Запас времени вместо веса
Вместо веса мы взяли запас, то есть время до срока минус оставшаяся работа. Запас показывает, на сколько работу над заказом можно отложить, не сорвав срок.
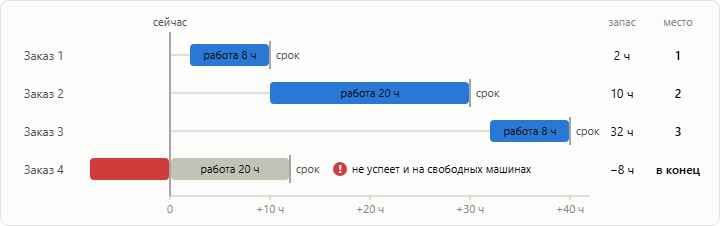
Очередь по одному только запасу сократила число опоздавших заказов с 26 до 19, а часы опоздания с 3393 до 1115.
Правило ATC
Вес заказа при этом из очереди выпал совсем, а размер заказа она не различала: заказ на два часа и заказ на семьсот стояли в ней по одному признаку. Поэтому следующим шагом стало правило ATC (apparent tardiness cost, «кажущаяся цена опоздания») из теории расписаний:
приоритет = (вес / работа) · exp(−запас / (K · средняя работа))
Сам приоритет является числом, по которому сортируются заказы: чем он выше, тем раньше заказ в очереди. Работа здесь означает часы, которые заказу осталось отработать, а средняя работа считается по всем заказам со сроком в будущем. Пока запас большой, приоритет заказа близок к нулю, а с приближением срока он растёт по экспоненте. Из одинаково срочных заказов вперёд идёт тот, у кого больше веса на час работы.
Параметр K задаёт, насколько заранее до срока приоритет начинает расти, и в литературе для него советуют значения от 1,5 до 4,5. Мы начали с K = 2. Меньшие значения на наших данных работали лучше: K от 0,75 до 1,5 давал на 14–20% меньше часов опоздания, и мы взяли K = 1.
Что не сработало
Сортировка по сроку на исходной копии дала лучший результат из всех, но на двух из трёх изменённых наборов проиграла очереди по запасу, и мы её не взяли. Мы пробовали и другие правила приоритета, но результат они не улучшили.
Слой 2. Заказ: когда ставить операции
Когда заказ взят из очереди, нужно решить, на какое время поставить его операции. Пока операции ставились как можно раньше, заказ с выдачей через две недели занимал завтрашние смены, и заказу со сроком завтра места не оставалось.
Поэтому операции расставляются обратным проходом, от срока назад. Последняя ставится как можно ближе к дате выдачи, предпоследняя как можно ближе к началу последней, и так до первой.
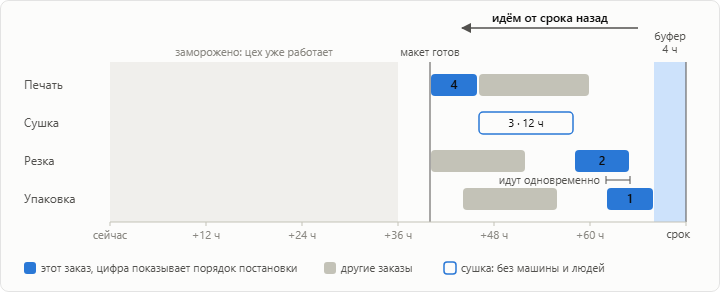
Если заказ не помещается между левой границей и сроком, он планируется вперёд от границы и получает опоздание.
Одновременные операции
В первых планах каждая операция ждала конца предыдущей, и заказ получался длиннее, чем в цехе, и чаще не помещался до срока. В цехе следующую операцию начинают, пока предыдущая ещё идёт: первую пачку листов режут, пока печатаются остальные.
Поэтому смежные операции в плане могут идти одновременно, если следующая не обгоняет предыдущую ни по началу, ни по концу. Сушка и другие пассивные операции начинаются, только когда предыдущая операция закончилась.
Буфер перед сроком
У обратного прохода есть побочный эффект: заказы заканчиваются вплотную к сроку. На копии прода 27 заказов из 73 заканчивались меньше чем за четыре часа до выдачи, и любой сбой в цехе делал их опоздавшими.
Поэтому появился буфер: обратный проход начинается за четыре часа до срока. Если так заказ не помещается, проход повторяется от настоящего срока. С буфером ближе четырёх часов к выдаче заканчиваются три заказа, и опозданий из-за него не появилось.
Инерция
Здесь же решается вторая проблема: цеху нужен план, в котором работа от пересчёта к пересчёту остаётся на своих местах.
Для этого в планировщике есть инерция: он помнит, куда прошлый запуск поставил каждый подход. Среди вариантов он отдаёт предпочтение той же машине в пределах двенадцати часов от прежнего времени.
Для проверки мы изменили пять заказов и посмотрели, сколько подходов сменит место у остальных: без инерции 46%, с ней 25%, а число опозданий осталось тем же.
Что не сработало
Буфер в двенадцать часов разносил подходы одной операции по разным машинам. Расстановка только вперёд от самой ранней даты уложила в срок четыре заказа из тестового набора вместо восьми.
Слой 3. Операция: какая машина и какой человек
Операции нужны машина и человек с допуском, и оба должны быть свободны в одно и то же время внутри одной смены. Целое окно под операцию находится не всегда, а делить её невыгодно: каждый новый подход на печати требует приладки, то есть настройки машины под тираж.
Поэтому планировщик перебирает варианты размещения по порядку, от самого выгодного. Он оставляет исполнителю час на обед в начале или в конце смены, чтобы не прерывать работу посередине.
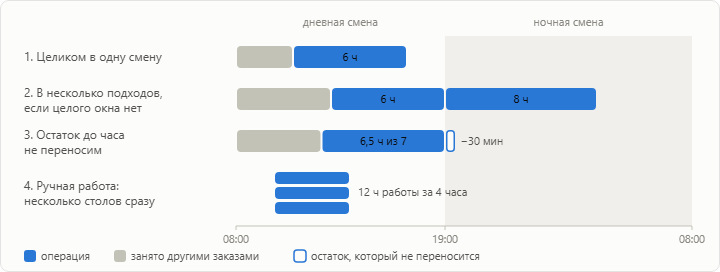
До введения этих правил (рис. 5) планировщик делил операции чаще. С ними подходов в плане 1040 вместо 1170, на несколько подходов делится 58 операций вместо 119, а опоздания не выросли.
Если исполнитель не нашёлся, операция ставится на машину без человека, и в плане она видна как работа без исполнителя.
Редкие специалисты
В одном из планов единственный оператор машины шесть с половиной часов упаковывал тираж, хотя упаковать могли другие, а заменить его на машине было некем. Редкого специалиста легко потратить на работу, которую может сделать любой.
Поэтому при выборе исполнителя первым идёт тот, кого проще заменить на других машинах, а из равных тот, у кого меньше часов. Если в свою смену человек остаётся единственным оператором загруженной машины, на другую работу его ставят, только когда свободных коллег на смене нет.
Что не сработало
Мы пробовали ставить операции без исполнителя в конец очереди машины, и часы опоздания выросли вчетверо.
Ещё один вариант требовал второго человека на машинах, где работает бригада из двух. С ним работа уходила в операции без исполнителя, и по метрике план выглядел лучше, чем был на деле.
Проверяем план: три способа
У нас три способа проверить план, и каждый отвечает на свой вопрос: хватает ли в данных людей и смен, почему отдельная операция стоит так поздно и сколько заказов теряет сам алгоритм.
Данные: опоздания, которые алгоритм не исправит
Прежде чем искать причину опоздания в алгоритме, мы проверяем, есть ли у машины люди и смены на нужные даты, потому что часть опозданий никаким правилом не исправить.
На копии прода дольше всего заказы ждали у машин, к которым допущены два-три человека с одной сменой в сутки, хотя сами машины были заняты не больше чем на три четверти времени.
Одной из печатных машин на две недели вперёд требовалось 257 часов работы операторов, а в графике их было 200, и порядок очереди не восполнит недостающие 57 часов. Два резака обслуживали одни и те же четыре человека. У одного из них совсем не было смен, а троих оставшихся на две машины не хватало.
Некоторых специалистов на их машине некем заменить, а график у них был заведён всего на день-два вперёд, и более поздняя работа оставалась без исполнителя.
Чтобы отделить такие опоздания от ошибок алгоритма, мы проверяем на копии, сколько даёт исправление данных. Когда мы продлили графики десяти таким специалистам, работа без исполнителя сократилась с 635 часов до нуля. Любая правка алгоритма давала по этому показателю меньше.
Один плохой случай: три ошибки в поиске места
Если людей и смен хватает, а заказ всё равно опаздывает, мы берём одну его операцию и смотрим, почему планировщик не поставил её раньше. Так в третьем слое нашлась главная причина опозданий при свободных машинах. Это было в самом начале, ещё до правил очереди из первого слоя: заказы на копии прода опаздывали суммарно на 16 615 часов, и мы подозревали очередь.
Подход в четыре с половиной часа стоял на полтора месяца позже возможного при десятках свободных людей. Причин нашлось три:
Поиск места для целой операции не рассматривал начала смен свободных работников: он перебирал только моменты, когда машина или человек заканчивали предыдущую работу.
Правило «ставь вплотную к соседней работе» отправляло всю ручную работу на один стол при десяти пустых.
Исполнителем назначался первый по списку, и один человек набирал 391 час при медиане 25 часов на человека.
Когда мы устранили все три причины, часы опоздания упали до 3544, то есть на 79%.
Обед и пропущенная смена
Ещё одна ошибка того же рода нашлась в правиле про обед. Поиск проверяет только несколько возможных моментов начала работы: начало смены и моменты, когда машина или человек заканчивают предыдущую работу.
Если конец смены уже занят, обед остаётся в её начале, и новая работа может начаться только через час после начала смены. Такого момента среди проверяемых не было. Поиск пробовал начало смены, там стоял обед, и смена пропускалась, хотя почти вся она была свободна.
Когда мы добавили в проверку момент «через час после начала смены», часы опоздания на тестовом наборе упали на 17%.
Точная модель: сколько теряет сам алгоритм
Три слоя вместе укладывали на тестовом наборе в срок 8 заказов из 15. Мы не могли сказать, в чём причина: в самом алгоритме или в данных, где может не хватать смен. Подсчёт часов на этот вопрос не отвечал: на тестовом наборе работа на главных машинах почти равнялась времени смен, и по сумме часов не было видно, хватит ли смен при другом порядке заказов.
Чтобы это выяснить, мы собрали точную модель того же набора в CP-SAT, солвере для задач с ограничениями из библиотеки OR-Tools. Правила в ней те же, что у планировщика, а цель состоит в том, чтобы уложить в срок как можно больше заказов.
Солвер нашёл план, в котором успевают все 15 заказов, причём 13 он уложил за две секунды. Значит, смен хватало, и семь заказов терял наш алгоритм.
Ещё полезнее оказалось сравнить план точной модели с нашим. На одной из печатных машин точная модель ставила первым заказ, который жадный планировщик брал пятым.
Причина нашлась в том, как мы считали запас. Формула брала время до срока и вычитала из него часы работы. Она не учитывала, что работать можно только в смены нужных людей и что сушка добавляет заказу часы ожидания. Поэтому у всех заказов набора запас выходил почти одинаковым.
Если учесть смены и сушку, запас у этого заказа самый маленький, и понятно, почему точная модель ставила его первым.
Так появился второй способ считать запас. Каждый заказ планируется отдельно, как будто других заказов нет, но с настоящими сменами и сушкой. Запасом считается время, на которое начало работы в таком плане можно отложить, не сорвав срок. На тестовом наборе очередь по такому запасу дала 11 заказов в срок вместо 8.
На копии прода та же очередь ухудшила план: не в срок вышло 32 заказа вместо 28 при очереди по ATC. Тестовый набор однороден, а в проде заказы бывают от двух до семисот часов работы. Правило «меньший запас первым» пропускает вперёд крупные заказы, и из-за них опаздывают мелкие. Поэтому основной осталась очередь по ATC.
В прод точная модель так и не попала, потому что дальше маленького набора она не масштабируется, а её подсказка с однородного тестового набора на проде не сработала. Она осталась инструментом отладки: на маленьком наборе видно, насколько эвристика отстаёт от лучшего плана и где именно.
Улучшаем план: поиск лучшей очереди
Три слоя не могут исправить ошибку в очереди: если заказ поставлен раньше, он уже занял своё место. И мы так и не нашли очередь, которая подходит всем наборам данных.
Какие бы правила очереди мы ни пробовали, без поиска на тестовом наборе в срок укладывались самое большее 12 заказов из 15. Когда мы просто ставили опоздавший заказ первым, он успевал, зато опаздывали от четырёх до девяти других заказов.
Как устроен поиск
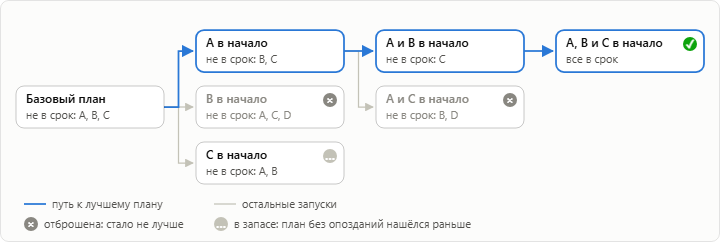
Поиск перезапускает три слоя с разными очередями и оставляет лучший план по той же метрике, по которой мы сравниваем планы. Так к конструктивной эвристике добавилась улучшающая: она меняет очередь и оставляет изменение, если план стал лучше.
Сначала строятся два плана, один с очередью по ATC, другой с очередью по запасу со сменами и сушкой. Затем идут повторные запуски.
Что это дало и чего стоило
На тестовом наборе перебор нашёл цепочку из трёх перестановок, и в срок уложились все 15 заказов, столько же, сколько у точной модели. На пяти копиях прода повторные запуски вместе с правилом одновременных операций из второго слоя снизили часы опоздания на 3–60%, и новых опоздавших заказов не появилось.
У повторных запусков два недостатка: расчёт на копии прода стал занимать от трёх до шести минут вместо полуминуты, а результат из-за инерции зависит от прошлого плана. Тот же перебор поверх уже готового плана укладывает в срок только 14 заказов из 15.
Что не сработало
Мы пробовали и более простые варианты. Схема «опоздавших вперёд, и так раз за разом» без отбора по метрике не сходилась: план то улучшался, то ухудшался, и в срок добавлялся самое большее один заказ.
Попарные перестановки заказов в очереди улучшений не дали. Ещё один вариант на каждом шаге брал самую срочную операцию из всех заказов сразу и уложил на тестовом наборе пять заказов вместо восьми.
Две ловушки при сравнении планов
Поначалу мы сравнивали запуск до правки и после на одной копии прода и дважды на этом ошиблись.
Время суток
Одна и та же версия на одной и той же копии утром и вечером давала часы опоздания с разницей до восьми процентов, то есть больше, чем эффект многих правок. Планировщик начинает расстановку с границы ближайшей смены, и с переходом от дневной смены к ночной план получается другим.
Поэтому мы сравниваем версии сериями запусков подряд: сначала планировщик без правки, потом варианты с правками, в конце снова планировщик без правки. Если первый и последний запуск дали одинаковый результат, условия за это время не изменились, и варианты можно сравнивать между собой. Если результаты разошлись, вся серия не считается.
Прошлый план во входных данных
План менялся от запуска к запуску, хотя заказы и смены оставались теми же. Разницу вносил сам план: если заказу не хватало смен, в следующем запуске он получал право двигать свои подходы в замороженной зоне, укладывался в срок, терял это право и снова не укладывался.
Поэтому каждый вариант мы запускаем с пустого плана два раза подряд и сравниваем по второму запуску.
Заключение
На тестовом наборе планировщик теперь укладывает в срок все 15 заказов вместо 8, столько же, сколько точная модель. На одной и той же копии прода число заказов не в срок упало с 44 до 24, а часы опоздания с 16 615 до 1762. План стал устойчивее: после изменения пяти заказов место меняют 25% подходов вместо 46%.
Пять выводов из этой работы подойдут и для других задач с расписанием:
Метрику стоит выбрать до первой гипотезы, потому что без неё любую правку можно назвать улучшением.
Правку нужно проверять на нескольких наборах данных: у нас два правила очереди выигрывали на одном наборе и проигрывали на других.
Данные нужно проверять раньше алгоритма: правила не восполнят нехватку людей и смен.
Прежде чем придумывать новое правило, полезно проследить путь одного плохого случая. У нас так нашлись три ошибки, и после их исправления часы опоздания упали на 79%.
Точная модель полезна как инструмент отладки: на маленьком наборе она показывает, сколько теряет эвристика и где, даже если в прод эта модель не попадёт.
Дальше хотим попробовать гибрид в составе MES: жадная расстановка для всех заказов и точная модель для плотного участка в несколько дней, где эвристике труднее всего.
К слову, мои коллеги тоже делятся с Хабром своим проектным опытом. Если статья была интересной, то вам наверняка понравятся и эти: