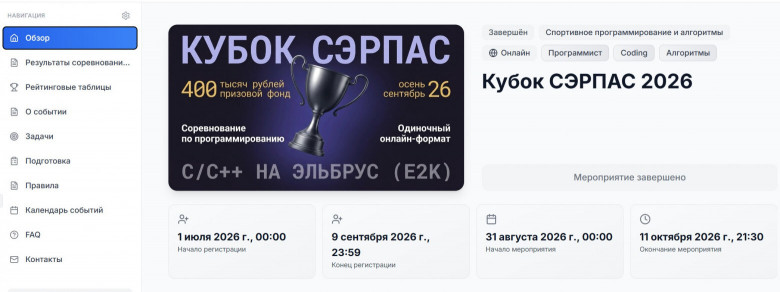
Всем привет! Меня зовут Александр Схрейдер, и этой осенью я занял первое место в Кубке СЭРПАС 2026 — соревновании по оптимизации программ на C/C++ под российские процессоры Эльбрус. Если честно, самым неожиданным для меня в нём оказалась не какая‑то хитрая математика, а то, что на Эльбрусе программа, которая делает на 60% меньше работы, вполне может работать медленнее (да, я тоже сначала не поверил). Почему так происходит и что с этим делать, я и попробую рассказать.
Кирилл Ерохин, организатор соревнования, уже рассказал на Хабре, как он проводил Кубок: про серверы, платформу, защиту решений и финал. Мне же хочется показать то же самое соревнование глазами участника: как я решал три отборочные задачи и финальный лабиринт, что на Эльбрусе сработало, а что, наоборот, сделало только хуже, и почему интуиция, наработанная на Intel и AMD, на e2k подводит чаще, чем хотелось бы.
Рассказ получился длинным, поэтому я разбил его на три части. В этой — чем Эльбрус отличается от привычных процессоров, как я мерил скорость и первая задача. Во второй части — свёртки сигналов и карта с пунктами выдачи, в третьей — финал. Все цифры в статье — это медианы прогонов на тестирующих машинах, которые я записывал по ходу соревнования. А исходники всех трёх моих отборочных решений лежат на GitFlic под лицензией MIT, так что всё, о чём пойдёт речь, можно посмотреть прямо в коде.
А если удобнее слушать, чем читать: про соревнование мы с Кириллом подробно говорили в подкасте Pure Virtual Cast от C++ Russia, полный выпуск есть на YouTube и во VK Видео.
Оглавление
Предыстория, которую можно пропустить
Как‑то вечером я листал интернет в поисках чего‑нибудь интересного, куда можно было бы податься, причём хотелось не очередного «сделайте веб‑сервис за выходные», а чего‑то про железо и скорость. Так я и наткнулся на хакатон, где нужно было писать быстрый код под Эльбрус. Про сам Эльбрус я на тот момент знал примерно то же, что и большинство: что он есть и что он где‑то стоит, а вот руками его ни разу не трогал. Подумал, что шанс посмотреть, как он вообще себя ведёт и как под него оптимизировать код, выпадает нечасто, и зарегистрировался в тот же вечер.
Довольно быстро выяснилось, что быстрый код я писать вроде бы умею, но всё, что я про это знаю, я знаю про x86. На Эльбрусе же половина привычных приёмов просто не работает, а часть и вовсе делает хуже, и, как ни странно, именно это и оказалось самым интересным.
Немного контекста для тех, кто статью Кирилла не читал. Активных участников было 112, а все три задачи решили 46 человек. Причём важно было не просто решить задачу, а решить её быстро и экономно по памяти, поэтому оценка на отборе считалась по такой формуле:
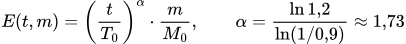
Слоган Кирилла звучал так: «10% прироста скорости стоят не более 20% увеличения памяти». Ранжировали по медиане десяти прогонов, а Valgrind без единой ошибки был обязательным условием. Лимиты были такие: 10,5 секунды, от 128 до 512 МБ в зависимости от задачи и не больше семи потоков.
Отбор шёл на платформе Codenrock, которая специально для Кубка научилась запускать решения на Эльбрусах: пишешь код, отправляешь и примерно через минуту видишь время и память на настоящем Эльбрус-8СВ. Поэтому каждая отправка у меня превращалась в такой маленький экспериментик: отправил, посмотрел, разобрался, почему стало быстрее или медленнее, и пошёл дальше.
Коротко про Эльбрус, или кухня без шефа
Разницу между Эльбрусом и привычными процессорами я для себя объяснял через кухню. У Intel на кухне стоит шеф, который смотрит на заказы и на ходу всё перекидывает: суп варится — значит, давай пока порежем салат. Процессор точно так же сам заглядывает вперёд по программе, находит независимые команды и выполняет их параллельно. Называется это out‑of‑order исполнение, и оно прощает программисту очень многое.
У Эльбруса шефа нет, зато есть заранее расписанный план: в этот такт трое режут, двое жарят. Повара выполняют его очень быстро и очень дружно, но если в плане написано «ждём бульон», они честно стоят и ждут. Пишет этот план компилятор LCC, когда собирает программу, упаковывая независимые операции в широкие команды (VLIW), и если упаковать ему нечего, широкая команда так и уходит полупустой.
Отсюда и сложился мой стиль работы под e2k: давать компилятору как можно больше независимой работы, читать память подряд, без прыжков, поменьше ветвиться и, конечно, всё мерить, потому что интуиция с x86 здесь подводит постоянно.
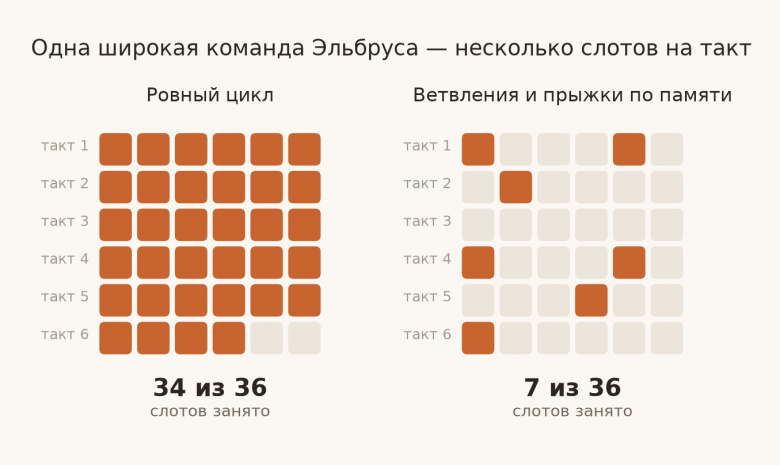
Как говорит Кирилл, задача программиста под Эльбрус — упростить жизнь компилятору, а дальше он всё сделает сам. С этим я полностью согласен, и, по сути, всё, что будет дальше, — это история о том, как придать коду правильную форму.
Как я мерил
Раз уж всё соревнование было про скорость, сначала пару слов о том, как я вообще понимал, что стало быстрее. Скорость я смотрел только на настоящем железе. Локально на своём Intel удобно проверять правильность, но время там ничего не говорит: не раз бывало, что у меня новая версия ускорялась, а на Codenrock, наоборот, работала медленнее. Поэтому каждую идею я отправлял на тестирующую машину и смотрел время и память уже там, причём одному прогону никогда не верил: шум был около ±3–4%, и мелкую правку доказывает только медиана по нескольким запускам.
Каждую отправку я версионировал и сохранял все дельты: что поменял, что улучшилось, что ухудшилось. В задаче 1 таких версий набралось больше двадцати, в задаче 3 — одиннадцать. Изначально я делал это просто для себя, чтобы в следующей задаче не наступать на те же грабли, но в итоге по этому журналу видно не только то, что сработало, но и то, что не сработало, а из неудач я, как ни странно, узнал больше всего.
Само по себе итоговое время мало что объясняет, нужно ещё понимать, куда уходят миллисекунды. Запустить на тестирующей машине perf было нельзя, она показывала только стандартный вывод, поэтому профилировщик я встроил прямо в решение: в отдельном режиме сборки программа вместо ответа печатала время каждого этапа — чтения, подготовки, основного счёта и вывода (по сути, старая добрая printf‑отладка, просто чуть более аккуратная).
Ну и, наконец, правильность. Каждую быструю версию я сверял с простым переборным решением на сотнях маленьких случайных входов и прогонял через Valgrind, потому что ускорение, которое ломает ответ, ничего не стоит, а сломать что‑нибудь незаметно при таких оптимизациях проще простого.
Задача 1: сотрудники и доступы
Полные условия всех трёх отборочных задач лежат в одном PDF, там же примеры входов и ограничения, а моё решение этой задачи целиком лежит на GitFlic в файле task1.c.
Что спрашивали
Дана бинарная таблица прав: строки — сотрудники, столбцы — ресурсы, единица означает, что доступ есть. Нужно посчитать, сколькими способами можно выбрать двух сотрудников и два ресурса так, чтобы у обоих был доступ к обоим, то есть, по сути, число квадратиков 2×2 из одних единиц.
Матриц пять, самые большие из них 12288×6144, 6144×12288 и 9216×9216, а на вход приходит около 236 МБ нулей и единиц текстом. Если считать в лоб, это месяц счёта, так что сначала пришлось подумать головой.
Одна формула
Возьмём пару строк. Если у них  общих единиц, то прямоугольников на этой паре ровно
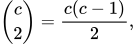
Это биномиальный коэффициент: любые две общие позиции дают один прямоугольник. Так вся задача превращается в «для каждой пары строк посчитай одно число».
Клетка — это бит, значит в 64-битное слово влезает 64 клетки. Общие единицы считаются как popcount(a & b), а у Эльбруса для popcount есть отдельная команда (__builtin_e2k_popcntd), так что 64 сравнения превращаются в пару операций.
Сначала выкинуть лишнее
Меньшая ось. Число пар растёт квадратично, поэтому для матрицы 12288×6144 пары считаются по столбцам. Для этого матрица транспонируется битовой «бабочкой» 64×64, параллельно всеми потоками (было около 50 мс, стало около 15).
Одинаковые строки. В условии была подсказка, что у некоторых сотрудников права совпадают полностью. Ну, типа все бухгалтеры одинаковые. Такие строки я хранил один раз с кратностью, а пары внутри группы считал формулой. Поиск через хеш, но после совпадения хеша строки всегда сравниваются целиком через
memcmp, чтобы коллизия ничего не испортила. Уникальных строк осталось 5376 из 6144 и 8064 из 9216, минус примерно четверть пар.
Тридцать две пары сразу
Если считать по одной паре, получается длинная цепочка: прибавил, прибавил, прибавил, и каждое сложение ждёт предыдущее. На Эльбрусе это означает, что большая часть широкой команды так и пустует, поэтому горячее ядро у меня берёт 16 строк с одной стороны и 2 с другой и считает 32 пары одновременно, каждую в свой счётчик:
// упрощённо: 16 левых векторов × 2 правых = 32 независимых аккумулятора
for (int w = 0; w < words; ++w) {
    uint64_t r0 = right0[w], r1 = right1[w];
    for (int i = 0; i < 16; ++i) {
        uint64_t l = left[i][w];              // одно чтение, два использования
        acc0[i] += __builtin_e2k_popcntd(l & r0);
        acc1[i] += __builtin_e2k_popcntd(l & r1);
    }
}
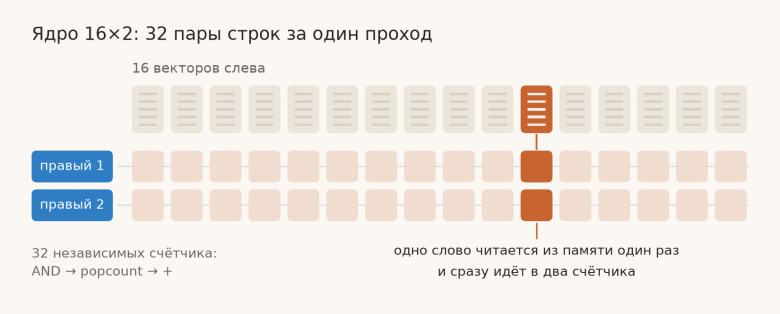
Так компилятору есть что раскладывать параллельно, а каждое слово из памяти используется дважды. Конечно, я пробовал и шире, но варианты 16×4 и 8×4 оказались хуже: кончились регистры, и компилятор начал гонять значения через память. В 16×1, наоборот, слишком мало параллелизма. Лучшая точка нашлась где‑то посередине, и найти её удалось только перебором, заранее угадать её у меня не получилось.
Интересно прикинуть, сколько при этом железо делает за такт. На матрице 9216×9216 около 32,5 млн пар по 144 слова, то есть примерно 4,7 млрд операций «AND + popcount + сложение» за ~238 мс на семи ядрах по 1,5 ГГц:
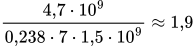
То есть около 1,9 слова за такт на каждом ядре, а это больше пяти полезных операций за такт, и всё это на обычном C, без единой строчки ассемблера. Для меня это, пожалуй, самый наглядный пример того, как раскрывается VLIW, когда код написан в правильной форме.
Чтение в освободившуюся память
Когда счёт стал быстрым, на первый план вылезло чтение: матриц пять, и просто распарсить столько текста занимает ощутимое время. Очевидное решение — читать следующую матрицу, пока считается текущая, но память шла в оценку, и держать ради этого второй большой буфер совсем не хотелось.
Потом я заметил, что посчитанный блок строк больше вообще не нужен, а значит, следующую матрицу можно писать прямо поверх него, по мере того как блоки освобождаются. Это как въезжать в квартиру, пока прошлые жильцы ещё съезжают: заносишь вещи в комнату, как только её освободили, главное в занятую не залезть. Технически это флаги done[ib] с release/acquire и «безопасный фронт», который двигается только по непрерывному префиксу готовых блоков. В итоге около 115 мс чтения спряталось за счётом, а всё решение уложилось примерно в 15 МБ.
Отдельно стоит сказать про потоки. OpenMP‑потоки держат заметно больше памяти (стеки, runtime), а память, напомню, входила в оценку, поэтому я написал свой постоянный пул на pthread: 6 рабочих потоков плюс main, стеки по 64 КиБ, а блоки раздаются через atomic_fetch_add. По скорости разницы не было, а вот памяти стало сильно меньше.
Самый большой прирост под конец
Уже под самый конец, когда казалось, что выжать больше нечего, следующая версия неожиданно дала почти 10%, хотя ни одной новой вычислительной идеи в ней не было. Я просто поменял, что main‑поток делает первым. Работа по блокам неравная, первые блоки самые тяжёлые, поэтому теперь main сначала забирает себе 15–16 самых тяжёлых блоков, потом уходит читать следующую матрицу, а если писать ещё некуда, возвращается и помогает остальным считать, чтобы никто не сидел без дела. Время упало с 698 до 629 мс.
Версия |
Медиана |
Что изменилось |
|---|---|---|
v5 |
~778 мс |
упаковка в биты, дедупликация, плотное ядро |
v10 |
~766 мс |
свой пул потоков: та же скорость, сильно меньше памяти |
v11 |
~728 мс |
параллельная транспозиция |
v15 |
~724 мс |
ядро 16×2 |
v17 |
~698 мс |
одна арена под матрицы, чтение поверх посчитанного |
v18 |
~629 мс |
main берёт тяжёлые блоки первым |
v19 |
626,5 мс |
загрузки с подсказкой кэша ( |
Итого с 778 до 626 мс при примерно 15 МБ памяти, причём из этих 626 мс около 545 приходится на чистый счёт, а ввод почти полностью спрятан за ним.
Как я сделал меньше работы, и стало медленнее
А теперь моя любимая история из всего соревнования, из‑за которой статья, собственно, так и называется. Я заметил, что многие строки хоть и не одинаковые, но почти одинаковые, и подумал: а зачем считать каждую заново, если можно посчитать одну, а для похожих на неё только разницу? Работы стало на 60% меньше, и я был прям доволен собой ровно до того момента, как отправил это решение на проверку и увидел, что оно стало медленнее, причём не на пару процентов, а заметно.
Сначала я, конечно, решил, что что‑то сломал, и всё перепроверил, но нет, всё правильно, просто медленнее. Дошло до меня не сразу. Старый вариант был тупой, но ровный: загрузил, сравнил, посчитал, сложил, и так миллиарды раз подряд, а такое компилятор раскладывает по широким командам идеально. В новом же появились проверки, прыжки по памяти и ветвления. Intel частично переварил бы это своим out‑of‑order, а на Эльбрусе, где шефа на кухне нет, всё это вылезает напрямую в виде пустых слотов.
С тех пор на Эльбрусе я сначала смотрю, насколько код ровный, и только потом считаю, сколько в нём операций. Сократить работу можно двумя способами, и результат у них противоположный: выбросить ненужное, не ломая структуру доступа к памяти, — это выигрыш, а заменить плотную работу на разреженную — на e2k почти всегда проигрыш.
Была и ещё одна неудача, которую я так и не смог объяснить: 128-битные операции, которые по идее должны быть вдвое быстрее, на одной из матриц дали 139 → 402 мс. Видимо, без разбора ассемблера широкий SIMD лучше не трогать, по крайней мере в этой задаче (в третьей, забегая вперёд, он мне очень даже помог).
В следующей части — свёртки сигналов через NTT без единого округления и карта на 78 миллионов клеток, которую не нужно строить. А в третьей — финал, где бот бежит по лабиринту наперегонки с соперником.
predpremi
Мой Мечтатель: «Оптимизация, кубок! Значит, и у меня в проектах есть такие места, где "меньше работы" сделает чудеса.»
Мой Валидатор: «Чудеса-то будут, но ты сначала посчитай, сколько стоит эта специфическая магия, и какой от неё реальный бизнес-эффект, а не только CPU-циклы.»
alex5885 Автор
Спасибо! Забавно, что как раз у меня «меньше работы» сделало только медленнее) а так да, сначала мерить, потом оптимизировать