Привет, Хабр! Мы — команда AI VK: Софья Гулевская, Михаил Трапезников, Александр Пославский и Александр Дьяконов. В этой статье расскажем, почему привычные методы прогнозирования времени просмотра не всегда справляются с короткими видео, какие проблемы возникают при обучении вероятностных моделей и как мы решили их с помощью HEGM — Hierarchical Exponential-Gaussian Mixture.
Покажем архитектуру, результаты экспериментов на открытых и промышленных данных, а также расскажем, что изменилось после A/B-тестирования на реальном трафике. Исследование принято в основной трек конференции IEEE ICDM 2026, а код и модели мы выложили в открытый доступ.
Почему недостаточно предсказывать время просмотра одним числом
В лентах коротких видео пользователь не выбирает ролик кликом — воспроизведение начинается автоматически. Поэтому CTR уже не так полезен для оценки интереса, как в классических рекомендательных системах. Гораздо больше информации даёт время просмотра (watch-time, WT).
Но одно число про это время говорит мало: два пользователя могут провести за просмотром одинаковое количество времени по совершенно разным причинам. Один досмотрел короткий ролик до конца, другой пролистал длинное видео через несколько секунд. Поведение в этих случаях принципиально разное, а точечный прогноз — один и тот же.
Чтобы учитывать эти различия, недостаточно предсказать одно число. Нужно оценить распределение возможного времени просмотра для конкретного пользователя и видео.
У распределения WT есть несколько характерных особенностей:
Инфляция около нуля (near-zero inflation): большое количество просмотров длится доли секунды, так как пользователи быстро пролистывают неинтересный контент.
Скос вправо (right skewness): распределение несимметрично, большинство наблюдений приходится на малые значения времени просмотра, но отдельные наблюдения могут принимать очень большие значения.
Тяжёлый хвост (long-tailed behavior): справа остаётся заметная масса. Её дают не только редкие очень долгие просмотры, но и сами моды досмотра, а у коротких роликов — пересмотры, уводящие время просмотра за всю длительность.
Мультимодальность: в поведении пользователей чётко выделяются разные режимы — быстрые скипы, частичные просмотры, полные досмотры и реплеи.
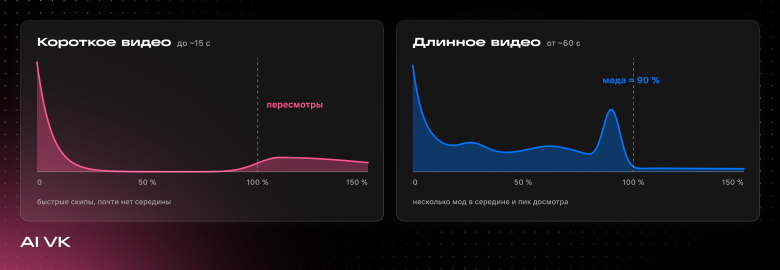
Отсюда и главная проблема точечного прогноза. Регрессия честно находит условное среднее, но при мультимодальном отклике эта точка попадает в провал между модами — туда, где не находится ни один реальный режим поведения. Это не ошибка обучения, а ошибка постановки задачи.
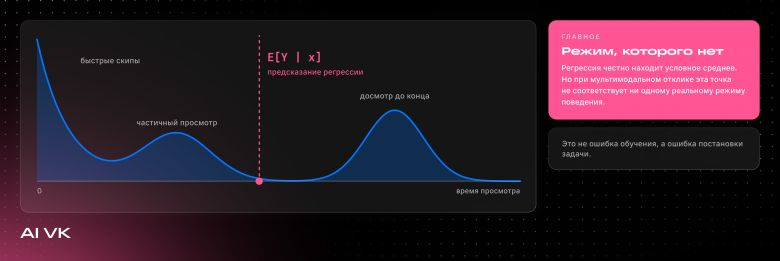
Стандартные методы регрессии, оптимизирующие среднеквадратичную (MSE) или среднюю абсолютную ошибку (MAE), сводят сложное распределение к одному числу. При оптимизации MSE модель стремится предсказать условное математическое ожидание, а при MAE — медиану. В обоих случаях мы теряем информацию о вероятности быстрого скипа, полного досмотра и других сценариев.
Плотность смеси
Поэтому вместо точечного прогноза мы рассматриваем моделирование условного распределения (distributional modeling), при котором модель оценивает плотность вероятности времени просмотра для пары «пользователь — видео». Удобное семейство для такой плотности — смесь: экспоненциальная компонента описывает массу быстрых скипов у нуля, а несколько гауссиан — режимы осмысленного просмотра.
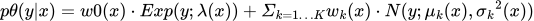 (1)
Здесь  — время просмотра,
 — признаки пары «пользователь — видео»,
 — экспоненциальное распределение со средним
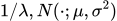 — нормальное распределение,
 — число гауссовых компонент. Веса неотрицательны и в сумме дают единицу. Все параметры смеси модель предсказывает для каждой пары отдельно — поэтому у каждого кандидата своя форма распределения.
Зачем предсказывать распределение вместо одного числа
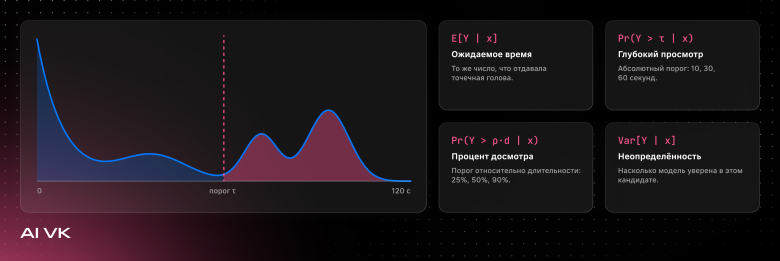
Если модель предсказывает не одно значение времени просмотра, а целое распределение вероятностей, из него можно получить сразу несколько сигналов для ранжирования без необходимости обучать отдельную нейросеть под каждый показатель:
Ожидаемое время просмотра (Expected WT) —
 , то же число, которое отдавала точечная голова.
Вероятность преодоления заданного порога (Deep Watch) —
 , например вероятность того, что пользователь будет смотреть ролик дольше 10 секунд.
Вероятность полного досмотра (Percentage Completion) — та же вероятность, но с порогом, заданным долей длительности ролика:
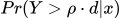 , где
 — длительность видео.
Предиктивная неопределённость (Predictive Uncertainty) —
 , насколько модель уверена в своём прогнозе. Этот сигнал может быть полезен для exploration-механизмов, которые помогают рекомендательной системе исследовать интересы пользователя.
Все эти величины — функционалы одной и той же плотности (1), они считаются аналитически, без дообучения и без отдельных голов под каждый порог.
Что ломается при обучении смеси?
Смесь (1) — это и есть устройство EGMN (Exponential-Gaussian Mixture Network), работы, с которой мы начинали. Все веса в ней раздаются одним общим softmax: экспонента и K гауссиан делят единый бюджет вероятности. Дальше мы будем называть такую конструкцию плоской смесью.
Проблемы, о которых пойдёт речь дальше, — не особенность конкретной реализации, а известные патологии смесей, обучаемых по максимуму правдоподобия. На академических датасетах они часто остаются незаметными, но на промышленном масштабе проявляются в полный рост.
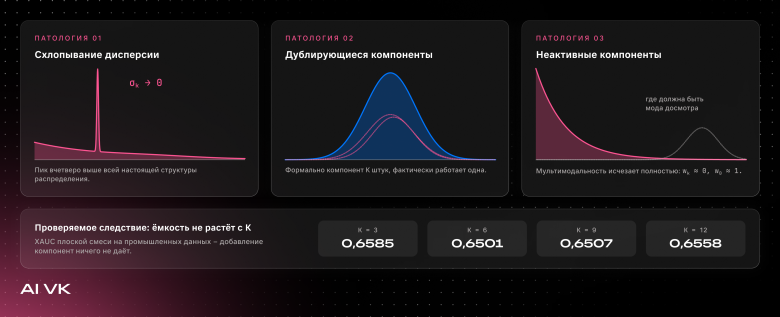
1. Схлопывание дисперсии (Gaussian Variance Collapse)
У смеси гауссиан правдоподобие не ограничено сверху. Достаточно посадить центр одной компоненты ровно на обучающий пример,  , и начать уменьшать её ширину
 : плотность в этой точке растёт неограниченно, а функция потерь — отрицательное логарифмическое правдоподобие,
 — уходит в минус бесконечность. Это не ошибка реализации или сбой оптимизации, а фундаментальная особенность постановки задачи.
На практике модель выдаёт узкие пики (спайки) вокруг отдельных значений времени просмотра — такой пик может быть в несколько раз выше всей настоящей структуры распределения. Фактически она начинает запоминать примеры из обучающей выборки, что ухудшает способность к обобщению.
2. Дублирующиеся компоненты
В процессе обучения несколько компонент могут сходиться к практически одинаковым параметрам:  ,
 . В результате они описывают одну и ту же область распределения и становятся функционально избыточными. При этом симметрия между компонентами не задаёт механизма, который гарантировал бы их разделение. В частности, компоненты могут концентрироваться вблизи одной и той же области, например около среднего значения экспоненциального распределения
 . Формально компонент
 штук, фактически работает одна.
У этого есть проверяемое следствие: ёмкость модели перестаёт расти с числом компонент. На промышленных данных XAUC плоской смеси почти не меняется при  = 3, 6, 9 и 12 — добавление гауссиан не даёт ничего.
3. Неактивные компоненты
Другая крайность — компоненты, которые просто выключаются:  при
 . Масса действительно сосредоточена у нуля, поэтому одной экспоненты хватает, чтобы объяснить её бо́льшую часть, — и выключить остальные компоненты для модели дешевле, чем научить их чему-то полезному.
В результате дорогая голова со множеством параметров по выразительности становится эквивалентна одной экспоненте, а мультимодальность исчезает полностью. По значению лосса это незаметно — нужно отдельно смотреть на веса компонент.
Напрашивающиеся решения проблему скорее переносят, чем снимают. Если привязать центры гауссиан к среднему экспоненты, сдвигая их на  , компоненты действительно расходятся — но их положение оказывается жёстко привязано к
 . Если добавить энтропийный штраф на веса, они перестают уходить в ноль — зато ожившая компонента выживает в виде иглы.
Общее следствие всех трёх патологий одно: правдоподобие перестаёт быть метрикой качества. Модель может уверенно улучшать NLL, уходя при этом всё дальше от осмысленного распределения, и результат сильно зависит от того, куда она попала на старте — сойдётся обучение к рабочей конфигурации или к вырожденной.
Именно это мы и увидели на промышленных данных: плоская смесь показала XAUC 0,6585 против 0,7070 у обычной MSE-регрессии. Более выразительная модель, которая теоретически должна описывать поведение пользователей лучше, на практике работала хуже простого скалярного прогноза.
Как мы устроили HEGM
Чтобы решить эти проблемы, мы разработали HEGM (Hierarchical Exponential-Gaussian Mixture). Метод сохраняет выразительность экспоненциально-гауссовской смеси, но делает обучение устойчивым.
В основе HEGM — три ключевых решения.
1. Иерархическое разделение скипов и просмотров
Вместо того чтобы складывать экспоненту и гауссианы в один общий softmax, мы разделили модель на два уровня. Сначала отдельный сигмоидный гейт оценивает вероятность быстрого скипа  , и только если скипа не произошло, включается смесь гауссиан:
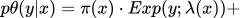
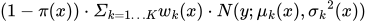 (2)
Это та же смесь (1), но веса в ней устроены иначе: экспонента получает  , гауссианы делят между собой оставшуюся массу
 , и их веса нормированы уже внутри своей ветки.
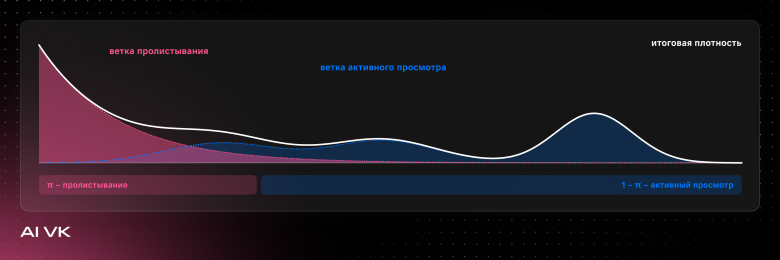
Так мы разделяем два разных типа поведения: быстрый отказ от контента и дальнейшее взаимодействие с ним. Это делает распределение более интерпретируемым и помогает модели не смешивать принципиально разные сценарии.
Но главный эффект — в другом: пропадает конкуренция между режимами. В плоской смеси экспонента и гауссианы делят один и тот же бюджет вероятности, и чтобы экспонента объяснила массу у нуля, ей приходится отбирать вес у остальных компонент — отсюда и выключенные гауссианы. В иерархии вся масса у нуля описывается только экспонентой, а K гауссиан делят между собой уже исключительно режимы осмысленного просмотра. Их веса нормированы внутри своей ветки, поэтому ветка просмотра не может выключиться целиком.
2. Инициализация компонент смеси
При случайной инициализации компоненты часто оказываются слишком близко друг к другу и сливаются в одну. Поэтому начальные параметры мы задаём не случайно. ВПеред началом обучения центры гауссовых компонент равномерно распределяются по всему диапазону допустимых значений: 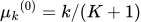 , Это обеспечивает начальное покрытие всего диапазона длительностей. Начальные ширины компонент задаются как
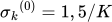 , что позволяет компонентам перекрываться и избегать чрезмерной локализации на начальном этапе обучения.
Экспоненциальная компонента инициализируется с параметром 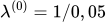 , что соответствует начальному математическому ожиданию, равному 5 % диапазона значений. Иными словами, на начальном этапе модель предполагает преимущественно короткие просмотры. Для рассматриваемого промышленного датасета это соответствует среднему времени около 9 секунд.
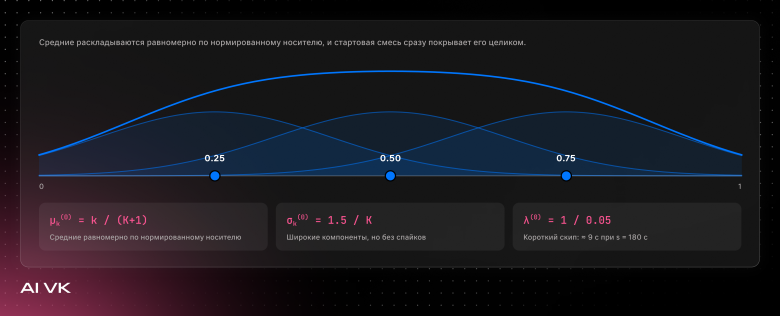
Это помогает стабилизировать первые этапы обучения и уменьшает риск слияния компонент.
3. KL-регуляризация дисперсии
Иерархия и инициализация снимают дублирование и вырождение, но от схлопывания не защищают: правдоподобие по-прежнему не ограничено. Когда компонент много, часть из них всё равно уходит в иглы. Для таких конфигураций мы добавляем приор на ширину компонент.
Диапазон длительностей роликов делится на M = 18 бакетов. Для каждого бакета по обучающим данным считается эмпирическая дисперсия времени просмотра. Дальше мы штрафуем расхождение между предсказанной компонентой и нормальным распределением с этим масштабом. Для двух нормальных распределений с одинаковым средним KL-расхождение зависит только от отношения дисперсий:
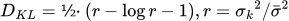 (3)
Итоговый штраф  — это среднее (3) по всем компонентам и объектам обучающей выборки.
У такого штрафа три полезных свойства. Во-первых, выражение (3) равно нулю при  и растёт в обе стороны: наказываются и слишком узкие компоненты, и слишком широкие, которые ничего не описывают. Во-вторых, оба распределения под
 делят одно и то же среднее, поэтому штраф трогает только ширину и не стягивает моды друг к другу. В-третьих, он опционален: при
 схлопывания нет и приор можно выключить, он нужен тогда, когда компонент много.
Это помогает избежать появления узких пиков и сохранить способность модели описывать несколько режимов просмотра. Выживают те компоненты, за которыми стоит реальный режим поведения: вырожденные подтягиваются к масштабу своего бакета, а положение мод штраф не трогает.
Итоговая функция потерь собирается из трёх слагаемых:
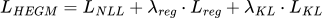 (4)
правдоподобие, MAE на ожидании (он калибрует точечную оценку — в ранжирование идёт именно  ) и опциональный приор на дисперсию с весом
 .
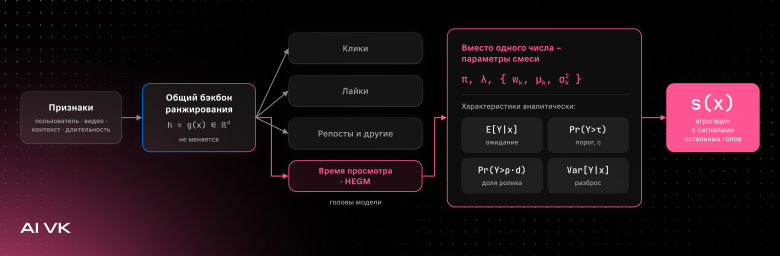
В результате HEGM сохраняет возможность описывать разные сценарии просмотра, но обучается устойчивее. При этом метод не зависит от основной архитектуры нейросети: это drop-in замена головы времени просмотра в multi-task ранкере. Общий бэкбон и остальные головы не меняются — меняется только то, что отдаёт голова WT: вместо одного числа это параметры смеси, из которых нужные сигналы считаются аналитически и дальше агрегируются в итоговый скор.
Проверяем HEGM на открытых и промышленных данных
Мы протестировали метод на двух публичных датасетах — KuaiRec и VK-LSVD, а также на внутреннем промышленном датасете из 282 млн пользовательских взаимодействий. Для оценки использовали хронологический сплит.
По метрике ранжирования XAUC HEGM превзошла все сравниваемые методы на каждом из трёх датасетов.
HEGM показала преимущество не только в ранжировании, но и в предсказании конкретных событий: для порога в 60 секунд ROC AUC составил 0,8903 против 0,8356 у плоской смеси. Это важно, поскольку одна модель может использоваться для получения сразу нескольких сигналов, необходимых рекомендательной системе.
Что произошло после запуска на реальном трафике
Мы интегрировали HEGM вместо существующей multi-task головы предсказания времени просмотра, которая отдавала точечный прогноз, сохранив остальную архитектуру ранкера.
A/B-тест продолжался полтора месяца и охватил 10% живого трафика: по 5% в тестовой и контрольной группах, около 11 млн запросов в день на каждую. Чтобы снизить влияние сезонности и эффекта новизны, использовали forward-reverse протокол: первый месяц шёл прямой тест, затем на две недели группы менялись местами — знак и величина эффекта на обеих фазах совпали. Статистическую значимость оценивали CUPED-скорректированными t-тестами на пользовательских агрегатах.
По сравнению с действующей production-моделью получили следующие результаты:
Среднее количество просмотренных видео за одну сессию выросло с 28,52 до 31,16. При этом общее время просмотра практически не изменилось. Модель, которая оптимизирует время просмотра напрямую, легко скатывается в duration bias: длинные ролики механически дают больше секунд просмотра, и ранкер начинает продвигать именно их, раздувая суммарное время.
Здесь этого не произошло. В том же бюджете времени пользователи успевают посмотреть больше роликов, реже бросают их в первые секунды, чаще делятся и реже ставят дизлайки. Это позволяет предположить, что рекомендации стали точнее попадать в интересы пользователей, а рост отдельных показателей вовлечённости пришёл из релевантности, а не из удержания.
Сколько стоит внедрение HEGM?
Несмотря на более сложную математическую модель, HEGM не требует полной перестройки рекомендательной системы. Мы заменили существующую голову предсказания времени просмотра, сохранив основную архитектуру ранкера.
Дополнительная медианная задержка составила 1,22 мс, а p99 вырос с 7,9 до 8,2 мс — при установленном для ранкера лимите в 30 мс на p99.
Таким образом, повышение точности прогнозов не потребовало существенного увеличения времени обработки запросов — важное условие для рекомендательных систем, работающих с миллионами запросов в день.
Где ещё можно использовать HEGM?
Мы разрабатывали HEGM как общую голову для распределения времени взаимодействия, а тестировали — на рекомендациях коротких видео. Подход не привязан к конкретной архитектуре нейросети и применим в других задачах, где важно прогнозировать продолжительность взаимодействия пользователя с контентом.
Например, в музыкальных стримингах аналогичный подход можно адаптировать для оценки вероятности пропуска трека, полного прослушивания или повтора. В рекламных системах — для прогнозирования длительности просмотра видеорекламы, а в стримингах — для оценки вероятности досмотра контента.
Для таких сценариев потребуется адаптация модели к особенностям данных и отдельная экспериментальная проверка.
Главное преимущество подхода — возможность получать несколько сигналов из одного предсказанного распределения, не обучая отдельную модель под каждый показатель.
Выводы
Наши эксперименты показали, что для предсказания времени просмотра важно не только выбрать подходящее семейство распределений, но и обеспечить устойчивость обучения. Без этого более сложная вероятностная модель может уступать обычной регрессии.
HEGM позволила снять патологии смесей и улучшить качество рекомендаций на реальном трафике без существенного увеличения задержки.
Мы открыли код и модели на GitHub, чтобы другие команды могли воспроизвести эксперименты и попробовать HEGM на своих данных. Подробности архитектуры и результатов — в нашей научной статье, принятой на IEEE ICDM 2026.
Truespb
А зачем это вообще?
Зачем эти измерения/метрики? Какой в них смысл?