
Если энергопотребление ЦОДов будет и дальше расти, то для них придётся выкупать мощности АЭС, как это сделали Microsoft и Amazon. Но должен быть другой выход. Поэтому есть большая потребность в энергоэффективных CPU.
Год назад стартап Efficient Computer представил «самый энергоэффективный в мире» процессор Electron E1. Разработчики попытались заново изобрести универсальный CPU, ориентируясь именно на энергоэффективность. Правда, конкретно этот CPU предназначен для embedded-систем, но схожую архитектуру применяют и для ЦОДов.
Новый CPU в 10–100 раз эффективнее ARM на типичных embedded-задачах, таких как быстрое преобразование Фурье (по данным с сенсоров) или выполнение свёрток (вычисление карты признаков) в свёрточных нейросетях.
Сейчас E1 и компилятор проходят тестирование среди разработчиков. Участники закрытой программы тестирования могут проверить свой код C и C++ в веб-песочнице, оценить его энергоэффективность на новом CPU.
Бутылочное горлышко фон Неймана
Большинство современных компьютеров построено на архитектуре фон Неймана, которая разделяет вычисления и память. Эта схема идеальна для традиционных вычислений, но становится бутылочным горлышком в типичных операциях нейронок, таких как перемножение матриц. Термин «бутылочное горлышко фон Неймана» впервые использовали в 1977 году, но сейчас проблема стала действительно актуальной на аппаратном уровне.
Поэтому ощущается спрос на новое, специализированное железо, которое будет эффективнее, чем существующие CPU и GPU. Процессоры нового поколения не просто заточены на новый тип вычислений, но и реализуют принципиально новую архитектуру, отличную от классической фоннеймановской.
И эта архитектура позволяет кардинально уменьшить энергопотребление вычислительных систем, потому что сводит к минимуму перемещение данных между CPU и памятью.
Современные CPU хорошо подходят для дискретных вычислений. Они выполняют инструкцию, отправляют данные в память — и быстро переключаются на другую несвязанную задачу. Но в приложениях ML почти все задачи взаимосвязаны, поэтому зачастую нет другой работы, которую можно было бы выполнить, пока CPU находится в ожидании. Вот почему единственным выходом некоторые исследователи видят оптимизацию архитектуры.
Передача инструкций последовательно из памяти связана с большим количеством накладных расходов. Если несколько миллиардов раз в секунду извлекать инструкцию из памяти, выполнять декодирование, переупорядочивание, переименование регистров и т. д., это требует немало энергии. А чтобы предотвратить заторы, современным CPU необходимо предсказание ветвлений — а это ещё больше энергии.
Вместо этого E1 отображает последовательность инструкций в виде пространственного пути, по которому «движутся» данные на процессоре, от одной плитки к другой.
Плитки E1

Каждая плитка E1 похожа на упрощённое процессорное ядро — она способна выполнять набор инструкций, но без выборки, предсказания ветвлений и других накладных расходов. Плитки соединены друг с другом в специально разработанную, программируемую сеть Fabric. Таким образом, скомпилированная программа пространственно распределена по поверхности чипа.

E1 относится к классу CGRA (Coarse-Grained Reconfigurable Architecture) или пространственным потоковым процессорам (Spatial Dataflow Processors). В них память находится близко к вычислителям (Near-Memory/Distributed SRAM), а вычисления происходят в логических блоках (ALU/плитках).
Это похоже на FPGA (программируемые пользователем вентильные матрицы), только с ячейками большего размера. Похожий подход использовала компания GreenArray в разработке экзотического процессора GA144, но он не получил известности. Вообще, методы «потоковой архитектуры» (Dataflow/CGRA) теоретически описаны ещё в начале 1980-х.
Разработчики E1 — группа инженеров под руководством Брэндона Люсии, это исполнительный директор и сооснователь Efficient Computer.

Компилятор для E1
Некоторые хабрапользователи поиграли в веб-песочнице Compiler Playground и попробовали программировать под E1. Compiler Playground показывает, как работает фирменный компилятор effcc и как будет исполняться реальный код на E1. Программирование для этой архитектуры не требует особых навыков, обычный код оптимизируется автоматически. Как сказано в документации, здесь проприетарный слой оптимизации Modular Optimization Framework выбирает самую оптимальную стратегию параллелизации, чтобы минимизировать количество тактов. От программиста ничего не требуется, только выделить отдельные функции, которые он хочет перенести на Fabric (пометить их отдельным атрибутом).
Главное отличие effcc — то, что он раскладывает выполнение программы не только во времени, но и в пространстве, по площади микросхемы. Компилятор назначает каждой инструкции в программе плитку. Затем настраивает сеть так, чтобы данные поступали в одну плитку, обрабатывались — а результат становился входом для следующей плитки, всё в правильной последовательности для выполнения программы. Когда последовательность разветвляется (if/then/else) — соответственно меняется и пространственный узор плиток:

Итоговый результат при необходимости можно подправить вручную.
Компилятор принимает С и С++, а также импортирует модели LiteRT и ONNX, распараллеливает инструкции под E1 и показывает, сколько тактов займёт выполнение каждой команды; скриншоты ниже взяты из упомянутой статьи:

Инструмент оценивает энергоэффективность выполнения программы на процессорах разных архитектур. Для наглядности показывают время работы CPU от батарейки АА при выполнении конкретной программы на разных архитектурах:

Понятно, что CPU составляет только часть от энергопотребления устройства, поэтому пример условный. Но довольно любопытно взглянуть, сколько джоулей «съедает» каждая функция.
Песочница Compiler Playground доступна для одобренных разработчиков, которые подали заявку по программе Early Access Program:

Потоковая архитектура
Efficient Computer не изобрёл потоковую архитектуру. Другие компании использовали её и раньше в своих инновационных чипах. Например, TPU от Google и чипы Inferentia от Amazon разработаны на потоковой передаче данных, а именно — на систолическом массиве (systolic array).

В IBM Research тоже работают над аналогичными процессорами NorthPole, где пробуют разные стратегии, чтобы преодолеть узкое место архитектуры фон Неймана и ускорить вычисления ИИ.

Но у всех них есть архитектурные ограничения по количеству ветвлений. В Е1 такие ограничения отсутствуют, говорят разработчики.
Сетевая структура E1 позволяет использовать любой произвольный путь, который может запросить программа. Речь идёт о поддержке произвольных рекурсий, как цикл while. Такие циклы требуют обратной связи. Система Fabric может передавать значения по путям обратной связи таким образом, что это позволяет выполнять вычисления общего назначения. Другие потоковые архитектуры не подходят для универсальных CPU, потому что не смогли решить эту задачу, которую решили Люсия с коллегами в результате нескольких лет научно-исследовательской работы.
Основные энергетические затраты в работе ИИ приходятся на передачу данных — перемещение весов модели туда и обратно между памятью и процессором. В сравнении с ними энергия на вычисления невелика, и они довольно простые, вроде умножения матриц на векторы.
До бума LLM архитектура фон Неймана не считалась проблемой, а бутылочное горлышко компенсировали многоуровневыми кэшами. За последние десятилетия мощность CPU и объём памяти сильно выросли, а энергия на передачу данных осталась без изменений, так что сейчас это бутылочное горлышко системы. И обучение, и инференс LLM можно сильно оптимизировать, если избавиться от этого недостатка.
Сейчас вся индустрия работает над тем, чтобы улучшить локализацию данных, то есть переместить память как можно ближе к CPU, максимально совместив хранение и обработку данных.

Кстати, несколько дней назад стало известно о ещё одном стартапе Positron, который тоже привлекает инвестиции и обещает выпустить процессор нового поколения для ИИ-вычислений. WSJ пишет, что Positron уже привлёк $875 млн инвестиций при оценке $5 млрд. Их флагманский процессор называется Asimov, он тоже спроектирован по архитектуре «memory-first» и поддерживает до 2,3 ТБ памяти.
Electron E1 Evaluation Kit (EVK)
Возвращаясь к Efficient Computer, участникам программы тестирования высылается отладочный комплект Electron E1 Evaluation Kit, чтобы оценить реальное железо, которое уже физически выпускается на заводах, в отличие от чипов Asimov и прочих экспериментальных образцов.

На плате установлены разъёмы стандартного форм-фактора Arduino и все остальные необходимые слоты, чтобы собрать нормальную периферию.
По идее, сверхнизкое энергопотребление CPU намекает на его предпочтительное использование «в поле», то есть в edge-системах, когда нужны вычисления ML на внешних офлайновых системах, которые могут годами работать от батарейки: в промышленных роботах, автомобилях, носимых гаджетах, космических компьютерах.

Теоретически, спрос на энергоэффективные вычисления есть и в серверах, ЦОДах, персональных компьютерах. Так что ещё неизвестно, какие применения найдёт новая архитектура и новые процессоры.
Новая архитектура и новые процессоры
По мнению независимых экспертов, такие сверхэнергоэффективные CPU общего назначения испытывают конкуренцию на рынке со стороны микроконтроллеров. Несмотря на инновационную архитектуру, им трудно конкурировать в нише embedded-систем. Может, Efficient Computer ориентируется на дата-центры, где спрос огромный.
Конечно, и архитектура фон Неймана тоже никуда не исчезнет. Хотя для LLM она не оптимальная, но отлично подходит для других приложений, для обработки компьютерной графики или прочих ресурсоёмких процессов, а также для вычислений 32- или 64-битной точности.
Однако мы видим, что переход человечества на ИИ-вычисления породил целое поколение новых процессоров на принципиально иной архитектуре «memory-first» с пространственной потоковой обработкой данных (Spatial Dataflow). Спрос рождает предложение, то ли ещё будет.
© 2026 ООО «МТ ФИНАНС»
Комментарии (39)


Brak0del
23.09.2026 09:18Главное отличие effcc — то, что он раскладывает выполнение программы не только во времени, но и в пространстве, по площади микросхемы.
К слову, есть и другие стартапы с подобной идеей. Например, NextSilicon Maverick (ссылки: 1, 2). Там just-in-time компилятор раскладывает граф вычислений на потоковые процессоры и в ходе выполнения в зависимости от телеметрии перенастраивает чип, докидывая потоковые процессоры на наиболее интенсивные задачи (распределяет задачу на большее количество выч. блоков).

ThJudge
23.09.2026 09:18Ну тут все-же больше сдвиг к in-memory вычислениям. Потоки как бы хорош не раскладывай все-равно упираешься в проблему того что данные нужно еще считать прежде чем вычислять. А тут поток данных получается напрямую от ядра к ядру, причем к ближайшему подходящему соседу, т.е. данные кидаются сразу туда, где будут нужны в следующем цикле вычислений. Это прям хорошо.
Brak0del
23.09.2026 09:18Потоки как бы хорош не раскладывай все-равно упираешься в проблему того что данные нужно еще считать прежде чем вычислять.
Нет, не потоки, а потоковые процессоры, dataflow processors, как и в основной статье. Фактически набор АЛУ, динамически конфигурируемых и объединяемых в зависимости от графа вычислений, и передающих результаты следующим АЛУ.
ThJudge
23.09.2026 09:18Что-то я честно говоря еще раз прочитал и все-равно в вашем примере не увидил про данные. В Электроне я так понял шина данных работает преимущественно между ядрами минимизируя обращение к общему пулу памяти (тот самый bottleneck) а в Мэверике шина данных все-же общая и ядра обмениваются данными через нее. Я не прав?
Brak0del
23.09.2026 09:18Вроде не правы. Поясню подробнее.
В Мэверике есть Compute Block (CB) -- это сущность состоящая из N АЛУ (N = 224 на картинках в статьях и до тысяч в маркетинговых статьях). CB имеет точки входа/выхода в память: подключен к шине памяти через станции резервирования (наверно там алгоритм Томасуло у них).
Внутри CB находится сеть конфигурируемых АЛУ, которые можно компоновать в райнтайме в зависимости от задачи. Внутри CB доступа к памяти нет, данные поступают от одного АЛУ к следующим по мере готовности, это классическая dataflow архитектура. Теперь сравните CB с сущностью Fabric Processor (с плитками АЛУ) у Электрона. Набор инструкций/операций и там и там отображается на пространственный путь (на граф из сотен или тысяч АЛУ). По окончании этого пути результаты попадают: в случае Мэверика на станцию резервирования и необязательно, но, если необходимо, на точки входа в память; в случае Электрона -- в banked cache/sram/NVM.
Как понял, принципиальная разница в том, что Электрон нацелен на низкое энергопотребление, эмбед и статическую компиляцию, а Мэверик на HPC и оптимизацию в рантайме.


ksbes
23.09.2026 09:18Это архитектура типа “аналоговых вычислительных залов” где люди сидели за столами и карточки друг другу с результатами передавали?


Aliandwa
23.09.2026 09:18Мне кажется, что будущее за фотонными процессорами и размещением ячеек памяти в непосредственной близости с вычислительными блоками. Типа оперативки целиком из кэша первого уровня.

gvitaly
23.09.2026 09:18будущее за фотонными процессорами
Есть идеи, как реализовать трехмерную топологию (волноводы заданной длины и отражатели) в куске идеально чистого стекла?
ThJudge
23.09.2026 09:18Да вроде прям в куске чтоб все и не планируется. Не слышал такого Есть вполне традиционные способы чуть ли не литографией, только в слоях не кремний и прочие материалы (хотя какая-то часть их и будет) а оптические мета-материалы в заданных конфигурациях. По сути обычная структура только вместо электричества свет пускают по полученным "лабиринтам". И многослойность здесь более уместна так как нагрев будет сильно меньше. Поэтому будущий "отптический куб" будет просто стопкой отдельных "стеклянных" чипов

CrashLogger
23.09.2026 09:18Получается, волноводы заменят металлические провода ? Но логические функции то все равно будет выполнять кремний. Тогда это не спасет от нагрева - ведь в чипе основная часть тепла выделяется при переключении транзистора из 1 в 0 и обратно. В металле и так потери минимальные.
ksbes
23.09.2026 09:18Логика там идёт не обязательно на транзисторах. Вполне себе есть системы свет-свет. Или свет-ЭМ-свет. Всё обещают гигантское быстродествие при отсутвии нагрева. Но пока что-то сложнее сложения без переноса я в “стекле” не видел.
CrashLogger
23.09.2026 09:18А как это работает ? Свет - это волна. Волны проходят друг через друга не взаимодействуя.
ThJudge
23.09.2026 09:18Что касается "проходят друг через друга" - это одна из фич, одновременно можно несколько пучков на разных частотах пускать по пересекающимся путям каждый пучок своей частоты внутри волноводов при этом выполняет свои вычисления. Насчет не взаимодействуют - они не с собой взаимодействуют, а с оптическими материалами, которые их могут преломлять, задерживать, отклонять, менять фазу и т.п причем свойства этих элементов тоже могут управляться как светом так и более традиционным способом - изменением электрического потенциала возле него. Сложность сейчас не в самой компоновке, это не сложнее чем для обычных чипов, сложность как-раз в материалах с нужными свойствами. Как товарищ выше написал, пока довольно мало рабочих элементов создано в реале. Но принципиальных преград нет, они уже "на бумаге" все типы логических элементов вроде сделали, физика вроде позволяет, а новые материалы разрабатывают довольно быстро.Так что может и выгорит.
ksbes
23.09.2026 09:18Свет - это волна. Волны проходят друг через друга не взаимодействуя.
Есть нелинейные материалы. Даже воздух при определённых условиях становится нелинейным - это, например, приводит к автофокусировке мощных лазеров. Соответсвенно нелинейность можно использовать для того чтобы волны всё же друг с другом провзаимодействовали.
gvitaly
23.09.2026 09:18А как сделать диагональное зеркало между слоями, чтобы поднять сигнал с нижнего уровня на верхний, но чтоб без "лесенки"? Слои должны быть ну очень тоненькими. Напылять такое придется вечность. При напылении также необходимо не "засорить" уже готовые волноводы на нижних слоях. Как вот это реализовать вообще?
Ну или как вариант нарезать из какого-нибудь светоотражающего графена нано-трафареты, а потом их накладывать друг на друга. Да так, чтобы всё точно совпало. Опять же, их толщина должна быть очень маленькой, чтоб не было "ступенек" на зеркалах между уровнями. Сколько времени займет такой процесс...
Я же больше размышлял про гравировку в стекле. Но чтобы "выгравировать" в нем топологию без тех же "лесенок", нужно очень тонко фокусировать гравирующий лазер. Изготовление одного "чипа" займет не меньшую вечность.
Да и сам "чип", кстати, будет немаленьким. Если использовать свойство интерференции для "оптических транзисторов", то длины волноводов должны быть кратны длине волны рабочего света. То есть минимальная длина - десятки и сотни нанометров, в зависимости от применяемого лазера.
ksbes
23.09.2026 09:18А как сделать диагональное зеркало между слоями, чтобы поднять сигнал с нижнего уровня на верхний, но чтоб без “лесенки”?
Зачем? Вы слашели о таком чуде инженерной мысли как “световод”? Достаточно просто стеклянный цилиндрик “напылить” - так же как делают медные штырки в традиционных микросхемах.
gvitaly
23.09.2026 09:18Зачем?
Для начала объясню про "лесенки". Может я словами не очень понятно выражаюсь, поэтому покажу картинки.
Боковой вертикальный разрез оптического "чипа"
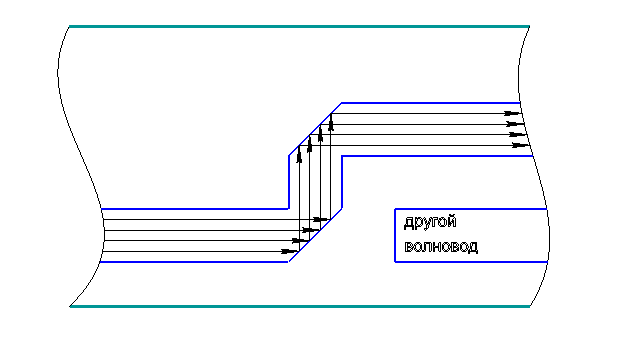
Нам надо перевести сигнал с нижнего уровня на верхний. Например, чтоб обогнуть другой волновод (да, я знаю, что лучи проходят сквозь друг друга, но мало ли). Или чтоб получить "подкачку" снизу для усиления затухающего сигнала. Короче, топология процессора сложная, одного уровня может и не хватить. Для этого и требуется диагональное зеркало.
Боковой вертикальный разрез оптического "чипа", изготовленного послойно
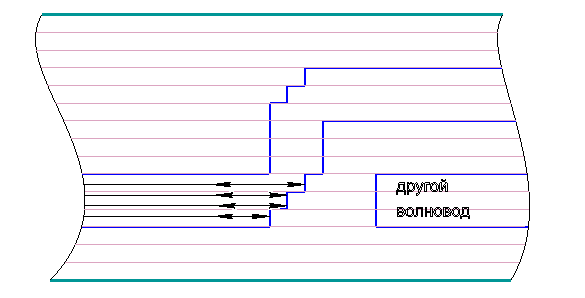
Вот мы изготовили чип послойно. Но если толщина слоя большая, то диагональное зеркало превращается в лесенку и перестает правильно работать. Вот и проблема.
Одна из проблем, конечно же.
А теперь, собственно, вопрос к Вам: покажите, как в Вашем случае сделать волновод, чтобы перевести оптический сигнал с нижнего уровня на верхний?
ThJudge
23.09.2026 09:18Более реалистично выглядит как-раз отказ от оперативки как отдельного устройства просто тупо для хранения. Сейчас есть вполне работающие прототипы когда вычисления реализуются в самой памяти.
Или, самый предельный случай - программа перегоняется в топологию и травится на чипе. Т.е. архитектура чипа сама является памятью. Правда в текущих вариантах это ROM, а не RAM. И это нишевые решения, конечно.

WASD1
23.09.2026 09:18Всё ровно наоборот по сравнению с тем, что вы пишите в "объяснении", например:
Современные CPU хорошо подходят для дискретных вычислений. Они выполняют инструкцию, отправляют данные в память — и быстро переключаются на другую несвязанную задачу. Но в приложениях ML почти все задачи взаимосвязаны, поэтому зачастую нет другой работы, которую можно было бы выполнить, пока CPU находится в ожидании. Вот почему единственным выходом некоторые исследователи видят оптимизацию архитектуры.
"Современные CPU ... Они выполняют инструкцию, отправляют данные в память — и быстро переключаются на другую несвязанную задачу." - неверно так работают GPU (переключаясь на другую задачу), CPU же наоборот (механызмы OoO, registers renaming, speculative execution) пытаются выбрать ИЗ ТЕКУЩЕГО ПОТОКА ИСПОЛНЕНИЯ что ещё можно исполнить.
"Но в приложениях ML почти все задачи взаимосвязаны, поэтому зачастую нет другой работы, которую можно было бы выполнить" - ронвно наоборот. ML запускается на GP GPU именно потому, что там есть ОЧЕНЬ БОЛЬШАЯ независимость по данным между разными потоками и warps (группы потоков). Посмотрите хотя бы на (классический) способ тайлового умножения матриц cutlas.

LinkToOS
23.09.2026 09:18На FPGA можно сделать процессор любой архитектуры, с любым набором команд, в том числе нестандартных. Это все что надо знать, чтобы понять принцип работы этого процессора.
Здесь FPGA обвязали традиционными узлами процессора - для кеширования и предсказание ветвлений, для обмена с памятью и периферией. Потому что это по любому нужно во всех случаях, и нерационально делать эти узлы на FPGA.
ThJudge
23.09.2026 09:18В FPGA насколько я помню с быстрой памятью вообще отдельные проблемы. Сам не имел дела, знакомый ругался.
И вообще тут говориться о динамическом изменении топологии графа передачи данных и типа (функции) вычислительных блоков в процессе работы. Насколько тоже помню FPGA на ходу свою структуру не меняет, для каждого изменения он должен уходить в перезагрузку и закачивать в себя новую конфигурацию. А тут именно что структура меняется В ПРОЦЕССЕ вычислений подстраиваясь под программу (правда пока это сделано отдельным компилятором). И это конечно вообще другой тип гибкости.LinkToOS
23.09.2026 09:18Насколько тоже помню FPGA на ходу свою структуру не меняет, для каждого изменения он должен уходить в перезагрузку
В обычных FPGA это так. Но это не обязательное свойство для FPGA. Механизм конфигурирования можно сделать любым. Можно сделать без перезагрузки, отдельно для любого участка FPGA, конфигурировать сразу группу по 64 блока в соответствии с форматом данных. Это вопрос конкретной реализации.
А тут именно что структура меняется В ПРОЦЕССЕ вычислений подстраиваясь под программу
Это по сути макрокоманда, которая синтезируется при компиляции. Участок кода из нескольких команд организуется в одну макрокоманду, где каждая "плитка" будет выполнять одну операцию. Допустим три последовательный команды в исходном коде, будет преобразованы в одну команду, которая сконфигурирует три "плитки" расположенных последовательно на выполнение этих трех команд. В цикле это даст большой эффект.

SmartTherm
23.09.2026 09:18Новый CPU в 10–100 раз эффективнее ARM на типичных embedded-задачах, таких как быстрое преобразование Фурье (по данным с сенсоров) или выполнение свёрток (вычисление карты признаков) в свёрточных нейросетях.
эффективнее в операциях в секунду, в ваттах на операцию или в чём?
типичная embedded-задача это дрыгать ногой/моргать светодиодом и смотреть как дрыгается входная нога
участникам программы тестирования высылается отладочный комплект Electron E1 Evaluation Kit, чтобы оценить реальное железо, которое уже физически выпускается на заводах, в отличие от чипов Asimov и прочих экспериментальных образцов.
На плате установлены разъёмы стандартного форм-фактора Arduino и все остальные необходимые слоты, чтобы собрать нормальную периферию.для выполнения п2 поставили аж две кнопки и два светодиода, что там стоит из того, с чего надо делать БФП или двумерное БФП - чет не видно
WASD1
23.09.2026 09:18Поскольку из статьи ничего не понятно - спросит gemini что содержательного скрывается за "пост фон-неймановскими архитектурами" и за Electron E1 в частности.
То, что инженеры называют "преодолением CPU-memory wall" - академики называют "пост фон-нэйман (ну звучит-то круче)", хотя часто это вообще безсодержательный термин (кажется в том числе в данном случае).X в 100 раз эффективнее CPU - это всегда маркетинговый обман. Который достигается или за счёт узкопрофилированной задачи (у нас уже есть GPU, NPU, TPU в 100-1000 раз эффективнее), или за счёт упрощения ядра, т.к. по энергопотреблению на FLOP: P-cores << E-cores << microcontroller cores << "cuda-cores" << MMA-cores......
Что из себя представляет архитектура (подход называется CGRA) - набор "маленьких" ядер связанных в сеть (обычно 2D-MESH) + каналы между ядрами.
-
ЕСЛИ задача подходит - компилятор строит пайплайн из ядер (желательно чтобы они были соседними) - первое ядро вычитывает данные из памяти, а дальше они текут по конвейру.
-
Особо продвинутые компиляторы умеют строить графы.
Что будет если граф нормально не ложится на MESH? Будет плохо: просадка по пропускной способности и\или по площади (ядрышко 100% времени будет работать как арбитра трафика)
Что будет если задача плохо ложится на "крупные data-flow" (когда данные потребляемые ядром-3 ВСЕГДА проходят сначала через ядро 2 и 1) - будет плохо.
-
Что происходит если мы соединили 2 ядра, при этом нагрузка несбалансирована (на одно ядро приходится в 1.5 раза больше вычислений чем на второе)? - Одно из ядер простаивает 50% времени.
-
Чем это лучше GP GPU (cuda):
вы читаете из памяти 1 раз, потом передаётся на ядро №2, потом на ядро №3.... Много ли это эффективности?
-
Чем это хуже GP GPU:
В этой архитектуре есть ограниченная ёмкость памяти, если задача в неё не умещается - до свидания, больших кэшей, вариантов скинуть в DDR временно ненужное и т.д. нет.
В целом для "задач размером с чип" - можно сэкономить 30% площади и 50% мощности (в сравнении с GPU) на том, что процессоры общаются не через память, а напрямую.Если задача плохо ложится на MESH, или слишком большая или слишком маленькая - горе вам. Либо не запустится, либо будет хуже чем на альтернативных вычислителях.
В целом так.


itoolsy
23.09.2026 09:18Существует 14 конкурирующих стандартов.
«Это нелепо! Нам нужен один универсальный стандарт, который покроет все потребности!»
Существует 15 конкурирующих стандартов.ThJudge
23.09.2026 09:18Давайте автопрому скажем - фиг ли вы свои все эти сотни моделей выпускаете? Давайте выпускайте вот грузовик, трактор, автобус и седан. Минивэн - нафиг! Электрокар - нафиг! Баловство это все! Кто-то там хочет самосвал? Ишь ты, что удумал, стандарты нам тут разводит новые. Фигу!

musicman3
23.09.2026 09:18Пока что на мой взгляд, перспективнее выглядят AI-сопроцессоры, резервирующие часть ОЗУ напрямую под себя при условной задаче, и работающие с зарезервированной памятью напрямую. Мне кажется это более реальный путь, так как отказаться от нынешних популярных архитектур будет очень не просто. Встраивать AI-функции в ЦП конечно тоже хорошо, но там сильно не разгонишься, и нужен отдельных взрослый чип... С другой стороны видеокарты практически и являются таким сопроцессором, с тем лишь минусом, что если не хватает сверхбыстрой памяти в карте, то для работы модели нужно кидать часть данных в более медленное ОЗУ, гонять данные через ОЗУ, шину и ЦП, а это сильно снижает итоговый профит. А отдельный AI-сопроцессор мог бы прилично так помочь, работая напрямую с зарезервированным ОЗУ и профит был бы гораздо выше, а для обыденных компьютеров без дискретного GPU задачи AI-типа решались бы гораздо бодрее.
ThJudge
Ну наконец-то движуха пошла на альтернативные процессорные архитектуры. А то решать многие задачи на "фон Неймане" также эффективно как переплыть океан на чугунной ванне или продолбить стену черствым батоном. Можно, конечно, но очень неэффективно (а с точки зрения затрат энергии суммарно - вообще "швах"). Как начинаешь алгоритмы разбирать где-б еще производительность выжать, особенно в высокопараллельных задач, часто упираешься в работу с памятью и в неэффективное хранение и выборку самих инструкций из памяти.