

Пришел Иванушка к камню, а на камне написано: data ocean, data lake, шлюз, канал, flood, pipeline/pipe, утечка, bridge и многие другие. И подумал Иванушка: «Это кто ж налил столько воды...»
Предлагаю вместе поговорить про воду в названиях круговорота данных. Я начну, а вас всех приглашаю помочь продолжить, так как это незавершенная работа, а приглашение к совместному исследованию прошлого, которое нашло отражение в будущем. Есть очень много специальных областей, про которые я только слышал, но не являюсь экспертом, и мне очень нужны все названия, чтобы сделать полную карту.
Сказка
Сначала нужно сказать про облака/cloud, тем более что тема с ЦОД сейчас предельно актуальная. Облака у нас белогривые лошадки, которые пьют, как лошади, а иногда и ржут над нами с высоты своего небесного видения. Пьют как лошади это в самом прямом смысле: дождевые облака — это миллионы литров; грозовые — десятки миллионов; а протяженные слоистые — сотни миллионов литров. Сотни миллионов, Карл!
Давайте теперь к этим облакам подключим нормальную энергетику и поставим Firewall / огненную стену, куда ж без неё. И в природе это будет огненная стена и энергетика в прямом смысле — стена из молний. И это сотни и тысячи миллионов джоулей, разность потенциалов на её пути — вплоть до сотен миллионов и миллиарда вольт, а сила тока — до 200 000 Ампер и больше. Молния — огонь и электричество!
После Firewall начинаются реки дождей или каналов (channels). По этим channels устремляются потоки (flows), вплоть до точки привязки — шлюза.
От шлюза трафик стекается по линкам (links), проходящим извилистыми маршрутами до озера данных (data lake).
Откуда по трубам (pipeline) заполненный поток (flood) растекается на свои источники (sources).
И каждый источник (source) связан со своей решеткой/сеткой/матрицей (frame), которая задает форму исходящим данным, откуда сформированными их можно забрать на мост (bridge).
От моста (bridge) данные воспаряют, каждое в своих потоках (streams) или парах (steam).
И собираются в точке‑зеркале (mirror) или она же водная гладь, в которой видно отражение. А уже оттуда начинают скапливаться в огромный облачный резервуар — облако.
Теперь вы прослушали полный курс круговорота воды/данных в природе.
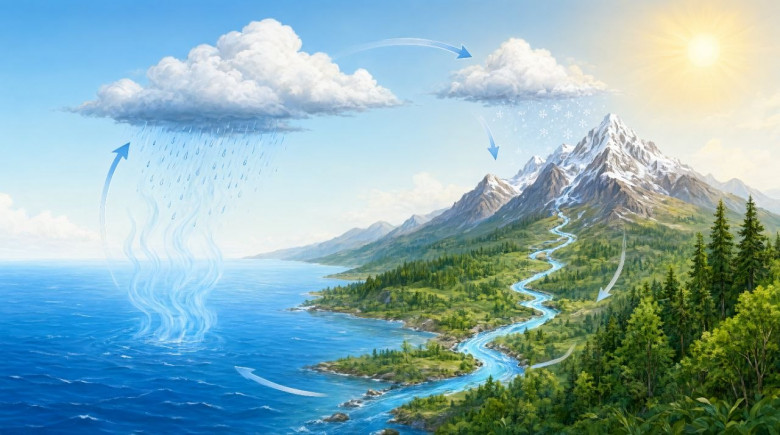
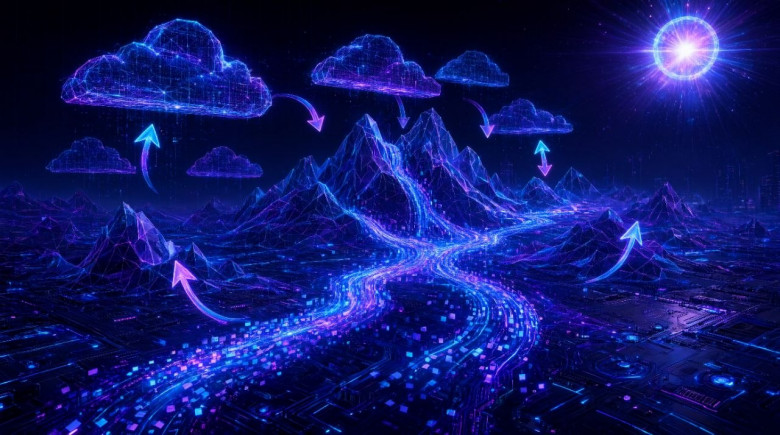
P. S. Последовательности переходов названий выдуманы, но сами названия поразительно текучи. Кажется, что кто‑то придумывал все интернет‑названия, связывая всё по образу и подобию водных систем.
P.P. S. Названия собраны больше в «поэтичном» или «сказочном» порядке, но при этом есть ещё куча названий, и когда‑нибудь, с вашей помощью, мы их соберем как надо.
nurix
Отличная идея, накидаю в озеро:
sink — сток. Раз есть source, должен быть и сток, иначе озеро переполнится)
leaky bucket — дырявое ведро, классический алгоритм ограничения скорости. Ведро, которое течёт специально
bucket вообще — в S3 данные хранят буквально в вёдрах
pool — бассейн соединений и потоков
backpressure — противодавление, прямо из гидравлики. Когда потребитель не успевает и поток упирается обратно
high watermark — отметка уровня воды, в стриминге и очередях
upstream / downstream — вверх и вниз по течению
drain — слив, так узел в Kubernetes выводят из работы
spill to disk — когда в памяти не поместилось и выплеснулось на диск
memory leak и buffer overflow — протечка и перелив, классика сантехники)
data swamp — то, во что превращается data lake без присмотра
И бонусом — waterfall, водопад. Только это уже не про данные, а про то, как их проект падает вниз по этапам)