

Эта статья — реинкарнация моего выступления на конфе GoCloud Tech. Если вы там были, не удивляйтесь знакомым тейкам.
Уже год, а то и больше, мы живем в инфополе, где модели якобы поумнели, но то и дело что-то ломают. То они обещают изменить всю индустрию, то это раздутый пузырь и все скоро лопнет. Машины решают задачи тысячелетия, фирмы-единороги из одного человека выходят на рынок… А нам-то, разработчикам что делать? Пора уже меняться или еще рано?
Осваивать новое — не вопрос. Но вот когда мы делегируем задачу агенту, мы действительно получаем выигрыш или просто переносим работу на следующего человека (возможно, на себя из будущего)? Как изменится нагрузка, если запустить несколько агентов? Можно ли поручить им еще и ревью? Насколько это безопасно и кто разберется с инцидентом, если разработчик перестанет читать изменения?
Я Миша Трифонов, Head of Development, и мы с моим коллегой Русланом решили исследовать эти вопросы на уровне компании, каждый со своей стороны: я с управленческой, он — с инженерной. Мы взяли 27 разработчиков и раздали им доступы к Claude Code в обмен на согласие подробно документировать и анализировать их рабочие сессии. Кроме того, с каждым мы провели глубинные интервью.
Предлагаю вместе с нами посмотреть, кто и как использует ИИ, каково распределение сотрудников на лестнице AI-adoption, предложенной Борисом Черни из Anthropic, и главное — где спрятана реальная польза от агентной разработки. Попутно отсыплю своего мнения о том, как скорее всего поменяется роль человека в разработке в скором будущем.
Что еще за лестница AI-adoption
Лестница AI-adoption — это методология, предложенная Борисом Черни, одним из главных идеологов Anthropic. Он некогда задался вопросом, когда ИИ дает реальную эффективность для разработки, и выделил два таких случая:
Когда ты делегируешь свою работу машине и она делает ее быстро и качественно.
Когда экономится время на передаче информации между разными участниками разработки (потому что вся разработка теперь ведется в одном окне).
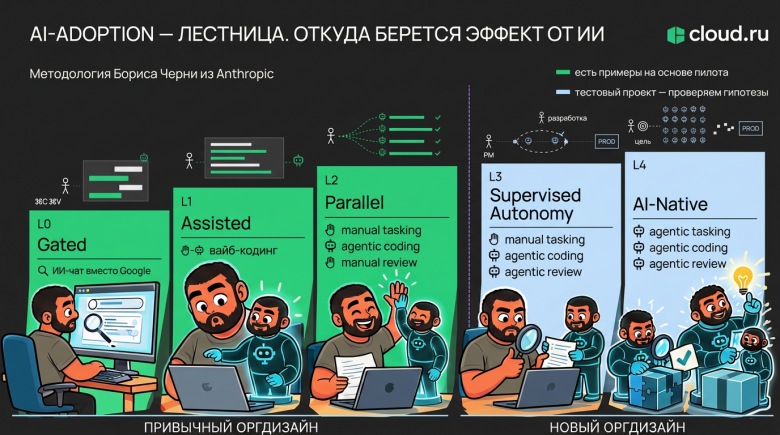
Черни выделяет пять ступеней делегирования: от вопросов в чате (как замена гуглежке) до выполнения, проверки и генерации задач с агентами. Мы выбрали эту схему, чтобы понять, какую работу передаем ИИ, что мешает двигаться на следующий уровень и когда нужно менять сам процесс разработки.
L0 — это уровень, где разработчик пользуется ИИ-моделью как поисковиком. Раньше, когда разработчик чего-то не знал, он шел на Stack Overflow, в Google или доку, теперь он просто спрашивает у чата.
L1 — это когда ты вместе с ИИ пишешь код, как парное программирование: ты пишешь функции, он тебя дополняет-проверяет и тесты запускает.
L2 — уже уровень, где разработчик перестает писать код. Он ставит задачу агенту, агент пишет код, а человек за ним проверяет.
L3 — уровень, где мы освоились с агентами настолько, что уже даже не проверяем за ним код: вместо нас это делают другие агенты.
L4 — уровень, где человек делегирует машинам еще и постановку задач, а сам становится архитектором циклов постановки задач.
Для ясности должен проговорить три вещи:
Уровни L0-L4 просто демонстрируют степень участия агентов в процессе и никоим образом не говорят что-то о квалификации инженера. В конце концов, если для определенной задачи хватает чата, почему бы не делать с чатом?
Тот факт, что я говорю о всех пяти уровнях AI-adoption, не значит, что мы внутри компании уже осилили все из них: наиболее уверенные наши наблюдения относятся к L0–L2; для L3–L4 у нас пока тестовые проекты. Мне в принципе кажется, что компаний, которые уверенно находятся на L4 в мире по пальцам руки опытного фрезеровщика пересчитать можно.
Разумеется, прежде, чем пускаться в эксперименты с ИИ-агентами, мы тщательно прикрыли все тылы по части безопасности. Как? Пожалуй, история для отдельной статьи. Но имейте в виду, что все описанное ниже не значило слив нашей кодовой базы вовне.
Теперь, давайте взглянем, что делали наши сотрудники на каждом этапе, с какими проблемами сталкивались и удалось ли им эти трудности преодолеть и выйти на следующий уровень.
L0. Когда чата достаточно
На L0 модель находится вне проекта. Разработчик сам задает вопрос, передает фрагмент кода, обсуждает решение и вносит изменения. Здесь подход к разработке практически не меняется: сам ставишь себе задачу, сам придумываешь способы ее реализации, выбираешь оптимальный код из предложенного ИИ-шкой… Для разовых запросов это вполне подходящий формат. Но какого-то сильного буста к эффективности и продуктивности мы на этом этапе не заметили. Наверное потому, что сейчас каждый разработчик так или иначе для своих задач использует ИИ, соответственно, «когда все молодцы — никто не молодец» и базовый уровень выравнивается.
Желание перейти от разовых запросов дальше появляется, когда приходится постоянно объяснять структуру проекта, контекст и заморачиваться с переносом файлов туда-обратно. Тогда хочется дать инструменту возможность самому посмотреть в репозиторий. Тут-то мы и пытаемся вскорабкаться на ступеньку L1.
L1. «Почти правильно» как главная проблема
На L1 агент уже работает с репозиторием или даже встроен в IDE: разработчик ведет задачу вместе с агентом и проверяет предложенные изменения. На этом уровне многие сталкиваются с двумя проблемами:
Сам доступ к репозиторию вообще не значит, что модель понимает задачу так же, как команда разработчиков. Формально решение может быть правильным, но не учитывать интересы смежных команд или принятые в компании практики.
Если раньше ты думал, писал и проверял свой код, то теперь нужно сначала сформулировать поручение, потом дождаться результата, разобраться в чужой реализации и объяснить, что именно не подошло. Особенно утомляет вариант, который выглядит убедительно, но содержит ошибку, которую еще надо найти.
Согласно исследованию Stack Overflow, главный раздражитель при работе с ИИ у разработчиков — тот факт, что он делает «почти правильно», а чтобы добиться «совсем правильно» уходит слишком много времени и сил. У некоторых участников нашего пилота это тоже стало причиной возврата к чату. Агент долго работал, после него оставалось много проверки, и более простой формат оказывался комфортнее.
Чем мы попытались это вылечить:
Упростили вход. Передали в унифицированном виде информацию из нашего трекера задач, корпоративной базы знаний, документации сервисов, чтобы не приходилось заново своими силами объяснять контекст. Создали корпоративный MCP, расшарили базу общих уже проверенных скиллов.
Выстроили систему обмена опытом, чтобы каждый, у кого что-то сработало, мог объяснить другим, как именно у него это сработало. Важно же не просто кидаться в человека инструментами, а объяснять, как ими пользоваться.
Части сотрудников это реально помогло освоиться с делегированием задач, что дало +10% к их эффективности. Самые отъявленные смельчаки захотели шагнуть еще дальше на уровень L2 и делегировать машинам этап «все фигня, переделывай» тоже.
L2. Страх и ненависть в одном репозитории
Когда ты делегируешь несколько параллельных задач агентам, это, с одной стороны, чистая эйфория: у тебя как будто 10 стажеров, которые бегают по поручениям и даже не обижаются на требования 10 раз переделать работу до достижения правильного результата. Особый кайф в том, что самый трудозатратный этап копания в чужом коде тоже не на тебе. При хорошем раскладе можно получить готовый результат на блюдечке. Но хороший расклад случается не так уж часто. Обычно агентный параллелизм приносит с собой не только +20% эффективности, но и новые проблемы.
Сначала расходятся файлы
Первая и главная боль — агенты начинают толкаться локтями в репозитории. Они по кругу редактируют одни и те же файлы, дерутся за порты, меняют результаты друг друга. При таком раскладе есть риск пожечь токены и ничего не получить.
Чем лечили? Для разделения файлов подходит git worktree. Забавно, что сама функциональность worktree появилась в 2015 году, и только сейчас разработчики начали осознавать ее прелесть. Суть в том, что у одного репозитория можно создать несколько рабочих деревьев и работать с разными ветками в отдельных каталогах. При этом часть состояния репозитория остается общей.
Сеть, процессы, порты и учетные данные нужно рассматривать отдельно: worktree не следует использовать как замену защищенной среде выполнения. Для параллельной проверки мы использовали фича-стенды, чтобы понять, совпадает ли фактическая работа фич с тем, что ты напланировал, и решает ли это вообще изначальную задачу. Пластырь для этой болячки нашли, но…
Потом теряются договоренности
В сессии появляется другая проблема: агент возвращается к исправленному варианту, забыв между сессиями уже обсужденное условие. Бац — и все ему нужно объяснять заново. Здесь уже можно отчаяться и вернуться на предыдущий уровень, но лечение есть, и имя ему SDD (spec-driven development) или разработка с опорой на спецификацию.
Чем лечили? Главное здесь не фиксировать все существующие условия в переписке, а создавать спецификацию, где отражается ожидаемое поведение, ограничения агента, критерии приемки результата и случаи, когда агенту нужно остановиться и спросить у человека, что делать дальше. Другой вопрос конечно, что спецификацию тоже нужно проверять и перепроверять. Потому что если какое-то важное условие упущено, даже педантичное следование документу не исправит исходную ошибку.
Но допустим, вы уже достигли просветления, ваши агенты что-то шуршат сами и приносят на подтверждение только те места, где им недостаточно прав или они не уверены, как поступить. Тут нас поджидает файнал босс уровня…
Приходит «царь во дворца»
Рано или поздно human-in-the-loop становится узким горлышком и слабым звеном агентной системы: когда тебе постоянно прилетают запросы на подтверждение отдельных небезопасных действий, возникает желание либо отключить их, либо согласиться на все условия, особенно не вдаваясь в суть. Тут-то и начинается dangerous-режим: у агента появляется доступ до сетей, корневых файлов, ему вообще ничего не мешает делать что угодно.
Чем лечили? Здесь можно поднять микровиртуалку с Docker Sandbox, где на уровне среды определяется, какие доступы есть у агента: дальше, чем позволяет «клетка» он не дотянется.
Вроде бы на этом этапе ты уже молодец: все работает само и можно пить кофеек. Но с закрытием крышки ноутбука агенты тоже перестают работать. Тут лекарство только одно — переносить работу в облако, хотя многим и локального уровня хватает. Но вы же не думаете, что эта сказка закончится хэппи-эндом, да?
Внимание дробится между сессиями
Если машины — это масштабируемый ресурс, то человеческое внимание все-таки имеет потолок, и у каждого он свой. Согласно исследованию Калифорнийского университета, переключение внимания между контекстами занимает в среднем 23 минуты. Предположим, вы запустили пять агентов:
Достиг развилки и ожидает решения.
Упал непонятно почему, надо разбираться.
Работает уже 30 минут, хотя задача должна была занять пять. Есть риск, что он там строит космолет вместо велосипеда.
Сессия выполнена. Нужно отревьюить результат, но сначала вспомнить: что там вообще была за задача?
Сессия закончилась неделю назад, ты ее забыл посмотреть.
Пока ты въехал в контекст каждой сессии, прошло почти два часа рабочего времени, а нужно еще разрабатывать вообще-то. Раньше если ты успешно скачешь между задачами — это называлось СДВГ, теперь это навык оркестратора. Уже представляю сессию у психотерапевта с запросом: «доктор, помогите, у меня нет СДВГ». Но если серьезно, даже с этим можно кое-что сделать.
Чем лечили? Лекарство здесь одно: харнессы. Это вся обвязка вокруг модели: спека, скиллы, правила проекта, песочница, директивы насчет того, когда звать человека, инструменты, проверки.
У каждого разработчика, который активно использует агентов, выстраивается свой харнесс, который вполне может быть классным. И тут возникает следующая проблема, уже весьма человеческая...
Сделать что-то свое стало проще, чем договориться об общем
Вполне может быть так, что два разработчика в смежных проектах хотят сделать один прототип. Раньше они просто встречались, обсуждали идеи, договаривались, кто за что отвечает, и делали один вариант.
С приходом агентов все изменилось. Лишь небольшая часть разработчиков отмечает улучшение командной работы с приходом ИИ. Что приводит нас к выводу, что бОльшая часть никаких улучшений не видит вообще или видит ухудшение. Сейчас два разраба могут набросать по прототипу за короткое время, а дальше нередко начинаются бодания «чей прототип лучше». В итоге у каждого может быть по крутому харнессу, но время потратили оба, еще какое-то время ушло на то, чтобы собрать из двух вариантов один общий. По правде говоря, у нас с Русланом перед конфой так и вышло: каждый подготовил презентацию на 30 страниц, а потом пришлось договариваться, где будет чей слайд.
Еще бывают ситуации, когда разные разработчики в команде находятся на разных уровнях принятия ИИ. У одного уже крутой харнесс и все пишут агенты, а двое других еще на уровне переписки в чате говорят: «это все, конечно, вау, я тоже так хочу, но давай пока в этот раз сделаем по-старому?». И мы приходим к ситуации, где у отдельных энтузиастов есть крутые харнессы, которые… лишь незначительно влияют на time-to-market решений и качество продуктов, а еще уходят из компании вместе с их обладателями.
Чем это лечится? По-хорошему должно быть три контура харнессов — личные, командные (продуктовые) и для всей компании. Личными могут оставаться удобные приемы, командными должны становиться договоренностью о продукте и проверках, а корпоративными — общие требования к данным и доступам. Не обязательно заставлять всех пользоваться одной настройкой, но результат работы должен быть понятен каждому члену команды, а движение должно происходить в общем русле.
Допустим, мы, даже как компания, все сделали правильно. Агенты тоже все сделали, как их просили. И даже люди на других ролях оказались органично встроены в пайплайн, все работает классно, ошибки стремятся к нулю. Возникает вопрос: а можно ли не ревьюить вообще? Нууу…
L3. «А можно я не буду проверять?»
На L3 в нашей схеме агенту передают не только реализацию, но и существенную часть проверки. На конфе мы обсуждали для этого этапа концепцию промежуточных гейтов, внешние тесты, дополнительные проверки агентами и общие пайплайны для изменений от людей и ИИ.
Но добавление агента-ревьюера само по себе не дает мне достаточного основания перестать смотреть изменения. Модельная проверка тоже требует оценки качества: например, в руководстве Anthropic для LLM-проверок отдельно указаны недетерминированность и необходимость калибровки по оценкам людей.
Я предпочитаю выстраивать процесс так:
Агент подготовил изменение — запускаются сборка, тесты и статический анализ.
Анализ нашел определенные классы проблем? Результат летит обратно на исправление.
Агент-ревьюер прошелся по заданным нами критериям и ничего не нашел? Шик! Катим в предпродакшен, если осторожные, или сразу в прод, если смелые. Агент что-то нашел и не знает, что с этим делать? Обращается к человеку.
Человек разбирает решения, для которых автоматической проверки недостаточно.
Схема не универсальная, у нас на ступени L3 пока находятся отдельные тестовые проекты. Мы хотели проверить сценарий, в котором человек ставит задачу и получает реализацию на продакшен-окружении, не сопровождая вручную каждый шаг. Могу сказать, что рост эффективности действительно похож на то, что обещал Борис Черни — где-то +80%.
При таком подходе мы наблюдаем значительное смещение ролей, которого в будущем, думаю, стоит ожидать большинству ИТ-гигантов. Моя гипотеза в том, что скоро часть инженерной работы сместится к настройке инструментов, проверкам и контролю агентного процесса. Если вы прямо сейчас задаетесь вопросом «уволят ли меня?», я склонен считать, что нет. Просто часть инженеров уйдет в платформенные задачи, а часть — в продукт-инженерию. Часть работы QA сместится к развитию независимого автоматизированного проверочного контура.
В энтерпрайзе, как мне кажется, будут расширяться возможности платформ и платформенных команд, а бизнес-команды будут маленькие (tiny teams), но суперэффективные.
Насколько я прав или неправ? Собьемся через пару лет под этим же постом ?
У нас тут на горизонте маячит еще один немаловажный вопрос: если простые изменения и часть ревью будут выполнять агенты, на каких тогда задачах менее опытные разработчики научатся понимать систему? Если агент эскалирует на человека только самые сложные вопросы, выходит, вся работа будет состоять из хардкора. Это и синьорам-то сложно, а каково будет тем, кто придет им на смену, и откуда вообще эти люди возьмутся? Точного ответа у нас нет. Мы обсуждали совместные дежурства и работу рядом с опытными коллегами, но проверенной модели, кажется, пока нет ни у кого. Можем подискутировать в комментариях: как это должно решаться и должно ли вообще? Может вообще стоит, как предлагают многие, заморозить развитие ИИ, пока не найдем ответы? Реально интересно будет почитать ваши мнения.
L4. Откуда берется следующая задача
В теории на L4 в цикл включается подготовка новых задач: система не только выполняет поручение, но и предлагает дальнейшие действия, а человек уже определяет, какие из них нужны. Здесь нам вообще нечего сказать по той простой причине, что сюда мы еще не допрыгнули. Поэтому я могу только сформулировать вопросы для следующих экспериментов.
На основании каких данных агент предлагает изменение?
Как предложение связано с целью продукта?
Кто разрешает взять его в работу?
Как остановить цикл, который производит правдоподобные, но ненужные задачи?
Генерация предложения и разрешение на его реализацию для меня должны оставаться разными действиями.
Что показал пилот и чего он не показал
Вопрос об экономике после доклада интересовал многих, спрашивали, как изменилось время поставки и считали ли мы окупаемость? Отвечаю: мы сопоставляли коммиты, merge requests, задачи в трекере и интервью с участниками. Продукты и задачи различались, поэтому единую метрику ускорения мы не получили.
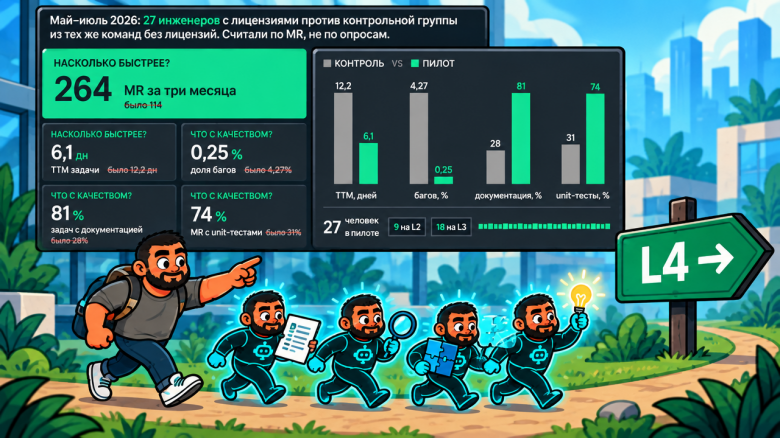
Можем дать только ориентировочные цифры: MR стало примерно вдвое больше. Эта цифра описывает активность в репозиториях; из нее, конечно, нельзя получить двукратное ускорение разработки или ROI, но для наблюдения динамики, по-моему, репрезентативно. Наиболее уверенные количественные выводы мы относили к L0–L1, а оценки для L3–L4 пока можем считать только исследовательскими, однако, если судить, о чем говорят гиганты рынка, мы получаем примерно сопоставимый эффект.
Для утверждения об ускорении мне понадобились бы сопоставимые задачи и период наблюдения, время до принятого результата, трудозатраты на проверку и переделки, а также данные о качестве после выпуска. Для окупаемости — еще стоимость инструментов, инфраструктуры и поддержки нового процесса. Но это уже совсем другая история.
Ценность этого пилота для меня в другом: он позволил разбирать не только готовый код, но и то, как меняется работа вокруг него. В сессиях и обсуждениях мы увидели недостаток контекста, возвраты к чату, конфликты параллельных агентов и трудности командного перехода. Поделитесь, какие сложности возникали в ваших командах?