

Привет! Меня зовут Сергей Бирюк, я технический лидер в MWS Cloud Platform, и сегодня мы поговорим о том, зачем облаку нужен Managed Kubernetes и чем наш сервис отличается от других. Благодарю коллег за помощь в подготовке этого материала.
Условимся о терминах в этой статье
Kubernetes — здесь будет подразумеваться кластер, который заказывает клиент и который выполняет оркестрацию контейнеров, контроль состояния и самовосстановление клиентских нагрузок — всё то, за что мы и любим Kubernetes.
Managed Kubernetes — это сервис предоставления таких кластеров «по запросу» с возможностью самообслуживания через UI, API и Terraform.
«Честный» PaaS — это когда сервис стремится максимально приблизиться к использованию только публичных сервисов и методов облака. Проще говоря, когда мы откроем наши компоненты (это будет скоро, мы почти готовы!), вы сможете такой же сервис построить сами.
Зачем нужен Managed Kubernetes
Развернуть кластер Kubernetes вручную — задача не столько сложная, сколько продолжительная: поднять виртуальные машины, установить компоненты Control Plane, настроить CNI, CSI, DNS, разложить сертификаты. Понять, что надо было иначе, удалить, сделать заново, и так раза три.
Развёртывание — это только первый этап жизни кластера, дальше мы должны заниматься поддержанием его деятельности, и это стоит дорого. Каждая рутинная операция эксплуатации в ручном режиме — это десятки человеко-часов и постоянные дежурства. Нужно следить за:
обновлением версии Kubernetes и системных компонентов;
ротацией сертификатов Control Plane;
масштабированием кластера и групп нод под нагрузкой;
управлением уязвимостями и установкой Security-патчей;
резервным копированием и регулярной проверкой процедур восстановления;
контролем SLA-доступности API-сервера.
Мало того, что это долго и недёшево, каждая из этих операций потенциальный источник ошибок, которые могут поломать прод и стать серьёзными инцидентами — и хорошо, если без последствий. А ещё для управления кластерами нужны высококвалифицированные SRE-инженеры, глубоко понимающие внутренности Kubernetes, а это редкий и дорогой ресурс, который не всегда оправдан для продуктового бизнеса.
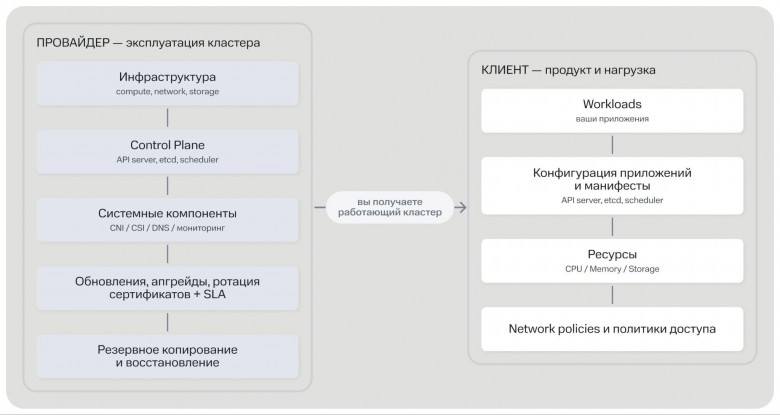
Managed-сервис снимает эту нагрузку. Провайдер берёт на себя всё, что связано с эксплуатацией: инфраструктуру, Control Plane, системные компоненты, обновления, скейлинг, апгрейды, ротацию сертификатов, бэкапы и доступность сервиса. Команда освобождается для того, что действительно приносит бизнесу ценность: разработка фич, улучшение пользовательского опыта, работа с продуктовыми метриками.
За клиентом остаётся то, что относится к его продукту: приложения, CI/CD, пользовательский мониторинг и всё, что связано с нагрузкой. И даже на этой стороне провайдер старается облегчить жизнь, предлагая готовые инструменты, интеграции и лучшие практики. Где заканчивается зона провайдера и начинается зона управления клиента — видно из схемы ниже:
Из чего состоит Managed Kubernetes в MWS Cloud Platform
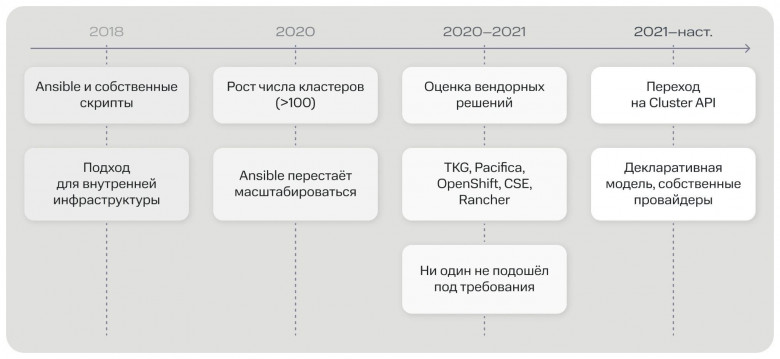
Прежде чем рассказывать об архитектуре, стоит объяснить, почему и как она стала именно такой. Конечно, наш Managed Kubernetes не появился за один спринт — это совокупность нескольких итераций, каждая из которых совершенствовала и дополняла результат предыдущей. На схеме ниже проиллюстрировано, как развивался наш подход:
Собственные скрипты и Ansible
Исторически первый подход к развёртыванию Kubernetes-кластеров был классическим для своего времени: Ansible-плейбуки и набор собственных скриптов. Этим методом мы управляли внутренней инфраструктурой ещё несколько лет назад. Такой подход работал на начальном этапе. Плейбуки описывали шаги последовательно: подготовить IP Plan, создать сеть, развернуть ВМ, выполнить kubeadm init, повторить ещё дважды, накатить CNI и далее по списку. Для небольшого числа кластеров этого было достаточно — код был понятен, изменения вносились точечно, debugging начинался с запуска плейбука с -vvv, а заканчивался где повезёт.
Но по мере роста числа кластеров начали проявляться недостатки подхода. Когда их количество превысило сотню, стало очевидно: это потолок масштабирования ручных скриптов и плейбуков.
Проблемы накопились системные:
Огромные усилия на поддержку. Каждый новый сценарий (другая версия Kubernetes, новый тип узла, обновление CNI) превращался в копирование и адаптацию существующих ролей. Кодовая база разбухала, дублирование логики становилось нормой.
Точечные правки вместо единой модели. Любое изменение логики развёртывания приводило к правкам по всей кодовой базе: один плейбук создавал узлы, другой их настраивал, третий применял аддоны. Связность между ними держалась только на внимании инженера.
Отсутствие декларативной модели состояния. Ansible — это императивный инструмент: он описывает, как сделать, а не что должно получиться. У нас не было единого источника истины о желаемом состоянии кластера.
Дрейф конфигураций. Без декларативной модели и reconciliation loop кластеры, развёрнутые в разное время или с разными версиями плейбуков, постепенно расходились в конфигурации. Отследить этот дрейф вручную при сотнях кластеров — задача, не имеющая конца.
Была ещё одна проблема, но она больше относится к принципу предоставления сервиса: поддерживался любой каприз пользователя, порядок не был зафиксирован baseline.
Ключевой вывод этого этапа: императивная автоматизация (Ansible) не масштабируется до fleet management. Она хорошо работает для конечного набора операций, но не для управления жизненным циклом парка кластеров, где состояние должно сходиться к декларации автоматически.
Оценка вендорских решений
Тогда мы подумали: «Возможно, кто-то уже решил эту задачу». Рынок Managed Kubernetes к тому моменту предлагал несколько зрелых платформ, и мы рассмотрели основные варианты:
TKG (Tanzu Kubernetes Grid, VMware) — платформа управления мультикластерным Kubernetes от VMware, построенная на Cluster API, но поставляемая как коммерческий продукт с привязкой к экосистеме VMware.
Pacifica — разработка VMware для управления Kubernetes на vSphere, которую нам предлагал вендор для пилотирования
CSE (Container Service Extension) — расширение VMware Cloud Director для предоставления Kubernetes как сервиса.
OKD (aka Red Hat OpenShift Community Edition) — полноценная платформа контейнерных приложений с собственным механизмом управления кластерами.
Rancher — open-source платформа управления Kubernetes-кластерами с поддержкой мультиоблака.
Ни одно из решений не подошло под наши требования, и причины были отнюдь не косметическими.
Глубокая интеграция с собственным IaaS. MWS — это не vSphere или приватное облако. У нас собственная IaaS-платформа со своими сетевыми моделями, балансировщиками, дисками, квотами и процессами биллинга. Большинство вендорских решений предполагают интеграцию с конкретным набором облачных провайдеров (AWS, Azure, GCP) с vSphere или Openstack. Подключить наш IaaS значило бы либо писать множество слоёв совместимости поверх чужой абстракции, либо мириться с ограничениями вендорской модели.
Open-source фундамент под нашим контролем. Нам нужна была база, которую мы можем развивать сами, патчить под наши сценарии и не зависеть от roadmap’а конкретного вендора. Коммерческие решения (TKG, OKD) закрывали часть задач, но ценой vendor lock-in и невозможности глубокой кастомизации без поддержки вендора.
Недопустимость vendor lock-in. Управляющий слой платформы — это слишком стратегический компонент, чтобы отдавать его третьей стороне. Любое изменение лицензионной политики, цен или roadmap’а вендора становилось бы нашим риском. Также на слуху истории последних лет, когда поддержка вендорских решений становилась недоступной в России.
Предположения о модели облака. Вендорские решения чаще всего строятся вокруг «стандартной» модели облачного провайдера: есть регион, есть zone, есть instance с billing-per-second. Наша модель отличается, и попытка впихнуть её в чужую абстракцию приводила к костылям на каждом уровне.
Итог: на рынке не оказалось готового вендорского решения, которое одновременно было бы open-source, self-hosted и глубоко интегрируемым с нашим IaaS. Rancher, будучи open-source, ближе всего подходил по философии, но его модель управления всё равно требовала адаптации под нашу инфраструктуру и не давала того уровня контроля над жизненным циклом кластера, который был нужен.
Это была важная точка осознания: нам нужен не готовый продукт, а фреймворк, на котором мы построим свою реализацию.
Cluster API
К этому моменту мы уже знали, что искать: декларативную модель, extensible-архитектуру и активный upstream. Этим требованиям соответствовал Cluster API — проект рабочей группы SIG Lifecycle, который позволяет управлять жизненным циклом кластеров декларативно, через те же механизмы, что и приложениями в Kubernetes (CRD + контроллеры).
Cluster API — это не очередной продукт поверх Kubernetes. Это набор спецификаций и контроллеров, которые превращают кластер в управляемый объект: вы описываете желаемое состояние кластера как набор custom resources, а контроллеры приводят инфраструктуру к этому состоянию.
Почему именно Cluster API
Декларативность. Мы описываем желаемое состояние кластера, а контроллеры сами приводят инфраструктуру к этому виду через reconciliation loop. Никакого императивного кода в духе «сначала создай сеть, потом VM, потом установи kubeadm». Если что-то ушло от desired state — контроллер это заметит и исправит. Это закрывает проблему дрейфа конфигураций, с которой мы жили на Ansible.
Расширяемость. Чёткие спецификации провайдеров (Core, ControlPlane, Bootstrap, Infrastructure) позволяют легко добавлять поддержку любых инфраструктур и кастомизировать bootstrap. Для нас это означало: мы можем написать собственный Infrastructure Provider под MWS IaaS, использовать готовый kubeadm bootstrap provider для инициализации узлов и расширять ControlPlane Provider под наши сценарии с hosted control plane.
Экосистема. Активное сообщество, готовые компоненты (kubeadm bootstrap, провайдеры для популярных облаков) и постоянное развитие upstream. Мы не оставались в изоляции — решения типовых задач уже существовали, а архитектурные паттерны (topology, clusterclass, machine deployments) оттачивались сообществом.
Масштабируемость. Cluster API изначально проектировался для управления флотом кластеров, в то время как Ansible-скрипты требуют постоянного переписывания при росте числа кластеров. Один management-кластер может управлять тысячами workload-кластеров, и операционная сложность не растёт линейно с их числом.
Влияние на развитие. Проект развивается открыто, можно участвовать в митапах сообщества, а свои особенные кейсы формировать в виде Proposals, Issues и Pull Requests.
Cluster API стал не просто технологией, а архитектурным фундаментом нашего сервиса. Он позволил сосредоточиться на продуктовых фичах: релизных каналах, аддонах, безопасности, интеграции с облачными сервисами MWS, а не на автоматизации развёртывания. Ознакомиться с Cluster API можно в The Cluster API Book.
В следующем разделе расскажем, как именно мы построили архитектуру на этом фундаменте: какие провайдеры реализовали, как организовали management-кластер и как управляющий слой взаимодействует с IaaS MWS.
Слои облачной платформы
Облачная платформа MWS состоит из четырёх слоёв, каждый из которых надстраивается поверх предыдущего. От физического железа до готовых приложений — каждый слой предоставляет абстракцию более высокого уровня и потребляет API слоя ниже.
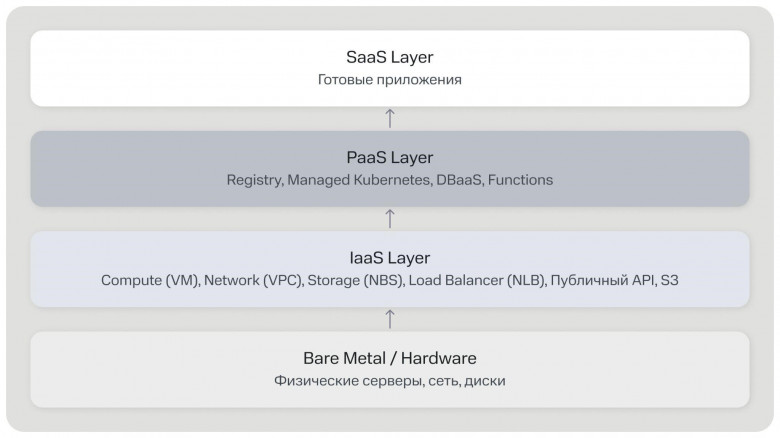
Нижний слой — Bare Metal: физические серверы, сетевое оборудование, дисковые полки. Это фундамент, на котором работает всё остальное.
IaaS — инфраструктура как сервис. Виртуальные машины, виртуальные сети (VPC), блочные диски (NBS), сетевые балансировщики нагрузки (NLB) — часть из этих тем мы разобрали в своих статьях на Хабре. Здесь статья о VPC, тут про виртуальные диски, а здесь о NLB.
Инфраструктурный слой предоставляет публичный API: тот же самый API доступен и пользователю, и внутренним сервисам платформы. Никаких «внутренних» методов, недоступных клиентам.
PaaS — платформа как сервис. Сюда входят Container Registry, Managed Kubernetes, DBaaS (управляемые базы данных), Functions (бессерверные вычисления). Именно этот слой мы строим по принципу «честного» PaaS, который раскроем ниже.
SaaS — готовые приложения поверх всего: почта, CRM, инструментальные сервисы. В рамках этой статьи в слой SaaS погружаться не будем.
Что такое «честный» PaaS
Слово «честный» здесь означает вполне конкретное архитектурное ограничение, которое мы накладываем сами на себя при разработке сервисов PaaS-слоя. Это же ограничение становится требованием при разработке новых функций сервисов IaaS.
«Честный» PaaS — это принцип построения сервиса, при котором PaaS не чёрный ящик. Сервис построен из тех же самых компонентов и публичных IaaS-методов, которые доступны пользователю. Пользователь при желании может собрать аналогичный сервис самостоятельно — из тех же строительных блоков, на которых построен наш Managed Kubernetes.
Что это значит на практике:
PaaS построен поверх публичного API, а не скрытого приватного, созданного специально для PaaS. Наши операторы, которые управляют жизненным циклом Managed Kubernetes-кластеров, обращаются к тем же методам создания VM, VPC, NLB и дисков, что доступны любому пользователю через CLI, Terraform-провайдер или Official Go SDK for MWS Cloud Platform. Нет внутренних «бэкдорных» API, доступных только нам.
Живём на уровне IaaS, а не изолируем его. Сервис не прячется в отдельной приватной сети с закрытыми маршрутами. Kubernetes-кластеры пользователей поднимаются на тех же виртуальных машинах и в тех же сетях, что доступны клиентам. Платформа интегрирована с инфраструктурой, а не вынесена за её пределы.
Догфудим собственную платформу. Внутренние сервисы, CI/CD и инфраструктурные пайплайны работают через те же публичные API, что доступны пользователям. Кроме того, догфудинг создаёт механизм обратной связи: если API нестабилен, если документация врёт, если метода не хватает — мы узнаём об этом в 3 ночи по пейджеру, а не через тикет в поддержку.
Используемые компоненты: open-source или наши собственные. Cluster API, kubeadm — всё это открытые инструменты. Собственные компоненты (Infrastructure Provider, CSI-драйвер, Cloud Controller Manager) мы готовим к публикации и публичному доступу. Любопытный пользователь сможет взять тот же стек и собрать кластер сам.
В будущем — возможность для клиента построить собственный кластер, интегрированный в облачную инфраструктуру, используя те же компоненты. Не просто «повторить вручную», а получить поддерживаемый путь сборки, основанный на тех же строительных блоках. Управляемый сервис останется для тех, кому не нужна эта ручная работа.
Managed Kubernetes как драйвер развития IaaS. Когда какой-то метод IaaS API ещё не готов к публикации для всех пользователей, потребность в нём со стороны Managed Kubernetes часто становится катализатором: сервис требует стабильного API для создания кластеров, и это ускоряет доработку и публикацию метода для всех. Таким образом, PaaS не только потребляет IaaS, но и подтягивает его развитие.
По сути мы делаем базовые строительные блоки, из которых собираем сервис. А чтобы получился полноценный сервис — не просто «кластер поднялся», а полноценный продукт с обновлениями, мониторингом и окнами обслуживания — поверх базовых строительных блоков мы реализуем все Day-2 операции.
Это разделение принципиально:
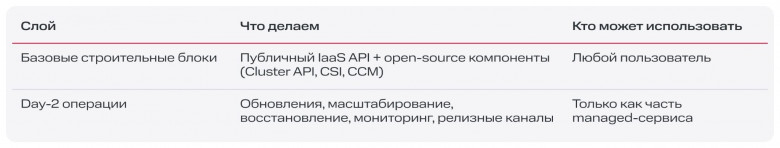
Парадигма честного PaaS даёт гарантию: строительные блоки будут развиваться вместе со всем облаком, потому что мы используем их для построения сервиса сами. Если в IaaS появляется новая возможность — она становится доступна и нашим операторам, и пользователю одновременно. Если публичный API меняется — мы проходим через те же миграции, что и наши клиенты. Нет ситуации, когда «внутри облака» работает новая версия API, а пользователь сидит на старой.
Сравним два подхода
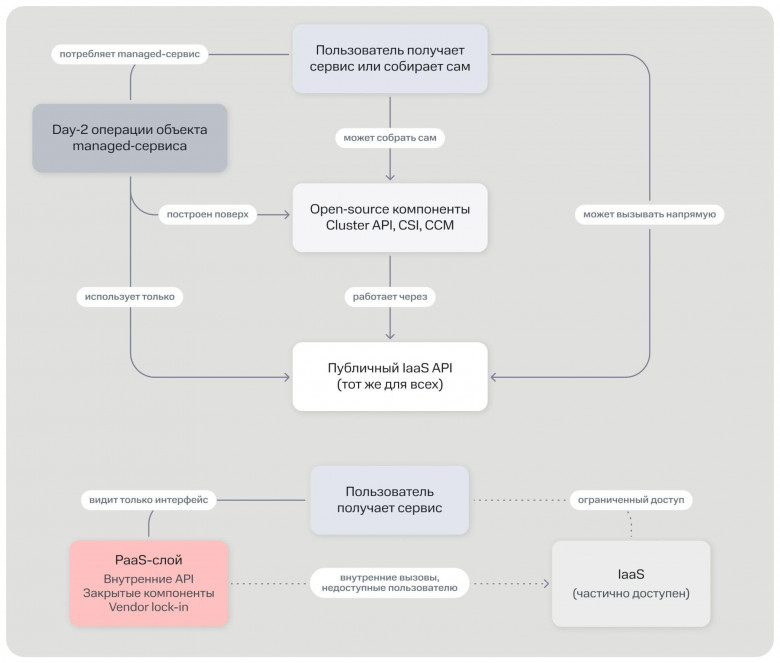
Чтобы было наглядно, давайте разберём и оценим два подхода: обычный PaaS и честный.
Обычный PaaS — чёрный ящик. Пользователь получает готовый сервис, но не видит, из чего он собран. Провайдер использует внутренние API, закрытые компоненты, проприетарные обвязки. Если провайдер перестаёт поддерживать какую-то возможность — пользователю ничто не поможет: повторить сервис самостоятельно он не может, потому что внутренние компоненты ему недоступны. Vendor lock-in возникает не из злого умысла, а из самой архитектуры: PaaS отделён от IaaS приватным слоем, который пользователь не может повторить.
«Честный» PaaS — сборка с инструкцией. Пользователь получает тот же managed-сервис, но при желании может заглянуть внутрь: увидеть, какие компоненты используются, какие API вызываются. И, что важнее, может собрать аналогичный сервис самостоятельно. Managed-сервис берёт на себя рутину эксплуатации — обновления, мониторинг, резервное копирование — поверх тех же базовых блоков, которые доступны пользователю.
Практическое следствие: если вам по каким-то причинам наш Managed Kubernetes не подходит — вы можете поднять кластер на тех же VM, тех же балансировщиках, тех же дисках, с тем же Cluster API, что используем мы. Вы не заперты, но когда вам надоест делать обновления вручную — managed-сервис ждёт, и он построен ровно из того, что вы только что собрали сами.
Архитектура решения
Базовая архитектура
Управляющие элементы облака построены на отдельных Kubernetes-кластерах, работающих на bare metal в underlay-сети. В этих кластерах расположены управляющие компоненты облака. Их задача — подготовка облачных сущностей: активация сервиса в проекте, создание сервисных аккаунтов и тому подобное. В отличие от control plane, управляющий слой не управляет жизненным циклом пользовательских кластеров.
Основной процесс управления жизненным циклом кластеров — подготовка инфраструктуры, развёртывание, реконсиляция — выполняется в CAPI-кластерах, построенных по принципу Hosted Control Plane.
Зачем Hosted Control Plane? В классической инсталляции Kubernetes control plane-ноды доступны внутри кластера и видны пользователю. Это создаёт поверхность атаки: на мастерах содержатся сертификаты, ключи от сервис-аккаунтов, база etcd — всё, что нужно для компрометации кластера. Кроме того, пользователь может случайно или намеренно разместить свою нагрузку на control plane-нодах, приводя к отказу всего кластера. Тренд облачных провайдеров — скрывать Control Plane от пользователя: GKE Autopilot, AWS EKS, наше решение в MWS Cloud Platform — все используют Hosted Control Plane. Подробнее о вариантах реализации и сравнении open-source провайдеров мы рассказывали в статье «Как спрятать Control Plane Kubernetes от любопытных глаз».
Управляющие компоненты живут в Underlay, а ноды с пользовательской нагрузкой — в Overlay. Реализуется паттерн «Kubernetes порождает Kubernetes»: управляющий кластер (management cluster), сам будучи Kubernetes, порождает и управляет другими Kubernetes-кластерами — пользовательскими (workload clusters).
Control plane пользовательских кластеров развёрнут на виртуальных машинах в overlay-сети, в выделенных системных проектах. Worker-узлы живут в пользовательских проектах. Управляющий кластер через CAPI создаёт эти VM, разворачивает на них control plane и поддерживает его состояние.
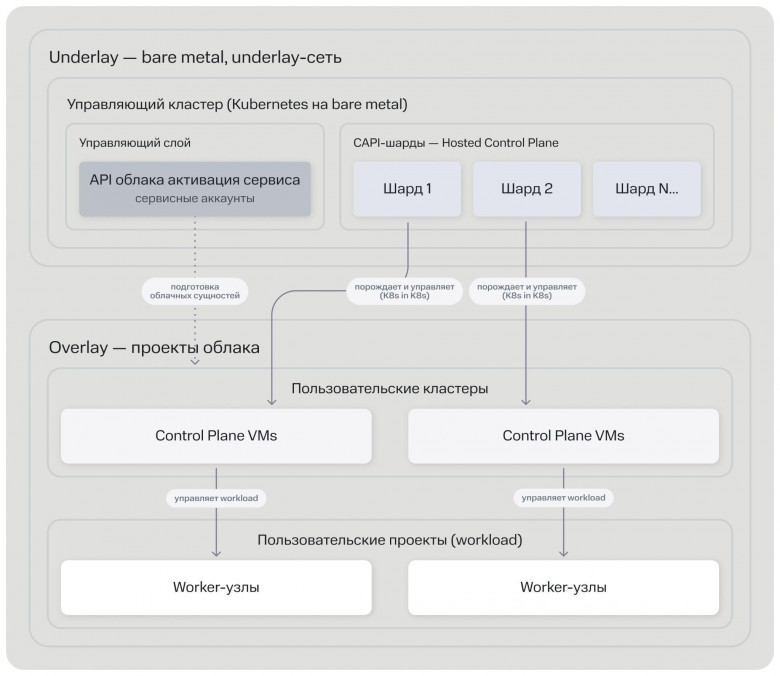
Управляющий кластер — это Kubernetes, работающий непосредственно на bare metal. В нём живут два независимых слоя: управляющий слой, который готовит облачные сущности, и инстансы CAPI, которые управляют жизненным циклом пользовательских кластеров. CAPI через инфраструктурный провайдер создают виртуальные машины в Overlay-сети, разворачивают на них Control Plane и worker-узлы.
Получившиеся пользовательские кластеры — полноценные Kubernetes, каждый со своим API-сервером, etcd и control plane. Управляющий кластер использует Kubernetes как платформу для оркестрации других Kubernetes-кластеров: те же контроллеры, реконсиляция и CRD применяются для управления инфраструктурой более высокого порядка.
Горизонтальное масштабирование
Из опыта мы знаем, что один CAPI-инстанс справляется с управлением примерно 500 кластеров без особенного тюнинга. Но по мере роста числа кластеров монолитный CAPI становится узким местом:
контроллеры не успевают обрабатывать очередь реконсиляции;
etcd управляющего кластера разрастается, замедляя все операции;
процедура обновления затрагивает сразу всю инфраструктуру управления;
параллельная поддержка разных версий Kubernetes требует разных наборов CAPI-манифестов, что усложняет единый инстанс.
Решение — шардирование CAPI. Мы логически разделили системные проекты и шарды. Каждый шард — это отдельный CAPI-инстанс в управляющем кластере, обслуживающий до 500 пользовательских кластеров.
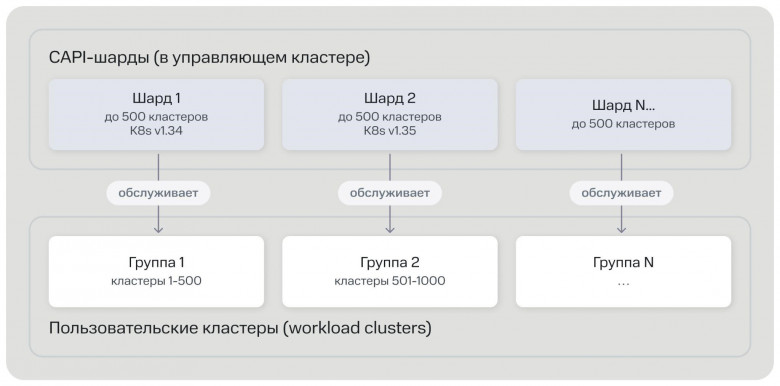
Шардирование даёт:
горизонтальное масштабирование — добавляем новые шарды под рост количества кластеров;
изоляцию отказов — проблема в одном шарде не распространяется на остальные;
независимые обновления — можно обновлять шарды по очереди, не останавливая сервис целиком;
поддержку разных версий Kubernetes — разные шарды могут работать с разными версиями CAPI и API Kubernetes.
Компоненты
В управляющем кластере работают upstream-компоненты Cluster API и наши собственные провайдеры. Их состав и разделение ответственности показаны на схеме и в таблице ниже.
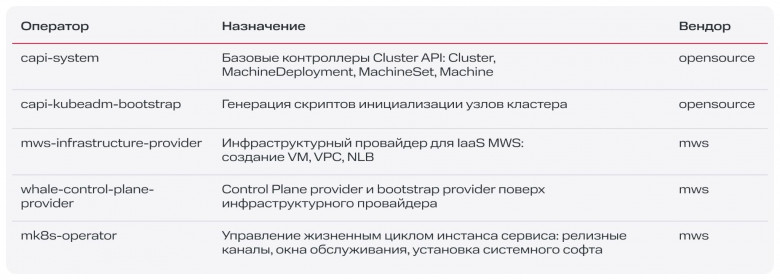
Два архитектурных решения, которые стоит отметить отдельно:
mk8s-operator — это оператор уровня сервиса: он управляет релизными каналами, окнами обслуживания, доставкой системного ПО. Он создаёт CAPI-ресурсы (например, ControlPlane CR), которые capi-system затем реконсилирует. mk8s-operator и базовые контроллеры capi — равноправные компоненты с разной зоной ответственности.
whale-control-plane-provider — это одновременно control plane provider и bootstrap provider. Он не только управляет состоянием control plane пользовательского кластера, но и отвечает за инициализацию узлов после того, как инфраструктура создана. В ванильном CAPI эти роли разделены между разными провайдерами; whale-control-plane-provider объединяет их в одном компоненте.
Разделение между инфраструктурным и control plane провайдером показано стрелками: mws-infrastructure-provider «создаёт» инфраструктуру — обращается к IaaS API, поднимает VM, VPC, NLB; whale-control-plane-provider «управляет» Control Plane — инициирует bootstrap, следит за состоянием, проводит обновления.
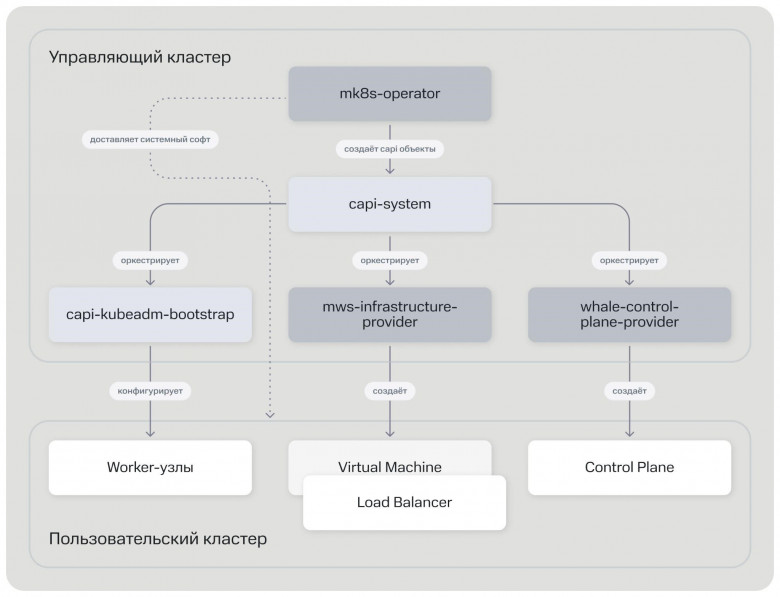
Управляющий кластер порождает и управляет пользовательскими кластерами. Каждый пользовательский кластер — это полноценный Kubernetes, независимый от управляющего после создания: собственный API-сервер, собственный etcd, собственный набор системных компонентов. Управляющий кластер нужен для создания, обновления и удаления; в ready state пользовательский кластер работает самостоятельно.
Подробно об архитектуре Managed Kubernetes в MWS Cloud Platform рассказали мои коллеги в эпизоде реалити «Создавая облако».
Заключение
Итак, подведём итоги. Ручное развёртывание кластера — полдела; настоящая цена Kubernetes — в эксплуатации: обновлениях, ротации сертификатов, бэкапах, дежурствах. Managed-сервис забирает эти обязанности на провайдера и возвращает команде время на продукт.
Главное отличие нашего сервиса не архитектура, а принцип «честного» PaaS. Managed Kubernetes в MWS собран из тех же публичных IaaS API и open-source компонентов, что доступны любому пользователю: никаких чёрных ящиков и внутренних бэкдоров. Мы догфудим платформу сами и узнаём о нестабильности API раньше клиентов.
Тестируйте сервис, задавайте вопросы в комментариях и в чате сообщества облака в Телеграме. Самые интересные кейсы, как положено, становятся Proposals в upstream.