

Понедельник, 9:12. В чате поддержки сорок сообщений про четыре разные системы: у одних не открывается почта, у других не грузится CRM, бухгалтерия пишет, что «1С зависла», разработчики спрашивают, куда делся репозиторий. Причина у всего одна, и находится она в дата‑центре облачного провайдера, до которого ваша служба дотянуться не может. Облако провайдер починит, а вот что делать людям, пока оно лежит, решает ИТ‑служба.
Этот условный понедельник мы пройдём по часам и отметим, что можно настроить заранее, а на что в разгар аварии времени уже не хватит. Для примера возьмём SimpleOne ITSM, но сами приёмы от выбранной системы почти не зависят.
9:12, «У меня не открывается почта»
Если на каждое обращение уходит 5–7 минут (принять, зарегистрировать, прочитать, ответить «мы в курсе»), сорок одинаковых заявок съедают от трёх до пяти часов рабочего времени. Цифры иллюстративные, но порядок величины понятен.
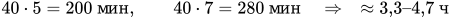
Помогает единый значительный инцидент — так в практике ITIL называют сбой, который задевает много людей и услуг (в оригинале major incident): его выводят из обычной очереди и ведут по отдельной процедуре, с назначенным ответственным и своим порядком оповещения. Остальные обращения привязываются к нему дочерними. Рабочие заметки и обсуждение из родительской записи копируются в дочерние, заявитель получает уведомление по каждому комментарию из обсуждения, а когда сервис вернулся и родитель переведён в состояние «Выполнено», поля закрытия копируются во все дочерние сразу. Тому, кто собирался написать «где моя заявка», достаточно прочитать уведомление.
Конечно, одной схемой дело не ограничивается — критерии значительного инцидента (сколько пострадавших, какие услуги, какие сроки) придётся описать до аварии, потому что спорить об определениях уже поздно.
Заранее: решить, что у вас считается значительным инцидентом, и назначить тех, кто вправе его объявить.
9:40, «А у вас тоже не работает?»
К этому времени команда обычно успевает разойтись по трём чатам и личным перепискам: инфраструктурщики обсуждают своё, сервис‑деск своё, руководитель задает вопросы тем, кому доверяет. Вечером на вопрос «кто и когда решил отключить балансировщик» никто ответить не может, потому что решение приняли в личной переписке, а в общий чат его никто не продублировал.
Против разобщенной коммуникации придумали сворминг‑сессию: на инцидент зовут сразу всех, кто может быть причастен, а по мере прояснения причины остаются только те, кто в теме, остальные расходятся. С экспертами работает координатор из сервис‑деска. Инфраструктуру он может знать слабо, его задача состоит в том, чтобы соединять людей и держать связь с пользователями. В карточке значительного инцидента в SimpleOne ITSM для этого есть кнопка «Начать сворминг»: через MID‑агент создаётся группа в Telegram, куда попадают заявитель, ответственный, менеджер инцидентов и владелец услуги. Хронология ведётся на отдельной вкладке, и пока она не заполнена, инцидент нельзя завершить, так что вечером гадать не придётся.
А иногда для сворминга приходится придумывать решение на ходу. Наш коллега рассказывает про ночь, когда в серверной одной из компаний, где он работал, начался пожар. Позвонил дежурный: пожарные приехали и огонь потушили, но вся инфраструктура лежит. ИТ‑директор в это время спал и ни о чём не знал. Почты и мессенджеров не было, корпоративная телефония тоже не работала, поэтому дежурного попросили разложить на столе все телефоны, какие найдутся (проводной, беспроводной DECT и сотовый), и включить на каждом громкую связь. Остальных звали на эти номера.
Если корпоративный мессенджер живёт в той же инфраструктуре, что и остальное, чем вы позовёте людей в 9:40? Заранее: запасной канал связи, который не зависит от упавшего облака, и распечатанный список телефонов дежурных, администраторов и владельцев услуг.
10:30, «Когда заработает?»
Когда срок починки неизвестен, пользователям нужно знать: что известно, чего пока не знаете, что делаете сейчас и когда придёт следующее сообщение. Даже «новостей нет, следующее обновление в 11:30» работает как новость, потому что показывает, что про людей не забыли. Образец, который можно держать наготове:
Недоступна почта и ряд внутренних систем (с 9:05).
Известно: сбой на стороне облачного провайдера, он подтвердил проблему.
Неизвестно: срок восстановления.
Делаем: переводим критичные услуги на запасные схемы, порядок действий для вашего отдела будет в следующем сообщении.
Следующее сообщение: в 11:30, даже если новостей не будет.
В ITSM‑системе для таких сообщений есть объявления пяти типов (срочное обслуживание, плановое обслуживание, восстановление, завершение восстановления и общая информация), их показывают на портале и рассылают по почте. Чтобы анонс видели и те, кто ещё не вошёл в систему, публичный доступ включают флажком Public на странице и на виджете.
Заранее: шаблоны анонсов и настроенный публичный портал.
12:00, «А что нам делать, пока оно лежит?»
Давайте представим условную бухгалтерию. До обеда нужно отправить три платёжки, а банковский клиент ходит через облачный шлюз. Как поступать в таком случае, знал Вася: у него лежала выгрузка и сертификат на флешке. Вася уволился в мае, инструкцию он оставил, но в вики, а вики живёт в том же облаке.
Обходной путь нельзя придумывать на ходу, его нужно согласовать до аварии, иначе в полдень придётся выяснять, кто вправе принять решение. Удобно начать с таблицы, где у каждой критичной услуги есть запасной вариант и ответственный. Ниже пример строк, подставьте свои.
Что не работает |
Обходной путь |
Кто решает |
Где лежит инструкция |
|---|---|---|---|
Почта |
Запасный канал связи для критичных контактов, обзвон руководителей по телефону |
Менеджер инцидентов |
Бумажная копия у дежурного |
Банковский клиент в облаке |
Резервное рабочее место с локальным доступом или бумажное поручение в банк |
Главный бухгалтер и ИТ‑директор |
Распечатанная памятка в бухгалтерии |
Сервис‑деск в том же облаке |
Телефон дежурного и локальная таблица, записи переносятся в систему после восстановления |
Руководитель поддержки |
Распечатанная инструкция у дежурного |
Согласование договоров в облачной системе |
Печатный лист с подписями, электронная версия вносится позже |
Владелец услуги |
Папка у юриста |
В ITSM обходной путь записывают в известную ошибку: у неё есть обязательное поле «Обходное решение», а запись переходит в состояние Актуальная после согласования владельцем услуги. Таблицу из примера можно вести там же, но бумажная копия всё равно нужна.
Порядок, в котором поднимать услуги, тоже лучше выбрать заранее. Наш коллега вспоминает, что начинали со связи, потом поднимали корпоративный сайт, CRM, систему контроля версий и Jira для разработчиков, а второстепенное оставили напоследок. Опирались при этом на бизнес‑критичность услуг, которую выявляют анализом влияния на бизнес (BIA); в SimpleOne ITSM у услуги уже есть соответствующий атрибут. Идеально размеченный каталог к аварии есть не у каждой компании, но для начала хватит и десятка услуг, без которых бизнес останавливается.
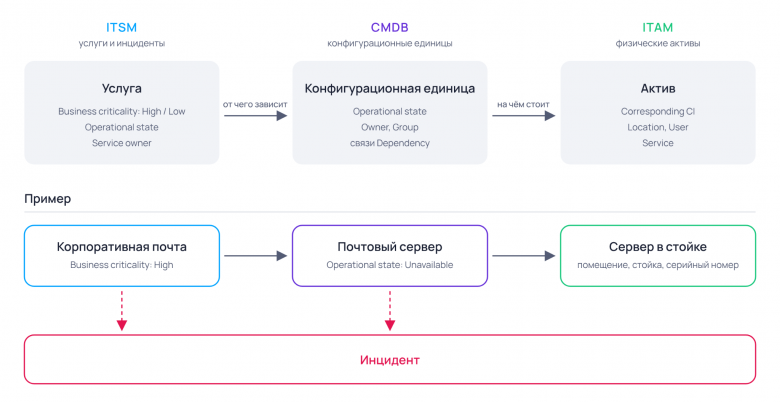
При этом, если оборудование на площадке привязано к услугам, гораздо быстрее можно выяснить, что зацепило. CMDB показывает конфигурационные единицы, а через них услуги и бизнес‑процессы (в карточке инцидента для этого есть поля Связанные КЕ и Услуга). Если такой привязки нет, список пострадавших придётся собирать по звонкам. Подробнее о связке ITSM‑системы, CMDB и системы управления ИТ‑активами рассказывали в прошлой статье на Хабре.
Заранее: записать обходные пути для критичных услуг, расставить услуги по важности и хранить копию плана на носителе, который не зависит от облака.
14:00, «Включайте резерв!»
К двум часам кто‑то из руководителей вспоминает, что в соседней зоне есть резервные серверы, и просит срочно переключить на них всё. Администратор правит правила балансировки и записи DNS напрямую, в обход процесса: так быстрее, а заявку можно оформить потом. К вечеру почта и CRM снова открываются, все выдыхают. Во вторник утром у части пользователей по‑прежнему открывается старый адрес, и никто не может сказать, что именно меняли, в каком порядке и как вернуть всё обратно.
Экстренное изменение можно провести изменение можно провести быстрее обычного, и согласования в этот момент никого не интересуют. Однако записать его всё равно придётся, пусть и после восстановления: лучше оформлять изменения и обновлять CMDB постфактум, когда сервисы уже подняты. Заранее же стоит решить, кто вправе принять такое решение без согласования и за какое время изменение нужно оформить после аварии. В плане изменения в ITSM‑системе есть фазы подготовки, основных работ, проверки и отката.
Вторник, «А почему мы узнали последними?»
Разбор лучше начинать без поиска виноватых: сотрудники поддержки и пользователи в этой истории оказались заложниками процесса, который к аварии не был готов. Чтобы следующий сбой был менее болезненным, из значительного инцидента свтоит взять хронологию, завести по ней проблему, по проблеме оформить известную ошибку с обходным решением.
Что ещё стоит проверить:
Вопрос |
Как проверить за 15 минут |
|---|---|
Записано ли, что считается значительным инцидентом и кто его объявляет? |
Найдите регламент. Если его нет, напишите три критерия и согласуйте с руководителем поддержки |
Привязаны ли критичные услуги к конфигурационным единицам в CMDB? |
Возьмите одну площадку и посмотрите, сколько услуг система покажет как пострадавшие |
Есть ли канал связи, который работает без вашего облака? |
Позвоните по списку дежурных и администраторов, проверьте, что номера актуальны |
Готовы ли шаблоны анонсов и открывается ли портал снаружи? |
Откройте публичный портал с личного телефона вне корпоративной сети, проверьте, что текст примера анонса уже лежит в системе |
Записаны ли обходные пути для пяти самых критичных услуг? |
Проверьте, что у каждой есть владелец и инструкция, которую можно открыть без облака |
Есть ли бумажная копия порядка восстановления услуг и список ответственных? |
Распечатайте, раздайте руководителям и уточните дату последнего обновления |
Рано или поздно сбой у облачного провайдера случится снова, и от подготовки зависит, сможете ли вы хоть чуть‑чуть управлять последствиями. А у вас обходные пути для критичных услуг записаны где‑то вне облака, и сколько людей знает, где они лежат?
Alex_Yudashkin
У нас инструкции на такой случай лежали в конфлюенсе, который хостился там же. Теперь думаем раз в квартал распечатывать и класть дежурному в папку)) выглядит дико, зато может пригодиться