

Привет, Хабр! На связи системный аналитик Илья Глазунов и разработчик Кирилл Дунаев. Мы работаем с платформой аналитического карточного хранилища Т-Банка. Попутно открываем все новые грани одного из главных компонентов нашего детища — Apache Cassandra.
Мы уже изучили тонну материалов, сами стали носителями знаний, делимся ими в команде и на Хабре. Но не перестаем натыкаться на интересные механики и особенности Cassandra, которые приходится разбирать по принципу «с миру по нитке».
Та механика, о которой пойдет речь, могла проявиться только в системе со специфическим дизайном, предназначенной для очень конкретных задач, при значительной нагрузке на запись и высоком коэффициенте параллельности.
В статье разберем, почему утверждение «Cassandra — колоночная БД» частично верное. Приоткроем занавес, как база данных работает с мета-данными и объединением неизменяемых файлов при высокой пишущей нагрузке. А еще подискутируем на тему понятия атомарности операций во вселенной Apache Cassandra и разберемся, причем же тут UDT и frozen UDT.
Исходные данные
У нас есть некоторый сервис, который хранит карточные данные в зашифрованном виде. При этом данные периодически перешифровываются. Два важных аспекта для дальнейшего разбора:
Процесс перешифрования дает значительный прирост по пишущей нагрузке: примерно +10к RPS.
В процессе не используются LWT из-за увеличения response time.
Допустим, у нас есть схема данных, часть которых хранится в зашифрованном виде. Они представляются с помощью json-вида:
{

“helper_data”: “qwerty”,

“data”: “i’m encrypted”

},
Оба элемента доменно неотделимы друг от друга: потеря одного элемента приведет к тому, что данные будет невозможно расшифровать при попытке авторизованного чтения. Важно, что в алгоритме, который используется, функция шифрования не детерминирована. Два разных ее вызова на одних и тех же входных данных вернут разные пары значений "helper_data" и "data”.
Отдельно есть ключ шифрования, который выбирается при каждом старте процесса шифрования из ограниченного числа ключей по хэш-кольцу. Сам ключ хранится отдельно, мы знаем только его идентификатор (UUID). В БД у нас есть некоторый UDT, состоящий из data — base64 от json-структуры выше с зашифрованными данными, а key_id — идентификатор ключа шифрования:
create type encrypted_data (
data_json text,
key_id uuid
);
Сама таблица с хранимыми элементами пусть выглядит так:
create table items
(
item_id uuid primary key,
encrypted_item encrypted_data,
);
Мы осознаем, что хранить base64 от сырого json в Cassandra неэффективно, но акцентировать внимание на этом в статье не будем.
Суть кейса
В пиковые моменты пишущей нагрузки возникали ошибки дешифровки данных: при последующем чтении данных key_id не подходил для data_json. Это происходило, когда разные инстансы одновременно приносили запросы на создание одинаковой сущности — объектов, имеющих одинаковый item_id и бизнес-наполнение. В ходе анализа мы выяснили, что data_json иногда был записан одним инстансом сервиса, а key_id — другим. Подобные кейсы возникали относительно редко: один случай на несколько сот миллионов записей. Давайте разберемся, почему такое вообще может происходить.
Удивительно еще и то, что в документации Cassandra черным по белому написано: All updates for an INSERT are applied atomically and in isolation. Впоследствии мы убедились, что понятие «атомарность» может иметь достаточно вариативную трактовку, но об этом позднее.
Первая попытка решить проблему
Мы предположили, что проблема — в отсутствии подобных по атомарности и изолированности гарантий для обычных UDT, то есть не frozen. frozen UDT отличается от обычного тем, что frozen расценивается как атомарный blob: вы не можете обновлять отдельные его части — требуется upsert всего объекта целиком. Не разобравшись досконально, что такое атомарность в рамках данной БД, мы решили, что перевести все данные в различные колонки (и из udt, и из json) — хорошая идея. Получилась таблица вида:
(
item_id uuid primary key,
helper_data text,
data text,
key_id uuid
);
Это только усугубило ситуацию: стали ломаться зависимые друг от друга колонки data и helper_data, из-за чего данные невозможно было дешифровать.
И тут мы пришли к мысли из заголовка статьи: запись строится в рамках колонок.
Попытка осознать атомарность заново
Разбираемся, что такое атомарность в Cassandra. При записи данные записываются в неизменяемые файлы, а уже при чтении эти записи читаются и на их основе вычисляется реальное значение запрашиваемой колонки.
Важно, что у каждой колонки есть метаданные, содержащие время записи и другую полезную метаинформацию, например оставшееся время жизни — TTL.
TTL можно назначить несколькими способами:
Вручную при запросе вставки (обновления) с помощью конструкции "USING TIMESTAMP x", где x — значение времени в unix-микросекундах.
втоматически на уровне координатора Cassandra — на одном из узлов кластера, на который пришел запрос от клиента.
Автоматически на уровне драйвера приложения клиента. Такой способ — это дефолтное поведение в новых версиях драйверов.
Важную роль тут играют метаданные, особенно timestamp. Чтобы в этом убедиться, посмотрим часть одной из предыдущих статей, где мы описывали процессы чтения и записи:
«Последовательность шагов для записи данных:
1. Появляется запись в конце журнала фиксации.
2. Данные добавляются в таблицу памяти.
3. Если в данных содержатся строки, которые хранятся в кэше, строка объявляется недействительной в кэше.
4. Если таблица в памяти или журнал фиксации достигла порога объема данных, она сбрасывается в файл SSTable на диске.
5. Узел-координатор при наличии незавершенных операций записи в другие узлы-реплики создает напоминания».
Добавим к этому, что SSTables со временем мерджатся между собой. Держим это в голове.
«Рассмотрим путь чтения по компонентам:
1. Строка ищется в кэше, в котором хранятся строки, к которым чаще всего обращаются клиенты.
2. Если в кэше строк ничего не найдено, поиск идет по кэшу ключей.
3. Если в обоих кэшах по запросу пусто, идет чтение в таблицах в памяти.
4. Если на всех уровнях кэша данные отсутствуют, идет чтение из долгосрочного источника хранения — SSTable. Если информация найдена в файле строковой таблицы, данные копируются в кэш строк (здесь же отрабатывает и фильтр Блума)».
И вот тут интересное: когда клиент попытается прочитать колонку по записанному ключу, Cassandra увидит эти две записи внутри одного файла и ей придется выбрать, какую показать. И это будет по алгоритму. Запись с наибольшим "timestamp", описанным выше:
При одинаковых
"timestamp"выбирается DELETE-операция;Если и
"timestamp"и типы операции одинаковые, выбирается лексикографически наибольшая.
Выбор актуальной версии записи происходит и при compaction разных SSTables.
Дьявол кроется в деталях: как “timestamp” записи свой для каждой колонки, так и при чтении нескольких колонок алгоритм выше запускается для каждой колонки отдельно. При записи “timestamp” назначается одинаковым для всех колонок в запросе с точностью до микросекунд.
Работает это так: два инстанса сервиса параллельно шифруют одни и те же данные → получают на выходе разные значения "data", "helper_data" и "key_id" → записывают их в Cassandra с одним и тем же "item_id". Иногда при большой нагрузке время записи "timestamp" совпадает, тогда при чтении этих данных мы видим для каждой колонки лексикографически большее значение из обоих запросов. Некоторые колонки попадают из первого запроса, а некоторые — из второго.
Эффект легко воспроизводится: вставим последовательно две записи и зафиксируем одинаковый "timestamp" вручную:
insert into items (item_id, data, helper_data, key_id)

values (00000000-0000-0000-0000-000000000000, 'aData', 'fHelper', 20000000-0000-0000-0000-000000000000)
using timestamp 200;

insert into items (item_id, data, helper_data, key_id)
values (00000000-0000-0000-0000-000000000000, 'bData', 'bHelper', 40000000-0000-0000-0000-000000000000)
using timestamp 200;
Тогда запрос вида
select item_id, data, helper_data, key_id from items
where item_id=00000000-0000-0000-0000-000000000000;
вернет следующий объект:
[
  {
    "item_id": "00000000-0000-0000-0000-000000000000",
    "data": "bData",
    "helper_data": "fHelper",
    "key_id": "40000000-0000-0000-0000-000000000000"
  }
]
Видим, что колонки data и key_id пришли из второго запроса, а helper_data — из первого.
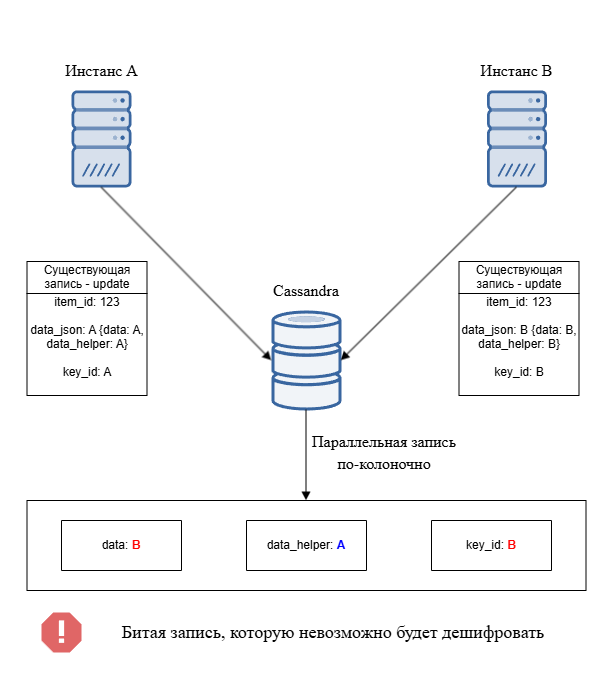
В документации гарантирована атомарность операции. На практике это означает, что либо применятся все изменения, либо не применится ни одно, без возможности видеть промежуточные состояния.
Мы видим вроде бы частично примененный первый и частично примененный второй запросы, но на самом деле обе операции применились полностью: обе записи успешно записаны в неизменяемые файлы, все изменения применились. Наблюдаемый эффект — результат описанного алгоритма чтения данных (или compaction), атомарность не была нарушена. Нет гарантий на атомарность строки как объекта — есть лишь на атомарность операции.
Объект для работы в Cassandra — это колонка, а не строка. Ситуаций, где это важно, много: похожий эффект можно наблюдать с TTL, когда удаляется значение лишь одной колонки, а не всей строки. Об этом эффекте писали наши коллеги из смежного проекта.
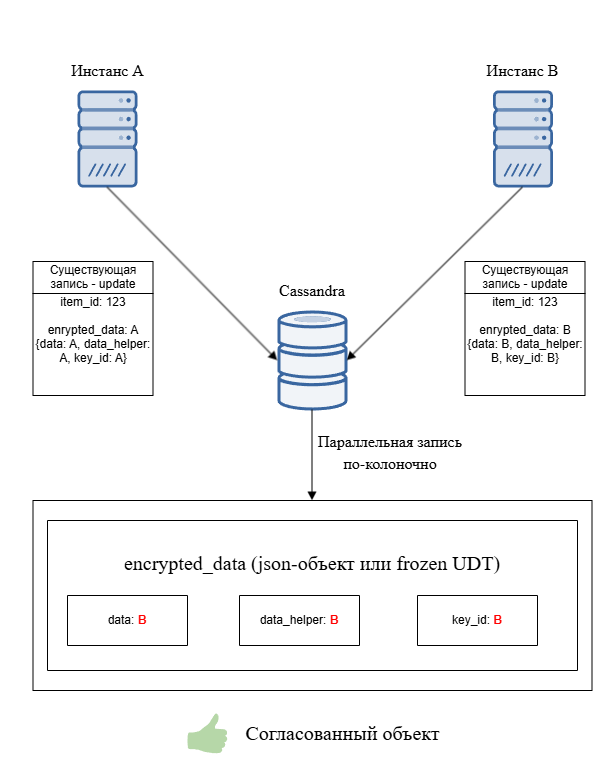
Наш случай разрешается путем записи всех взаимосвязанных данных либо в одну колонку, либо во frozen UDT. Варианты не сильно отличаются, ведь The database treats the value of a frozen, user-defined type like a blob.
Вариант записи взаимосвязанных данных в одну колонку:
create table items
 (
 item_id uuid primary key,
 encrypted_data text,
 );
 где encrypted_data - json вида
 {
 "helper_data": "qwerty",
 "data": "i'm encrypted",
 "key_id": "40000000-0000-0000-0000-000000000000"
 }
Пробуем запись по измененной модели:
insert into items (item_id, encrypted_data)
 values (00000000-0000-0000-0000-000000000000, '{"helper_data": "aData", "data":"fHelper", "key_id":"20000000-0000-0000-0000-000000000000"}')
 using timestamp 200;

insert into items (item_id, encrypted_data)
 values (00000000-0000-0000-0000-000000000000, '{"helper_data": "bData", "data":"bHelper", "key_id":"40000000-0000-0000-0000-000000000000"}')
 using timestamp 200;

select * from items;
И получаем объект вида:
[
 {
 "item_id": "00000000-0000-0000-0000-000000000000",
 "encrypted_data": "{"helper_data": "bData", "data":"bHelper", "key_id":"40000000-0000-0000-0000-000000000000"}"
 }
 ]
Иной вариант, когда udt у нас с типом frozen:
create type encrypted_data (
 data_json text,
 key_id uuid
 );
 create table items
 (
 item_id uuid primary key,
 encrypted_item frozen<encrypted_data>,
 );
Пробуем вставить объект с frozen udt:
insert into items (item_id, encrypted_item)
values (00000000-0000-0000-0000-000000000000, {helper_data: 'aData', data:'fHelper', key_id:20000000-0000-0000-0000-000000000000})
using timestamp 200;

insert into items (item_id, encrypted_item)
values (00000000-0000-0000-0000-000000000000, {helper_data: 'bData', data:'bHelper', key_id:40000000-0000-0000-0000-000000000000})
using timestamp 200;

select * from items;
И получаем при прочтении объект вида:
[
 {
 "item_id": "00000000-0000-0000-0000-000000000000",
 "encrypted_item": "{helper_data:'bData',data:'bHelper',key_id:40000000-0000-0000-0000-000000000000}"
 }
 ]
Выводы
Записи данных в одну колонку и во frozen UDT мало отличаются от первоначальной модели данных, но даже такое маленькое изменение в корне меняет правила игры. Теперь Cassandra считает данные шифрования единой колонкой и после выполнения параллельной записи при чтении будет лексикографически сравнивать не отдельные поля, а целиком весь объект. encrypted_data — в варианте с записью в одну колонку вида json, encrypted_item — в варианте с frozen UDT. Так мы смогли добиться нужной нам атомарности объекта, а не только операции. Хотя формально это все еще атомарность в разрезе операции.
Надеемся, что статья помогла чуть больше погрузиться в механики записи и чтения в Apache Cassandra. А еще взяли на заметку более пристальное чтение документации, так как там часто можно увидеть знакомое понятие, интерпретировать его в свою пользу и основывать на этом принятие решений, которые в будущем могут повлечь неожиданные последствия.
Век живи — век учись!