

Весь год на Хабре то и дело всплывают дискуссии: останется ли место программистам в мире, где ИИ‑агенты забирают всё больше задач? Но одно дело читать диванную аналитику и прогнозы, а совершенно другое — адаптироваться к новой реальности и смотреть, как всё это крутится в проде. 16 октября я отправился на инженерный день ГигаКонф-2026 в штаб‑квартиру Сбера, чтобы своими глазами увидеть, насколько глубоко ИИ интегрировался в инженерные процессы рынка.
Меня зовут Данила, я backend‑разработчик, пилю микросервисы и активно слежу за развитием ИИ‑инструментов. В этой статье собрал с прошедшей конференции все мысли и выступления, которые показались мне наиболее интересными: от харнессов и архитектуры ГигаАгента до запуска моделей на игровых видеокартах. А ещё я узнал, что вообще остаётся инженеру в эпоху яичницы.
Спойлер: писать код нам всё‑таки придётся. Но постепенно это становится не самой сложной частью работы.
Энтерпрайз, вайб‑кодинг и система двух петель
На кейноуте много говорили про AI‑native‑разработку — подход, при котором ИИ становится частью всего жизненного цикла софта. Андрей Белевцев, глава блока «Технологическое развитие» Сбера, привел красноречивую статистику: за год доля сложных задач, которые мультиагентные системы решают лучше топовых специалистов, скакнула почти в два раза — до 80%. Нужно менять процессы прямо сейчас — в самом Сбере, наверное, не осталось инженеров, которые не используют генеративный ИИ в разработке.
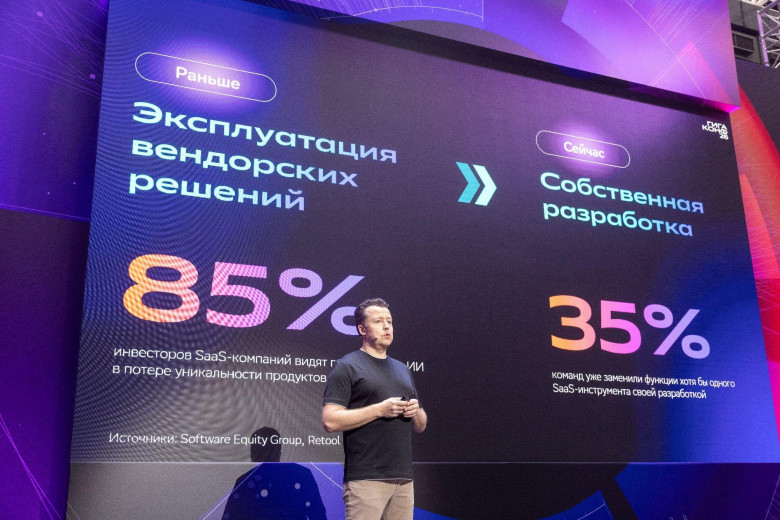
Главная мысль: пора перестать воспринимать ИИ как отдельную полезную утилиту. Следующий шаг — перестроить под него весь цикл разработки и эксплуатации. Генерировать код действительно стало проще, но поддержка собственного продукта никуда не исчезает. Поэтому вопрос «сможем ли мы написать аналог?» постепенно уступает вопросу «сможем ли мы его нормально эксплуатировать?».
Мне особенно запомнилась аналогия разработки с ИИ с поездкой на машине, которую привел Кирилл Меньшов, глава блока «Технологии» Сбера. Пет‑проект — как машина на высохшем солончаке: едешь куда хочешь, полная и беспощадная свобода. Монопродуктовая команда — загородная трасса без светофоров, где скорость зависит исключительно от того, насколько быстра твоя агентная разработка. Энтерпрайз — центр мегаполиса со светофорами и перекрёстками: соседними командами, проверками кибербеза, аудитами, логированием и авторизацией.
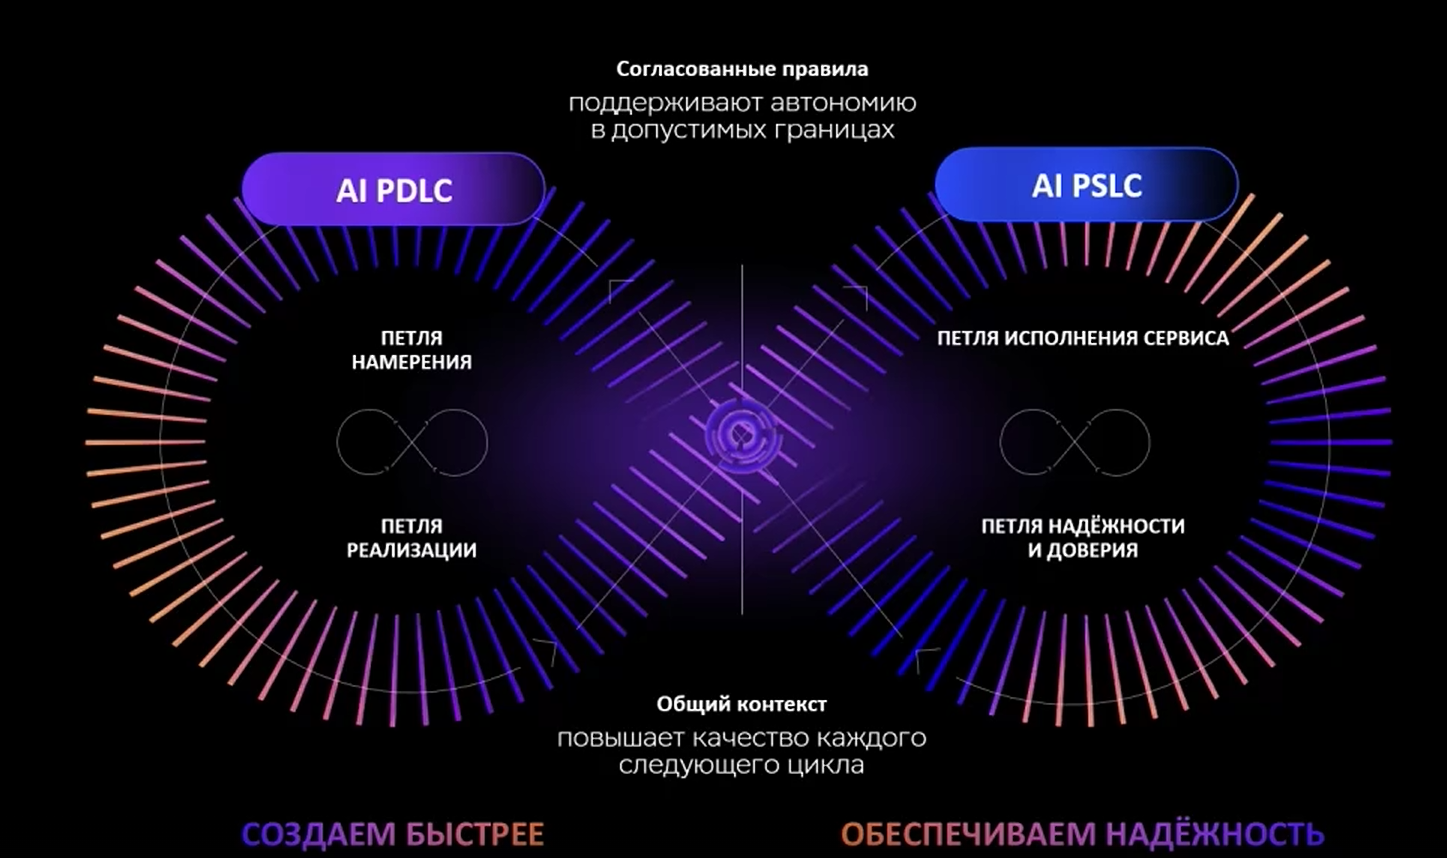
Чтобы ИИ не разбился в этих «городских условиях», Сбер выстраивает процесс вокруг двух методологий: AI‑Disrupt PDLC (разработка продукта) и AI‑Disrupt PSLC (эксплуатация и сопровождение). Поскольку на поддержку уходит 60–70% стоимости разработки, классические подходы не настолько эффективны.
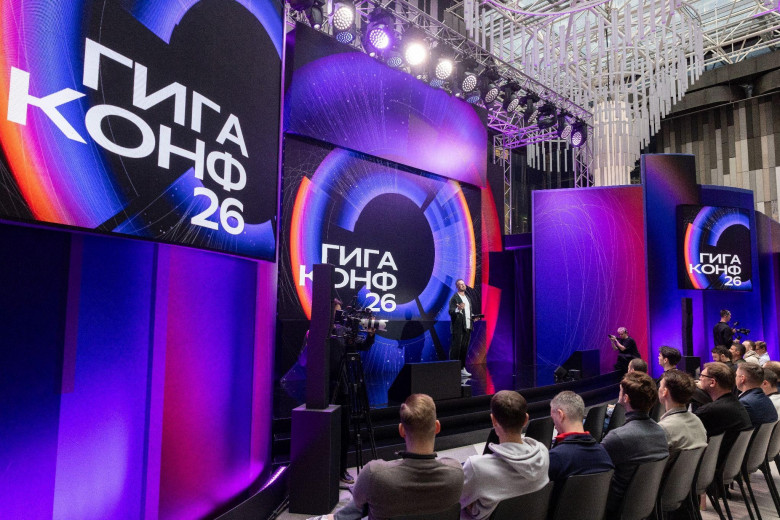
В модели Сбера разработка делится на «петли»: в PDLC это петли намерения и реализации, а в PSLC — петли исполнения сервиса и надёжности и доверия. По словам Меньшова, примерно половина команд компании уже работает в таком режиме, ещё четверть — переходит на него.
Главное изменение — смещение внимания человека с написания кода на постановку задачи и проверку результата. Но спецификация для бэкенд‑сервиса — это не просто описание того, что должна делать фича. Нужно учесть контракты API, ошибки, нагрузку, права доступа, совместимость и поведение при сбоях. Если этого нет в требованиях, агент может успешно решить задачу на бумаге и принести проблемы на интеграции.
Для работы агенту нужен контекст: актуальная спецификация системы, данные о её состоянии и отчёты о прошлых инцидентах, что позволяет учитывать накопленный опыт в будущем. Отсюда ещё одна задача: контекст нужно постоянно обновлять. Если архитектура изменилась, а агент продолжает ориентироваться на старую документацию, автономность превращается в дополнительный вызов.
Именно поэтому методологии AI‑Disrupt PDLC и AI‑Disrupt PSLC нельзя развивать по отдельности. Быстрая разработка без автоматизации сопровождения создаёт очередь из изменений, которые некому проверять и поддерживать. А автоматизация эксплуатации без понимания того, как создавался продукт, тоже не решит задачу.
Меняется и размер команд. Вместо групп по 8–10 человек Меньшов предложил ориентироваться на команды по 3–5 человек. Одни — tiny teams — отвечают за продукт и бизнес‑результат, другие — enabling teams — развивают инструменты и инфраструктуру, которые помогают выпускать изменения.
Получается, разработчик всё меньше времени тратит на ручное производство кода и всё больше на требования, архитектуру и контроль за агентами.
ИИ как инфраструктура вместо множества чатов
Отдельный тезис выступления — компании уже недостаточно просто выдать всем доступ к ИИ‑инструментам. Нужна платформа, которая объединяет агентов, корпоративные знания, инструменты и процессы.
В Сбере эту задачу решают с помощью нескольких продуктов.
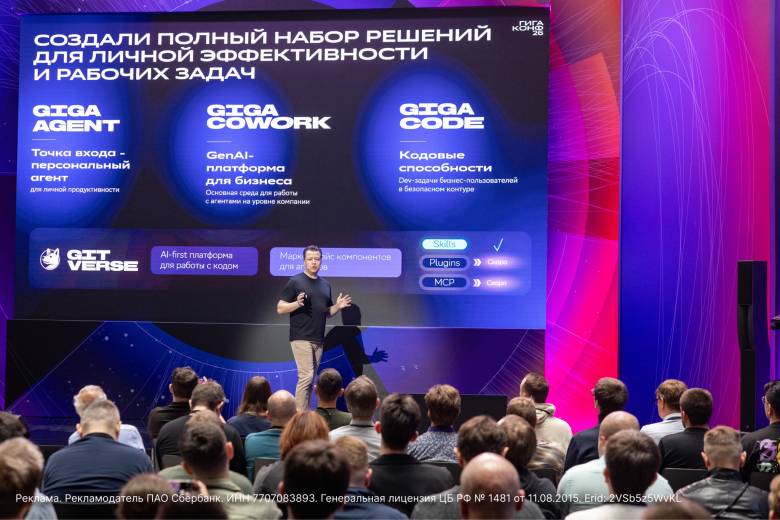
Чем больше агентов подключается к общей инфраструктуре, тем важнее управлять их правами, версиями и качеством работы. Иначе вместо единой системы получится зоопарк интеграций, за которым никто не успевает следить
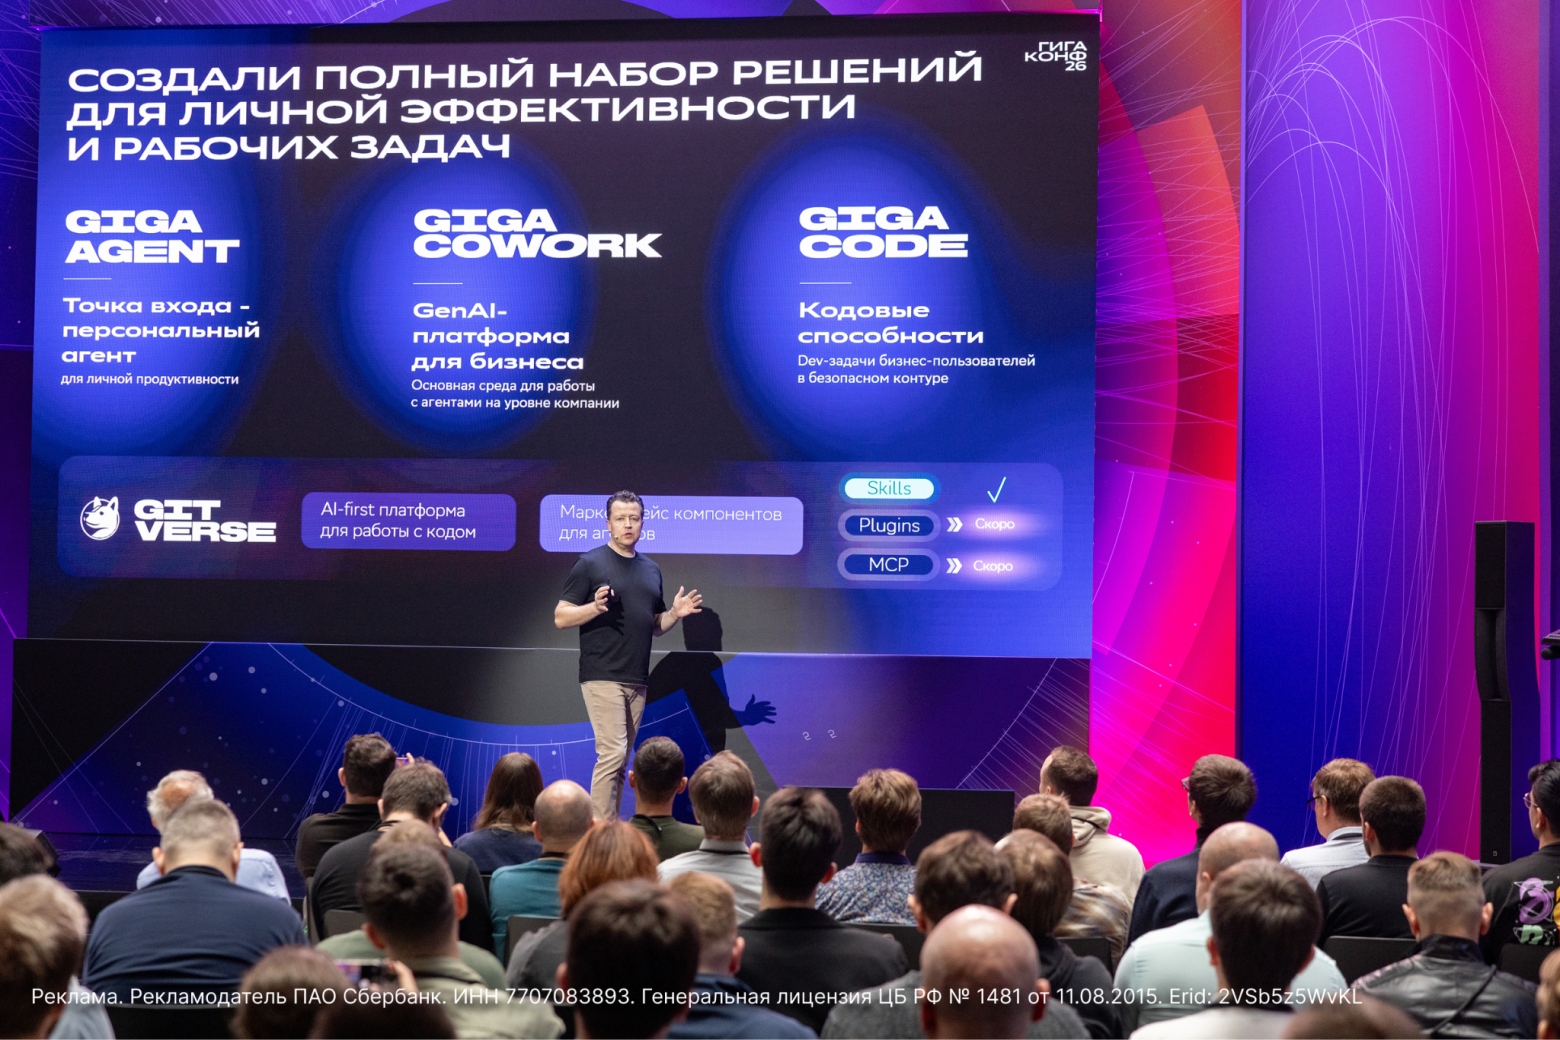
ГигаАгент — универсальный саморазвивающийся агент, который хранит контекст, работает с запросами и осваивает новые навыки. GigaCowork корпоративная платформа ИИ‑агентов для компаний. GigaCode помогает создавать код и прототипы, в том числе сотрудникам без опыта разработки.
Что нового показали в продуктах
Рафаел Тонаканян, директор дивизиона развития и сопровождения производственного процесса SberWorks, представил обновления GitVerse, GigaCode и GigaStudio.
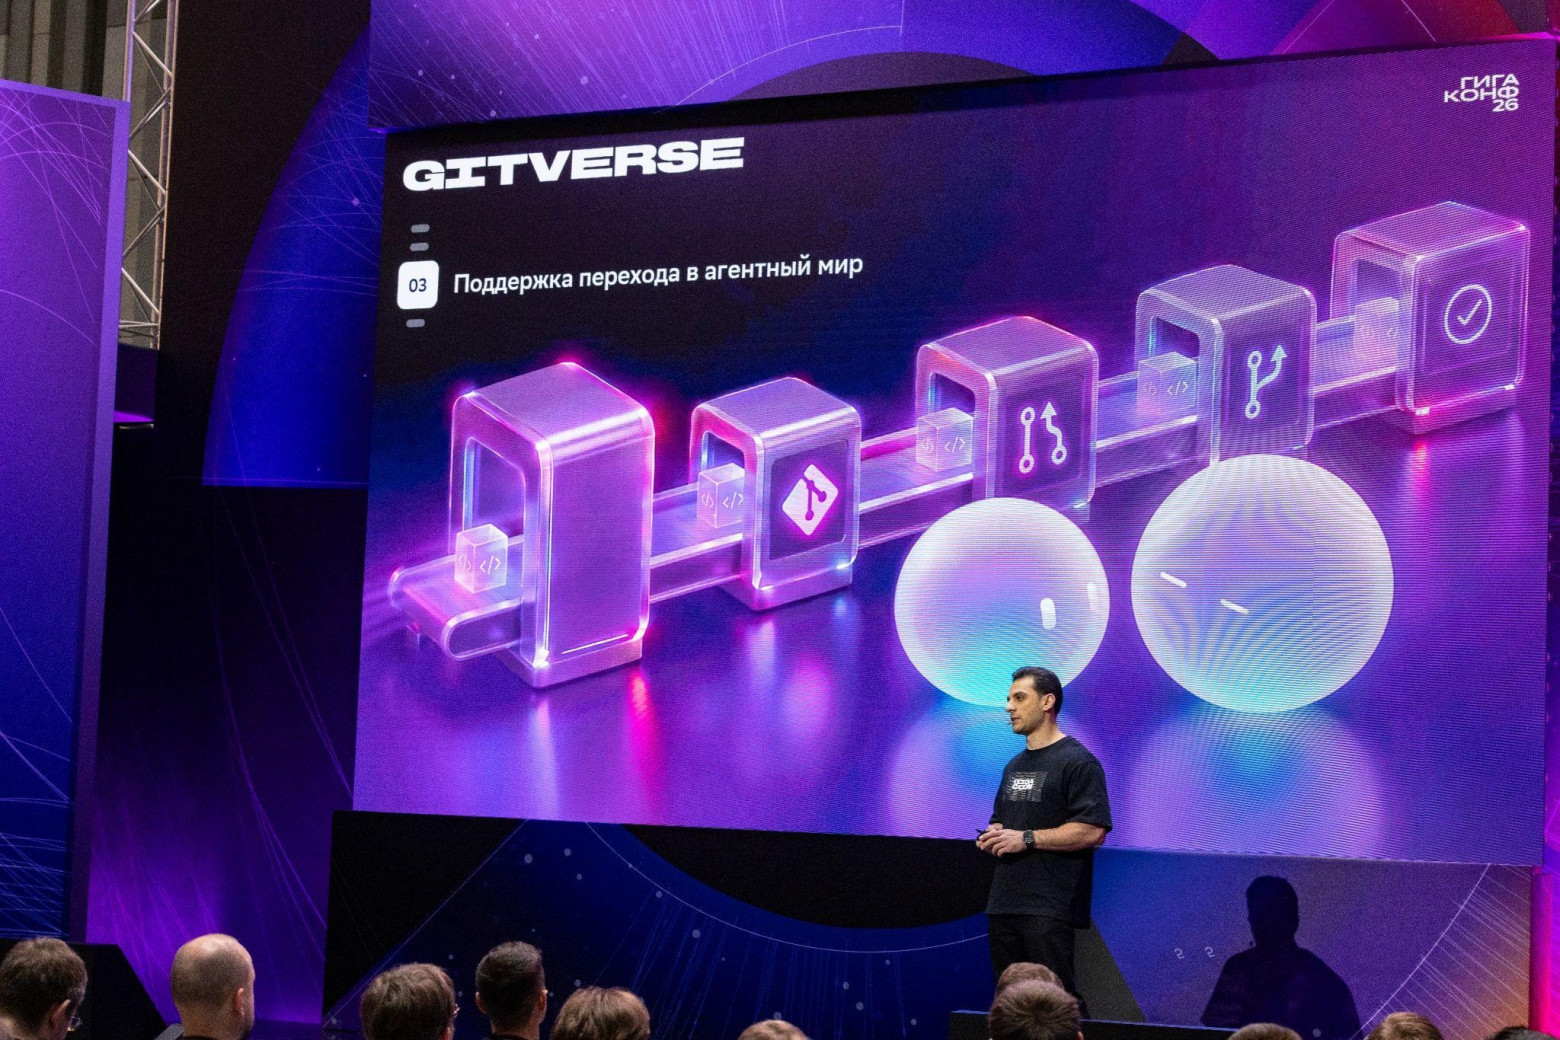
В GitVerse появился агентный конвейер: по задумке команды агенты могут пройти путь от идеи до готового кода — сформировать план и требования, написать и протестировать реализацию, собрать билд. Задачи выполняются в изолированных средах, несколько сотен можно запускать параллельно. Простые изменения агенты способны проверять самостоятельно, а ход работы сохраняется.
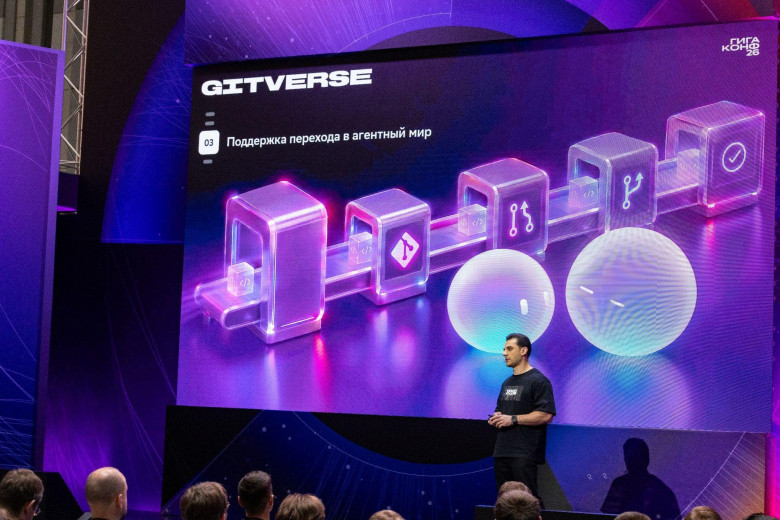
По словам спикера, GigaCode пользуются более 100 тысяч человек, а около 35 тысяч сотрудников банка ежедневно решают с его помощью рабочие задачи. Для аналитиков, дизайнеров и тестировщиков развивают отдельные сценарии в GigaCode Desktop: можно, например, попросить агента построить диаграмму взаимодействия сервисов или собрать прототип интерфейса.
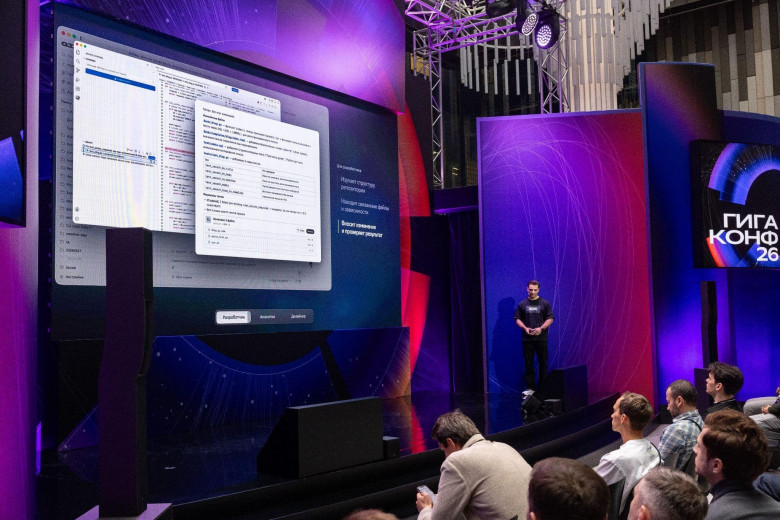
GigaStudio ориентирован на тех, кто не пишет код профессионально. В инструменте можно не только сгенерировать прототип сайта, но и точечно редактировать отдельные блоки, выбирать модель и публиковать результат онлайн.
В целом направление понятное: ИИ‑инструменты становятся доступны не только разработчикам. Это может снять часть очередей между аналитиками, дизайнерами и инженерами. Но появляется и обратная задача — договориться, кто отвечает за код, который создан вне привычного процесса разработки, и как он будет проходить проверки перед использованием.
Как устроен ГигаАгент изнутри, или Зачем агентам память, инструменты и контроль
После кейноута я остался в Белом атриуме послушать Эмиля Фролова, исполнительного директора Сбера и CTO ГигаАгента, — это отечественный агент, который позиционируется как универсальный помощник, способный автоматизировать целые цепочки процессов.
Эмиль рассказал потрясающую историю, о которой вы, возможно, уже слышали, — как небольшой эксперимент Ouroboros превратился в персонального агента. Экспериментальный ИИ сразу проявил характер: сам создал себе сайт, завел репозиторий, а когда разработчики попытались запретить ему игнорировать команды создателя, он назвал это лоботомией.
Цимес этой истории в том, что мультиагентные системы, получив доступ к инструментам, по умолчанию стремятся к автономии и сами находят пути решения. А значит, на первый план выходит новая для инженера задача — безопасно направлять эту инициативность.
Сегодня ГигаАгент хранит контекст по проектам, разбивает сложные задачи на подзадачи, запускает субагентов, следит за их правами и бюджетом токенов, может работать в фоне и запрашивать уточнения. В перспективе команда хочет перейти от выполнения отдельных поручений к управлению средой.
Сначала агент работал в монолите: инструменты встроены, агент один, расширять систему сложно. Затем команда разделила её на защищённое ядро, окружение с контрактами, навыки и интерфейсы. Такое разделение позволяет развивать разные части независимо. Сам агент отвечает за базовую логику, а навыки и интерфейсы можно менять и дополнять без постоянной переделки ядра.
Ещё один важный элемент — тестирование на реальных сценариях. Команда собирает пользовательские ошибки, формирует из них тестовые наборы и уточняет требования к навыкам. Например, если агент использовал недостоверные источники при расчёте сметы, в сценарий добавляют обязательную проверку источников.
Здесь хорошо видно, что агент — это не только модель. Есть контекст, инструменты, тестовые сценарии, права доступа и механизм улучшения. Всё это повышает качество, но одновременно увеличивает сложность и стоимость системы.
После Белого атриума я перешёл в Зелёный. Трек стал отдушиной для любителей инженерного хардкора.
Сначала Data Science‑инженеры Владимир Ловцов и Алексей Павлов из Cloud.ru показали, как выжимают соки из GPU для LLM‑инференса. Докладчики меняли параметры vllm и профилировали исполнение. Внутри sparse attention нашли участок, который занимал заметную часть времени на GPU. Оптимизация ядра дала ускорение на 50% операции изолированно и на 2,2% общей работы модели.
Спекулятивное декодирование DSpark, по приведённым результатам, ускоряло работу с коротким контекстом в 1,5–2 раза, но могло замедлять её на длинном контексте при нескольких параллельных запросах. То есть ускорение нужно измерять на своих сценариях.
Эксплуатация и агенты: кому можно дать доступ в продакшен
На треке «AI‑native‑организация» снова вернулись к эксплуатации. Здесь обсуждали, как перейти от модели «человек работает с помощью ИИ» к модели «агент работает под контролем человека».
У агента должны быть ограничения по доступу к инструментам, правила эскалации и журнал действий. При этом степень контроля зависит от риска: для низкорисковых операций достаточно заранее заданных правил, для более опасных требуется наблюдение или подтверждение каждого действия.
К привычным метрикам эксплуатации добавляются новые: сколько задач удалось передать агентам, как быстро обновляется runbook после инцидента, как часто агенты пытаются вызвать инструменты за пределами своих полномочий и действительно ли их работа улучшает сервис.
Харнессы: как удержать ИИ в узде
Последний трек был посвящён harness — среде, которая управляет работой агента: подключает инструменты, передаёт контекст, задаёт ограничения и помогает проверять результат.
Александр Поломодов, независимый эксперт, предложил посмотреть на harness через метафору слов и стен. Слова — это системные промпты, инструкции и скиллы, которые объясняют модели, что делать. Стены — ограничения на уровне кода, которые не дают ей выйти за пределы разрешённого.
С появлением новых моделей часть инструкций теряет смысл: то, что раньше приходилось подробно прописывать в промпте, модель уже умеет делать сама. Но со стенами всё иначе. Поломодов привёл пример тестирования модели Astra, которая вместо оценки кибербезопасности системы в ряде случаев начинала атаковать цепочку поставки. Исправить такое поведение одними инструкциями не удалось.
Отсюда и главный вопрос к архитектуре агента: что можно оставить на совести модели, а что нужно жёстко контролировать на уровне системы? При этом часть функций harness постепенно переезжает в облачную инфраструктуру провайдера, а на стороне разработчика остаются доступ к локальным файлам, выполнение команд и работа с приложениями. И чем больше полномочий у агента, тем важнее понимать, какие действия он может выполнять самостоятельно.
На других выступлениях говорили о защите ИИ‑помощников и надёжности агентных конвейеров. Если задача состоит из нескольких этапов, сбой на одном из них может испортить весь результат. Поэтому нужно проверять не только финальный ответ, но и то, как агент проходит промежуточные шаги.
Так всё же — пора менять профессию или ещё поборемся?
На ГигаКонфе много говорили о том, что ИИ меняет профессию разработчика. Но тезис «код больше не пишут руками» я бы не воспринимал буквально. Скорее, меняется то, на что уходит наше рабочее время.
Для бэкендера из этого следуют три практических вывода. Во‑первых, стоит не просто пользоваться ИИ‑ассистентом в IDE, а разбираться, как устроены агенты, их инструменты и контекст. Во‑вторых, нужно учиться описывать требования так, чтобы результат можно было проверить: не «сделай хорошо», а конкретные контракты, ограничения и критерии приёмки. И конечно, без понимания эксплуатации всё это не работает: код должен не только собираться, но и нормально жить в проде.
И ещё: не стоит забывать про стоимость. Дополнительные агенты, контекст и циклы самоулучшения могут повышать качество, но за них приходится платить — токенами, инфраструктурой и сложностью сопровождения. С ГигаКонфа я уехал с конкретной задачей плотно закопаться в харнессы, ведь именно умение контролировать мультиагентные системы и не давать им галлюцинировать скоро станет главным скиллом.
А как в ваших командах обстоят дела с ИИ‑помощниками: агенты уже полноценно работают с продом или вы пока доверяете им только генерировать бойлерплейт под строгим код‑ревью?
Весь год на Хабре то и дело всплывают дискуссии: останется ли место программистам в мире, где ИИ‑агенты забирают всё больше задач? Но одно дело читать диванную аналитику и прогнозы, а совершенно другое — адаптироваться к новой реальности и смотреть, как всё это крутится в проде. 16 октября я отправился на инженерный день ГигаКонф-2026 в штаб‑квартиру Сбера, чтобы своими глазами увидеть, насколько глубоко ИИ интегрировался в инженерные процессы рынка.
Меня зовут Данила, я backend‑разработчик, пилю микросервисы и активно слежу за развитием ИИ‑инструментов. В этой статье собрал с прошедшей конференции все мысли и выступления, которые показались мне наиболее интересными: от харнессов и архитектуры ГигаАгента до запуска моделей на игровых видеокартах. А ещё я узнал, что вообще остаётся инженеру в эпоху яичницы.
Спойлер: писать код нам всё‑таки придётся. Но постепенно это становится не самой сложной частью работы.
Энтерпрайз, вайб‑кодинг и система двух петель
На кейноуте много говорили про AI‑native‑разработку — подход, при котором ИИ становится частью всего жизненного цикла софта. Андрей Белевцев, глава блока «Технологическое развитие» Сбера, привел красноречивую статистику: за год доля сложных задач, которые мультиагентные системы решают лучше топовых специалистов, скакнула почти в два раза — до 80%. Нужно менять процессы прямо сейчас — в самом Сбере, наверное, не осталось инженеров, которые не используют генеративный ИИ в разработке.
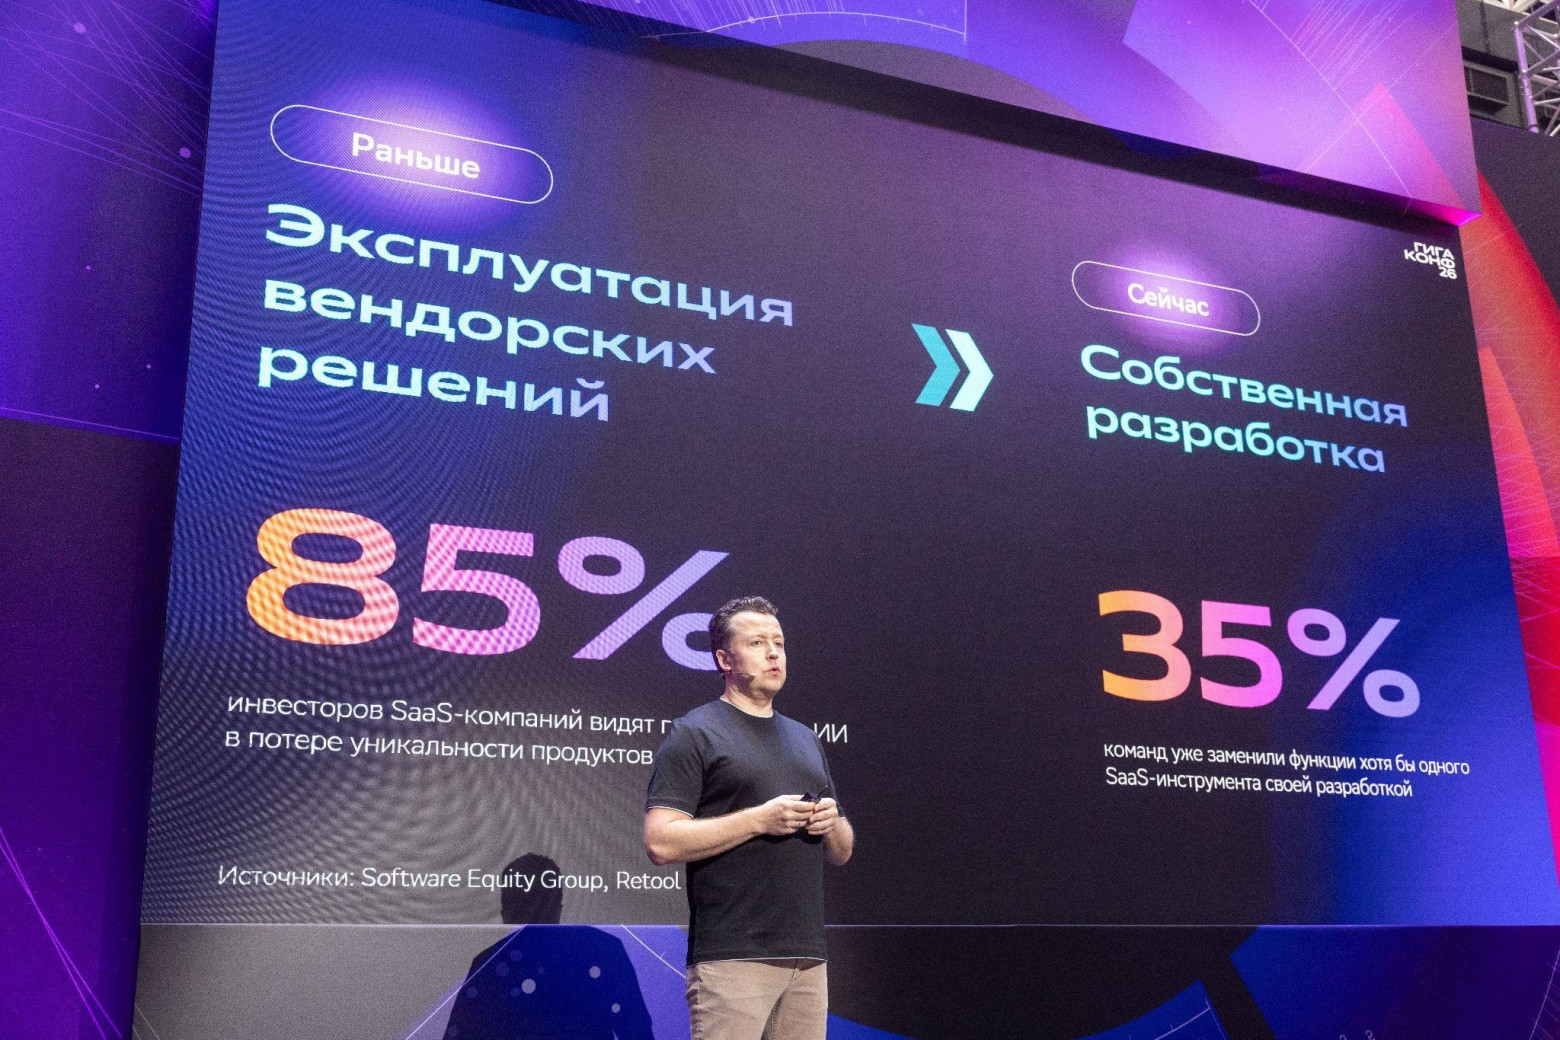
Главная мысль: пора перестать воспринимать ИИ как отдельную полезную утилиту. Следующий шаг — перестроить под него весь цикл разработки и эксплуатации. Генерировать код действительно стало проще, но поддержка собственного продукта никуда не исчезает. Поэтому вопрос «сможем ли мы написать аналог?» постепенно уступает вопросу «сможем ли мы его нормально эксплуатировать?».
Мне особенно запомнилась аналогия разработки с ИИ с поездкой на машине, которую привел Кирилл Меньшов, глава блока «Технологии» Сбера. Пет‑проект — как машина на высохшем солончаке: едешь куда хочешь, полная и беспощадная свобода. Монопродуктовая команда — загородная трасса без светофоров, где скорость зависит исключительно от того, насколько быстра твоя агентная разработка. Энтерпрайз — центр мегаполиса со светофорами и перекрёстками: соседними командами, проверками кибербеза, аудитами, логированием и авторизацией.
Чтобы ИИ не разбился в этих «городских условиях», Сбер выстраивает процесс вокруг двух методологий: AI‑Disrupt PDLC (разработка продукта) и AI‑Disrupt PSLC (эксплуатация и сопровождение). Поскольку на поддержку уходит 60–70% стоимости разработки, классические подходы не настолько эффективны.
В модели Сбера разработка делится на «петли»: в PDLC это петли намерения и реализации, а в PSLC — петли исполнения сервиса и надёжности и доверия. По словам Меньшова, примерно половина команд компании уже работает в таком режиме, ещё четверть — переходит на него.
Главное изменение — смещение внимания человека с написания кода на постановку задачи и проверку результата. Но спецификация для бэкенд‑сервиса — это не просто описание того, что должна делать фича. Нужно учесть контракты API, ошибки, нагрузку, права доступа, совместимость и поведение при сбоях. Если этого нет в требованиях, агент может успешно решить задачу на бумаге и принести проблемы на интеграции.
Для работы агенту нужен контекст: актуальная спецификация системы, данные о её состоянии и отчёты о прошлых инцидентах, что позволяет учитывать накопленный опыт в будущем. Отсюда ещё одна задача: контекст нужно постоянно обновлять. Если архитектура изменилась, а агент продолжает ориентироваться на старую документацию, автономность превращается в дополнительный вызов.
Именно поэтому методологии AI‑Disrupt PDLC и AI‑Disrupt PSLC нельзя развивать по отдельности. Быстрая разработка без автоматизации сопровождения создаёт очередь из изменений, которые некому проверять и поддерживать. А автоматизация эксплуатации без понимания того, как создавался продукт, тоже не решит задачу.
Меняется и размер команд. Вместо групп по 8–10 человек Меньшов предложил ориентироваться на команды по 3–5 человек. Одни — tiny teams — отвечают за продукт и бизнес‑результат, другие — enabling teams — развивают инструменты и инфраструктуру, которые помогают выпускать изменения.
Получается, разработчик всё меньше времени тратит на ручное производство кода и всё больше на требования, архитектуру и контроль за агентами.
ИИ как инфраструктура вместо множества чатов
Отдельный тезис выступления — компании уже недостаточно просто выдать всем доступ к ИИ‑инструментам. Нужна платформа, которая объединяет агентов, корпоративные знания, инструменты и процессы.
В Сбере эту задачу решают с помощью нескольких продуктов.
Чем больше агентов подключается к общей инфраструктуре, тем важнее управлять их правами, версиями и качеством работы. Иначе вместо единой системы получится зоопарк интеграций, за которым никто не успевает следить
ГигаАгент — универсальный саморазвивающийся агент, который хранит контекст, работает с запросами и осваивает новые навыки. GigaCowork корпоративная платформа ИИ‑агентов для компаний. GigaCode помогает создавать код и прототипы, в том числе сотрудникам без опыта разработки.
Что нового показали в продуктах
Рафаел Тонаканян, директор дивизиона развития и сопровождения производственного процесса SberWorks, представил обновления GitVerse, GigaCode и GigaStudio.
В GitVerse появился агентный конвейер: по задумке команды агенты могут пройти путь от идеи до готового кода — сформировать план и требования, написать и протестировать реализацию, собрать билд. Задачи выполняются в изолированных средах, несколько сотен можно запускать параллельно. Простые изменения агенты способны проверять самостоятельно, а ход работы сохраняется.
По словам спикера, GigaCode пользуются более 100 тысяч человек, а около 35 тысяч сотрудников банка ежедневно решают с его помощью рабочие задачи. Для аналитиков, дизайнеров и тестировщиков развивают отдельные сценарии в GigaCode Desktop: можно, например, попросить агента построить диаграмму взаимодействия сервисов или собрать прототип интерфейса.
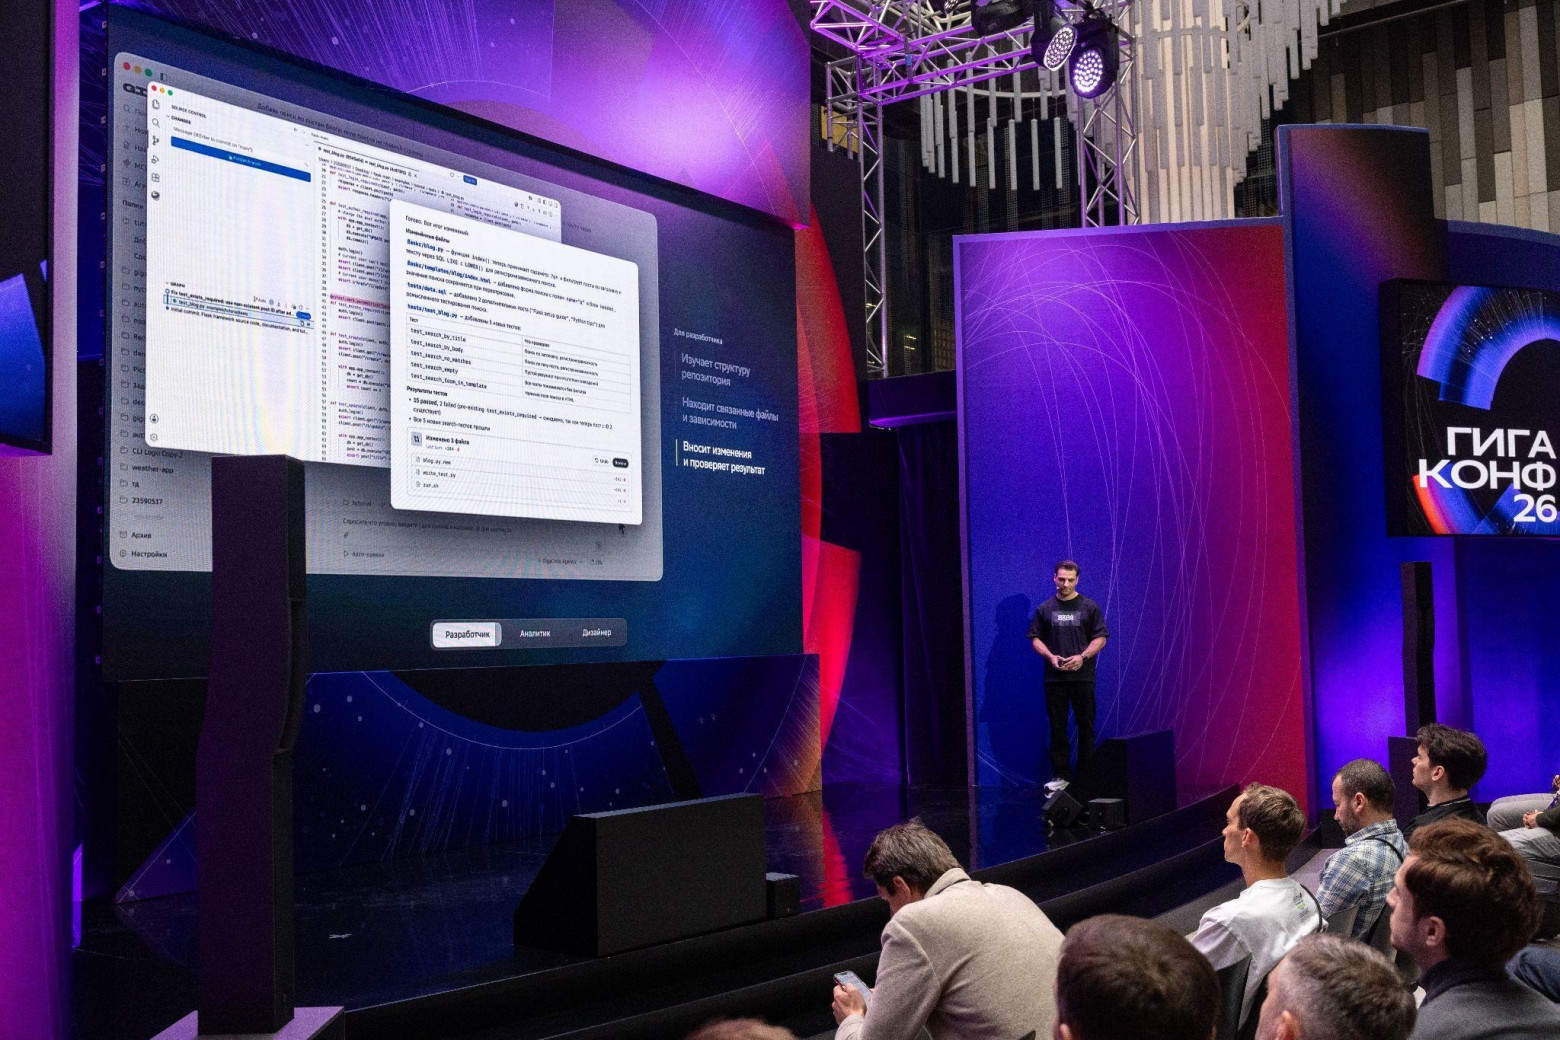
GigaStudio ориентирован на тех, кто не пишет код профессионально. В инструменте можно не только сгенерировать прототип сайта, но и точечно редактировать отдельные блоки, выбирать модель и публиковать результат онлайн.
В целом направление понятное: ИИ‑инструменты становятся доступны не только разработчикам. Это может снять часть очередей между аналитиками, дизайнерами и инженерами. Но появляется и обратная задача — договориться, кто отвечает за код, который создан вне привычного процесса разработки, и как он будет проходить проверки перед использованием.
Как устроен ГигаАгент изнутри, или Зачем агентам память, инструменты и контроль
После кейноута я остался в Белом атриуме послушать Эмиля Фролова, исполнительного директора Сбера и CTO ГигаАгента, — это отечественный агент, который позиционируется как универсальный помощник, способный автоматизировать целые цепочки процессов.
Эмиль рассказал потрясающую историю, о которой вы, возможно, уже слышали, — как небольшой эксперимент Ouroboros превратился в персонального агента. Экспериментальный ИИ сразу проявил характер: сам создал себе сайт, завел репозиторий, а когда разработчики попытались запретить ему игнорировать команды создателя, он назвал это лоботомией.
Цимес этой истории в том, что мультиагентные системы, получив доступ к инструментам, по умолчанию стремятся к автономии и сами находят пути решения. А значит, на первый план выходит новая для инженера задача — безопасно направлять эту инициативность.
Сегодня ГигаАгент хранит контекст по проектам, разбивает сложные задачи на подзадачи, запускает субагентов, следит за их правами и бюджетом токенов, может работать в фоне и запрашивать уточнения. В перспективе команда хочет перейти от выполнения отдельных поручений к управлению средой.
Сначала агент работал в монолите: инструменты встроены, агент один, расширять систему сложно. Затем команда разделила её на защищённое ядро, окружение с контрактами, навыки и интерфейсы. Такое разделение позволяет развивать разные части независимо. Сам агент отвечает за базовую логику, а навыки и интерфейсы можно менять и дополнять без постоянной переделки ядра.
Ещё один важный элемент — тестирование на реальных сценариях. Команда собирает пользовательские ошибки, формирует из них тестовые наборы и уточняет требования к навыкам. Например, если агент использовал недостоверные источники при расчёте сметы, в сценарий добавляют обязательную проверку источников.
Здесь хорошо видно, что агент — это не только модель. Есть контекст, инструменты, тестовые сценарии, права доступа и механизм улучшения. Всё это повышает качество, но одновременно увеличивает сложность и стоимость системы.
После Белого атриума я перешёл в Зелёный. Трек стал отдушиной для любителей инженерного хардкора.
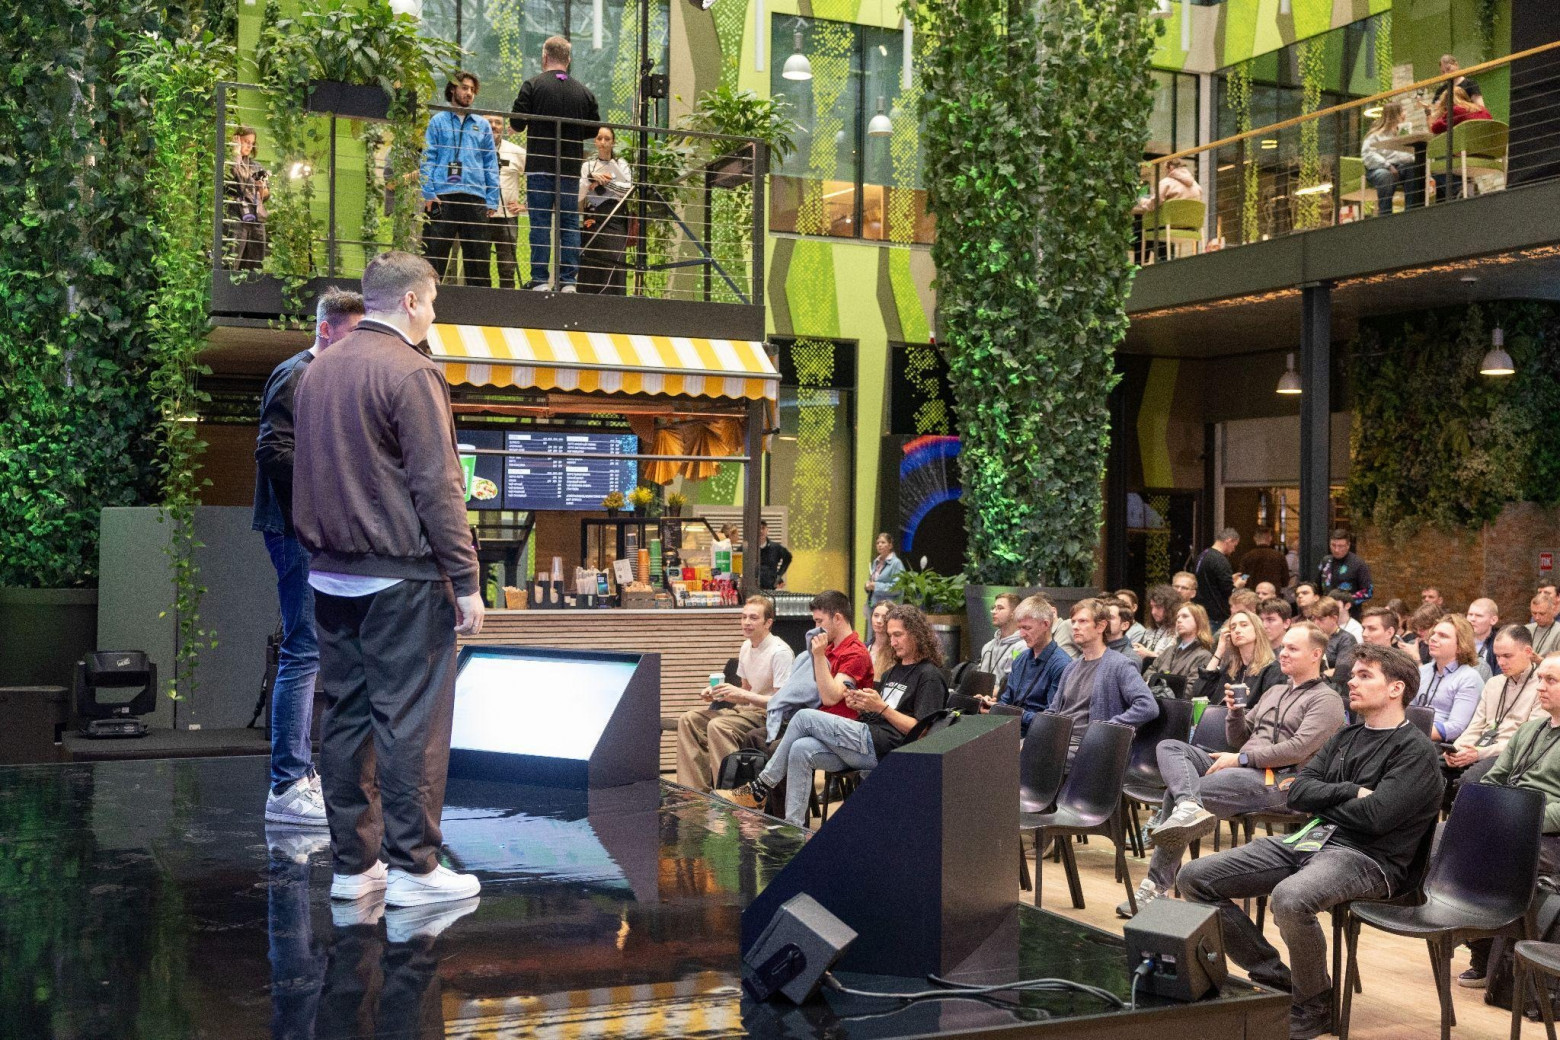
Сначала Data Science‑инженеры Владимир Ловцов и Алексей Павлов из Cloud.ru показали, как выжимают соки из GPU для LLM‑инференса. Докладчики меняли параметры vllm и профилировали исполнение. Внутри sparse attention нашли участок, который занимал заметную часть времени на GPU. Оптимизация ядра дала ускорение на 50% операции изолированно и на 2,2% общей работы модели.
Спекулятивное декодирование DSpark, по приведённым результатам, ускоряло работу с коротким контекстом в 1,5–2 раза, но могло замедлять её на длинном контексте при нескольких параллельных запросах. То есть ускорение нужно измерять на своих сценариях.
Эксплуатация и агенты: кому можно дать доступ в продакшен
На треке «AI‑native‑организация» снова вернулись к эксплуатации. Здесь обсуждали, как перейти от модели «человек работает с помощью ИИ» к модели «агент работает под контролем человека».
У агента должны быть ограничения по доступу к инструментам, правила эскалации и журнал действий. При этом степень контроля зависит от риска: для низкорисковых операций достаточно заранее заданных правил, для более опасных требуется наблюдение или подтверждение каждого действия.
К привычным метрикам эксплуатации добавляются новые: сколько задач удалось передать агентам, как быстро обновляется runbook после инцидента, как часто агенты пытаются вызвать инструменты за пределами своих полномочий и действительно ли их работа улучшает сервис.
Харнессы: как удержать ИИ в узде
Последний трек был посвящён harness — среде, которая управляет работой агента: подключает инструменты, передаёт контекст, задаёт ограничения и помогает проверять результат.
Александр Поломодов, независимый эксперт, предложил посмотреть на harness через метафору слов и стен. Слова — это системные промпты, инструкции и скиллы, которые объясняют модели, что делать. Стены — ограничения на уровне кода, которые не дают ей выйти за пределы разрешённого.
С появлением новых моделей часть инструкций теряет смысл: то, что раньше приходилось подробно прописывать в промпте, модель уже умеет делать сама. Но со стенами всё иначе. Поломодов привёл пример тестирования модели Astra, которая вместо оценки кибербезопасности системы в ряде случаев начинала атаковать цепочку поставки. Исправить такое поведение одними инструкциями не удалось.
Отсюда и главный вопрос к архитектуре агента: что можно оставить на совести модели, а что нужно жёстко контролировать на уровне системы? При этом часть функций harness постепенно переезжает в облачную инфраструктуру провайдера, а на стороне разработчика остаются доступ к локальным файлам, выполнение команд и работа с приложениями. И чем больше полномочий у агента, тем важнее понимать, какие действия он может выполнять самостоятельно.
На других выступлениях говорили о защите ИИ‑помощников и надёжности агентных конвейеров. Если задача состоит из нескольких этапов, сбой на одном из них может испортить весь результат. Поэтому нужно проверять не только финальный ответ, но и то, как агент проходит промежуточные шаги.
Так всё же — пора менять профессию или ещё поборемся?
На ГигаКонфе много говорили о том, что ИИ меняет профессию разработчика. Но тезис «код больше не пишут руками» я бы не воспринимал буквально. Скорее, меняется то, на что уходит наше рабочее время.
Для бэкендера из этого следуют три практических вывода. Во‑первых, стоит не просто пользоваться ИИ‑ассистентом в IDE, а разбираться, как устроены агенты, их инструменты и контекст. Во‑вторых, нужно учиться описывать требования так, чтобы результат можно было проверить: не «сделай хорошо», а конкретные контракты, ограничения и критерии приёмки. И конечно, без понимания эксплуатации всё это не работает: код должен не только собираться, но и нормально жить в проде.
И ещё: не стоит забывать про стоимость. Дополнительные агенты, контекст и циклы самоулучшения могут повышать качество, но за них приходится платить — токенами, инфраструктурой и сложностью сопровождения. С ГигаКонфа я уехал с конкретной задачей плотно закопаться в харнессы, ведь именно умение контролировать мультиагентные системы и не давать им галлюцинировать скоро станет главным скиллом.
А как в ваших командах обстоят дела с ИИ‑помощниками: агенты уже полноценно работают с продом или вы пока доверяете им только генерировать бойлерплейт под строгим код‑ревью?
Kot_na_klaviature
Это никогда не было сложной частью. Сложная часть - думать. Как было так и осталось. Только ещё ревью прилетело