

Представим: ночью у сервиса в одной из зон растет очередь на создание ресурсов, запросы завершаются тайм-аутами. Дежурному звонят: «У нас инцидент, посмотри». Он открывает мессенджер — а там уже целая простыня алертов.
Приложение сыплет ошибками, какая-то зависимость недоступна, на диске заканчивается место. Заодно высокая загрузка CPU в тестовой среде. Отлично, информации очень много. Только с чего начинать?
Если вас тоже интересует этот вопрос, давайте на этом примере разберемся, как настроить алерты, чтобы они помогали заметить сбой и начать восстановление. Заодно посмотрим, какие сообщения вообще стоит отправлять дежурному, а какие спокойно дождутся утра.
Почему один сбой превращается в десятки алертов
Часто все начинается вполне разумно: команда берет готовый набор правил из опенсорса, чтобы не писать мониторинг с нуля. Пример: в Awesome Prometheus Alerts уже собраны выражения для разных компонентов. Взяли, подключили, настроили доставку в мессенджер — и наслаждаетесь, узнавая о проблемах вовремя.
У меня такое было и не раз: каждое утро открываешь мессенджер, смотришь, что произошло за ночь. Сначала читаешь сообщения, потом просто пролистываешь десятки экранов. А еще через какое-то время видишь сотни непрочитанных и убираешь телефон, бубня под нос: «Нет, это я смотреть не буду».
Знакомо? Плохие новости: в этот момент мониторинг уже перестал выполнять свою задачу.
И готовые правила сами по себе не виноваты. Их автор просто не знает, как устроен ваш сервис: есть ли резерв, какие операции критичны, а какие нет. Поэтому чужой набор — хорошая первая итерация, но дальше его придется кастомить под свою систему.
К тому же один сбой может породить сразу несколько сигналов. Допустим, зависимость перестала принимать запись: приложение получает ошибки, повторяет запросы, очередь растет, пользователи ждут.
Для каждого компонента правило вроде сработало правильно, но дежурному пришло несколько сообщений об одной цепочке событий. А рядом еще гора очень важных алертов.
Если все это одинаково громко требует внимания, команда постепенно перестает реагировать. Возникает alert fatigue — усталость от оповещений. Почти как в истории про мальчика, который кричал «Волки!». Только наш мальчик кричит: «Алерт!»
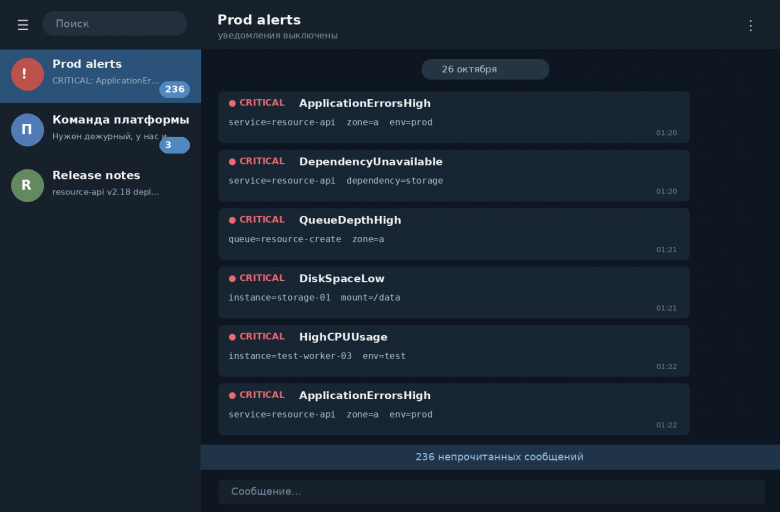
Все критично. Уведомления выключены.
И страшно вот что: однажды в чате действительно окажется сообщение о серьезном сбое. Но обратят ли на него внимание?
Поэтому сначала давайте разберемся, какие сигналы требуют срочной реакции. Спойлер: замьютить телефон — так себе решение.
Когда дежурному пора реагировать
Сконструируем историю: пользователь не может создать ресурс. В целом валидная причина разбудить дежурного: важная операция не работает, нужно восстанавливать сервис. А вот сообщение «CPU загружен на 90%» без контекста ему почти ничего не скажет. Возможно, машина как раз занята полезной работой и отлично справляется.
У Роба Эвашука в My Philosophy on Alerting есть удобная проверка: срочный вызов должен быть реальным, важным, срочным и требовать действия. Перед тем как отправить новое правило в дежурный канал, надо задать себе четыре вопроса:
Проблема реальна? Сервис действительно работает хуже или близок к отказу? Или мы поймали обычное колебание метрики?
Последствия важны? Что не может сделать пользователь и насколько это для него существенно?
Нужно вмешаться сейчас? Что произойдет, если оставить проблему до утра?
Что должен сделать человек? Есть ли проверки и решения, которые помогут восстановить работу? Открыть сообщение, сказать «ну да» и лечь спать — не считается.
Так мы приходим к алертам на пользовательские симптомы. Для облачного сервиса это — невозможность авторизоваться, создать ресурс или получить результат запроса за приемлемое время. Причину еще предстоит найти: сегодня подвела база, завтра сеть, послезавтра новый релиз. Но во всех трех случаях важно вовремя заметить, что нужная операция перестала работать.
При этом ждать первых пользовательских ошибок нужно не всегда. Если диск заполнится через полчаса, а на расширение нужен час, реагировать уже пора. Или сервис потерял последний резерв: сейчас запросы проходят, но следующий отказ он не переживет. Здесь срочность определяется тем, сколько времени осталось на вмешательство.
Поэтому сообщение о диске из нашего чата нельзя заранее объявить ни очень критичным алертом, ни бесполезным шумом. Нужно сначала понять, какой это диск, на что он влияет и сколько у команды времени. Но основным сигналом о текущем инциденте уже может быть нарушение создания ресурсов. Здесь к гадалке ходить не надо.
И еще: если после каждого вызова дежурный выполняет одну и ту же последовательность команд, стоит подумать об автоматизации. Конечно, сначала проверить, что действие безопасно и не скроет более серьезную проблему. Но будить человека только ради запуска знакомого скрипта тоже странно.
Как выбрать условия срабатывания
Показываю три пальца, загибаем каждый по очереди.
Учитываем долю ошибок и важность операции
Допустим, мы решили следить за ошибками создания ресурсов. Самое простое правило — сообщать, если за час накопилось десять ответов HTTP 500. Только вот при миллионе запросов это 0,001%, а при ста — уже 10%. О как. Оказывается, контекст имеет значение. И хоть количество ошибок одинаковое, ситуация для пользователей совершенно разная.
Поэтому счетчик ошибок полезно смотреть вместе с объемом трафика. Но и общий процент может обмануть: главная страница может открываться, запросов к ней много, а создание ресурсов полностью сломалось. В суммарной статистике доля ошибок небольшая, вот только одна из важных функций недоступна.
Еще нужно выбрать, где измерять результат. Внутренний компонент может вернуть ошибку, после которой запрос успешно выполнится на резерве, пользователь этого даже не заметит.
Поэтому качество операции лучше оценивать ближе к ее потребителю. Например, на входном балансировщике, если он видит итог выполнения запроса. Для асинхронного создания ресурса одного успешного ответа API маловато: важно проверить, что ресурс в итоге создался.
В нашем случае отдельно смотрим создание ресурсов в проде и сохраняем разбивку по зонам. Иначе успешная работа зоны Б скроет отказ в зоне А. Тестовую среду наблюдаем отдельно, если ее проблемы не влияют на прод. А данные из браузера сопоставляем с другими сигналами: там на результат влияют еще два фактора: сеть и устройство пользователя.
Связываем порог с требованиями к сервису
Чтобы выбрать порог, нужно договориться, какое качество работы мы обещаем.
Для этого есть SLI — измеримый показатель качества, и SLO — его целевое значение за выбранный период. В нашем примере SLI — доля успешно созданных ресурсов. Допустим, хотим, чтобы за 30 дней успешными были 99,9% операций.
Оставшиеся 0,1% составляют бюджет ошибок. Если сейчас неуспешны 2% операций, допустимая доля превышена в 20 раз: если ситуация сохранится, то бюджет будет расходоваться в 20 раз быстрее — это и есть burn rate. Подробно подход разобран в Alerting on SLOs, если хотите почитать в оригинале.
Что нам это дает? Помогает ответить на вопрос: как быстро нужно вмешаться?
При этом полезно смотреть на два окна одновременно. Длинное показывает, что проблема уже съедает заметную часть бюджета. Короткое — что она продолжается прямо сейчас. Например, за последний час ошибки составили 2%, а за последние пять минут — 3%. Для SLO 99,9% это burn rate 20 и 30. Если выбранный порог равен 14,4 для обоих окон, условие сработает. При постоянной нагрузке такой порог за час — примерно 2% месячного бюджета.
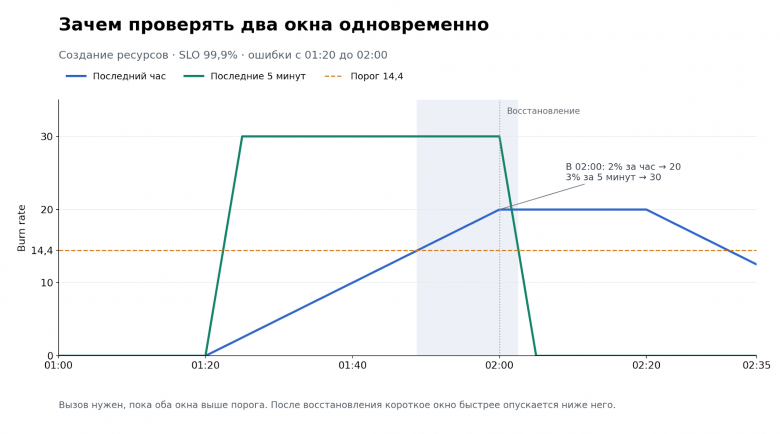
Срочный вызов остается активным, пока оба окна выше порога.
Зачем короткое окно? После восстановления в часовом еще останутся ошибки, а в пятиминутном их доля уже снизится. Тогда эта пара условий перестанет вызывать дежурного. При этом ждать целый час после начала сбоя не нужно: скользящие окна пересчитываются по мере поступления данных.
Жаль, что готового порога для всех сервисов нет. Его приходится выбирать вместе с окнами, исходя из требований и допустимого времени реакции. При малом трафике проценты особенно капризны: один неудачный запрос может выглядеть как катастрофа. Здесь дополнительно проверяйте абсолютное число ошибок и, где уместно, используйте синтетические запросы, которые регулярно проверяют нужную операцию.
Проверяем гипотезу на истории
Наконец, третий палец.
Итак, у нас есть гипотеза: такое выражение с такими порогами заметит значимый сбой. Прежде чем будить по нему людей, посмотрим, как оно вело бы себя на долгосроке. Причем проверять нужно само выражение алерта, а не только метрику, из которой оно собрано.
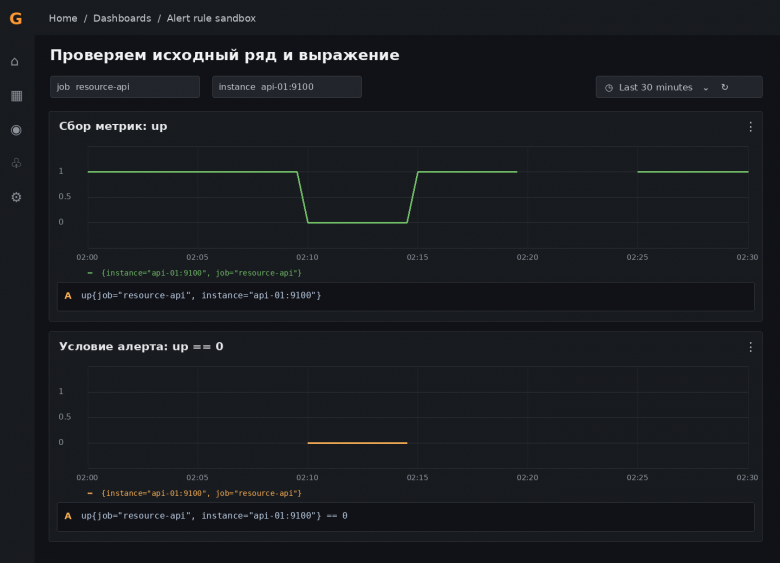
Возьмем простой пример из Prometheus. Метрика up равна единице, если сбор метрик с цели прошел успешно, и нулю — если нет. Запрос up == 0 без bool отфильтрует единицы и оставит нули. При успешном сборе метрик результат этого запроса будет пустым. Но пусто будет и тогда, когда данных вообще нет.
В этом кейсе запросу просто нечего проверять, но с виду все ок. Нулевое значение в результате не мешает алерту стать активным: важно, что ряд прошел условие и остался в выдаче.
Как решить: для наглядности смотрим на исходный ряд: данные действительно поступают? Нужные метки на месте? Период выбран правильно? И отдельно помним, что up проверяет успешность сбора метрик. О том, может ли пользователь создать ресурс, эта метрика не расскажет.
Совет: чтобы отличать статус «все хорошо» от «данных нет», допишите or vector(0). Ряд перестанет пропадать, и вместо разрыва на графике будет видимый ноль. Важно не оставлять это в правиле алерта: если условие срабатывает по факту наличия ряда в выдаче, этот подход сделает его вечно активным. Да и метки (instance, job, и т.д.) у такого ряда теряются.
Для сигнала именно об отсутствии данных есть отдельные правила absent() и absent_over_time().
Затем расширяем диапазон просмотра. На графике за последний час все может быть спокойно, а за неделю обнаружится короткий сбой. Берем список известных инцидентов и сопоставляем его с историей выражения: какие события оно заметило, какие пропустило, а где сработало без повода?
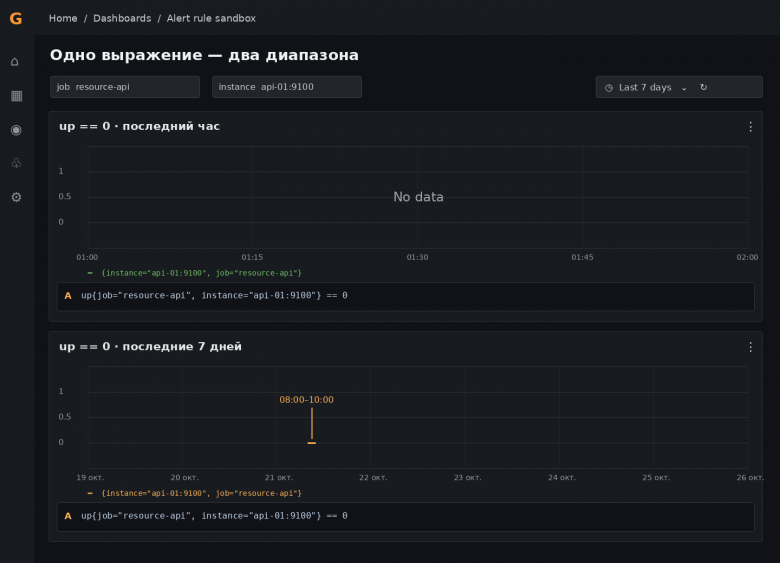
Один запрос за час и за неделю: короткий диапазон скрывает прошлый сбой.
Для нашего правила также проверяем ошибки создания ресурсов по зонам, оба расчетных окна и исключения. Если известный отказ попал в историю, но сигнал не появился, разбираемся почему. Если правило реагировало во время штатной работы — тоже. После запуска продолжаем наблюдать за срабатываниями: нагрузка и сама система будут меняться.
Так настройка и превращается в итеративную работу: предложили условие, проверили на графиках и известных событиях, запустили, посмотрели на результат, поправили.
Так что взять готовые правила на старте нормально. Просто не надо думать, что после этого мониторинг настроен раз и навсегда.
Как собрать связанные алерты в понятное уведомление
Вся штука в том, что даже полезные правила не обязательно должны оказываться в чате при каждом срабатывании.
Потому что сработавший алерт и инцидент — это принципиально разные вещи. Например, десять алертов от экземпляров одного сервиса можно собрать в одно сообщение. Инженер увидит масштаб сбоя, но не захочет выключить телефон до следующего утра.
В нашей ночной истории основным сообщением может стать «Не удается создать ресурс в продакшене зоны А». Ошибки зависимости, рост очереди и состояние диска послужат контекстом для расследования. А дежурный сможет начать с нарушенной операции и дальше проверить все, что с ней связано.
Для группировки нужны общие признаки: сервис, окружение, зона отказа. Если в зоне Б одновременно сломалась другая операция, ее нельзя прятать в ту же пачку только потому, что сообщения пришли рядом по времени. И предупреждение из тестовой среды тоже не стоит смешивать с продакшеном.
Есть еще одна штука — подавление уведомлений. Например, если надежно обнаружен отказ общей зависимости, можно временно не отправлять повторяющие его сообщения от зависимых компонентов. В документации Alertmanager разобраны оба механизма, почитайте. Но условия подавления нужно ограничить нужной областью и проверить: отдельная авария не должна исчезнуть вместе с дублями.
И заранее договоритесь, кто начинает работу. В нашем примере первым включается дежурный сервиса создания ресурсов. Если проверки укажут на общую зависимость, он подключит ее владельца. Если об этом не договориться, даже одно идеально собранное сообщение с алертами можно пересылать между командами до утра.
Как починить уведомления
Теперь посмотрим на само сообщение. Можно сколько угодно дорабатывать выражение, но если ночью человеку приходит только название правила, контекст он все равно будет собирать вручную. Сравним два варианта для нашей ситуации.
Вариант до переработки
CRITICAL: ApplicationErrorsHigh
Что сломалось? Где? Насколько сильно? Куда смотреть? Все это придется выяснить после открытия сообщения. А если дежурный отвечает за несколько сервисов, сначала еще нужно вспомнить, чей это вообще алерт.
Вариант после переработки
Что произошло: часть операций создания ресурса завершается ошибкой. Окружение — production, зона А.
Масштаб: за последний час неуспешны 1 200 из 60 000 операций, за пять минут — 150 из 5 000. На графике первые ошибки видны с 01:20.
Что еще сработало: ошибки общей зависимости и предупреждение о нехватке места на ее узле.
С чего начать: открыть дашборд создания ресурсов с фильтрами по зоне и окружению, проверить соседние зоны, сопоставить ошибки операции с ответами зависимости.
Кто реагирует: дежурный сервиса создания ресурсов. Рядом — ссылки на нужный дашборд, инструкцию по первым действиям, изменения перед сбоем и контакты для эскалации.
Дальше дежурный проверяет зависимость и находит ошибки записи. Ее владелец подтверждает: на нужном томе закончилось место. Команда восстанавливает запись, после чего проверяет создание ресурсов и сокращение очереди. На этом наш инцидент заканчивается. Обратите внимание: зеленая метрика диска сама по себе еще не означала бы, что пользователь снова может получить ресурс.
Для первых проверок и нужен runbook — короткая инструкция, привязанная к сигналу. Что он означает, куда посмотреть сначала, какие особенности учесть, как проверить восстановление и кого позвать, если своими силами не получается.
А что делать с полезным сигналом, который может подождать? Отправить в рабочую очередь, назначить ответственного и договориться о сроке разбора. Повторные срабатывания лучше добавлять к существующей задаче.
Можно использовать и регулярный отчет, если знаете, кто его читает. Просто завести еще один чат для несрочных алертов недостаточно: мы уже знаем, чем заканчиваются сотни непрочитанных.
Как понять, что стало лучше
После нашего инцидента стоит вернуться к алертам и посмотреть, как они помогли.
Когда начались пользовательские ошибки? Когда пришло первое полезное сообщение? Когда дежурный начал проверку? Так станет видно, где потеряли время: в обнаружении сбоя или уже после уведомления.
Заодно разберем сообщения, которые пришли за смену. По каждому нужно принять решение:
оставить срочный вызов, если он вовремя заметил значимую проблему и потребовал действий;
поправить условие, если оно срабатывало на обычные колебания;
перевести в задачу, если вмешательство нужно, но может подождать;
оставить для диагностики, если сигнал полезен при расследовании, но не требует отдельного вызова;
удалить, если он дублирует другие сигналы или вообще не помогает.
Количество уведомлений имеет смысл оценивать вместе с пропущенными инцидентами и временем реакции. Если пушей стало меньше, но о сбое теперь узнают из техподдержки, улучшение сомнительное. А если дежурный все так же тратит полчаса на поиск нужного дашборда, одной настройки порогов оказалось мало.
Такой разбор полезно проводить после заметных инцидентов и регулярно между ними, например раз в неделю. Проверять не только условия, но и владельцев, ссылки, инструкции. Сервис мог измениться, команда переехала на другой дашборд, сотрудник больше не дежурит, что угодно — и некогда хорошее сообщение снова стало бесполезным.
Мой самый главный совет: не стоит сохранять старую систему только потому, что вы долго ее собирали. Если правила шумят, люди их игнорируют, а нужный сбой все равно приходится искать вручную, подход пора пересмотреть. Главное — проверить, что новые правила замечают важные отказы, прежде чем отключать старые.
Прочитали все это, но все равно не знаете, с чего начать?
Действуем по шагам
Возьмите одно правило, которое больше всего раздражает команду, и откройте его последние срабатывания.
Посмотрите, что в эти моменты происходило с сервисом и что делал дежурный. Выясните, почему сигнал вообще попадает в срочный канал.
Затем проверьте выражение на истории: поймало ли оно известные сбои и сколько раз сработало зря. По результату уточните условия или выберите другой маршрут.
Откройте само уведомление. Понятно ли из него, что сломалось, кому действовать и куда смотреть? Все ли ссылки ведут туда, куда нужно?
После изменений посмотрите на следующие срабатывания. Настройка алертов на этом не закончится, но хотя бы одно правило начнет приносить больше пользы — или перестанет зря будить людей.
А что еще почитать
My Philosophy on Alerting — исходный текст Роба Эвашука о срочности, пользовательских симптомах и пересмотре правил.
Monitoring Distributed Systems — глава Google SRE о мониторинге, симптомах и причинах.
Alerting on SLOs — бюджет ошибок, burn rate и несколько временных окон.
Alertmanager — группировка, подавление и маршрутизация уведомлений.