Во время разработки библиотеки morphing-scroll я пришёл к необычному способу организации локальных данных в React-компоненте. Это не было заранее придуманной архитектурой. Я экспериментировал с обновлениями, постепенно убирал лишние состояния и в какой-то момент получил код, который оказался заметно проще прежнего. Для меня это стало настоящим открытием.
Позже я вынес найденный механизм в хук useRerender и добавил в свой стейт-менеджер nexus-state. В этой статье я хочу показать не только результат, но и путь к нему.
Идея состоит в том, чтобы разделить две операции, которые обычно объединяет useState:
1. изменить данные;
2. сообщить React, что интерфейс нужно обновить.
Данные можно хранить в refs и изменять синхронно, а для обновления интерфейса использовать один общий сигнал. Это противоречит привычной модели React и подходит далеко не каждому компоненту. Но именно поэтому интересно разобраться, где такой антипаттерн становится полезным инструментом.
Дальше я буду называть этот подход ручной инвалидацией рендера. Данные изменяются независимо от React, а разработчик сам сообщает, когда текущее отображение нужно признать устаревшим и построить заново. Это название придумано для статьи и не является общепринятым термином React.
От обычного счётчика к лишнему состоянию
Начнём с обычного счётчика:
import { useState } from "react";

function Counter() {

const [count, setCount] = useState(0);

return (

<button onClick={() => setCount((value) => value + 1)}>

      Нажатий: {count}

</button>

  );

}
Здесь useState решает задачу точно. Значение участвует в рендере, а каждое изменение должно обновить текст кнопки. Такой код знаком почти каждому React-разработчику и пока не содержит ничего необычного.
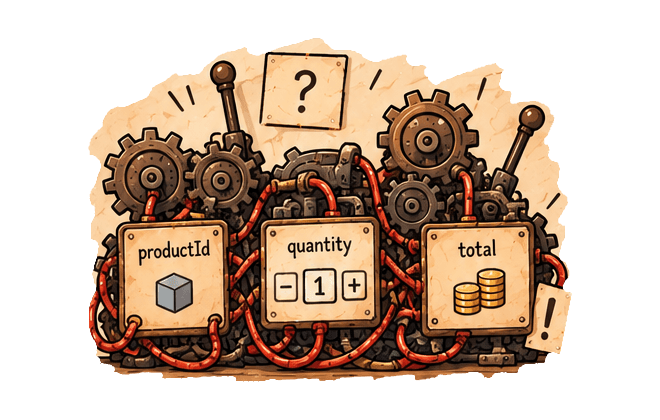
Теперь поместим счётчик в карточку товара. Кроме количества, нам понадобятся выбранный товар и итоговая стоимость. Первую версию намеренно напишем прямолинейно: для каждого изменяемого значения создадим отдельный useState.
const products = {
  keyboard: { name: "Клавиатура", price: 8_000 },
  mouse: { name: "Мышь", price: 4_000 },
  display: { name: "Монитор", price: 35_000 },
};

function ProductCard() {
  const [productId, setProductId] = useState("keyboard");
  const [quantity, setQuantity] = useState(1);
  const [total, setTotal] = useState(products.keyboard.price);

  function changeProduct(nextProductId) {
    setProductId(nextProductId);
    setTotal(products[nextProductId].price * quantity);
  }

  function changeQuantity(nextQuantity) {
    setQuantity(nextQuantity);
    setTotal(products[productId].price * nextQuantity);
  }

  return (
    <section>
      <select
        value={productId}
        onChange={(event) => changeProduct(event.target.value)}
      >
        <option value="keyboard">Клавиатура</option>
        <option value="mouse">Мышь</option>
        <option value="display">Монитор</option>
      </select>

      <button onClick={() => changeQuantity(Math.max(1, quantity - 1))}>
        −
      </button>
      <span>{quantity}</span>
      <button onClick={() => changeQuantity(quantity + 1)}>+</button>

      <p>Итого: {total.toLocaleString("ru-RU")} ₽</p>
    </section>
  );
}
Этот код работает, но во время проверки мы заметим неприятную связь. Любое изменение товара или количества требует не забыть вызвать setTotal. Если позже появится ещё один способ изменить количество, итог легко перестанет соответствовать остальным данным.
У total нет самостоятельного источника. Он всегда равен цене выбранного товара, умноженной на количество. Значит, хранить его не нужно:
function ProductCard() {
  const [productId, setProductId] = useState("keyboard");
  const [quantity, setQuantity] = useState(1);

  const product = products[productId];
  const total = product.price * quantity;

  // остальная разметка остаётся прежней
}
Так исчезли setTotal, обе ручные синхронизации и возможность получить противоречивое состояние. React также рекомендует не хранить производные данные в state.
Сначала это выглядело как обычное приведение кода в порядок: нашёл лишний state, заменил его вычислением и уменьшил число значений, которые нужно синхронизировать. Но за этим рефакторингом обнаружился более общий вопрос.
Если одно значение не обязано быть React state, потому что его можно вычислить, то где вообще проходит граница? Обязательно ли React должен хранить остальные данные только потому, что они участвуют в JSX? Можно ли изменять их самостоятельно, а рендер запрашивать лишь тогда, когда результат действительно пора показать?
В React легко привыкнуть связывать любое изменение с useState. Из-за этого новый state часто появляется автоматически, ещё до вопроса о том, должен ли React вообще хранить это значение.
Именно здесь я задумался: а что, если попробовать убрать все useState, хранить данные самостоятельно и оставить только один общий механизм обновления?
Пример с магазином намеренно упрощён. На практике этот подход помог мне при разработке сложного React-компонента, связанного со скроллом.
Переломный момент в morphing-scroll
В morphing-scroll задача была другой. Компонент управляет прокруткой, виртуализацией, перетаскиванием, инерцией и собственными элементами управления. Для работы ему нужны:
- текущая и целевая позиция прокрутки;
- размеры области просмотра и содержимого;
- видимый диапазон элементов;
- направление движения;
- состояние перетаскивания и анимации;
- идентификаторы запланированных кадров.
Первое очевидное решение выглядит так:
const [scrollTop, setScrollTop] = useState(0);
const [targetScrollTop, setTargetScrollTop] = useState(0);
const [viewportHeight, setViewportHeight] = useState(0);
const [visibleRange, setVisibleRange] = useState([0, 20]);
const [isDragging, setIsDragging] = useState(false);
const [isScrolling, setIsScrolling] = useState(false);
Количество хуков само по себе ещё не объясняет проблему. Сложность появляется, когда состояний становится много и между ними возникают связи. Одно событие scroll меняет позицию, направление и видимый диапазон. Начало drag переключает несколько флагов. Анимация должна на каждом кадре прочитать свежие данные, вычислить следующие и иногда обновить JSX.
Сеттер при этом не меняет значение в уже выполняющемся обработчике:
function handleScroll(nextScrollTop) {
  setScrollTop(nextScrollTop);

  console.log(scrollTop); // значение из текущего рендера
}
Так работает React state: каждый рендер получает собственный снимок, а сеттер ставит следующий снимок в очередь. Для декларативного интерфейса это полезная гарантия. Внутри скролла мне, наоборот, требовались синхронно изменяемые данные, доступные обработчикам прямо сейчас. Несколько отдельных сеттеров затрудняли предсказуемый порядок вычислений.
React объединяет несколько обновлений состояния в один рендер. Но batching отвечает только на вопрос, сколько рендеров произойдёт. Он не отделяет изменение данных от запроса на обновление интерфейса: каждый сеттер по-прежнему делает и то и другое.
Почему не useReducer
Связанные состояния можно собрать в useReducer. Это уберёт множество сеттеров, оставит один dispatch и для большинства компонентов будет более стандартным решением.
Но reducer сохраняет основную модель React: dispatch ставит в очередь новый снимок state и вместе с ним запрашивает рендер. В morphing-scroll мне требовалось другое. Внутренняя модель должна была изменяться синхронно, иногда несколько раз между кадрами, а React нужно было подключать только тогда, когда накопленный результат пора показать.
Поэтому вопрос был не только в количестве сеттеров. Мне нужно было разделить изменение данных и публикацию этих изменений в интерфейсе.
Ref как внутренняя модель компонента
Я собрал связанные значения в один объект внутри useRef:
const runtimeRef = useRef({
  scrollTop: 0,
  targetScrollTop: 0,
  viewportHeight: 0,
  rowHeight: 40,
  visibleRange: [0, 20],
  isDragging: false,
  isScrolling: false,
});
Теперь обработчик может закончить все вычисления синхронно:
function handleScroll(element) {
  const runtime = runtimeRef.current;

  runtime.scrollTop = element.scrollTop;
  runtime.viewportHeight = element.clientHeight;
  runtime.visibleRange = calculateVisibleRange(
    runtime.scrollTop,
    runtime.viewportHeight,
    runtime.rowHeight,
  );
  runtime.isScrolling = true;
}
Следующая строка сразу видит результат предыдущей. Нет нескольких сеттеров и не нужно помнить, к снимку какого рендера относится значение.
Остаётся одна проблема: изменение ref.current не запускает рендер. React не узнает, что visibleRange пора перечитать.
useRerender как отдельный сигнал
Повторный рендер функционального компонента можно запросить через фиктивное состояние:
import { useReducer } from "react";

function useRerender() {
  const [, rerender] = useReducer((version) => version + 1, 0);

  return rerender;
}
Значение version нигде не используется. Оно нужно только для того, чтобы React запустил новый рендер компонента.
Теперь несколько изменений можно завершить одним явным rerender:
const rerender = useRerender();

function handleScroll(element) {
  const runtime = runtimeRef.current;

  runtime.scrollTop = element.scrollTop;
  runtime.viewportHeight = element.clientHeight;
  runtime.visibleRange = calculateVisibleRange(
    runtime.scrollTop,
    runtime.viewportHeight,
    runtime.rowHeight,
  );

  rerender(); // явно обновляем наш интерфейс в конце
}
Именно здесь для меня произошёл перелом. До этого я воспринимал обновление данных и рендер как одну операцию: изменился state, значит React должен начать обновление. Оказалось, эти действия можно разъединить. Сначала привести внутреннюю модель в согласованное состояние, а затем одним сигналом опубликовать результат.
Сначала изменить данные. Потом решить, когда React должен их показать.
Неожиданно код стал проще для понимания. Вместо большого набора пар value/setValue остался обычный объект и один общий rerender. Мне больше не нужно было помнить отдельное имя сеттера для каждого поля и порядок нескольких запланированных обновлений. Несколько мутаций превратились в одну явно обозначенную границу обновления.
Именно это, а не три строки внутри useRerender, стало ключевым результатом эксперимента. Ответственность за момент обновления перешла к компоненту: он сам решает, какие изменения должны войти в следующий рендер.
Такой стиль гораздо ближе к обычному императивному JavaScript. Мы синхронно изменяем нужные данные, а React подключаем только тогда, когда хотим отобразить их актуальную версию в UI.
Один рендер на кадр
События scroll и pointermove могут приходить несколько раз между двумя отрисовками браузера. В этом случае сигнал можно ограничить одним вызовом на кадр:
const frameRef = useRef(null);
const rerender = useRerender();

function renderInNextFrame() {
  if (frameRef.current !== null) return;

  frameRef.current = requestAnimationFrame(() => {
    frameRef.current = null;
    rerender();
  });
}

function handleScroll(event) {
  const runtime = runtimeRef.current;

  runtime.scrollTop = event.currentTarget.scrollTop;
  runtime.visibleRange = calculateVisibleRange(
    runtime.scrollTop,
    runtime.viewportHeight,
    runtime.rowHeight,
  );

  renderInNextFrame();
}
Если между кадрами произошло пять событий, ref сохранит результат последнего, а React получит один запрос на рендер. Это не автоматический batching, а граница обновления, которую задаёт сам компонент. На размонтировании запланированный requestAnimationFrame также нужно отменить.
Для morphing-scroll это оказалось главным преимуществом: скорость изменения внутренних данных больше не обязана совпадать с частотой рендера React. Это также помогло производительности: компонент не запрашивал больше рендеров, чем браузер мог показать кадров.
Что мы за это отдаём
React рассматривает refs как escape hatch. Документация рекомендует хранить в них значения, которые не участвуют в JSX, и предупреждает о чтении ref.current во время рендера. Ручная инвалидация сознательно пересекает эту границу: JSX читает данные из ref, а useRerender заставляет React перечитать их.
Из этого следуют ограничения:
1. Если забыть вызвать rerender, данные изменятся, а интерфейс останется прежним. React уже не контролирует эту связь за разработчика.
2. Чтение изменяемого ref во время рендера выходит за стандартный контракт React. Такой код работает за счёт явной инвалидации, но линтер и новые возможности React опираются на другой договор: результат рендера должен определяться props, state и context.
3. Стабильная ссылка требует внимания при мемоизации. React.memo, useMemo или сравнение по ссылке не заметят внутренних мутаций объекта. В дочерний компонент лучше передавать конкретные значения или отдельную версию обновления.
4. Изменения refs не отображаются в React DevTools как обычные обновления state, поэтому их сложнее отслеживать при отладке.
Есть и отдельная особенность эффектов. ref.current сам по себе не является реактивным значением. Но после его изменения мы вызываем rerender, поэтому на следующем рендере React всё же сравнит новое значение зависимости с предыдущим:
useEffect(() => {
  doSomething(runtimeRef.current.scrollTop);
}, [runtimeRef.current.scrollTop]); // выражение вычислится заново после rerender()
Этот код сработает именно благодаря useRerender: он запускает рендер, во время которого выражение в массиве зависимостей вычисляется заново, а React сравнивает результат через Object.is. Если ref изменить без rerender, эффект об этом не узнает.
exhaustive-deps может предупредить, что изменяемое значение не является допустимой реактивной зависимостью. Современная конфигурация eslint-plugin-react-hooks также может задействовать правило refs, потому что зависимость читается во время рендера. Для обычного React-кода эти предупреждения справедливы: мутация ref не вызывает рендер. В ручной инвалидации этот недостающий шаг выполняет useRerender, но линтер не может вывести такой договор из кода. Локальное подавление предупреждения здесь становится ещё одной явной ценой антипаттерна.
Такой эффект реагирует не на каждую мутацию ref, а только на значения, которые дошли до очередного рендера. Кроме того, callback читает runtimeRef.current.scrollTop уже во время выполнения и может увидеть более новое значение, чем то, которое React сравнивал в массиве зависимостей. Если важна каждая мутация или точный снимок конкретного обновления, побочный эффект лучше вызвать рядом с изменением данных либо использовать полноценный реактивный источник.
Перепишем магазин через антипаттерн
В начале статьи мы удалили только производный total, а productId и quantity оставили в React state. Теперь для интереса доведём мысль до конца и перепишем карточку без единого useState. Объект products с названиями и ценами остаётся тем же: он объявлен вне компонента в первом примере.
function ProductCard() {
  const rerender = useRerender();

  const modelRef = useRef({
    productId: "keyboard",
    quantity: 1,
  });

  const model = modelRef.current;
  const total = products[model.productId].price * model.quantity;

  return (
    <section>
      <select
        value={model.productId}
        onChange={(event) => {
          model.productId = event.target.value;
          rerender();
        }}
      >
        <option value="keyboard">Клавиатура</option>
        <option value="mouse">Мышь</option>
        <option value="display">Монитор</option>
      </select>

      <button
        onClick={() => {
          model.quantity = Math.max(1, model.quantity - 1);
          rerender();
        }}
      >
        −
      </button>

      <span>{model.quantity}</span>

      <button
        onClick={() => {
          model.quantity += 1;
          rerender();
        }}
      >
        +
      </button>

      <p>Итого: {total.toLocaleString("ru-RU")} ₽</p>
    </section>
  );
}
model.productId хранит ключ выбранного товара, например "keyboard". Выражение products[model.productId] находит по этому ключу товар в каталоге, после чего его цена умножается на количество.
total остаётся обычной константой, потому что вычисляется из исходных данных при каждом рендере. Переносить его в отдельный ref нет смысла: это не даст заметного выигрыша, зато вернёт ручную синхронизацию, от которой мы избавились в начале статьи.
Код получился прямолинейным: данные изменяются обычным присваиванием, а для всех полей используется один rerender. Перед его вызовом можно изменить одно поле или сразу несколько.
Где подход особенно полезен
Я бы рассматривал refs вместе с useRerender для компонентов, у которых есть собственная императивная модель:
- виртуализированные списки и сложный скролл;
- drag-and-drop;
- canvas и WebGL;
- анимационные циклы;
- pointer-события высокой частоты;
- DOM-измерения и синхронизация с браузерными API.
Преимущество заметнее всего там, где данные меняются чаще, чем должен обновляться JSX, или перед рендером нужно согласованно изменить несколько значений. Ещё один повод рассмотреть этот подход — большое количество локальных состояний в одном компоненте. Каждая новая пара value/setValue добавляет имя и отдельный путь обновления, которые приходится держать в голове. Если из-за этого код становится труднее читать и контролировать, один объект с данными и общий rerender могут заметно снизить когнитивную нагрузку.
Само количество useState не задаёт универсального порога, после которого код обязательно нужно переписывать. Важнее практический результат: какая модель точнее описывает компонент и в какой из них проще проследить изменение данных.
Насколько этот приём оригинален
К этому решению я пришёл самостоятельно во время работы над morphing-scroll. Я не искал готовый паттерн и не пытался повторить чужую реализацию: идея появилась из экспериментов с реальным компонентом и сразу доказала свою пользу на практике. Именно поэтому момент, когда всё заработало, был для меня озарением.
При этом отдельные части подхода существовали раньше. В старом React Hooks FAQ показан почти такой же счётчик на useReducer, а в библиотеках встречаются хуки с названиями useForceUpdate, useUpdate и useRerender. Сам механизм принудительного рендера не новый.
Есть и более близкие архитектурные параллели. useSyncExternalStore отделяет внешний источник данных от сигнала подписчикам. MobX и Valtio позволяют изменять модель отдельно от React, но автоматически отслеживают, какие компоненты нужно обновить. А в React Three Fiber после императивных изменений можно вызвать invalidate(), чтобы запросить новый кадр. Последний пример особенно близок к тому, как этот подход работает со скроллом и requestAnimationFrame.
Но среди найденных примеров я не встретил описания обычного локального React-компонента, в котором эта идея была бы сформулирована именно так: refs используются как полноценная модель, а один rerender становится явной границей её публикации. Возможно, подобный код уже писали и раньше, но мне важна не претензия на изобретение хука, а самостоятельно найденный способ организации компонента.
Название «ручная инвалидация рендера» описывает именно эту полную модель. Если актуальные данные уже хранятся вне React state, технический счётчик рендеров не стоит выдавать за предметное состояние. Его настоящая задача состоит в том, чтобы пометить текущее отображение устаревшим и попросить React построить новое.
Поэтому я добавил такой примитив в nexus-state:
const rerender = nexus.useRerender();

runtimeRef.current.value = nextValue;
rerender();
Итог
Путь к useRerender начался не с желания придумать новый хук. Во время разработки morphing-scroll работа с множеством связанных состояний стала настолько запутанной, что я начал убирать лишние useState один за другим. Так основная runtime-модель стала храниться в refs, а отдельный useUpdate остался сигналом, сообщающим React, что её пора отобразить заново.
Этот опыт изменил моё понимание самого useState. Это не просто контейнер с парой value/setValue, а договор с React: React хранит снимок данных и решает, когда показать следующий. Если таких состояний становится настолько много, что в их значениях и сеттерах трудно ориентироваться, это уже полноценный повод рассмотреть другую модель. Особенно когда состояния связаны, должны изменяться синхронно или данные меняются чаще, чем нужно перерисовывать интерфейс. В таких случаях более императивный подход с useRerender может оказаться проще для чтения и контроля.
useRerender показал мне ещё одну модель: данные могут изменяться как обычный JavaScript-объект, а рендер становится отдельной явной операцией. Сначала можно обновить несколько значений, проверить результат, при необходимости дождаться следующего кадра и только потом попросить React обновить интерфейс. Для сложного скролла это оказалось не обходным путём, а самым прямым описанием происходящего.
Когда этот вариант впервые заработал, меня удивило, насколько мало механики осталось в коде. Я убрал несколько абстракций и получил больше контроля: одна изменяемая модель, один способ запросить рендер и понятная граница между вычислением и отображением.
В этом для меня и состоит суть ручной инвалидации рендера. Главная идея здесь не в том, чтобы заменить каждый useState, а в возможности перестать считать изменение данных и обновление интерфейса одной неделимой операцией. Надеюсь, этот путь поможет и другим разработчикам немного иначе взглянуть на React.
Связанные статьи
Если хотите увидеть контекст, из которого вырос этот подход, прочитайте также другие мои статьи:
- История npm-библиотеки morphing-scroll
- О том, как я написал свой стейт-менеджер