Kubernetes в проде держат 80% организаций по опросу CNCF за 2024 год, против 66% годом раньше. В России адопшн ниже, но того же порядка: около 60% крупных компаний используют Kubernetes. Спор об управлении кластером в облаке обычно сводится к интерфейсу: консоль или CLI вроде eksctl. Но жизненный цикл кластера всё равно должен кто-то исполнять. Именно здесь и проходит реальная граница между инструментами.
В этой статье мы разбираем пользовательский жизненный цикл кластера второго поколения Managed Kubernetes в VK Cloud: создание, нод-группы, масштабирование, обновление версии и аддоны. За точку сравнения берём eksctl как привычный инструмент управления EKS. Дальше — таблица соответствия задач eksctl операциям VK Cloud, HCL-листинги Terraform-провайдера для кластера, нод-группы и аддона, числовые пороги автоскейлинга мастеров, процедура апгрейда со скрытым control plane и список мест, где обе абстракции дают сбой.
Это статья для инженеров, которые выбирают или эксплуатируют managed Kubernetes в российских облаках и хотят понимать, какие операции берёт на себя платформа. Для платформенных команд, переводящих кластеры в IaC. Если у вас самосборный Kubernetes, разделы об апгрейдах и запасе узлов тоже пригодятся: они описывают механику самого Kubernetes.
Эталон одной команды
README проекта eksctl обещает: «Вы можете создать кластер за несколько минут, выполнив всего одну команду», и это обещание честное. Утилита сама создаст VPC, control plane и две ноды m5.large по умолчанию, а kubeconfig положит в ~/.kube/config. За кулисами работает CloudFormation, механизм стеков AWS. В репозитории это сказано прямо: eksctl написан на Go и использует CloudFormation.
За несколько лет вокруг этой команды вырос целый жанр. На Хабре по ней собирали мегагайды на 66 тысяч знаков, а Сергей Полунин из «Газинформсервиса» в разборе 2022 года советовал использовать консольные утилиты при первом развёртывании EKS. CLI стал входной точкой в managed Kubernetes для тех, кому консоль казалась слишком медленной.
Из привычной картины выпадает статус самого проекта. Во-первых, eksctl никогда не был проектом CNCF. Его создала компания Weaveworks; проект следует CNCF Code of Conduct, но в реестрах фонда не значится. Сейчас репозиторий ведёт AWS под названием «The official CLI for Amazon EKS». Во-вторых, документация переехала с eksctl.io в AWS Docs, а старый домен теперь перенаправляет на неё.
Утилита давно переросла набор флагов. Основной сценарий выглядит как декларативный YAML: ClusterConfig со схемой eksctl.io/v1alpha5, в котором описаны metadata, vpc, nodeGroups, а поверх него работают команды create, upgrade и delete. В релизах 2026 года появился даже откат версии кластера через rollbackConfig. Эталон жанра выглядит так: декларативный конфиг, императивные команды и внешний механизм стеков под капотом.
Тот же цикл в VK Cloud
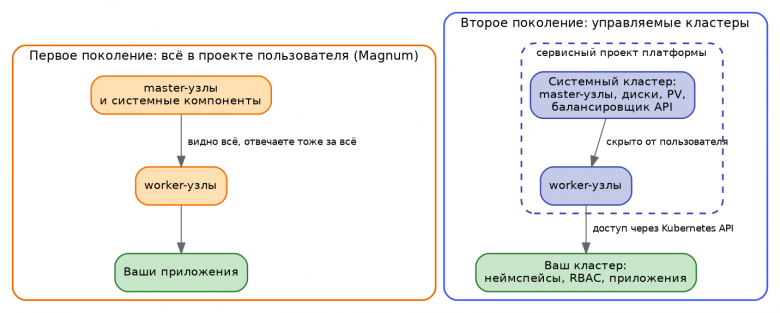
В VK Cloud кластеры Kubernetes существуют в двух поколениях. Первое работает на Magnum, инструменте оркестрации контейнеров из OpenStack. Кластер целиком живёт в проекте пользователя вместе с системными компонентами, и пользователь сам отвечает за их состояние.
Второе поколение управляемых кластеров сервис выпустил в конце 2025 года. Модель устроена иначе: мастер-ноды, диски, постоянные тома и сервисные балансировщики вынесены в сервисные проекты — изолированную среду на стороне платформы. Пользовательский кластер запускается внутри системного кластера. В мастере создания это поколение обозначено опцией «Новое поколение».
Автор статьи VK Tech об архитектуре Gatekeeper, ведущий разработчик команды, описывает модель так: «вы остаетесь администратором внутри своего кластера… но инфраструктура, control plane и системные компоненты полностью управляются провайдером и скрыты от глаз пользователя».
Для пользователя eksctl здесь одновременно много знакомого и нового. В EKS control plane тоже скрыт, но воркеры остаются вашими EC2-инстансами в вашем аккаунте. Во втором поколении VK Cloud платформа управляет и воркерами. У вас остаются сетевая связность с ними и полный доступ к Kubernetes API, а слой виртуальных машин выходит из зоны ответственности.
Сервисный проект — это проект-невидимка рядом с вашим. Платформа размещает там ВМ узлов, их диски и балансировщик API. В документации есть прямое предупреждение: любые действия с портами этих ресурсов могут привести к нестабильной работе кластера. Граница ответственности проходит буквально по списку ресурсов в интерфейсе.
Создание кластера
Через личный кабинет кластер второго поколения создаётся мастером: выбираются версия Kubernetes, тип кластера, сеть, CNI и группы узлов. Тип определяет топологию control plane. Стандартный кластер использует 1, 3 или 5 мастер-нод в одной зоне доступности, отказоустойчивый распределяет 3 или 5 мастеров между тремя зонами.
Платформа сама выбирает флейвор мастеров. По умолчанию это 2 CPU, 8 ГБ RAM и системный SSD-диск на 20 ГБ. Для каждого экземпляра etcd выделяется отдельный высокопроизводительный SSD класса High-IOPS. Из компонентов мастера именно etcd особенно чувствителен к задержкам диска.
Kubeconfig скачивается автоматически после создания. Документация обещает создание за 5–20 минут, а автор мегагайда по EKS называл для eksctl 10–15 минут. Порядок времени сопоставим.
Терминальный путь здесь предлагает Terraform. Полный кластер описывается ресурсом vkcs_kubernetes_cluster_v2:
resource "vkcs_kubernetes_cluster_v2" "k8s_cluster" {
  name    = "k8s-standard-cluster"
  version = "v1.35.6"

  cluster_type       = "standard"
  master_count       = 1
  availability_zones = ["MS1"]
  master_flavor      = data.vkcs_compute_flavor.master.id

  network_id             = vkcs_networking_network.app.id
  subnet_id              = vkcs_networking_subnet.app.id
  loadbalancer_subnet_id = vkcs_networking_subnet.app.id
  network_plugin         = "calico"
  pods_ipv4_cidr         = "10.100.0.0/16"
}

resource "vkcs_kubernetes_node_group_v2" "default" {
  cluster_id             = vkcs_kubernetes_cluster_v2.k8s_cluster.id
  name                   = "k8s-node-group"
  node_flavor            = data.vkcs_compute_flavor.worker.id
  availability_zone      = "MS1"
  scale_type             = "fixed_scale"
  fixed_scale_node_count = 3
  parallel_upgrade_chunk = 40 # процент недоступных нод при обновлении
  disk_type              = "ceph-ssd"
  disk_size              = 20
}
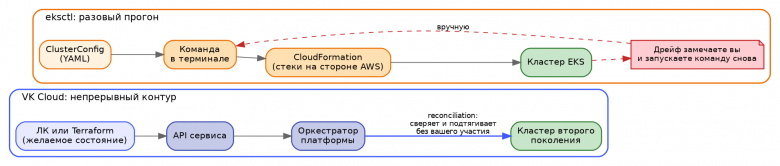
Сходство с ClusterConfig от eksctl прямое: та же декларативная запись того, каким должен быть кластер, и те же нод-группы отдельными блоками. Различается исполнитель. eksctl разворачивает YAML в стеки CloudFormation: вы запускаете команду, CloudFormation исполняет стеки на стороне AWS, а следить за дрейфом и повторять прогон приходится вам. Terraform-провайдер VK Cloud передаёт желаемое состояние оркестратору облака. Затем платформа непрерывно приводит кластер к этому состоянию.
Экспортируемые атрибуты закрывают бытовые задачи: kubeconfig доступен в поле k8s_config, API-эндпоинт — в api_address, а доступ к API можно ограничить списком CIDR через loadbalancer_allowed_cidrs.
Задачи eksctl и их эквиваленты
В таблице слева — команды из документации eksctl, справа — способы решить ту же задачу в VK Cloud.
Задача |
eksctl |
VK Cloud Kubernetes |
Создать кластер |
|
Мастер в ЛК или |
Получить kubeconfig |
|
Автоскачивание при создании, атрибут |
Добавить нод-группу |
|
«Добавить группу узлов» в ЛК или |
Масштабировать группу |
|
Поле числа узлов в ЛК, |
Автоскейл группы |
Флаги |
|
Слить ноды перед удалением |
|
Платформа сама выполняет drain при обновлении и масштабировании |
Обновить версию |
|
«Обновить версию» в ЛК |
Откатить версию |
|
Понижение версии недоступно |
Метки и тейнты |
Поля |
«Labels и Taints» в ЛК, блоки |
Аддоны |
|
Каталог аддонов в ЛК, ресурс |
GitOps |
|
Аддон Argo CD из каталога |
Единственную нод-группу кластера нельзя удалить через личный кабинет, хотя Terraform это ограничение обходит. Drain в VK Cloud вообще не оформлен как пользовательская команда. Поды вытесняются внутри процедур платформы при обновлении и масштабировании.
У eksctl вокруг drain больше сервисных возможностей. Есть команда drain nodegroup --undo, которая возвращает ноды в строй, и glob-фильтры вроде --include='ng-prod-*' для операций сразу над несколькими группами.
Группы узлов настраиваются одним набором параметров и в личном кабинете, и в Terraform: флейвор, зона доступности, тип и размер диска, количество узлов, границы автоскейлинга, метки и тейнты. Для production-нагрузок документация рекомендует SSD-диски и минимум две ноды в группе. Отказоустойчивую конфигурацию собирают из нескольких групп в разных зонах доступности, а реплики приложений распределяют между ними через topology-ограничения.
Смена флейвора существующей группы не требует пересоздания. Terraform-ресурс запускает rolling upgrade: ноды переходят на новый флейвор волнами. Шаблоны с высокопроизводительными CPU открываются через поддержку.
Аддоны
Аддоны в жизненном цикле стоят особняком. Это видно уже по тому, что отдельный ресурс провайдера для них появился независимо от кластера и нод-групп.
В каталоге второго поколения доступны Argo CD, ingress-nginx, cert-manager, kube-prometheus-stack, Istio, external-secrets-operator, s3-csi и другие. Они работают на воркер-узлах и потребляют их ресурсы, поэтому для тяжёлого набора аддонов документация рекомендует выделить отдельную нод-группу с автоскейлингом.
В коде аддон описывается ресурсом vkcs_kubernetes_cluster_addon_v2:
resource "vkcs_kubernetes_cluster_addon_v2" "ingress" {
  cluster_id       = vkcs_kubernetes_cluster_v2.k8s_cluster.id
  addon_id         = data.vkcs_kubernetes_addon_v2.ingress.addon_id
  addon_version_id = data.vkcs_kubernetes_addon_v2.ingress.id
  addon_name       = "ingress-nginx"
  namespace        = "ingress-nginx"
  values           = data.vkcs_kubernetes_addon_v2.ingress.values_template
}
В листинге показан только каркас. Конфигурация аддона передаётся в values как YAML, а доступный набор зависит от региона. У eksctl аналогичную роль играет команда create addon с политиками IAM. GitOps в обеих моделях вынесен в отдельный контур: eksctl вызывает flux bootstrap, а VK Cloud устанавливает Argo CD как аддон из того же каталога.
Разворачивайте кластеры Kubernetes с Managed Containers
Автоматизируйте деплой
и снижайте затраты на инфраструктуру
до 60%
В итоге контур управления во втором поколении замыкается на четырёх участниках: интерфейсе, API сервиса, оркестраторе и системном кластере, внутри которого работает пользовательский кластер.

Жизненный цикл в обеих моделях описывается декларативно. У eksctl желаемое состояние воплощает разовый запуск команды: CloudFormation исполняет стеки, а наблюдение за дрейфом остаётся на пользователе. В VK Cloud состояние принимает оркестратор платформы, а облако непрерывно приводит к нему кластер. kubectl в обеих моделях остаётся у пользователя, control plane скрыт в обеих, но во втором поколении VK Cloud под управление платформы уходят и воркеры.
Масштабирование и апгрейд
Автоскейл воркеров
Cluster Autoscaler предустановлен в каждом кластере, но по умолчанию выключен. Его включают для конкретной группы узлов и там же задают минимальное и максимальное число нод. В одной группе может быть до 500 воркер-нод. Пока автоскейлинг включён, вручную менять число узлов нельзя: сначала его нужно отключить в настройках группы.
Механика соответствует upstream Cluster Autoscaler. Расширение запускает под в состоянии Pending, которому не хватает ресурсов по requests. Планировщик учитывает resources.requests, а не limits, поэтому кластер с завышенными запросами будет расти раньше, чем ожидает команда.
Сжатие работает осторожнее: платформа вытесняет поды с недозагруженной ноды, ждёт пять минут простоя, помечает ноду тейнтом и удаляет её. По оценке VK Cloud, автоскейлинг способен экономить до 60% вычислительных ресурсов. Цифра вендорская, но её направление согласуется с мировой статистикой недозагрузки контейнерных нагрузок.
Автоскейл мастеров
Дальше начинается механика, которой в мире eksctl нет. Мастер-ноды второго поколения масштабируются вертикально автоматически. Автоматика включена всегда и не отключается.
Пороги опубликованы в документации. Агент следит за тремя условиями:
CPU выше 80% в течение минуты;
CPU выше 60% в течение пяти минут;
RAM выше 90% в течение минуты.
При срабатывании по CPU мастер получает два дополнительных ядра. При срабатывании по памяти RAM увеличивается по шкале 6, 8, 12, 16, 20, 24, 32, 36 и 48 ГБ. Вниз автоматика не масштабирует мастер-ноды. Уменьшить флейвор можно только вручную.
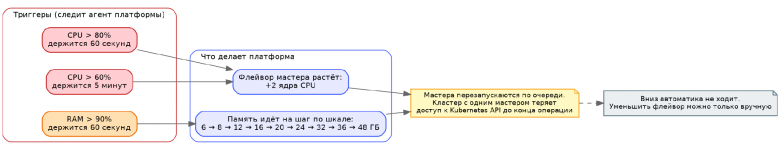
В EKS control plane также обслуживает провайдер, но подробности его масштабирования наружу не выведены: нет ни порогов, ни шкалы, ни ручного управления. В VK Cloud мастера тоже скрыты, но правила их роста опубликованы. Чёрный ящик здесь идёт с паспортом: известны пороги и шаги масштабирования.
У автоматики есть финансовая и техническая цена. Master- и worker-узлы тарифицируются одинаково: по ядрам, памяти и дискам, с отдельной детализацией расходов по мастерам. Невозможность отключить рост control plane означает, что за расходами нужно следить.
С технической стороны смена флейвора поочерёдно перезапускает виртуальные машины. В кластере с одним мастером Kubernetes API на время операции становится недоступным, а нагрузка в группе с единственным воркером простаивает. Это ещё один аргумент в пользу минимум трёх мастер-нод и групп из двух и более воркеров.
События масштабирования можно отправлять в алертинг. Для этого предусмотрены триггеры kubernetes_master_vscale и kubernetes_worker_hscale.
Обновление версии
Политики версий у платформ удивительно похожи. VK Cloud поддерживает версию 14 месяцев с даты её появления в сервисе и за 30 дней до завершения поддержки отправляет письмо и уведомление в личный кабинет.
Между релизом upstream Kubernetes и появлением версии в сервисе проходит от пяти до восьми месяцев. Например, ветка 1.33 вышла 15.05.2025, появилась в сервисе 20.10.2025 и завершит поддержку 20.12.2026 — через 14 месяцев после появления в VK Cloud.
Сейчас в сервисе доступны 1.35.6, 1.34.2 и 1.33.3. Формально в списке остаются 1.32.1 и 1.31.4, но их поддержка уже закончилась: 28.07.2026 и 17.04.2026 соответственно. В ближайшее время в сервисе останутся три ветки, начиная с 1.33.
У EKS standard support также длится 14 месяцев, после чего доступна платная extended support ещё на год. На обеих платформах обновление выполняется только на одну минорную версию за шаг и только вперёд.
В VK Cloud используется одна стратегия — обновление на месте, in-place. AWS в гайде по обновлениям EKS рекомендует тот же подход как основной. Blue-green с двумя параллельными кластерами оставляют для перехода через несколько версий: два кластера стоят дороже, а кроме того, меняются API-эндпоинт и OIDC.
Полезно помнить о допустимом рассинхроне версий в Kubernetes. Начиная с 1.28 kubelet может отставать от control plane на три минорные версии, поэтому воркеры не обязаны догонять мастера в день обновления. В EKS managed node groups вообще наследуют версию control plane: флаг --version для них не поддерживается.
Процедура в VK Cloud описана в концепциях. Сначала обновляются мастера, строго по одному: нода выходит из кластера, обновляется, проходит проверку и возвращается в строй. Затем обновляются группы воркеров — уже пачками. Размер пачки задаёт параметр «Процент недоступных нод при обновлении кластера», которому в Terraform соответствует parallel_upgrade_chunk.
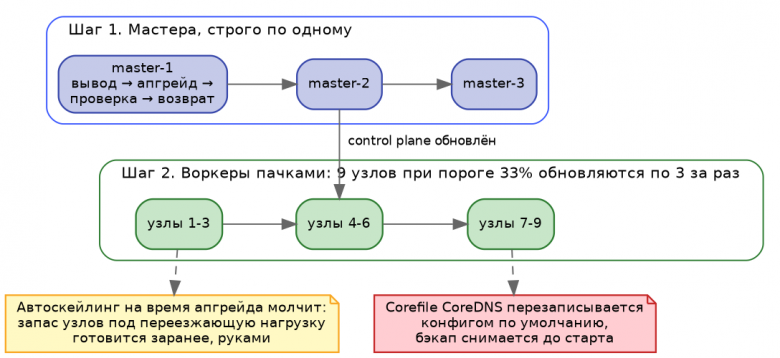
Документация приводит расчёт: если в группе девять нод, а нагрузке достаточно шести, можно обновлять по три ноды одновременно. Для этого нужно установить значение 33%.
Перед обновлением стоит помнить о трёх свойствах процедуры:
Во время обновления не работает автоскейлинг, поэтому узлы для переезжающей нагрузки нужно добавить заранее вручную.
Вместе с кластером обновляются Gatekeeper, встроенный компонент платформы, а не ваш OPA Gatekeeper, Shell Operator и CoreDNS.
Corefileпри этом заменяется конфигурацией по умолчанию. КастомныйCorefileбез резервной копии будет потерян.Аддоны вместе с кластером не обновляются: их версии команда меняет самостоятельно.
Перед обновлением инструкция предлагает полный прогон: создать резервную копию через Velero, развернуть из неё копию кластера, отрепетировать обновление и только затем переходить к боевому окружению. Это дороже, чем сценарий «eksctl upgrade cluster и посмотрим», но после репетиции остаётся гораздо меньше сюрпризов.
Тот же порядок — release notes, бэкап, control plane, аддоны и data plane — AWS рекомендует в best practices по апгрейдам EKS. Методика у платформ одна, но VK Cloud выполняет больше шагов самостоятельно.
Автоскейл воркеров включается для конкретной группы и ориентируется на requests, а мастера автоматически растут по опубликованным порогам. Апгрейд идёт волной: мастера по одному, воркеры — пачками, размер которых определяется процентом недоступных нод. Запас узлов и бэкап Corefile нужно подготовить до начала обновления, потому что автоскейлинг во время него отключён.
Где протечки у абстракции
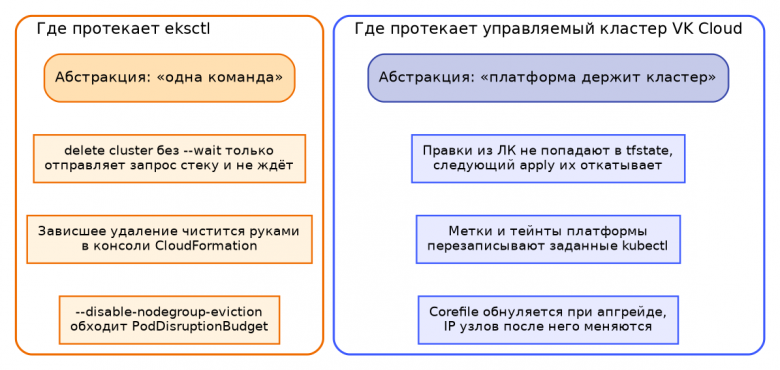
У eksctl протечки задокументированы давно. Команда delete cluster без флага --wait только отправляет запрос на удаление стека и не ждёт завершения. Если удаление зависло, документация предлагает открыть консоль CloudFormation и вручную очистить стеки.
Там же есть флаг --disable-nodegroup-eviction, который позволяет обойти PodDisruptionBudget, если drain упёрся в него. Абстракция «одна команда» заканчивается в момент, когда стек CloudFormation оказывается в ошибочном состоянии.
В VK Cloud протечки другие, но они также описаны в документации. Главная находится на стыке интерфейсов: личный кабинет и Terraform не знают друг о друге. Изменения, сделанные в ЛК, не попадают в tfstate. Следующий terraform apply откатит их и, как предупреждает документация, в худшем случае может привести «к неработоспособности кластера».
Штатное лечение — terraform apply -refresh-only и актуализация конфигурации. Но важнее организационная мера: кластер нельзя менять мимо кода, если Terraform считается источником истины.
Вторая протечка тоньше. Метки и тейнты, заданные через платформу, синхронизируются в кластер в одну сторону и перезаписывают одноимённые ключи, добавленные через kubectl. Метки и тейнты, добавленные мимо платформы, продолжают работать, но не видны ни в личном кабинете, ни в tfstate.
К этой же группе относится перезапись Corefile при обновлении: кастомная конфигурация заменяется настройками по умолчанию, и восстановить её можно только из заранее подготовленного бэкапа.
Критики managed-подхода назовут это платой за чужой control plane. Плата есть, но в двух моделях счёт приходит в разных местах. Протечка eksctl обычно означает разовую ручную очистку стека CloudFormation после собственной команды. Рассинхронизация личного кабинета и tfstate опаснее: изменить кластер может человек, который не знает о существовании Terraform, а ошибка проявится на следующем apply и затронет весь кластер.
Проблема решается не документацией, а внутренним правилом: не менять кластер вне IaC-контура. При этом и AWS, и VK Cloud описывают острые углы в официальной документации, что позволяет подготовиться до инцидента.
Границы контура
Отката версии кластера нет: понижение запрещено политикой обновления. Роль eksctl в VK Cloud распределена между личным кабинетом, Terraform-провайдером и kubectl.
Ограничение по CNI, из-за которого Cilium ещё недавно можно было включить только через личный кабинет, снято. Теперь network_plugin в Terraform-ресурсе v2 принимает и calico, и cilium: поддержку добавили в провайдере 0.17.1.
За рамками статьи остаются две темы: миграция существующих кластеров первого поколения на Magnum в новую модель и прямое сравнение с managed-сервисами других российских облаков. Обе заслуживают отдельного разбора; eksctl здесь нужен только как знакомая многим точка отсчёта.
Открытые замеры
Публичную планку скорости автоскейлинга задал Флант: 40 секунд на ввод новой ноды в связке EKS, Karpenter и spot-инстансов. Для VK Cloud такой замер можно снять той же методикой: создать под с requests, превышающими свободные ресурсы, и измерить время от Pending до Running на новой ноде. Повторите тест в своём окружении — результаты будет интересно сопоставить.
Ещё одна полезная цифра относится к автоскейлингу в целом. По Datadog Container Report за 2023 год, более 65% контейнерных нагрузок используют меньше половины запрошенных CPU и памяти, а HPA применяет лишь половина организаций. Автоскейлер масштабирует то, что указано в запросах ресурсов. Если requests завышены вдвое, кластер также будет вдвое больше необходимого, и Cluster Autoscaler этого не исправит.
Куда движется управление кластерами
Kubernetes-сообщество уже сформулировало направление. Cluster API, сабпроект SIG Cluster Lifecycle, описывает создание, масштабирование, обновление и удаление кластеров через декларативные API. Кластер становится объектом reconciliation так же, как Deployment.
eksctl движется в ту же сторону. Команда enable flux вызывает flux bootstrap, передавая доставку приложений отдельному GitOps-инструменту. По опросу CNCF, GitOps-практики используют 77% респондентов. Для большинства команд доставка приложений уже живёт в отдельном декларативном контуре рядом с кластером.
eksctl, Cluster API и оркестратор второго поколения VK Cloud сходятся в одной точке: желаемое состояние описывается декларативно, а затем его поддерживает контур reconciliation. Различается только владелец этого контура: разовый запуск команды, оператор в вашем кластере или оркестратор облачного провайдера.
Версии и ссылки
Всё описанное проверяется по открытым источникам; состояние — на сентябрь 2026 года. В VK Cloud поддерживаются Kubernetes 1.35.6, 1.34.2 и 1.33.3, там же опубликованы даты релизов и окончания поддержки. Дистрибутив сертифицирован CNCF в рамках программы Certified Kubernetes для hosted-платформ.
Стартовые точки для повторения: документация Cloud Containers, репозиторий terraform-provider-vkcs с ресурсами kubernetes_cluster_v2, kubernetes_node_group_v2 и kubernetes_cluster_addon_v2, а также документация eksctl в AWS Docs для сравнения с эталоном.
HCL-фрагмент из раздела о создании кластера самодостаточен: остаётся добавить сеть и data source флейворов.
Managed Kubernetes постепенно убирает из повседневной работы операции с мастер-нодами и виртуальными машинами. Во втором поколении VK Cloud control plane и инфраструктура мастеров находятся в сервисном проекте платформы, а пользователь управляет кластером через Kubernetes API, личный кабинет и Terraform. Главный вопрос здесь не в выборе интерфейса, а в том, какие части жизненного цикла берёт на себя облако и где заканчивается его зона ответственности.
Комментарии (2)

johndow
05.11.2026 20:10Скажите почему у вас в нод-группу можно сделать только в одной AZ ? Это же дико неудобно. Хочу я например сделать выделенную нод-группу с taint для вундервафли какой-нибудь, которую надо сделать отказоустойчивой и выходит, что надо делать 3 группы в разных AZ по одному узлу.
vizerty
Озвученный объем эксплуатации радикально завышен. Сам по себе инструмент зачастую изнутри никто не знает, большинство проблем решают перезагрузками. Сейчас тренд на отказ от него наоборот